ARTICLE · 1379289
扫描 PDF 搜不到字?Github开源工具 NAPS2 轻松搞定
PDF 里明明写着那几个字,按 Ctrl+F 却什么也找不到。鼠标拖过去,只能框出一块区域,选不到一句完整的话。这样的文件,通常只是把扫描图片装进了 PDF,阅读器还不知道图上的字是什么。
NAPS2 可以给这类扫描资料做 OCR,保存成带文字层的 PDF。它是 GitHub 上的开源扫描工具,支持 Windows、macOS 和 Linux;已有的扫描 PDF 也能导入,不需要再找一台扫描仪。这篇按电脑桌面界面,把一份资料从导入讲到搜索。
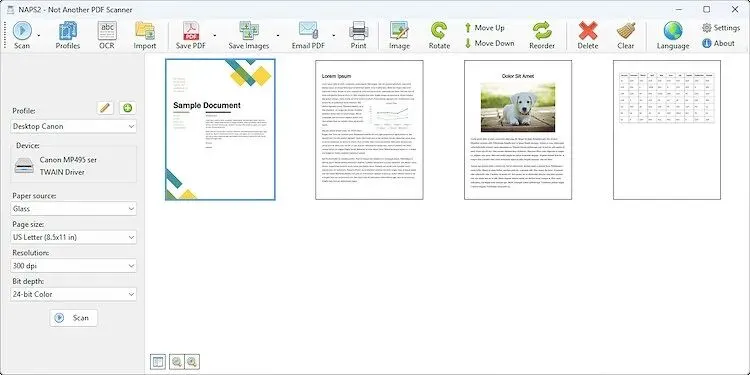
NAPS2 官方界面:扫描或导入的页面先在主窗口整理。
做完以后,页面仍是原来的扫描画面,但阅读器能够利用识别出的文字查词、选择和复制。它解决的是“找到哪页、取出哪些字”,不会顺便把复杂表格还原成 Excel,也不是把整份文件改造成排版相同的 Word。
先确认文件缺的是文字层
打开资料,选一个清楚、独特的词搜索。不要一开始就搜单字,容易出现太多无关结果。再试着选中一行文字;两种操作都不行,而页面看上去像一张照片,就很适合继续走这条路径。
如果能选字,却复制出乱码,情况不同。NAPS2 对导入 PDF 的处理规则是:页面已经有文字,就保留;没有文字,才做 OCR。所以,把带错误文字层的文件重新导入,并不等于强制重新识别。这类问题要另找支持重做文字层的流程。
原文件加密、受访问权限限制时,先取得正常可处理的文件。不要把打不开、没有权限和识别不出来混成一个问题。
导入页面,把顺序摆好
从 NAPS2 官网下载对应系统版本。Windows 用户可按常规安装方式打开软件,已有文件就用工具栏的导入入口选择 PDF;也可以导入常见图片文件。扫描按钮留给连接了扫描设备的场景,这次不用它。
导入后先看页面缩略图。封面有没有漏,横着的页面是否需要旋转,几张手机拍摄的内容有没有混乱,先在这一步处理。调整页面后,OCR 结果可能需要重新计算,放在识别之前整理更直接。
例如,一份培训手册里同时有封面、正文和一张横向流程图:封面仍然保留,正文依次排列,流程图转到能正常阅读的方向。别为了让缩略图“整齐”,把有内容的页边也裁掉。
页面歪斜时,可查看旋转菜单里的纠偏功能;小字发虚、阴影很重,则应优先找更清晰的来源。软件能调整页面,缺失的笔画和被遮住的内容却不能靠设置补回来。
语言选对,再保存 PDF
点击工具栏的 OCR。首次使用会提示下载识别语言,中文资料选择对应中文语言包,英语资料选英语。首次下载需要网络,语言包准备好后,识别工作由本地 OCR 引擎处理。
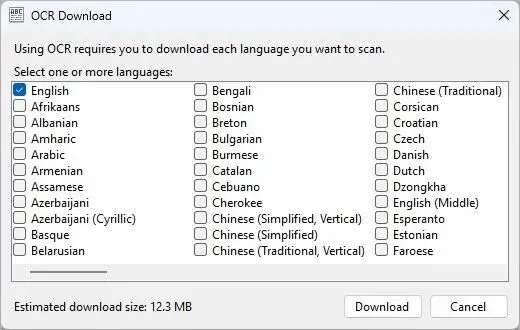
官方 OCR 语言下载窗口:识别语言要与资料内容匹配。
资料里中英文混排,可以先下载需要的语言,再在语言选项里选择多语言。只选实际出现的语言即可,不必因为“以后可能用上”把所有语言都勾上。
进入 OCR 设置后,确认用于生成可搜索 PDF 的选项已勾选,语言也与本次资料对应。不要只完成了语言下载,就把它当成整份文件已经识别结束。
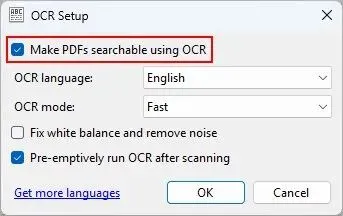
官方 OCR 设置窗口:确认启用可搜索 PDF,并选择识别语言。
一般先使用默认的快速模式。清晰度较差的扫描件,可以查看较高质量的识别模式,以及白平衡、去噪等选项;更复杂的处理会增加时间,不能把模式名称理解成识别必然正确。
然后回到主界面,选择保存 PDF,另存一个新文件,例如“培训手册-可搜索版.pdf”。NAPS2 通常在保存 PDF 时执行 OCR,保存完成才拿到这份结果;仅导入页面、关掉窗口,不会自动得到你要的文件。
如果只想处理其中几页,保存前确认选择范围;要整理整本手册,就确认全部需要的页面都在输出里。文件名可以说明用途,但不要覆盖唯一的原扫描件。
搜得到,还要看是不是这一句
用 PDF 阅读器打开新文件,先搜索一处正文里的独特词,点到匹配位置,再看原图对应的那一行。换一个靠后的页面再查一次,确认不是只看了前几页。
接着选中一小段文字复制到记事本。这样能看出字符有没有漏、空格是否异常、多栏内容是否串行。复制出来的句子是识别结果,重要金额、型号、日期仍以页面原图为准。
如果识别很差,先查语言,再看页面方向和清晰度。新扫描纸张时,官方建议可从 300 dpi 入手;对于已经模糊的旧文件,单纯放大像素并不能重新拍出细节。必要时重新获取清晰扫描件,比反复改保存参数更有用。
还有一种常见误会:想在 NAPS2 里直接导出纯文本。它的 OCR 工作流主要是输出可搜索 PDF;只取文字时,可以保存 PDF 后在阅读器里选择、复制,再按用途整理,复杂表格则需要单独处理。
把资料留下来,方便下次再找
处理好的文件可以按“主题+用途”保存,例如设备说明、培训手册、项目档案。以后需要找一个型号或步骤,就从文件名定位资料,再进 PDF 查词,不必每次重新截图识字。
这也是 NAPS2 在已有资料里的价值:先把图片中的文字变成可检索内容,保留页面供核对。对于扫描归档,找到信息和看清原文可以放在同一份文件里完成。
开源工具与使用入口
官网下载与平台选择https://www.naps2.com/download
老鲨不想加班
分享用得上的开源工具,把下载、操作和容易卡住的地方讲清楚。欢迎关注、转发、留言交流!