ARTICLE · 1380435
它的文档里没有“RAG”这个词,却把 RAG 的活儿干完了
它的文档里没有“RAG”这个词,却把 RAG 的活儿干完了上一篇我们把企业用大模型绕不开的四个痛点拆清楚了:没读过你的书、不知道也硬答、知识会过期、资料不能出门。 道理好懂,难的是落地。读者真正想问的是:这四件事,具体拿什么堵? 这篇有个天然方便的条件——这篇稿子本身,就是用千问办公做出来的,包括你看到的这几张图和最后的排版。 所以我不打算讲概念,只写这次真实跑通的四个能力落点,以及每个落点分别堵住了哪个痛点。 丑话说在前面:千问办公里没有一个叫“RAG 引擎”的按钮。它解这四个痛点的方式,是把“先查资料、按资料答、别越界”变成日常操作。 顺便说明:文中“官方描述”引自千问办公文档站,“第三方报道”会另标,两者不和我的实测混着写。 ▍落点一:先让它“读得到”你公司的书 痛点一最直白:模型压根没读过你的制度、工单和项目文档。 对应的能力是“接入”,在千问办公里它有三个入口。 一是连接器。官方的说法是“连接外部平台、账号、数据和工具”,钉钉、飞书、Microsoft 365、企业微信都在列。连上之后,钉钉里的文档、知识库、AI 表格、日程、待办,它能按你账号的权限去读。 二是本地文件授权。桌面端可以读你电脑上的文件,但有个关键设计:不是你整块硬盘随便翻,而是你授权哪个文件夹,它才能进哪个房间。 三是个人网盘。你给它看的资料、它产出的文件,收纳在同一个目录树里,不用在几套网盘之间来回搬。 光“读得到”还不够,格式也得吃得下。PDF、Word、Excel、PPT、扫描件、截图,这些它都有对应的处理能力。 这里有个容易被忽略的坑:制度文档里的表格,如果在解析阶段被拍平成一段流水账,后面检索再准也答不对——因为答案早在第一步就丢了。 顺带一个实操建议:第一次接入别贪多。挑一个部门、一套文档先跑通,比一上来把全公司的资料都倒进去有效得多——前者一周能见效,后者通常三个月还在收拾文件。 场景代入一下:行政把“制度汇编”那个文件夹授权出去,直接问“出差住宿报销要哪些材料”,它是去翻那份文件,而不是凭印象编一份。 到这一步,“没读过你的书”就变成了“读哪几本”的问题。 ▍落点二:把“不许瞎编”写进工作手册 痛点二最难治:它不知道也会硬答。 千问办公这边有个不太显眼、但很关键的东西叫意识:一份工作手册加上长期记忆,跨会话生效。 手册里写什么,它就照做什么。我这份手册里就明写着几条硬规矩:正文数字必须多源交叉核实、只引用可核实来源、文末逐条标注出处与检索时间、没实际执行的步骤必须标“尚未执行”。 有人担心写手册很麻烦。其实它就是几个文本文件:第一次让它按你的规矩干活,把纠正过的那几句话记进去,后面它就自己带着走。 这次写稿,“RAG 出自 Lewis 等人 2020 年的论文”这条,是先联网核对、再写进文末的,不是我凭记忆敲的。 你在这次交付的每个数字后面都能看到来源和检索时间,也是这条规矩在起作用,而不是我临时想起来补的。 另一层是技能。官方定义是“把一类工作的说明和所需材料打包供成员使用”。 说白了,技能就是把“我们部门到底怎么答这个问题”固化下来:HR 把招聘台账的统计口径做成技能,全组共用一套算法;法务把合同初审流程做成技能,新人上传文件就能一键跑。 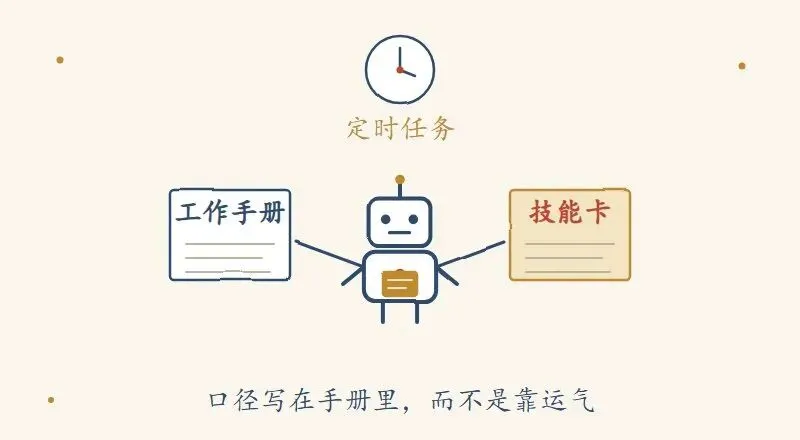
两条合起来的效果是:答案带着出处,纪律带着人。 口径不写进手册,就只能靠运气。 ▍落点三:文档一改,下次查到的就是新版 痛点三是时效。传统思路是“重新训练”,成本高、周期长,还容易把学过的旧知识搅乱。 这边对应两个能力。 一个是连接器读的是活数据:它查的是文档当前的状态。你改完存好,下一次问到的就是新版,不存在“文件已经改了、模型脑子里还是旧的”。 这里有个常见误区:把“知识更新”理解成“重新上传一次”。接了连接器之后,源文件改了就是改了,没有“再喂一遍”这个动作。 另一个是定时任务。官方描述是:按预设时间自动执行工作,即使关闭浏览器或退出登录,任务也会继续在云端按计划运行。 这条用在“知识过期”上很直接:把“检查制度文档有没有新版本、把变更摘要发到群里”配成每周一次,知识更新就从“想起来才做”变成“到点自己做”。 场景代入:财务把月度对账流程做成定时任务,每月固定时间自动出简报推到 IM;运营每天巡检一次数据异常,有异常才@人。 顺带一提,跨会话记忆也算这一环——这次定好的口径、踩过的坑,下次不用重讲一遍。 但也要说句实话:如果企业资料本来就散在十几个人的本地硬盘上、没人归位,那接上连接器也只是多了一个能查的入口,治不了“根本没有单一事实来源”这个病。工具解决的是可达性,不是脏乱差。 ▍落点四:数据不出门,靠边界而不是自觉 痛点四是硬约束。这里最容易被误解成“上了内部部署就安全了”。 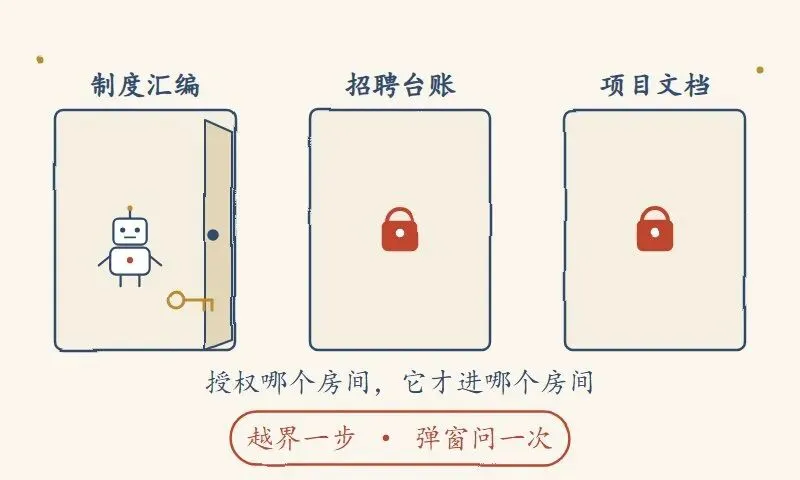
真正起作用的是几条边界设计,而这次我全程都在被它们管着: 目录授权:要访问你没选中的文件夹,它得弹窗问你,而不是悄悄读。 权限继承:连接器用的是你账号的权限——你看不到的文档,它也读不到。 删除保护:让它删文件,走的是“移到系统回收站”,不是永久删除;改你的文件之前,还要先备份。 沙箱执行:命令默认在隔离环境里跑,需要越界时单独申请。 更要紧的是,这些边界是默认生效的,不需要你每次提醒它“别乱来”。 这几条听起来完全不像卖点,但在企业场景里,“它不能做什么”往往比“它能做什么”更值钱。 至于组织级权限管控、私有化部署这类企业级方案,是另一个话题,我在文末口径块里单独标了一句,不混在实测里讲。 ▍串起来看 四个落点分别堵住四个痛点:接入管“没读过”,手册和技能管“瞎编”,活数据和定时任务管“过期”,边界设计管“出门”。 换句话说:模型是租来的聪明,知识得是自己的家底,而千问办公干的就是“把家底接上、把规矩立住”这一段活。 三个岗位的一天,大概是这个样子: 行政——把制度文件夹授权出去,员工问报销、问请假、问门禁,答案带原文出处。 HR——招聘台账丢进去,问“按渠道统计本周面试转化”,它写公式、出表、给结论,异常数据标红。 财务——月度对账做成技能加定时任务,每月自动出简报推到群里,人只做复核。 这三个场景里,没有一步是“训练模型”,全是接上、授权、定规矩、让它跑。 这四步里不需要算法工程师,但每一步都需要有人把口径说清楚——门槛在人,不在技术。 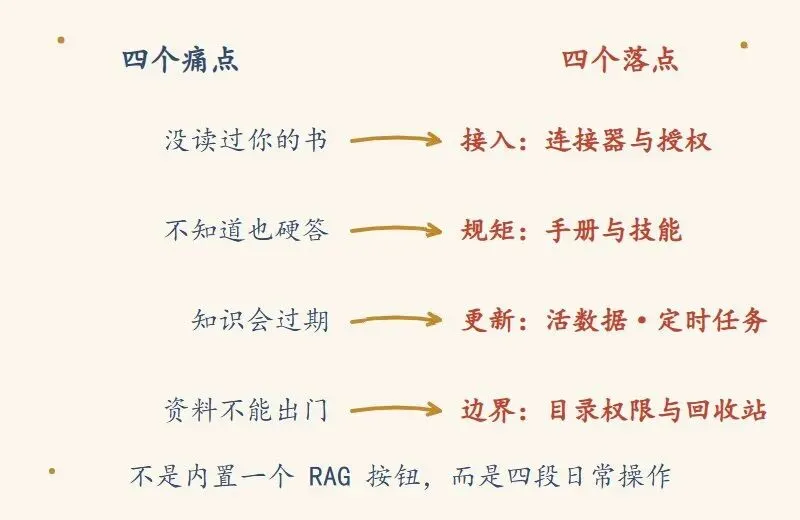
▍写在最后 如果你只想记一句话:企业知识库不是“建”出来的,是“用”出来的。 数据接得进、口径管得住、更新不用等、边界画得清——这四件事凑齐,AI 才算真的在你公司入职了。 下一篇我们回到技术本身:文档怎么入库、检索怎么做、权限怎么落,把 RAG 的两条链路逐个环节拆开。 口径与参考(三级分列):①已实测(本机本次任务真实发生)——本地文件夹授权与越界弹窗、改文件前先备份、删除走系统回收站、命令默认沙箱执行、跨会话记忆与工作手册生效、文献出处联网核对、三张正文配图与封面由本机 Chrome 无头渲染并按显示宽度复核。②尚未实测——云端定时任务未在本机实际创建运行,此处仅引用官方描述;企业版组织权限管控与私有化部署未实测。③二手转引——第三方报道中出现的“企业知识库问答”“1M Token 上下文”“私有技能库”“组织权限管控”“私有化部署方案”等为媒体与厂商侧说法,本文不作为实测结论;产品功能表述以官方文档为准(连接器、技能、意识、定时任务、个人网盘、我的网页)。④概念出处:RAG 见 Lewis P. 等《Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks》,NeurIPS 2020(arXiv:2005.11401),已于 2026-11-19 联网核对。