ARTICLE · 1399884
下载器做久了,都会长成浏览器插件
想下载 B 站某个多 P 视频的高清晰度版本,你复制链接,粘进下载器,得到的是一个页面地址,不是媒体文件。想录一场正在直播的赛事,浏览器缓存里躺着几千个分片,没有一个能直接点开。
这两件事的难点都不在「下载」。下载是网络活,人人都能干。难点在「拿到真正的地址」,而这一步根本不在下载器里,而在浏览器里。
Ghost Downloader 3 的选择是把这两件事合成一件。它带着一个浏览器扩展一起工作:扩展负责在页面里认出哪一个视频是你点的、媒体地址藏在哪里,桌面端负责把拿到地址的东西真的下载下来。中间隔着一条 WebSocket 通道,两端共享同一份登录状态。
这个项目 2023 年 8 月创建,起源很朴素,作者说是为了帮一位 B 站创作者管理素材。三年后再看,它已经不像一个下载器,更像一套围绕内容捕获搭起来的系统。
01 项目名称:Ghost Downloader 3
仓库有 881 个 fork、99 个 open issue,提交记录超过 1,700 次,最近一次推送在 2026-11-21。项目还带一套独立文档站 gd.xychr.com,基准测试、功能说明、插件开发指南都放在那里,甚至提供 llms.mdx 供大模型直接抓取。
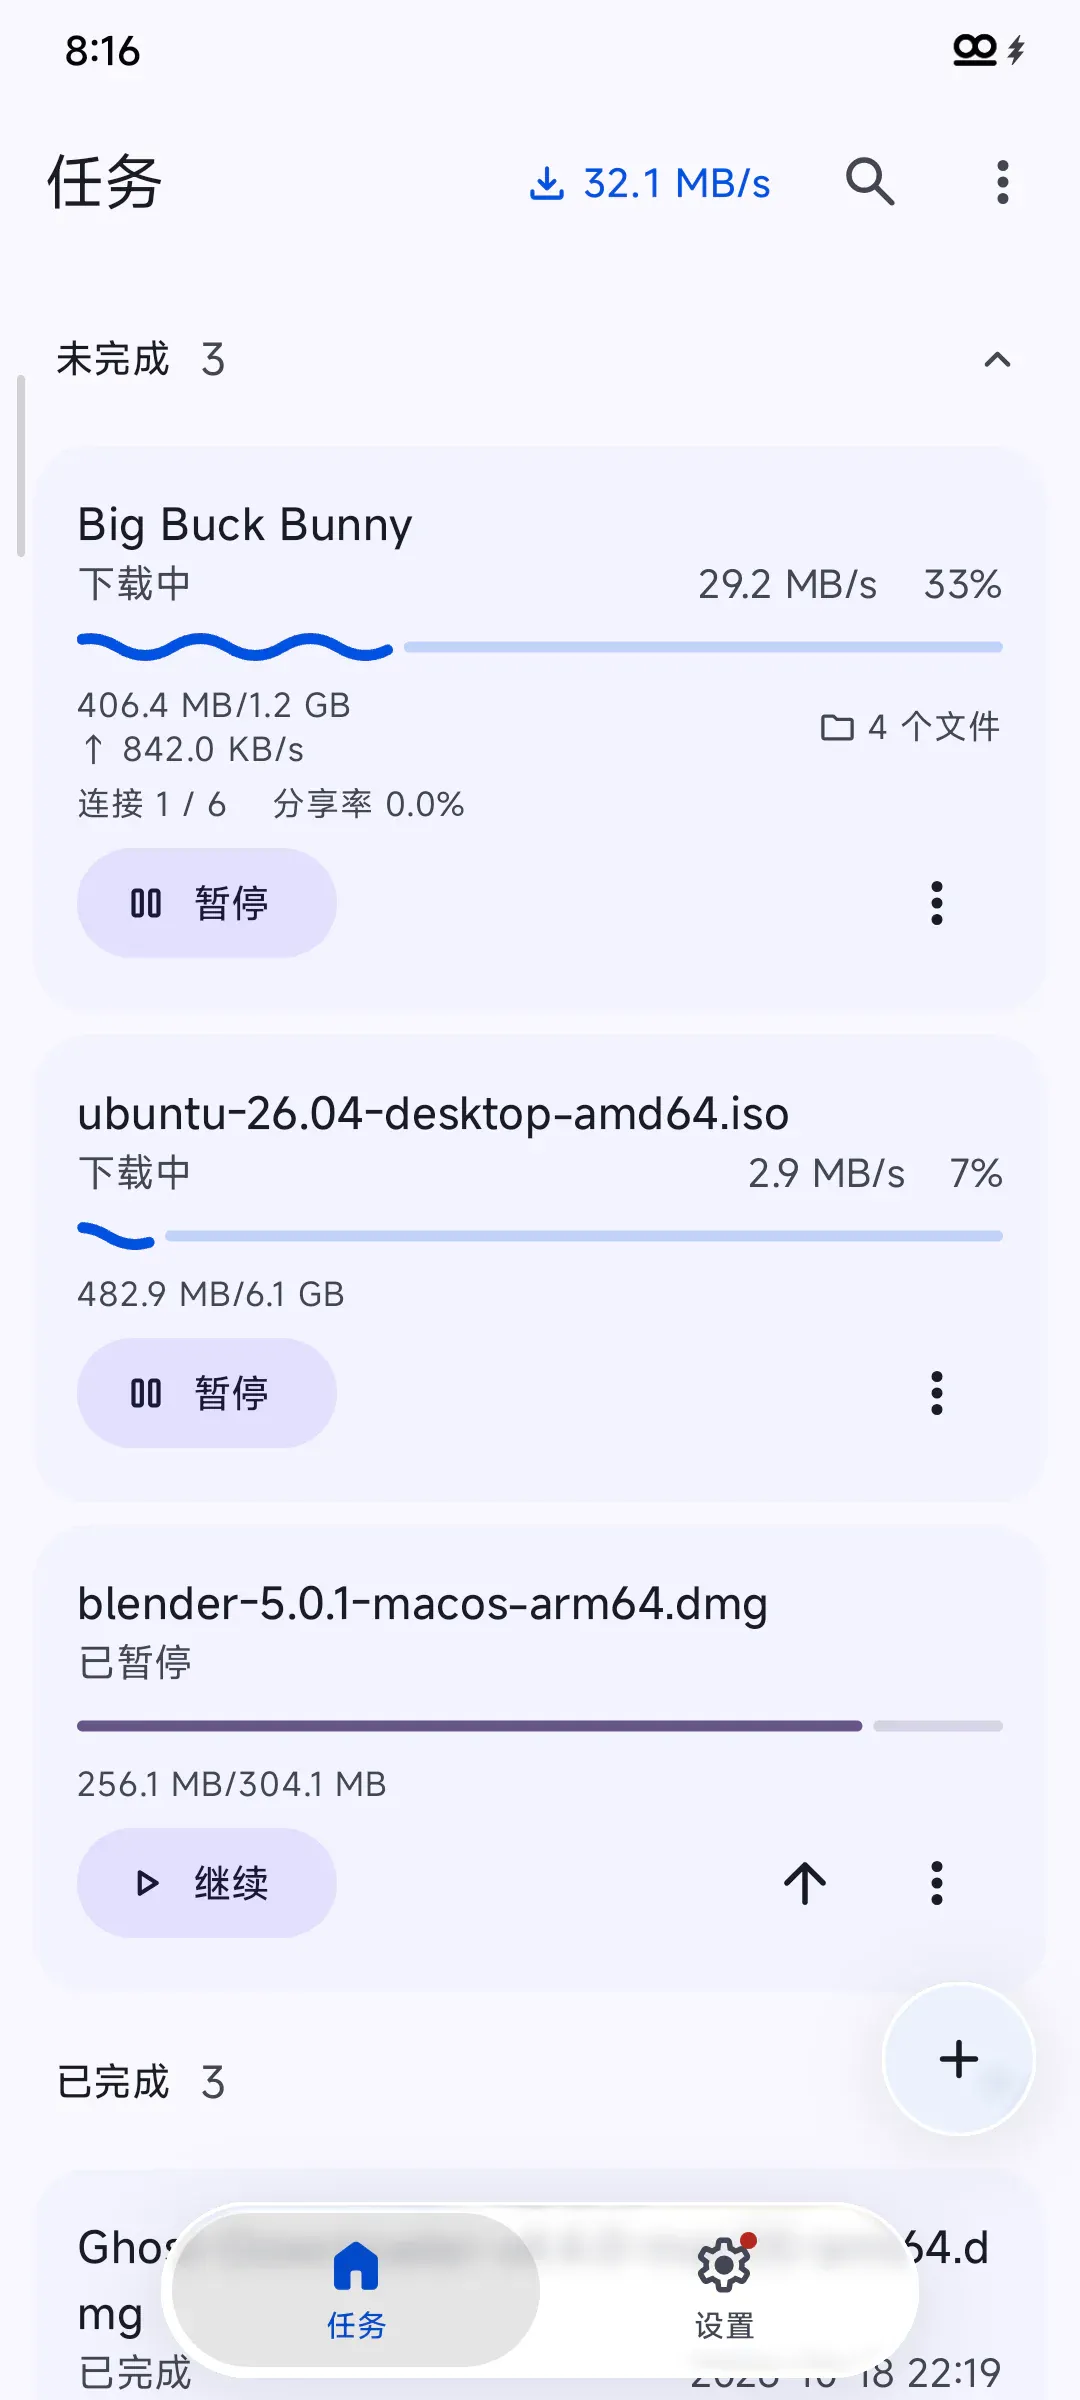
它同时覆盖四个系统。Windows、macOS、Linux 是桌面端,另有 Android 版;桌面端提供 x86_64 与 arm64,Android 只有 arm64-v8a。Android 端能录制直播 M3U8 并在后台继续下载,这点在同类工具里不常见。
项目作者是 GitHub 上的 XiaoYouChR,一位独立开发者。四端是四套独立安装的原生应用,扩展与桌面端之间走的是本机 WebSocket,任务不会自动在设备之间同步。
02 项目介绍:一个客户端,六类协议
六类协议,一个窗口
普通下载器通常只管 HTTP。Ghost Downloader 3 同时支持 HTTP/HTTPS、FTP、Magnet/BT、M3U8、MPEG-DASH 和 eD2k。
HTTP 下载走多线程,速度上不去会自动加线程,断点续传是默认行为,任务进行中右键还能改 URL、请求头和代理。FTP 粘贴 ftp:// 链接,如果指向目录就展开成文件树让你挑,代理只支持 SOCKS4 和 SOCKS5。磁力和 BT 交给 libtorrent,eD2k 用的是作者自己写的 Kelpie 引擎。M3U8 由 N_m3u8DL-RE 驱动,MPEG-DASH 有专门的解析器。
协议后面还有站点专用能力。YouTube 支持画质选择、字幕、播放列表和多 P;Bilibili 支持多 P 和清晰度选择;GitHub 与 HuggingFace 的 Release 提供镜像加速。这类站点每年都在改解析规则,能长期维护本身就是成本。
下载接管,登录态跟着走
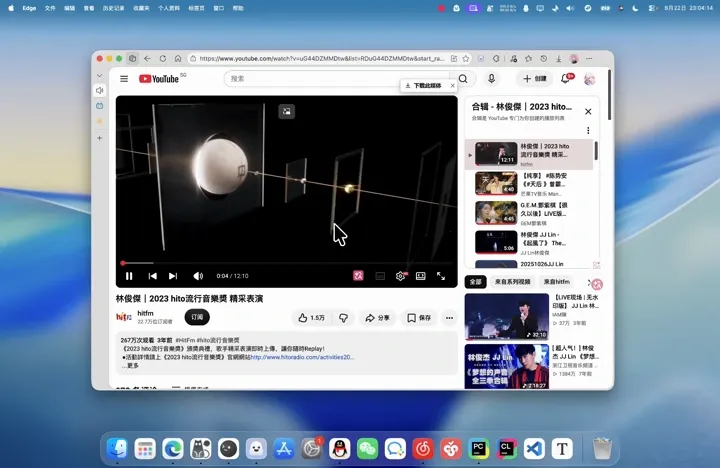
扩展做的是「资源嗅探」。鼠标悬停在播放中的视频上,会浮出一个下载按钮,点一下,扩展自动判断这是哪个视频、真实地址藏在哪,然后把任务推给桌面端。
按扩展图标打开资源列表,可以看到当前页面所有媒体请求。一页视频有多个清晰度时,每个清晰度都是独立条目;高清视频常把画面和声音分开传输,可以各选一条,走合并下载。HLS、DASH 流由桌面端解析分片,普通 MP4 直接下载。
更实用的一点是登录状态。扩展直接带上请求头和 Cookie,桌面端接着用,不需要你手动去复制链接,也不会因为「链接失效」重新折腾。
三个容易被忽略的细节
第一,扩展并不只服务本项目的桌面端。它兼容 Cat Catch 这类嗅探扩展的用法,也提供 aria2 兼容的 RPC API,第三方工具可以接进来。
第二,移动端不是功能阉割版。Android 端能录直播、能在后台继续下载,任务列表和桌面端是同一套逻辑。
第三,它选择 GPL-3.0 开源,并且把能力拆成可插拔的 FeaturePack。你可以读它的代码、拆它的包,也能给它加新站点。
快这件事,作者自己给了限定
README 里讲速度的方式很克制:每个下载器在好网速下都很快,真正的考验在坏网速下。它的做法是智能分块,不需要额外的文件合并步骤;同时自动探测带宽来调整并发。分块下载最怕的是把分片先落盘再合并,多一次磁盘往返,慢网下这一往返就够难看。
还有一条更少被下载器提及:它用真实浏览器的 TLS 指纹发请求,让反爬检测看不出来。这一条直接决定某些资源能不能开始下载。后面跑分表里那几处「反爬」,指的就是这类站点拦下了普通客户端的请求。
03 架构设计:拿地址和下载,被拆成两段
Ghost Downloader 3 是一个信号驱动的 actor 模型。每个 Service 持有自己的私有状态,对外只通过 Qt Signals 通信。依赖是单向的:
UI → Services → Models ← FeaturesUI 层可以随时替换,桌面端和 Android 端就是两套不同的 UI;Service 的行为不应该因为换了 UI 而改变。Features 不反向引用 UI,否则 Service 就会绑死在某个界面框架上。
一条任务走过的路
不管地址从哪来,任务都走同一条流水线:解析 → 入队 → 调度 → 执行。差别只在入口。
两个选择值得留意。
CoroutineRunner 用独立线程而不是把 asyncio 嵌进主线程,代价是多一次跨线程通信,收益是界面不会卡。任务快照推送每秒做一次全量字符串比较,作者的注释写得很直白:任务列表只有几十到几百条,增量跟踪要付出十倍代码,不划算。
浏览器桥:三层执行上下文
扩展与桌面端之间走 WebSocket,所有交互都是 JSON 消息。为什么不用 Chrome 的 Native Messaging?因为后者要为每个浏览器单独写 host manifest 并做平台注册,而 WebSocket 一个端口就能跨平台跑通。
真正难的是识别「你点的那个视频」。
现代播放器用 MSE(MediaSource)把视频分段喂给 <video> 元素,真实地址藏在 blob: 后面,一页里还可能有多个视频共用网络请求。扩展把这件事拆成三层:
MSE 探测(MAIN world)。注入到页面 JS 上下文,拦截 createObjectURL、addSourceBuffer、appendBuffer、fetch、XMLHttpRequest,记录每次 appendBuffer 调用,由此建立「哪个 <video> 消费了哪些请求」的证据,再通过 postMessage 送到隔离世界。这一层必须在 MAIN world 跑,隔离世界的 content script 拿不到页面的 MediaSource 实例。
归因引擎(ISOLATED world)。为每个 <video> 维护一个会话,分两级:临时归因靠启发式推断,比如 URL 里带视频 ID、时间顺序、页面上只有一个视频;锁定归因则要等 MSE 探测确认某个 SourceBuffer 真的消费了某个 URL 的数据,一旦锁定不可逆。信息流场景里浏览器会预取下一个视频的数据,这些 URL 先临时挂在当前会话上,等下一个 <video> 元素出现并完成绑定,归因引擎再把 URL 收回并锁给正确的会话。
站点策略(ISOLATED world)。按域名分发到对应的策略函数,策略拿到一份只读的会话快照,返回一个选择结果。之后是资源缓存,最后送到桌面端。
下载接管和外部扩展走的是另一条路:跳过页面媒体识别,直接从 Background 进入。
FeaturePack:把能力拆成可插拔的包
站点适配能力被拆成独立的 FeaturePack,每个包可以带解析器、任务卡片、文件类型、URI 协议和独立运行时。
优先级数字小的先匹配,第一个 match() 返回 True 的解析器接管这个 URL。所以通用 HTTP 放在 100,是最后兜底的那个。jack_yao 只提供应用内的资源下载目录页面,没有解析器,在发布脚本的黑名单里,不进正式版;Android 构建还会额外剥掉 bittorrent_pack、ed2k_pack 和 jack_yao。
Python 怎么变成四个系统的原生应用
一个 Python 项目要交付 Windows 的 Setup.exe、macOS 的 dmg、Linux 的 AppImage 和 Android 的 apk,绕不开打包这一步。项目的致谢名单里能看到 Nuitka,这个 Python 编译器负责把源码编译成原生二进制。
这也解释了它的安装包形态:四个平台的产物是各平台自己的原生包,而不是「一个脚本加一堆依赖」。代价是构建链更重,好处是用户拿到的就是一个正常软件,不需要先装 Python 环境。
04 快速上手:准备好的是浏览器,不是客户端
正式版安装包在 GitHub Releases,按平台提供 Windows 的 Setup.exe 与 zip、macOS 的 dmg、Linux 的 AppImage、deb 与 tar.xz,以及 Android 的 apk。v4.5.11 的发布页里,Windows x86_64 安装包下载数已过 6,000 次,macOS arm64 的 dmg 约 2,100 次,Android apk 约 3,400 次。
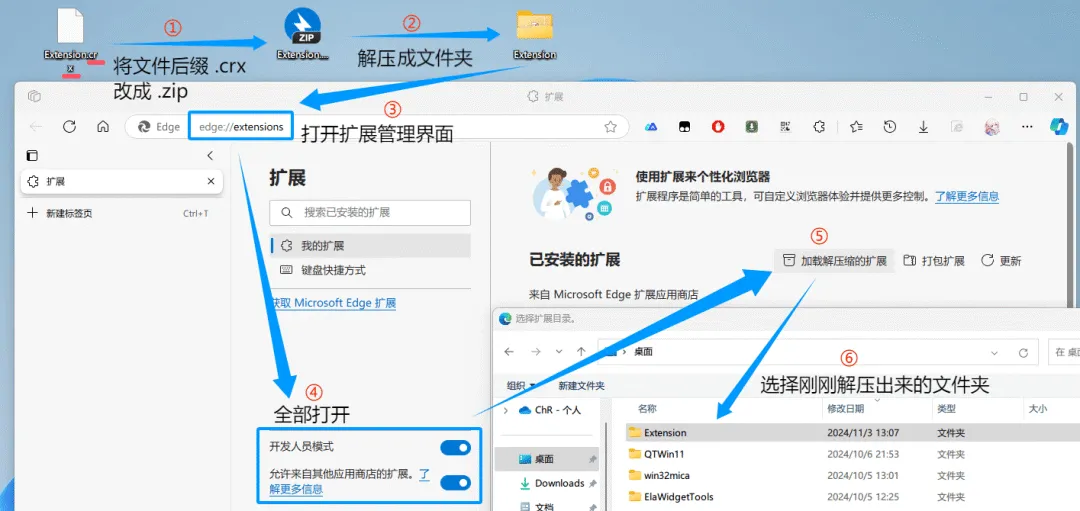
.crx 手动装载(给受限环境准备的那条路)。
手动那条路的官方步骤是:把导出的 .crx 文件后缀改成 .zip,解压成文件夹,然后打开浏览器的扩展管理界面,打开开发者模式,选择「加载解压缩的扩展」,指向上一步解压出来的文件夹。
先装客户端,再装扩展并配对。扩展装好后必须和运行中的桌面端完成配对,才能发出下载请求;桌面端会弹出配对请求点允许就行,自动配对没反应时,可以在桌面端「设置 → 浏览器扩展」复制配对令牌,粘到扩展设置里。配对成功后,扩展面板顶部会显示已连接。
装好之后三类任务各有各的入口。普通文件和 FTP 链接直接粘贴;磁力链接同样粘贴;网页视频用扩展,在视频上点浮出的下载按钮,或者从资源列表里挑。YouTube 和 Bilibili 由桌面端接管,其余站点走「先探测流 → 分轨合并 → 单文件」的通用策略。
如果弹出「发现多个媒体资源」的提示,说明页面上有多条流没法自动判定,去资源列表手动选。高清视频的音视频分轨要等两条都抓到才能合并,点完按钮后如果出现等待提示,继续播放几秒再试。
05 实战场景:它解决的是「拿到地址」那一段
多 P 教学视频,按清晰度分批下
一个几十 P 的课程合集,真正要的是其中几节的最高画质。扩展在每一集上都能定位到可用清晰度,桌面端接收后按队列跑。队列里同时躺着 BT 种子和其他站点包,任务之间互不干扰,暂停和继续也按任务独立保存。
只有分片的直播
赛事直播通常只给 M3U8。桌面端解析分片清单并按序下载,FFmpeg 负责合并。Android 端和桌面端共用同一套代码,核心下载能力一致,也能接收扩展推送过来的任务,只是各自管理各自的队列。
做开源项目的人常同时面对这几类东西:GitHub Release 的安装包、HuggingFace 上的模型权重、内部网盘上的镜像。GitHub 和 HuggingFace 都有对应的特性包,Release 下载走镜像加速。下载目录还能按文件类型自动分类,装完不用手动挪。
官方跑分怎么看
项目文档站放了一份自己做的跑分,2026-07-30,Windows 11,重庆电信 1000 Mbps、IPv6、不走代理,每项只跑一次不取平均,对比对象是 IDM 6.43 Build 7、Motrix Next v3.9.6 和 Gopeed v1.9.3。
| 1.07s | |||||
| 11.83s | |||||
| 11.07s | |||||
| 3.40s | |||||
| 6m14s | |||||
| 5m59s |
最快次数 Ghost Downloader 拿 5,Motrix Next 拿 1,IDM 和 Gopeed 都是 0;完成数 6/6、6/6、6/6、3/6。
这份表有两个地方需要自己留意。OneDrive 那行,Ghost Downloader 和 Motrix Next 用了 128 个连接,IDM 和 Gopeed 用 32 个,条件并不对等,作者在正文里专门标了这一点。另外作者自己写明,结果对时段和路由很敏感,同一个链接换个时间测可能差几倍。也就是说,这是一份单次跑分的记录,不是稳定结论。
浏览器接管这一项,四个站点里 Ghost Downloader 和 Motrix Next 都是 4/4,IDM 和 Gopeed 都是 3/4,Claude.ai 上 IDM 明确未被拦截。媒体嗅探测了 23 个站点,Ghost Downloader 与 IDM 的完全支持、部分支持、不支持数量完全一致,都是 18、2、3,差异在具体站点:Bilibili 上它能拿到任意画质,IDM 最高 720P;看看直播的 M3U8 它能直接拿到,IDM 不行;NNYY 视频它能拿到完整文件,IDM 只能拿到 TS 分片。反过来,优酷和腾讯视频它嗅探不到,因为是 DRM 加密,作者明说 IDM 可以。作者的结论是用场景决定胜负。
哪些人现在值得试,哪些人应当先等等
值得试的是这样一类人:经常需要从网页上抓视频或直播,下载源混杂,手机和电脑各装一套、任务分开管,并且愿意自己读一点代码确认行为。
应当先等等的是这样一类人:只想下一个直链文件,浏览器扩展和 FeaturePack 对你完全是负担;或者你的核心需求在 DRM 内容上——优酷、腾讯视频、爱奇艺这条线它过不去,这是加密的限制,不是什么版本能修好的问题。
还有一条现实提醒。Qt 6.6 起要求 CPU 支持 AVX,这个项目用 Qt 是它的优点也是它的门槛。老旧机器跑不动桌面版时,可以先在 Android 上试试。
06 总结:真正的护城河在浏览器那一端
下载速度是可以被追平的,多线程和自动加线程这套玩法,任何一家认真做都能做出来。Ghost Downloader 3 值得单独写一篇文章的理由在另一处:它承认「拿地址」才是真问题,并且把这件事做进了浏览器扩展里。
blob URL 的逆向归因、预取导致的会话错位与回收、登录态继承、音视频分轨合并、直播录制与后台续传,这些工作都不性感,却需要大量时间和反复踩坑。三年下来,1,700 次提交攒下来的正是这层经验。
GPL-3.0 加 FeaturePack 的组合,让这套经验可以被拆开重组。站点解析器是一个个独立包,优先级数字决定谁先匹配,外部运行时(N_m3u8DL-RE、yt-dlp、libtorrent、FFmpeg)也都能替换。官方文档甚至把怎么写一个自己的包写成了教程。
它当然有代价。装扩展要先开桌面端再配对,比双击一个 exe 麻烦,Qt 6.6 的 AVX 门槛会让一部分老机器直接出局,DRM 站点永远过不去。而且它长期占着一个下载器的位置,而这位置从来不缺竞品。
GPL-3.0 也带来一条现实约束:改动后的版本需要继续以 GPL 发布。想在闭源产品里借用它的代码,或者把它改名后当成自己的工具,这条路走不通。这对喜欢拆包改造的人是约束,也是一种保护——它让三年来攒下的站点解析经验不至于被人闭源收走。
我更愿意关注的是它接下来把「浏览器」这条边界往哪儿推。当一个下载器开始认真处理页面级的内容归属,它就不再是下载器了,它更像是在替浏览器做一件浏览器自己没做好、也越来越做不好的事。
接下来我会去看它的 FeaturePack 生态。如果有人愿意为它写站点包,那这套架构就真的立住了。