夜雨聆风
GitHub地址:github.com/sudoprivacy/hydra(MIT 协议,TypeScript 编写)
我为什么关注到这个项目
最近我越来越明显地感觉到一个问题:AI 编程不是不够聪明,而是我没法同时用好多个 AI。
Claude 适合帮我拆方案,Codex 适合进代码库执行,Gemini 适合看截图和 UI 反馈。但真实工作里,我经常要在几个终端、几个会话、几个任务之间来回切。Hydra 解决的不是「让某个 AI 更强」,而是让你同时调度多个 AI Agent 并行干活。
一句话理解 Hydra
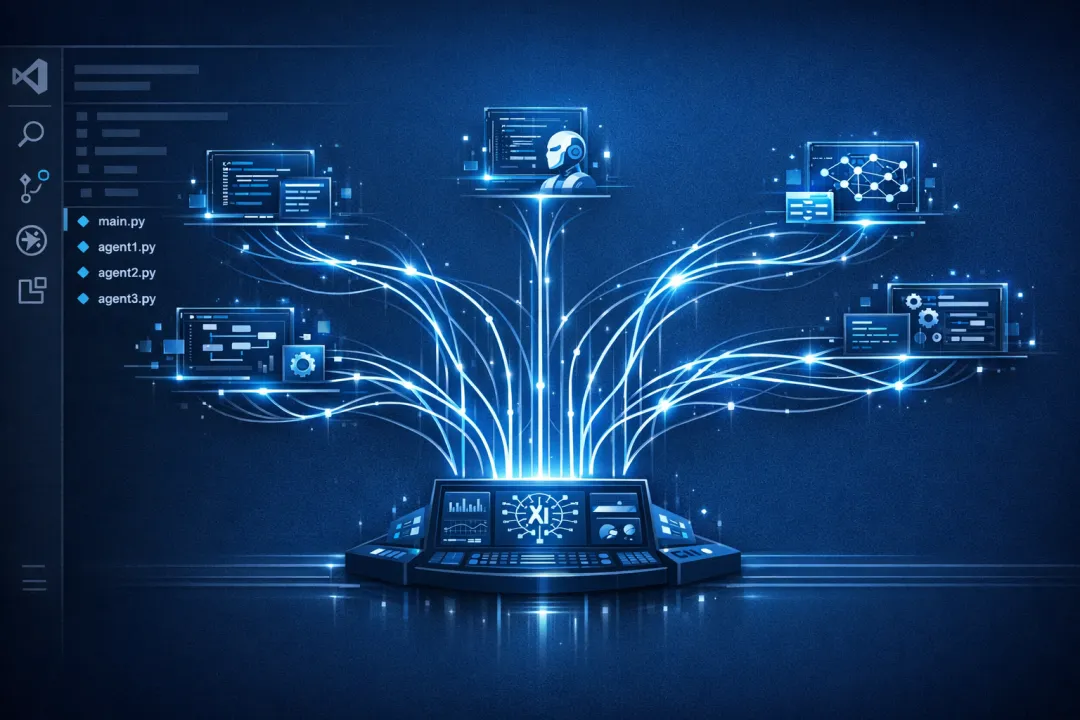
Hydra 是 sudoprivacy 开源的一个 VS Code 扩展,核心理念就一句话:让你同时派发多个 AI 编程 Agent 并行干活,而你在侧边栏当总指挥。
如果说你平时用 Claude Code 或 GitHub Copilot 是一个「一对一」的结对编程体验,那 Hydra 就是一个「一对多」的项目经理模式。它解决的痛点非常实在——你有一堆任务要做,但每次只能跟一个 AI 对话,等它干完才能切下一个,时间全浪费在「等」上了。
以前:开一个终端问 Claude → 等它分析完 → 切到 Codex 执行 → 再打开 Gemini 看 UI中间不断复制上下文、切目录、追进度
用了 Hydra:Copilot 负责拆任务 → 多个 Worker 同时跑 → 每个 Worker 有自己的分支和 worktree你在 VS Code 侧边栏看状态、进终端、review diff
它到底怎么用?一个真实场景
假设今天要做一次活动平台的改版。传统做法是你跟 AI 一个接一个来——先让 Claude 读旧逻辑整理迁移清单,再切到 Codex 去改接口,再切回去写测试,最后找 Gemini 看 UI 截图调整样式。每一步都要等上一步结束,时间全花在「切」上了。
用 Hydra 的流程是这样的:
1启动 Copilot(总指挥)
在 VS Code 侧边栏点「Create Copilot」。这个 Copilot 是你的「技术主管」,它的职责不是写代码,而是分析任务、拆分任务、监控进度。
你跟它说:「帮我拆一下活动平台改版的任务:读旧逻辑梳理清单、改接口和数据结构、补测试、调 UI 样式。」
2一键生成 Worker 军团
Copilot 分析完后,一条命令下去,4 个 Worker 同时被创建,分别对应读旧逻辑、改接口、补测试、调 UI。每个 Worker 自动拥有:
一个独立的 git worktree(在
~/.hydra/worktrees/下,不会污染你的主工作区)一个独立的 git 分支(比如
feat/migration-list、feat/api-refactor……)一个绑定好的 AI agent(可选 Claude、Gemini、Codex)
3坐在侧边栏前看它们干活
你的 VS Code 侧边栏变成了一个「作战指挥中心」:
实时看到每个 Worker 的 CPU 使用率
看到它们的终端输出滚动
看到每个分支落后/领先 main 多少个 commit
随时一键 attach 进任意 Worker 的终端
4审查 & 合并
某个 Worker 干完了,侧边栏会有提示。你切进去 review diff,满意了就合并分支,不满意就追加指令让它继续改。你自己只负责拆任务、看 diff、合并结果。
关键设计细节
这些才是最精彩的部分。
1. Git Worktree 隔离 —— 解决「幻觉」和「冲突」
这是 Hydra 最巧妙的设计。每个 Code Worker 有自己的 git worktree,物理隔离在不同的文件夹里。这意味着:
Worker A 改
auth.ts绝对不会和 Worker B 改auth.ts产生冲突,因为它们在两个独立的 worktree 里Agent 不会「看到」其他 Worker 的代码,减少了上下文污染导致的幻觉
最终合并时再解决冲突,符合正常的 git 工作流
2. tmux 持久化 —— Agent 永不掉线
所有 Worker 都运行在 tmux session 里。你关掉 VS Code、断开终端、断开 SSH——Worker 还在跑。这个设计意味着你可以在睡觉前派发任务,醒来验收成果。
3. Repo Registry —— 告别手动 clone
你可以把常用的 repo 注册进去:
hydra repo add sudoprivacy/hydra以后创建 Worker 直接用 --repo sudoprivacy/hydra 就行,Hydra 会自动在 ~/.hydra/repos/ 下维护一个干净的 clone,每次创建 Worker 前自动 git fetch,永远基于最新的 main 分支。
4. Autonomous Mode —— 让 Agent 放飞自我
启动 Worker 时可以选择自主模式,Agent 的所有权限自动批准,不需要你每次手动确认。适合那些你完全信任的任务类型,比如格式化代码、批量重命名、生成文档等。
上手门槛
安装非常简单:VS Code 插件市场搜索「Hydra Code」即可。前置条件是系统装了 tmux 和 git,macOS 上 brew install tmux 就搞定。
CLI 命令也相当直观:
# 创建一个 Code Worker hydra worker create --repo . --branch feat/my-feature # 创建一个 Task Worker(不需要 git 的场景) hydra worker create --dir ~/Desktop/research --task "调研竞争对手" # 设置默认 Agent hydra config set default-agent claude # 查看 repo 注册列表 hydra repo list我的一些观察和思考
适合什么人?
我觉得 Hydra 最适合三类人:
独立开发者——同时有多个功能、bug、文档和测试要处理,一个人就是一个团队
小团队技术负责人——需要把任务拆给不同 AI Agent 并行推进,自己只负责 review
重度 AI 编程用户——已经在 Claude Code、Codex、Gemini CLI 之间频繁切换,需要一个统一调度台
不适合什么场景?
如果你的任务是强耦合的——比如重构一个核心模块,每一步都依赖上一步的结果——那 Hydra 的并行优势就难以发挥。这种场景还是老老实实一个 Agent 串行做。
潜在风险
多个 Agent 同时在同一个 repo 的不同 worktree 上改代码,最终的合并冲突是不可避免的。Hydra 把「隔离」做到了极致,但「合并」这个环节目前还是需要人来处理。好在每个 Worker 的改动都被 git 管理得清清楚楚,review 起来不会太痛苦。
关于隐私
项目有匿名的遥测机制(PostHog),收集的是功能使用数据(比如创建了多少个 Worker、用的什么 Agent),不收集代码、prompt、仓库名等敏感信息。可以通过 HYDRA_TELEMETRY=0 关闭,也可以设 HYDRA_TELEMETRY_DEBUG=1 在本地查看所有事件日志。
总结
Hydra 是一个思路非常清晰的工具——它不做 AI 本身,而是做 AI 的「调度器」。它承认了一个现实:单线程跟 AI 协作已经不够用了,你需要的是并行。最难能可贵的是,它的隔离设计(git worktree + tmux)让并行不只是「快」,更重要的是「稳」——不会因为并发导致文件冲突、上下文污染这些让人头大的问题。
项目还在早期阶段,但工作流方向很清晰。它不是另一个 AI 编码模型,而是一个多 Agent 调度层。对已经重度使用 Claude Code、Codex、Gemini CLI 的人来说,这个方向很值得试。适合重度 AI 编程用户尝鲜,也适合对多 Agent 工作流感兴趣的人参与共建。