 夜雨聆风
点击上方蓝字⬆,关注我公众号 !
起因:看到得不到
PDF 文件加密防复制很常见:
• 复制密码很弱,n多工具都可以直接移除,python脚本也可以; • 打开密码好像不好破解,只能上字典,但不给密码也没法传播; • 图片型文件也能阻止复制,但文件体积要么很大,要么文字比较模糊。
除此之外,还有一类文件,少见一些,不是图片PDF:文字是矢量字形,可选中(但选中后复制为乱码)
• 视觉显示正常:中文文字清晰可见,放大没问题 • 复制时乱码:粘贴出来是 \x01 \x02 !"#$等无意义字符就像下图这样:
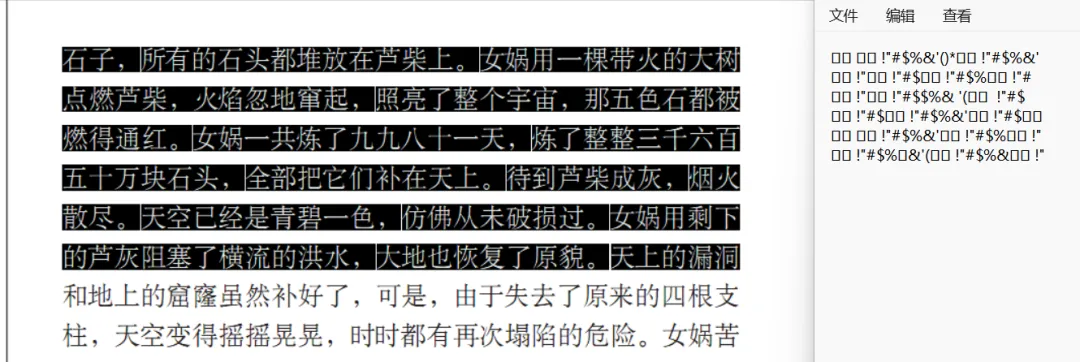
资料太少
过去十几年,有时闲了也试着查一下,指向字体问题,但都讲不清楚,一忙就又放下了。
昨天又翻到一份文件,忽然想到应该丢给AI研究一下,就是上面那一份。
AI 直接回:应该先转成图片,然后OCR。
哈哈,想偷懒,不能放过它。提要求:目的不是将其内容提取出来,因为转图片,OCR一定能得到一个结果;
• 1、搞清楚其方法实现方法,并且初步实现,例如我这有一个纯文字的PDF,能转成这样的文件就算成功; • 2、讲清楚转换方法,例如其实文件里存的是字体,用字体画出来; • 3、能将这种加密的页面中不使用OCR方法,转成文字txt,或者讲清楚为什么搞不出来; • 4、要把这个工作看做解密,当然也可以搜集网络资料,而不是一定自己傻算;
然后睡觉,睡醒之后结果早就来了:
PDF FakeFont 防复制技术研究报告
研究目标
1. 搞清楚实现方法:理解FakeFont防复制的技术原理 2. 正向实现:将普通文字PDF转换为防复制PDF 3. 逆向恢复:将防复制PDF还原为文字TXT(不直接使用OCR提取,但可用OCR辅助建立映射)
PDF文字的双通道模型
PDF的文字处理有两条完全独立的通道:
| 通道 | 作用 | 依赖的数据 | 破坏影响 ||--### --|------|-----------|---------|| 视觉渲染通道 | 在屏幕上画出文字像素 | 字形轮廓数据(CFF/FontFile中的贝塞尔曲线) | 破坏→文字看不见 || 文字提取通道 | 复制/搜索时获取Unicode文字 | ToUnicode CMap(字形编号→Unicode映射表) | 破坏→复制得到乱码 |
核心洞察:两条通道完全独立。破坏ToUnicode不影响视觉显示,破坏字形轮廓不影响文字提取(但提取到的是原始编码而非汉字)。
FakeFont防复制技术详解
整体架构
原始PDF: 防复制PDF (FakeFont):┌─────────────────────┐ ┌─────────────────────┐│ 内容流: <4E2D> Tj │ │ 内容流: <01> Tj │ ← 编码改为无意义序号│ 字体: SimSun │ │ 字体: FakeFont-001C9E57 │ ← 每段文字独立字体│ ToUnicode: 4E2D→中 │ │ ToUnicode: 01→(空格) │ ← 映射被破坏/伪造│ CFF: 字形"中"轮廓 │ │ CFF: 字形"中"轮廓 │ ← 轮廓数据保留(不变)└─────────────────────┘ └─────────────────────┘视觉: "中" ← 靠CFF轮廓画出 视觉: "中" ← 同样靠CFF轮廓画出 ✓复制: "中" ← 靠ToUnicode映射 复制: " " ← ToUnicode被破坏 ✗三个核心手法
手法1:每字一字体(极端子集化)
• 每个文字片段创建独立的FakeFont实例 • 每个FakeFont仅包含1~22个字形(平均6.6个) • 即使同一个"的"字出现100次,也会创建100个独立字体 • 第1页:197个FakeFont,1301个字形 ≈ 1297个字符
手法2:字形编号重映射
• 原始Unicode编码(如0x4E2D)被替换为无意义序号(0x01, 0x02...) • 总共只有22种编号(0x01, 0x02, 0x20~0x33) • 同一编号在不同字体中对应完全不同的汉字 • 例:编号0x01在197个不同FakeFont中都使用,每个对应不同的汉字
手法3:CFF字形名混淆
• 原始字形名(如 uni4E2D)被替换为通用占位符(.null、space、nonmarkingreturn)• 完全抹除可推断Unicode的命名线索 • ToUnicode CMap被删除或伪造(只映射空格0x20)
CFF字体程序深度分析
对前10个FakeFont的CFF数据进行了二进制级解析:
• CFF Header、Name INDEX、Top DICT INDEX、String INDEX、Global Subr INDEX
• 解析Charset(字形名列表)、CharStrings(字形绘图程序)、Encoding(编码映射) • 使用fontTools 4.58.0和手动二进制解析双重验证
关键发现
| Charset | .null/space/nonmarkingreturn等通用名 | |
| CharStrings | ||
| Encoding | ||
| String INDEX | .null、字体名) | |
| ToUnicode (PDF层) |
结论:CFF字体程序内部不包含任何可用的Unicode信息,无法从字体数据直接恢复文字。
字形数量分布
| 合计 | 197 | |||
总字形数 = 1301(所有FakeFont字形之和),几乎等于页面字符数1297。
正向转换器实现方案
核心原理:对PDF中每个字体对象,添加/替换假的ToUnicode CMap,使文字提取通道失效,同时不触及字形轮廓数据。
关键发现:对于Type0字体(如STSongStd-Light),原本可能没有ToUnicode而是靠/Encoding(如GBK-EUC-H)解码。单纯删除ToUnicode无效,必须添加假的ToUnicode覆盖Encoding回退路径。
正向转换器假ToUnicode CMap设计
FAKE_TO_UNICODE_CMAP = b"""/CIDInit /ProcSet findresource begin12 dict beginbegincmap/CIDSystemInfo << /Registry (Adobe) /Ordering (UCS) /Supplement 0 >> def/CMapName /Adobe-Identity-UCS def/CMapType 2 def2 begincodespacerange<00> <FF> # 1字节编码空间<0000> <FFFF> # 2字节编码空间endcodespacerange2 beginbfchar<20> <0020> # 空格 → 空格<0020> <0020> # 2字节空格 → 空格endbfcharendcmapCMapName currentdict /CMap defineresource popendend"""设计要点:
• 覆盖1字节和2字节编码空间,确保所有编码都被假CMap接管 • 仅映射0x20→空格,其余编码未映射→复制时得到空白/乱码 • 使用Adobe-Identity-UCS标准CMap名称,兼容所有PDF阅读器
正向转换器实现代码
正向转换函数:forward_convert(input_pdf, output_pdf)
• 用pikepdf打开PDF • 遍历所有页面的字体资源 • 对每个字体对象设置 /ToUnicode为假CMap流• 保存为新PDF
验证函数:verify_forward(input_pdf, protected_pdf)
• 对比原始和防复制PDF的文字提取结果 • 渲染对比验证视觉一致性 • 检查中文是否已被破坏
正向转换器测试结果
改变中国影响世界... | ֻ两个月ࢃğ༝࣍... | ||
看看实际效果吧:
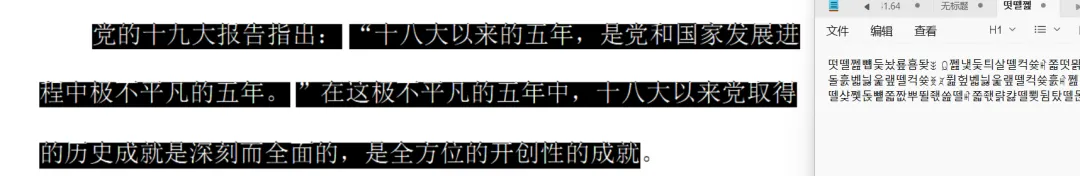
正向转换器的局限
1. 未实现"每字一字体":当前方案只破坏ToUnicode,未做字体子集化重编码 2. 理论上可被ToUnicode重建工具修复:如PDFontFixer等工具可通过OCR重建映射 3. 更彻底的方案需要用fontTools做字体子集化+字符编码重映射+重写内容流
逆向恢复为什么不能用纯字体数据分析
CFF分析已证实:
• 字形名全部混淆( .null/space),无uniXXXX编码名• 无ToUnicode或ToUnicode被伪造 • CharStrings是纯绘图程序,无语义信息 • 唯一恢复途径:OCR渲染图 + 位置匹配建立映射表
逆向恢复实现方案
防复制PDF │ ├── PyMuPDF get_text('rawdict') ──→ 每个字符的(font, code, bbox) │ ↓ ├── PyMuPDF render(2x) ──→ 高清图片 │ │ │ └── PaddleOCR ──→ OCR文本行(bbox, text) │ │ bbox位置匹配 ←─────┘ ↓ (font, code) → 汉字 映射表 ↓ 遍历全部字符 → 还原全文TXT逆向恢复关键技术点
原始字符提取
使用PyMuPDF的get_text('rawdict')而非get_text('dict'):
• rawdict返回的'c'字段是原始字节按latin1解释的字符• ord(c['c'])得到字形编号(0x01, 0x02等)• 每个字符附带 bbox(页面坐标)和font(字体名)
CropBox扩展
测试PDF的页面有rotation=270°且CropBox小于MediaBox:
• 默认渲染会裁剪掉CropBox外的文字 • 解决方案:临时将CropBox设为MediaBox,渲染后恢复
page.set_cropbox(page.mediabox)pix = page.get_pixmap(matrix=fitz.Matrix(scale, scale))page.set_cropbox(original_cropbox) # 恢复PaddleOCR 3.x API适配
PaddleOCR 3.4.0有重大API变更:
• show_log和cls参数已移除• 使用 predict()而非ocr()接口• 返回格式从 [bbox, (text, conf)]变为分离字段:• dt_polys: list of np.ndarray shape (4,2),4角点像素坐标• rec_texts: list of str,识别文本• rec_scores: list of float,置信度
初始化参数:
ocr = PaddleOCR( lang='ch', use_doc_orientation_classify=False, use_doc_unwarping=False, use_textline_orientation=False,)bbox匹配算法
OCR返回4角点坐标,PyMuPDF返回矩形bbox,需要转换匹配:
1. 坐标转换:OCR像素坐标 ÷ 缩放倍数 + 渲染区域偏移 = 页面坐标 2. 匹配条件: • 垂直:字符中心在OCR行的垂直范围内(带50%行高容差) • 水平:字符bbox与OCR行bbox有重叠 3. 对齐策略: • 数量一致:1:1逐一对齐 • 数量不一致:按比例插值对齐(按x坐标排序) 4. 投票机制:同一(font, code)可能被多个OCR行匹配,取投票最多的汉字
文本重建
• 按字符的(y_center, x_center)排序成阅读顺序 • 估算行高(取字符高度中位数) • 相邻字符y差超过0.8倍行高时插入换行 • 未映射的字符用 □标记
逆向恢复测试结果
恢复的部分文字样例:女娲、石头、宇宙、芦柴、神、国、整、中、全、代、话、故、事、集
实际效果:
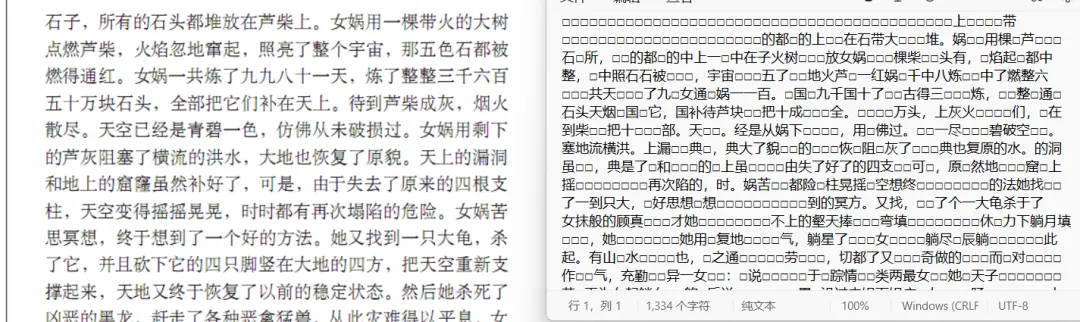
网络资料调研
PDFontFixer工具
发现了一个专门工具 PDFontFixer v1.5(52pojie.cn论坛):
• 原理与本研究的逆向恢复方案完全一致 • 用OCR识别PDF中每个字形的Unicode编码 • 将编码做成ToUnicode映射表保存到PDF字体中 • 使用轻量OCR小模型,CPU即可快速识别印刷体汉字 • 实测准确率接近100%(不含特殊符号) • 人工审核OCR结果并进行个别校正
结论
FakeFont防复制的本质是利用PDF双通道模型的分离性:
• 视觉通道(字形轮廓)保持完整 → 显示正常 • 语义通道(ToUnicode映射)被破坏 → 复制乱码
写在最后
通俗一点说吧就是已有一个PDF文件,将文字以随机长度,嵌入一一个字库,因为只有几个字,所以就可以1,2,3这样排,而字型维持原来的轮廓,所以去复制,无论什么字都是0x01,0x02之类的;加密看起来比较好弄,AI搞出来的脚本,已经勉强可用了;要恢复 ,确实是可行的,只是AI没干到底,但文件如果嵌入字体太多也麻烦的很;PDFontFixer v1.5这个程序做的更好一点,但因为没提供全自动识别功能,所以也不太可用
纯兴趣,到此为止吧
尽信AI不如无AI,不用AI迟早卖白菜。
------------END ------------
相逢是缘,都看到这里了就关注下再走吧。