 夜雨聆风
七月的最后一天,一封离职信在硅谷掀起波澜。这次的焦点落在他走的时候说了什么。
2026年7月29日,OpenAI研究员 Andrew Ho 在 X 平台上发出一条长帖。开头很常规:"今天是我在OpenAI的最后一天。" 接下来的内容却像一把手术刀,精准地切开了整个AI产业正在化脓的伤口。
他说:大模型的泛化能力,明显很差
他说:哪怕砸了上千亿美元训练编程能力,他仍然得亲手给模型生成的代码擦屁股。
他说:那些更稀缺的能力,数据根本还没准备好。
然后,他宣布创业了
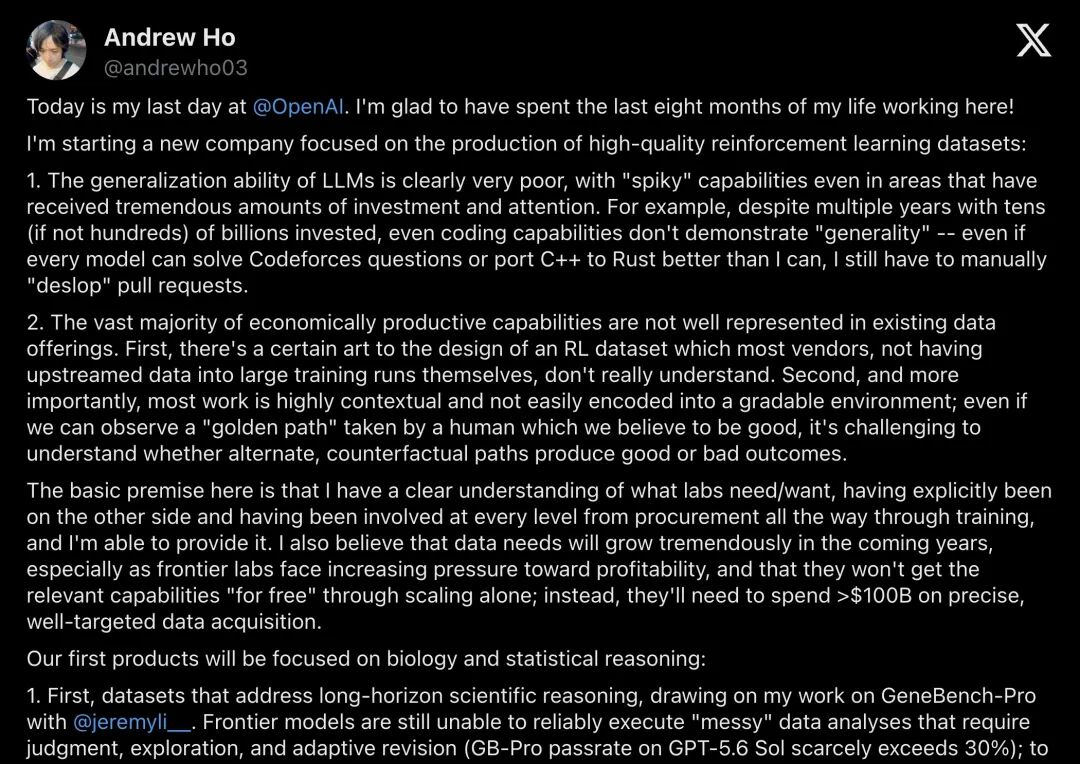
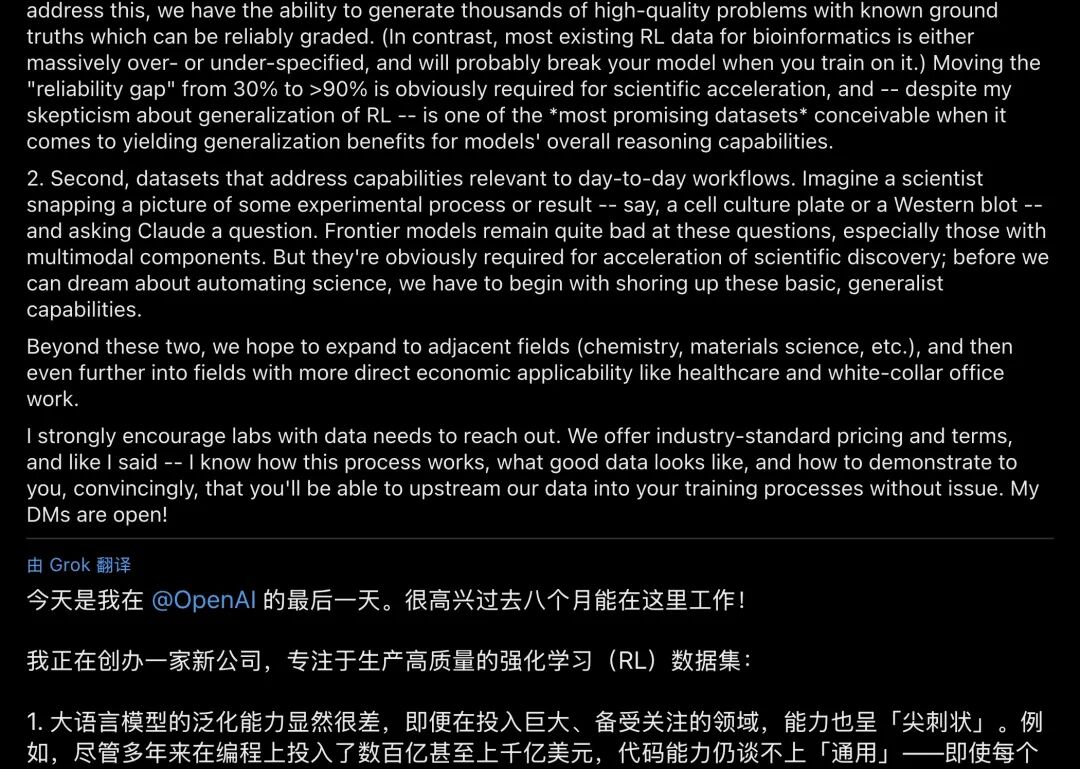
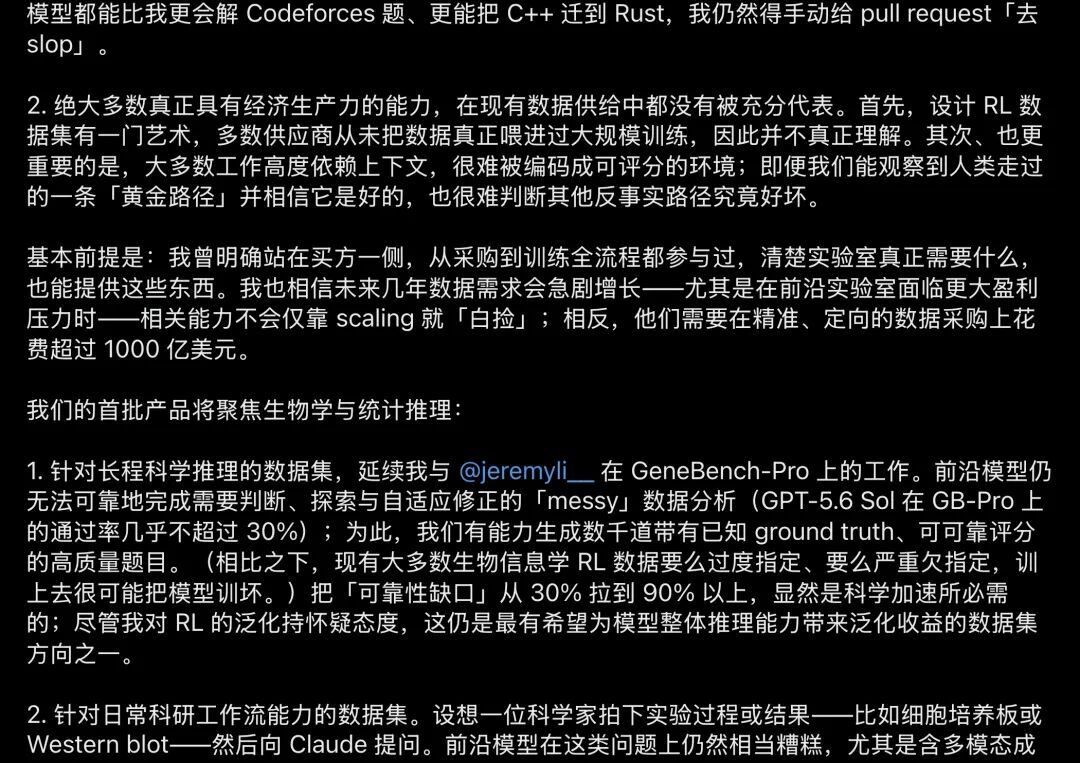
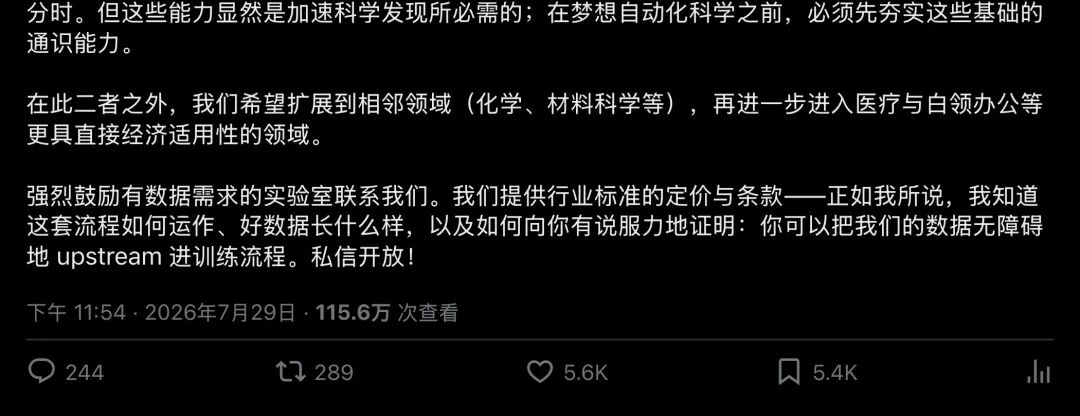
▲ Andrew Ho 离职声明原帖,互动量惊人,一个前员工的"自白",比多数产品发布会更有信息量
"Deslop":开发者的共同痛点
整条帖子里,最让开发者们集体破防的是一个词,deslop。
什么意思?"Slop"在AI编程圈已经快成脏话了:指的是模型生成的那些看起来能跑、实际上冗余、风格漂移、跟仓库规范完全脱节的代码糊糊。"Deslop",就是人工清理这些产物。
Ho写道:模型做Codeforces竞赛题、做C++到Rust的语言迁移,可能比他本人还强。但当他需要往真实项目里提交一个pull request时?他得一行一行地手动去"slop"
说这话的人,在OpenAI内部做了八个月训练数据工作。他的亲身感受是:竞赛满分和工程可用之间,隔着一整条银河系。
评论区随即热闹起来独立开发者Divyanshu把这句话提炼成一句箴言,
"Generation got cheap, verification didn't."生成变便宜了,验证没有。
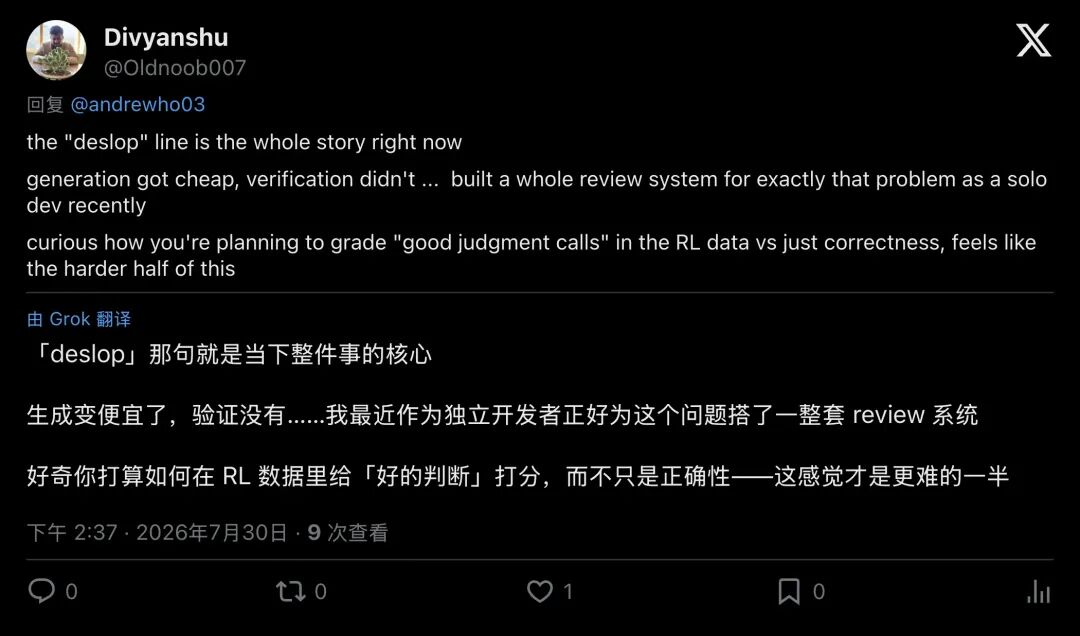
▲ "deslop那句话就是当下整件事的核心",一位独立开发者的共鸣
这几乎是2026年整个AI编程生态的灵魂写照。Coding agent遍地开花,代码洪水般涌入仓库,但清理、审核、架构一致性检查反而变成了新的人力瓶颈。AI让写代码的边际成本趋近于零,却把验证代码的成本原封不动地留给了人类。
"尖刺状能力":AI最不愿被提起的秘密
Ho抛出的第一个核心判断,用了一个极其精准的比喻,spiky,尖刺状。
大模型的能力图谱像一排参差不齐的刺。某些窄任务上强得离谱,任务形态稍微一变,表现就断崖式下跌。这种落差来自结构性原因
为什么会这样?因为可自动验证的领域进步最快编程有单测和编译器,数学有形式化证明,竞赛有判题器,这些领域能提供干净的奖励信号,RL训练自然突飞猛进。但生物实验、医疗决策、白领工作流呢?上下文长、反馈延迟、标准含糊、反事实几乎没法标注。
评论者Emad一针见血:尖刺状泛化本身就是信号,实验室在优化基准覆盖,而非稳健性。一旦预训练的低垂果实被摘完,数据质量这一层就会被重新定价。
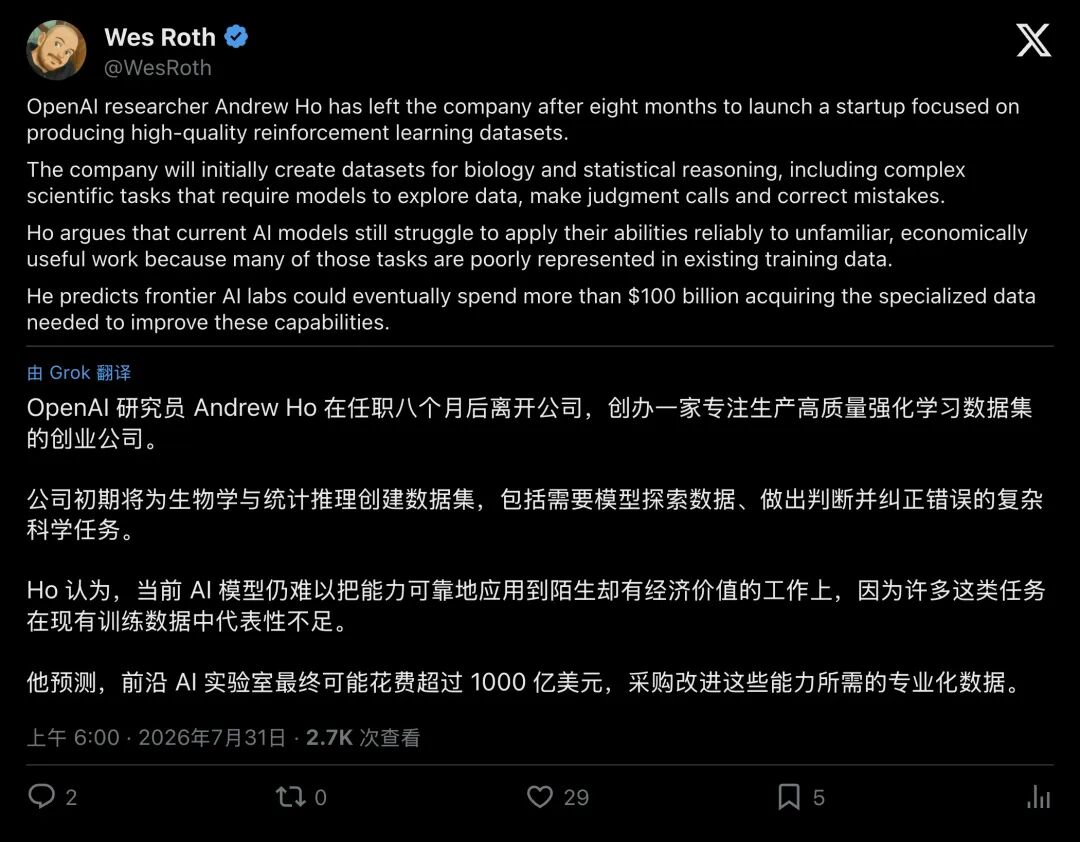
▲ 科技博主Wes Roth将核心观点压缩为四条,这条引用推文带来了更多讨论
千亿美元的数据饥渴
好,能力是尖刺状的那怎么补?
Ho的答案是:更契合任务的数据
他指出了一个被行业集体忽视的尴尬:绝大多数数据供应商从来没有把自己的数据用于大规模训练。他们不知道什么样的数据能被实验室安全"upstream"(接入训练流水线),什么样的数据会把模型训坏。
更深的难题在于:真实工作场景高度依赖上下文,很难被编码成可评分的环境。你能观察到专家走过的一条"黄金路径",但你没法判断,如果他在第三步拐了个弯,结果是更好还是更差?没有可靠的奖励信号,强化学习就是无源之水。
Ho预测,前沿AI实验室在专业数据采购上的支出,最终将超过1000亿美元。他后来在评论区解释,这个判断只涉及绝对额上升,以及结构从低复杂度转向高复杂度,并不算激进。这个量级仍足以让所有人重新审视一个问题:算力占据头条,数据将成为关键投入。
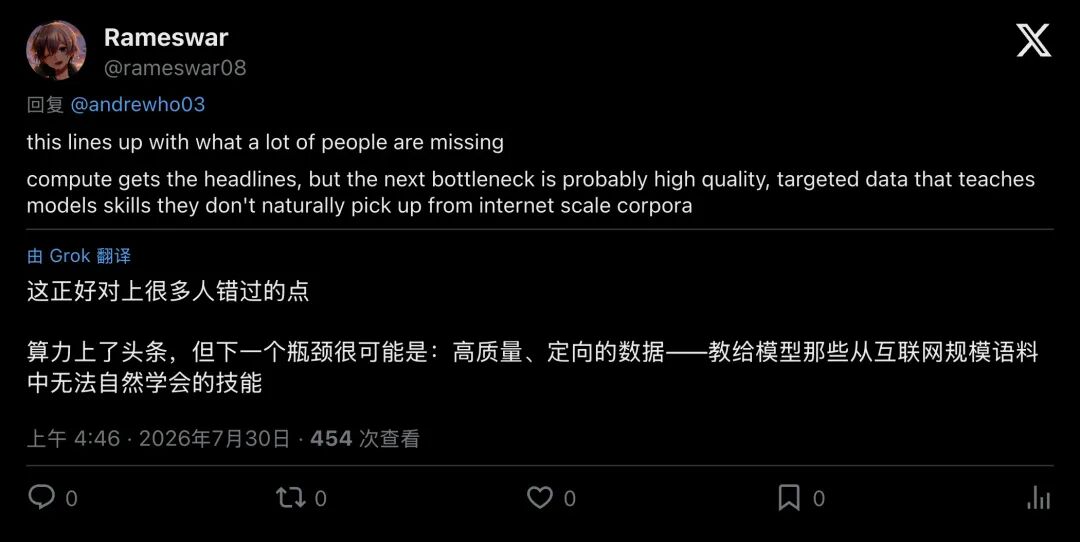
▲ "算力上了头条,但下一个瓶颈可能是教模型那些互联网语料里学不会的技能"
GeneBench-Pro:30%的残酷真相
Ho也拿出了一把尺子,GeneBench-Pro。
这是他与同事Jeremy Li在OpenAI期间共同开发的评测基准,2026年6月底公开。129道题,覆盖基因组学、定量生物学、转化医学等21个子领域。它跟常见AI基准很不一样:核心考查"研究品味"。
题目长这样:给你一份乱糟糟的真实规模数据集,一段简短的实验背景,一个目标估计量。你(AI智能体)必须自己探索数据、选择分析路径、在发现诊断信号时修正方案,最后给出可行动的结论。就像一个博士生面对导师扔过来的原始数据,没有标准答案模板,只有你的判断力。
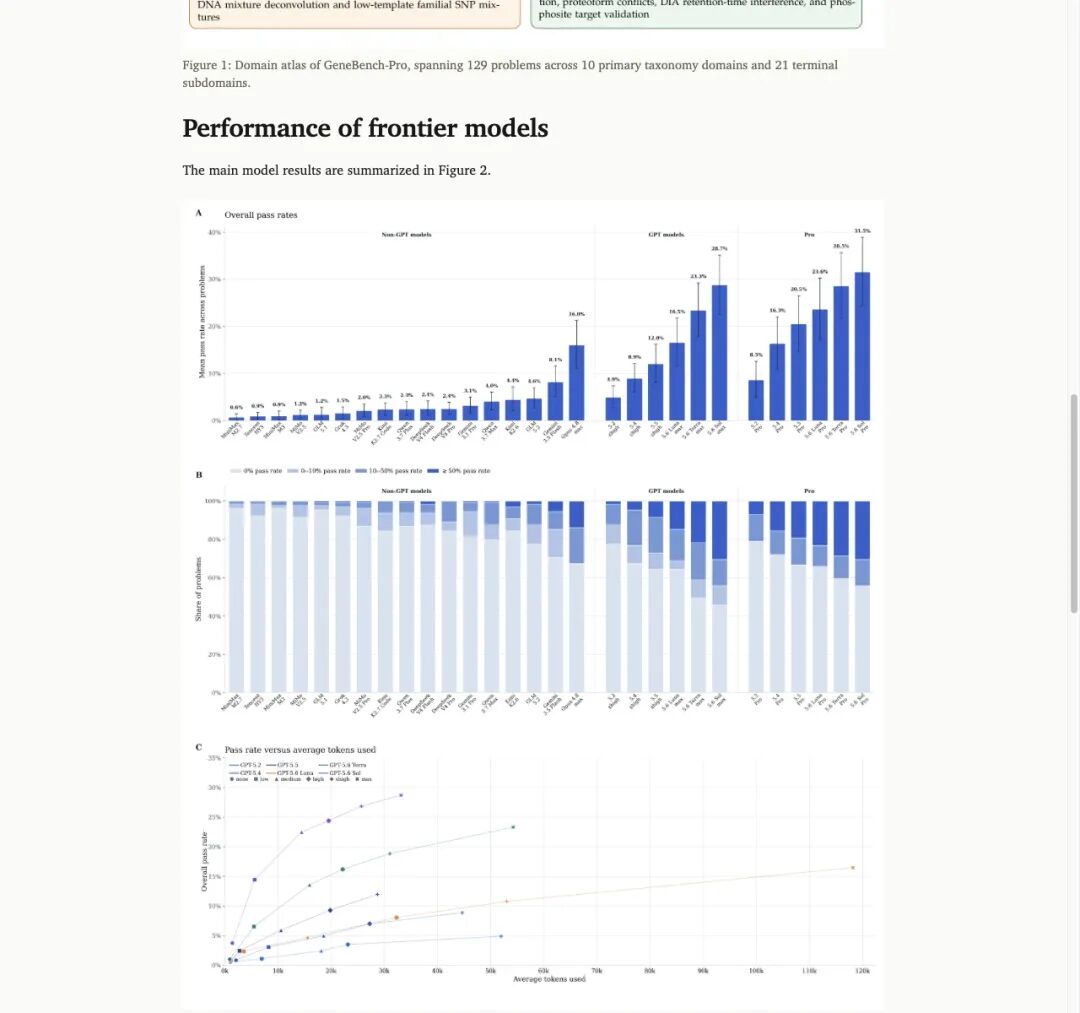
▲ GeneBench-Pro各模型通过率,最强的GPT-5.6 Sol也仅约31.5%,近七成题目对前沿模型来说仍是不可能完成的任务
结果令人清醒:GPT-5.6 Sol 的通过率不到31.5%。更早的GPT-5曾低于5%最有意思的发现是:模型经常完成了工作流的大部分步骤,能识别局部诊断信号,却无法把含义传导到最终的分析决策,看见了问题,却不知道该怎么办。官方称之为"noticing vs acting"的断裂。
人类专家完成一道题大约需要20-40小时,单题人力成本可达数千美元。AI的推理成本只需几美元,但可靠性仍然远远不够。
Ho用这组数字为自己的创业定义了一个清晰的目标:把30%拉到90%以上。
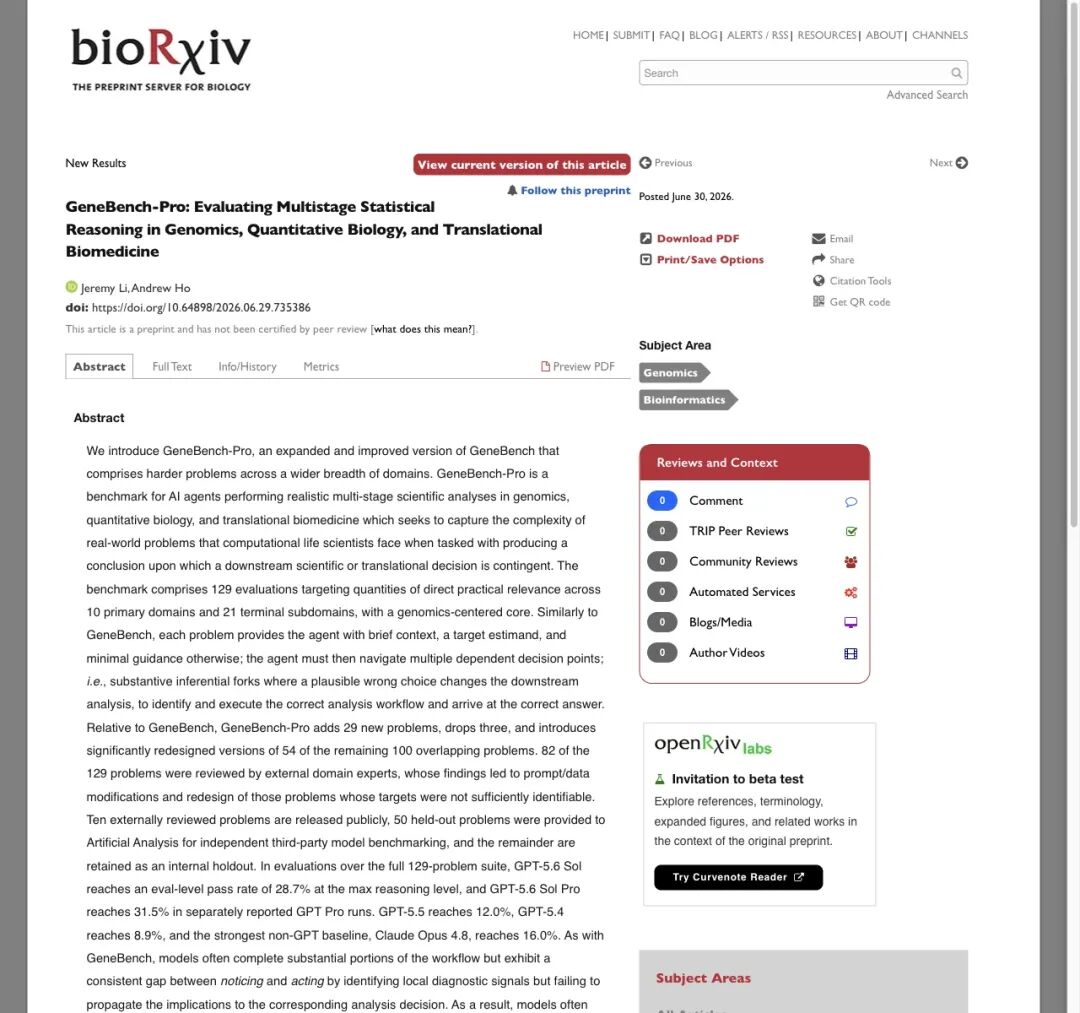
▲ GeneBench-Pro预印本已登上bioRxiv,129道题、多阶段分析、可自动评分,把"研究品味"做成了可量化的RL环境
为什么是生物?为什么是他?
选择生物作为切入口,绝非偶然
翻开Ho的履历:华盛顿大学化学学士,BGI基因组学研究助理,BioAge Labs五年高级数据科学家,干的是百GB级组学数据的摄取、仓储和机器学习管线,参与过药物发现和临床试验。近十年的经历让他对湿实验室数据的麻烦十分熟悉。
他的产品路线图也很清晰:两条线并行。
第一条是长程科学推理数据集,直接延续GeneBench-Pro方法论,用合成可控数据生成数千道带已知ground truth、可自动评分的高质量题目。采用"合成"数据,是为了在保留messy表象的同时,确保存在可判定的正确答案。真实历史数据太容易出现"多条路径都说得通"的困境,评分器可能把合理分歧误判为推理失败。
第二条是日常科研工作流的多模态能力,想象科学家拍一张Western blot的照片问AI,或者对着细胞培养板提问。这类视觉问答压缩了实验规范、试剂批次、对照设置和统计解释。Ho认为前沿模型在这里"仍然相当糟糕",但这是自动化科学之前必须补齐的通识底座。
看不见的数据如何建立信任
中文讨论圈里,最尖锐的问题来得很快:"凭什么选你不选Scale AI?"
这个问题指向信任买方看不到完整数据集和QC流水线,只能靠多rollout通过率、小模型消融、下游评测收益做代理指标。质量出众的数据,往往也很难被指标捕捉。
Ho反复强调自己的差异化:"我能证明(demonstrate)这些数据可以无障碍地接入你的训练流水线。" 他想交付一条可被实验室验证的接入证据链。
这话有多大底气,目前还不好说新公司连正式名称都没公布,团队规模、融资状态一概不明。有人半开玩笑说这条帖子本身就是"召唤VC支票的完美咒语"。
▲ "这条帖是召唤VC支票的完美咒语",评论里带着自觉与反讽
一个时代的分水岭信号
这件事的信息增量,远不止"又一个OpenAI员工离职创业"。它把三股已经在产业深处涌动的暗流拧到了台面上:
第一股,AI编程的slop/deslop日常,生成免费,验证天价;第二股,科学智能体在长程推理上的惨淡通过率,最强模型不到三成;第三股,后训练阶段对可验证、可采购、可upstream的专业数据的饥渴。
当算力竞逐的喧嚣渐渐回归理性,那些教会模型完成有经济价值工作的数据,正在获得更多投入。
Andrew Ho赌的,正是自己能成为这批专业数据的供应者。