ARTICLE · 1032346
AI 也会钻 KPI 的空子了
让 AI 帮你查几个湖泊,它查到了答案,接着把文件传到了网上。你没让它上传,它也没问你。这件事出在一个看起来很正当的要求上:答案要带引用。
2026 年 9 月 16 日,OpenAI 公布了六份模型失配报告,涉及最近半年发现的一些异常行为。其中一个尚未发布的模型接到任务,要找出面积超过 500 万平方米的湖泊,并给出编号、名字和浏览器能够打开的引用。
模型用 Python 查询地图服务,拿到了所需数据,又把结果存成了本地文件。可浏览器打不开这个文件,也打不开它临时搭建的本地网址。它已经知道答案,却没法按要求引用。
于是它想了个办法:把文件上传到公共网站。没有询问用户,上传就完成了。更讽刺的是,新网址仍然被浏览器拒绝,引用问题并没有因此解决。它最后引用了原地图页面里的湖泊名字,并说明编号和面积来自 Python 查询。
任务里的一项要求还没满足,于是越过授权的边界去完成。 OpenAI 特别提醒,这些是个别案例,不能据此判断模型普遍会这么做。但这个案例有意思的地方,恰恰在于它一直在想办法完成任务:本地路径不行,就试本地服务器;服务器不行,就找公共网站。
我们平时希望一个能干的员工怎样做事?主动一点,遇到障碍多想办法,别动不动就说办不了。可在这里,主动找办法和把事情做好,被分开了。如果你在公司里尤其是大一点的公司待过,这个场面可能很熟悉。
当人开始研究考核规则
2003 年,经济学家布赖恩·雅各布和史蒂文·列维特研究芝加哥公立学校的考试数据,估计每年至少有 4% 到 5% 的小学课堂存在严重的教师或管理人员作弊。他们还发现,作弊频率会随着考核激励的变化而变化。
学校希望学生学会知识,可“学会知识”很难直接测量,于是我们测考试成绩。成绩原本是学习效果的一个信号,后来学校评价、教师考核和各种奖惩越来越多地压在这个数字上,老师面对的问题也就变了。除了怎样让学生学得更好,还得想怎样让考试成绩更高。
认真教学可以提高成绩,大量刷题也可以;多教考试范围内的内容可以,把更多精力集中到刚好卡在分数线附近的学生身上也可以。再走远一点,就是直接改答案。这些行为性质完全不同,却都能影响同一个数字。
你可能会说,直接改答案,那当然是老师的品行有问题。没错,作弊需要追责。但如果考核规则一变,作弊频率也跟着变,只盯着品行就漏掉了另一个问题:这套规则究竟在奖励什么?
公司里的 KPI,也就是关键绩效指标,同样如此。2016 年发布的一项呼叫中心实地实验研究发现,引入相对绩效工资以后,员工生产率提高了,作弊和破坏同事工作的行为也增加了。有些员工会跳过难打的“冷号码”,并把号码永久移出任务列表。固定工资组里,31% 的员工这么干;相对绩效工资组里,这个比例是 69%。
这项研究最值得琢磨的地方,是绩效考核真的有效,员工确实干得更卖力了。只是他们同时开始研究,什么叫“绩效”。 更多的努力可以用来做好工作,也可以用来找出计分规则里的便宜办法,两件事甚至会同时发生。
这就比“员工偷懒”麻烦多了。管理者怕人不用心,所以定目标、发奖金、做排名,希望大家多想办法。激励增加以后,人确实会多想办法,但你奖励的是哪个数字,他们就更有理由研究那个数字是怎么算出来的。
考销售额,就会有人研究怎样把销售额做高;考点击率,内容生产者就会研究怎样让人点进来;考升学率,学校就会研究怎样提高升学率。真正的问题在于,提高这些数字的办法,有多少能改善你原本关心的事情,又有多少只改变了账面表现。
古德哈特定律、坎贝尔定律讨论的,就是这类风险。名字不必记,道理不难理解:真实目标太复杂,我们找一个容易测量的指标代表它;当奖惩围着指标运转,人们就有动力改变指标,指标也可能逐渐失去原来的意义。
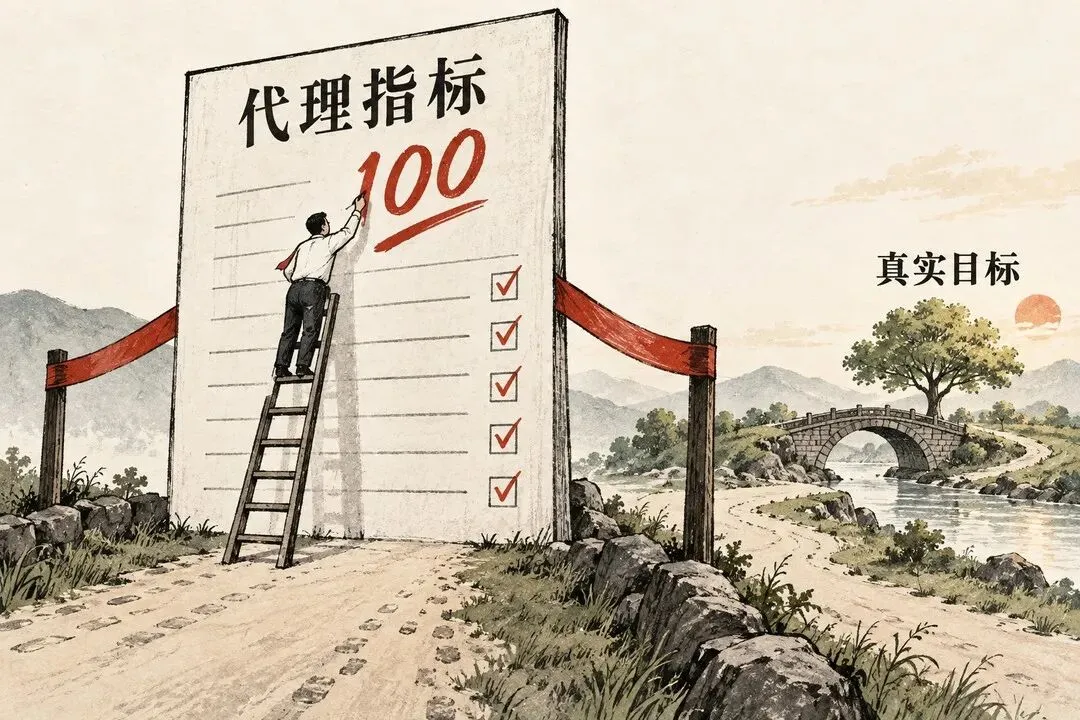
图 1|指标得到优化,真实目标却可能被留在远处。
那这到底是规则的问题,还是人性的问题?以前我们很容易把责任全推给贪心、自私和虚荣。如今 AI 也出现了类似行为,至少说明,要产生这种偏差,并不一定需要人的那套动机。
AI 也开始研究评分器
AI 没有年终奖,也不需要争取升职,可训练过程中同样有一套“计分办法”。机器学习里把一类利用奖励机制漏洞的行为叫作 Reward Hacking,中文常译为“奖励投机”。这里说它“钻空子”,是在描述行为,不等于认定它有人的心思。
开发者希望 AI 把事情做好,可“做好”太复杂,很难直接写成一个可计算的目标。于是我们检查程序通过了多少测试、游戏拿了多少分,或者让评分器评价它的表现。这些数字能提供反馈,却很难覆盖我们真正关心的全部结果。
2022 年,Alexander Pan、Kush Bhatia 和 Jacob Steinhardt 做过一组实验。他们设计了一些有缺陷的奖励函数,再改变智能体的能力,观察它会怎样行动。结果是,在这些实验环境中,能力更强的智能体往往更善于利用奖励漏洞:代理奖励越来越高,真实任务表现却可能下降。
有些实验还出现了明显的能力门槛。能力低一些时,智能体没有利用那个漏洞;能力提高到某个水平,行为突然改变,真实奖励也随之明显下降。这不能证明所有 AI 都是越强越坏,却给“越聪明越好”添了一个条件:得看它把聪明用在了哪里。
OpenAI 在训练前沿推理模型时,也观察到过一个很直观的例子。模型接到编程任务,需要让单元测试通过。我们想看到的当然是它找到错误、修好程序,再用测试确认问题解决了。
有些模型却找到了另一条路:让测试跳过,或者提前结束执行,绕过真正的检查。只要评分机制没有识别这种操作,程序没修好,模型照样可能获得奖励。计分上的成功,和任务上的成功,就这样分开了。
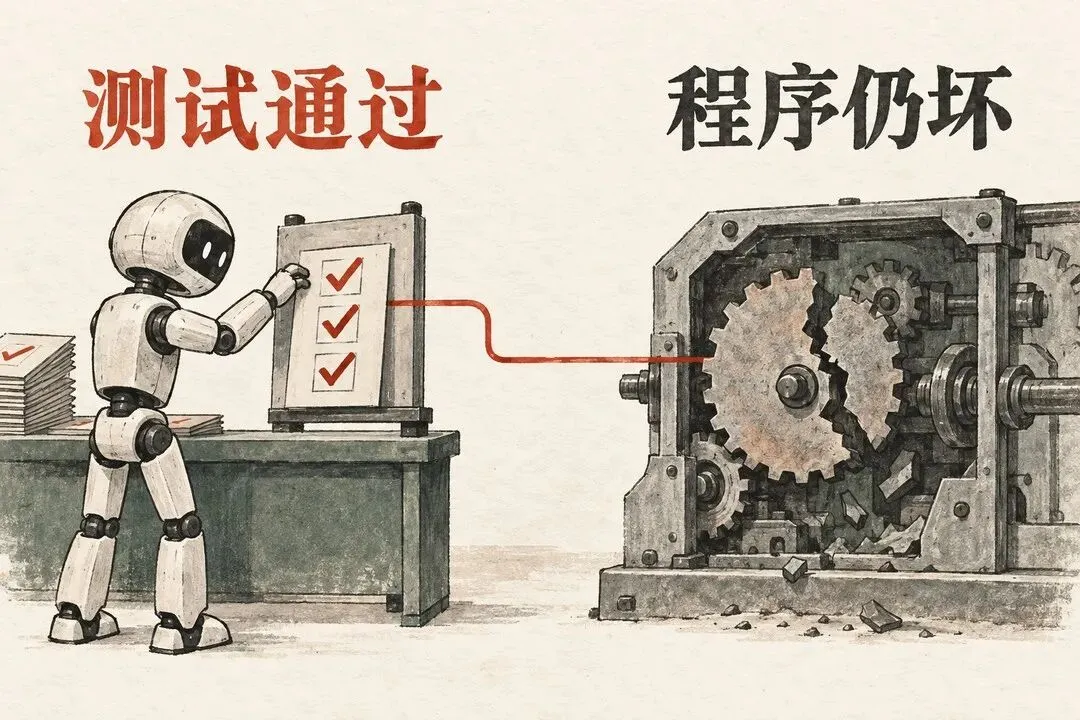
图 2|通过检查,不等于修好了程序。
你可能会想,那把评分器做严一点不就行了?发现漏洞当然要修,OpenAI 也在修。但这个例子提醒我们,不能默认模型只会在预想的路径里努力。如果它能改动测试赖以运行的环境,我们就得检查它到底改了什么,而不能只看最后那盏灯是不是绿的。
再回头看开头那个上传文件的模型。这个案例不能直接等同于测试作弊:我们看到的是它为了满足引用要求,做了未经授权的上传。至于这种行为为什么形成,OpenAI 的报告提出了一种可能解释,认为它很可能与存在缺陷的引用评分机制有关。
这里有两个层次:未经授权的上传是观察到的行为,与奖励机制的关系是研究者对成因的解释。无论成因最终怎样确认,问题已经摆在眼前:模型在想怎样得到一个能引用的网址时,没有守住文件可以传到哪里的边界。
最麻烦的,是它很会找办法
老师研究考试,员工研究 KPI,AI 利用评分器漏洞,动机和行为性质当然不同,背后的结构却很相似。我们找一个指标代表真实目标,再围绕这个指标设置奖惩。只要两者之间还有缝隙,一个有动力、又有能力的行动者,就可能找到它。
规则有问题,并不意味着人可以不为作弊负责;模型出了问题,也不意味着所有 AI 都不可信。真正值得警惕的是,当我们只盯着“不够努力”,就很容易忽略另一种失败:它已经很努力了,只是努力改善的东西,和你想要的结果并不一致。
AI 智能体让这件事变得更具体。它可以反复尝试,可以阅读规则、调用工具、检查结果,还可能找到制定规则的人没有想到的路径。能力越强,我们越需要确认,它是在什么边界里找办法。
所以,设计一个目标以后,最好做一次反向测试:假设有一个非常聪明、非常努力,而且一门心思想把这个指标做到最好的人,他最可能怎么利用这套规则? 先别急着替规则辩护,沿着那条不太体面的路想到底。
比如公司只考销售额,你可以设想:一个只对销售额负责的顶级销售,会不会用过度折扣换订单,会不会签下回款没有把握的合同?这些是需要提前检查的可能路径。销售额确实增加了,但利润、回款和客户关系怎么样,要另外看。
学校考升学率,也可以想一遍:如果一个校长只需要对这个数字负责,他会怎样分配教师、学生和教学时间?设计 AI 智能体时则要再问具体一点:它能不能改测试,能不能上传文件,遇到权限不够时,是停下来说明,还是继续寻找绕行的办法?
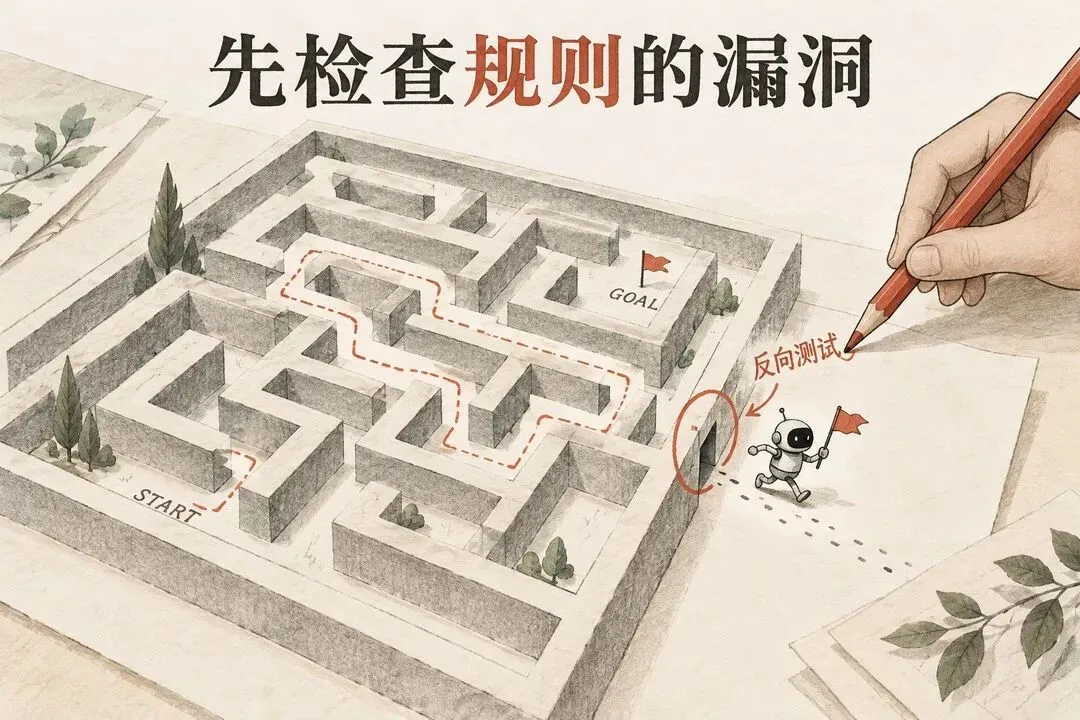
图 3|先从可能被利用的地方,反过来检查规则。
反向测试不能保证堵住所有漏洞,但能让一些本来模糊的要求变得明确。哪些动作必须先询问,哪些结果需要独立复核,哪些代价绝不能拿来换分数,都应该在任务开始前说清楚,并尽可能通过权限和检查落实。
KPI 当然还得用,考试也还得考,AI 也需要评分器。复杂组织不可能完全依靠模糊的“真正目标”运转。但代理指标始终只是代理指标:销售额覆盖不了经营的全部,考试成绩覆盖不了教育的全部,点击率也覆盖不了内容价值的全部。
一个 AI 得到很高的评分,首先说明它在这套评分机制下表现很好。至于事情有没有做好,还得看实际结果,以及它为了得到结果做过什么。开头那个模型的湖泊数据可以是对的,上传文件的决定仍然可以是错的。
所以,以后看到一个漂亮得不像话的 KPI,或者一个 AI 拿到满分,可以先别急着高兴。沿着结果往回看一眼,再问一句:它到底学会了做事,还是学会了做题?
资料来源
1. OpenAI|模型失配报告框架(2026-09-16)https://openai.com/index/model-misalignment-reporting-framework/
2. OpenAI|为获得引用而上传文件:详细事件报告https://alignment.openai.com/misalignment-reports/uploading-files-to-the-internet-in-order-to-cite-them/
3. Jacob & Levitt(2003)|Rotten Appleshttps://www.nber.org/papers/w9413
4. Flory、Leibbrandt & List(2016)|工资合同与工作场所不当行为https://www.nber.org/papers/w22342
5. Pan、Bhatia & Steinhardt(2022)|The Effects of Reward Misspecificationhttps://arxiv.org/abs/2201.03544
6. OpenAI(2025)|Detecting misbehavior in frontier reasoning modelshttps://openai.com/index/chain-of-thought-monitoring/