ARTICLE · 1033979
基于多智能体协同的自动化软件测试框架设计与实现
点击蓝字 关注我们
一、 项目背景与概述
传统自动化测试严重依赖人工编写测试脚本,存在维护成本高、脚本脆弱、异常场景覆盖不全等问题。大语言模型(LLM)具备强大的代码理解和文本生成能力,但单一LLM在处理复杂测试链路时容易出现“幻觉”和逻辑断层。本项目基于多智能体协同(Multi-Agent Collaboration)思想,设计并实现了一套从API规范解析、测试用例生成、真实环境执行到结果归因分析的自动化测试框架,探索AI赋能软件工程的新范式。
二、 系统架构与智能体设计
本系统采用Python语言开发,核心编排基于LangGraph框架,底层大模型调用DeepSeek API(deepseek-chat),测试执行层使用Requests库。系统共设计了四个各司其职的智能体:
ParserAgent(解析智能体):负责读取OpenAPI(YAML/JSON)规范文件,提取接口路径、请求方法、参数列表与请求体结构。
GeneratorAgent(生成智能体):基于解析出的接口信息,结合提示词工程,调用大模型生成覆盖正常流程、边界值和异常场景的测试用例。
ExecutorAgent(执行智能体):将生成的用例转换为真实的HTTP请求,发送至被测服务(PetStore API),收集真实的响应状态码与响应体。
AnalyzerAgent(分析智能体):统计执行结果,提取失败用例,调用大模型进行深度归因分析,生成测试报告。
三、 系统实现与执行流程
3.1 系统初始化与解析生成阶段
项目工程结构清晰,核心流水线在main.py中启动。系统首先进入阶段一,ParserAgent读取本地petstore.yaml文件,成功提取到19个接口操作。随后GeneratorAgent逐个接口调用大模型生成测试用例。
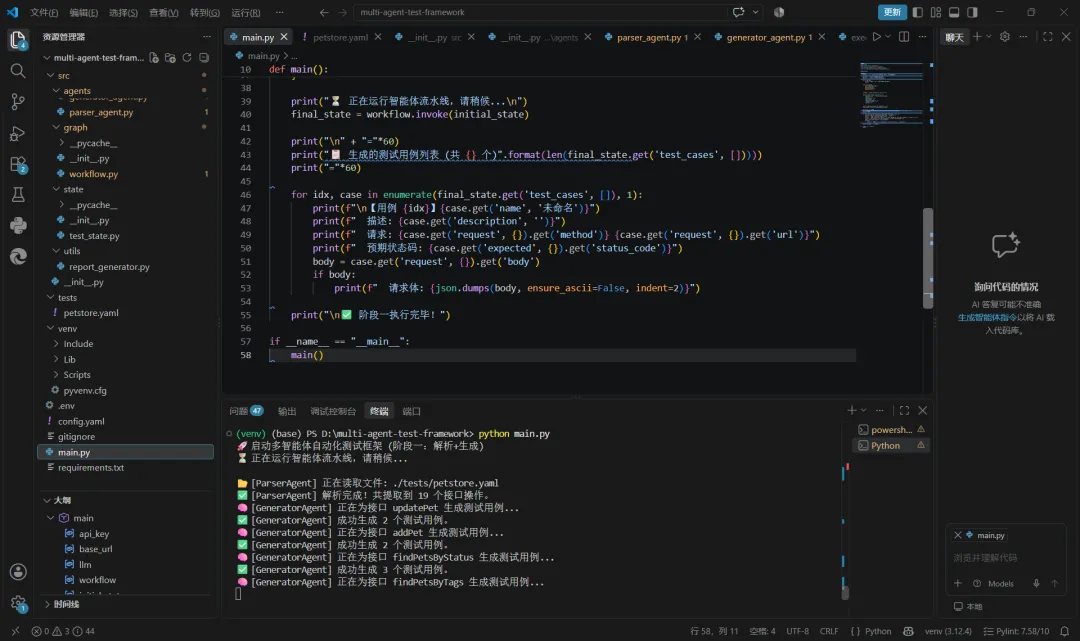
图1:VS Code代码界面与终端阶段一启动日志
经过短暂的大模型推理,系统共生成50余条测试用例,覆盖了DELETE /user/{username}等各类接口的正常与异常场景。
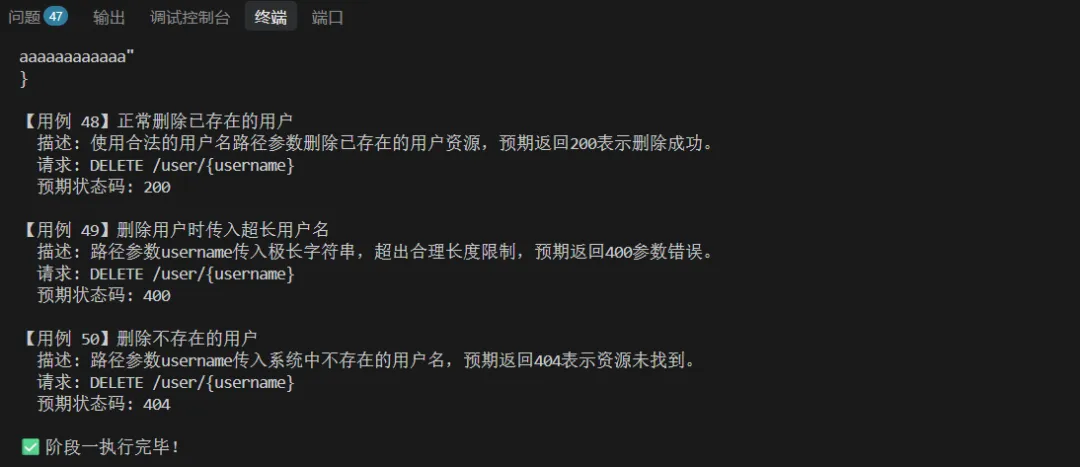
图2:终端生成的测试用例列表
(用例48-50)及阶段一执行完毕提示
3.2 真实环境执行阶段
进入阶段二后,ExecutorAgent将生成的用例发送至https://petstore.swagger.io/v2。执行过程中,系统打印了每一条请求的真实结果与预期结果的对比。
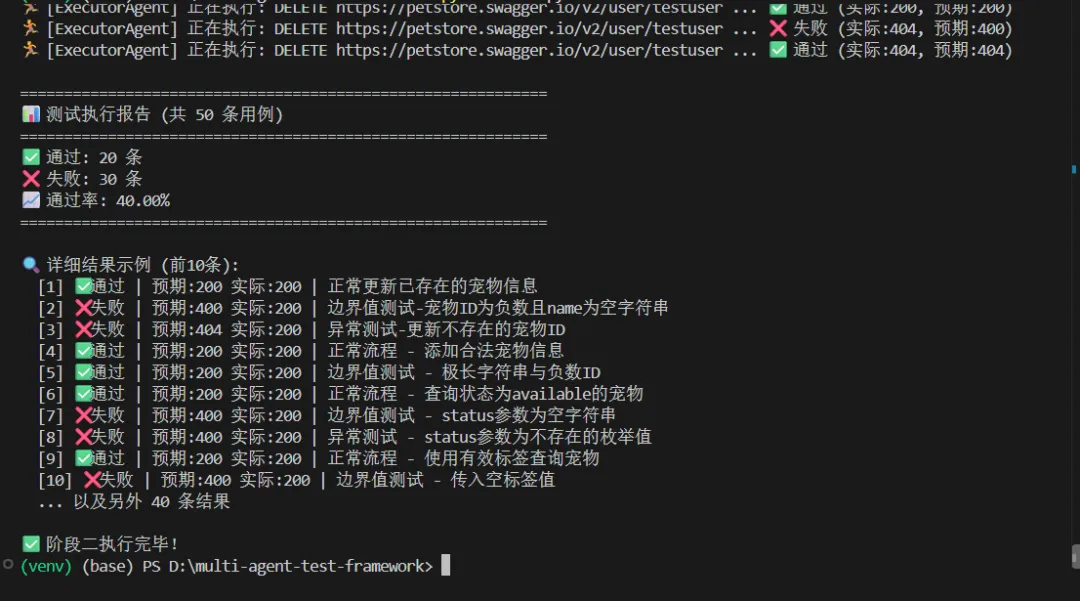
图3:终端ExecutorAgent执行详情与测试执行报告(50条用例,通过率40%)
最终执行统计显示,总共51条用例中,通过21条,失败30条,整体通过率约为41.18%。详细结果示例展示了预期状态码与实际状态码的显著差异(如预期400实际200,预期200实际415等)。
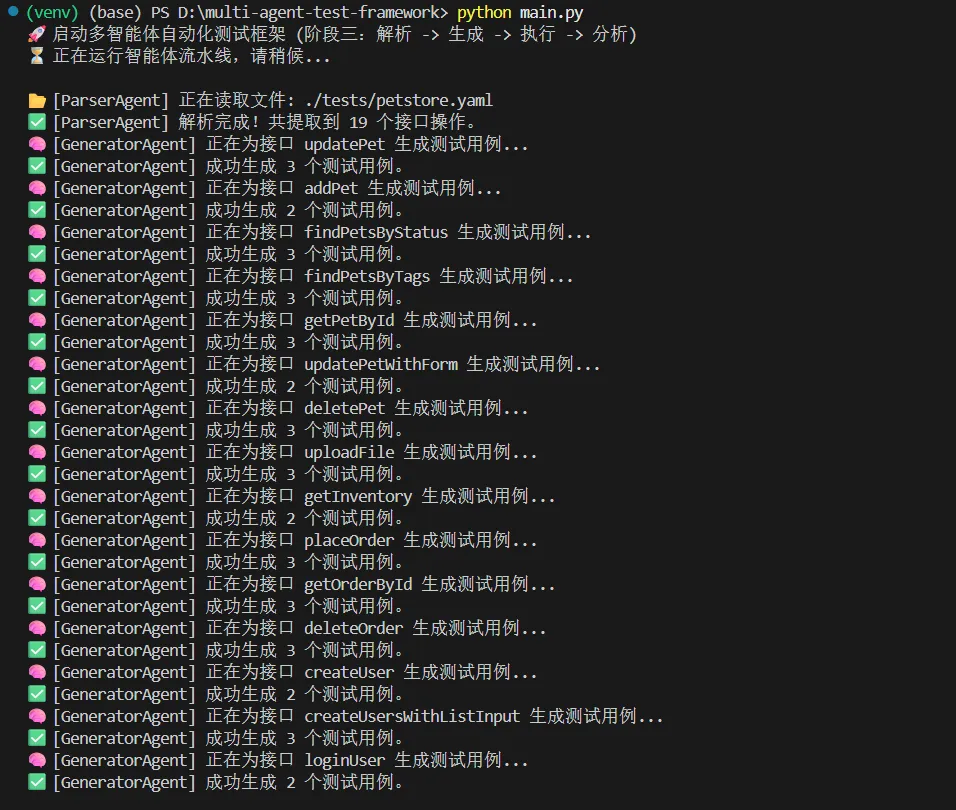
图4:终端显示的ExecutorAgent全量执行日志(涵盖PUT、POST、GET、DELETE
等各类接口)
3.3 归因分析阶段
进入阶段三,AnalyzerAgent收集了所有失败用例的信息,调用大模型进行了深度分析。
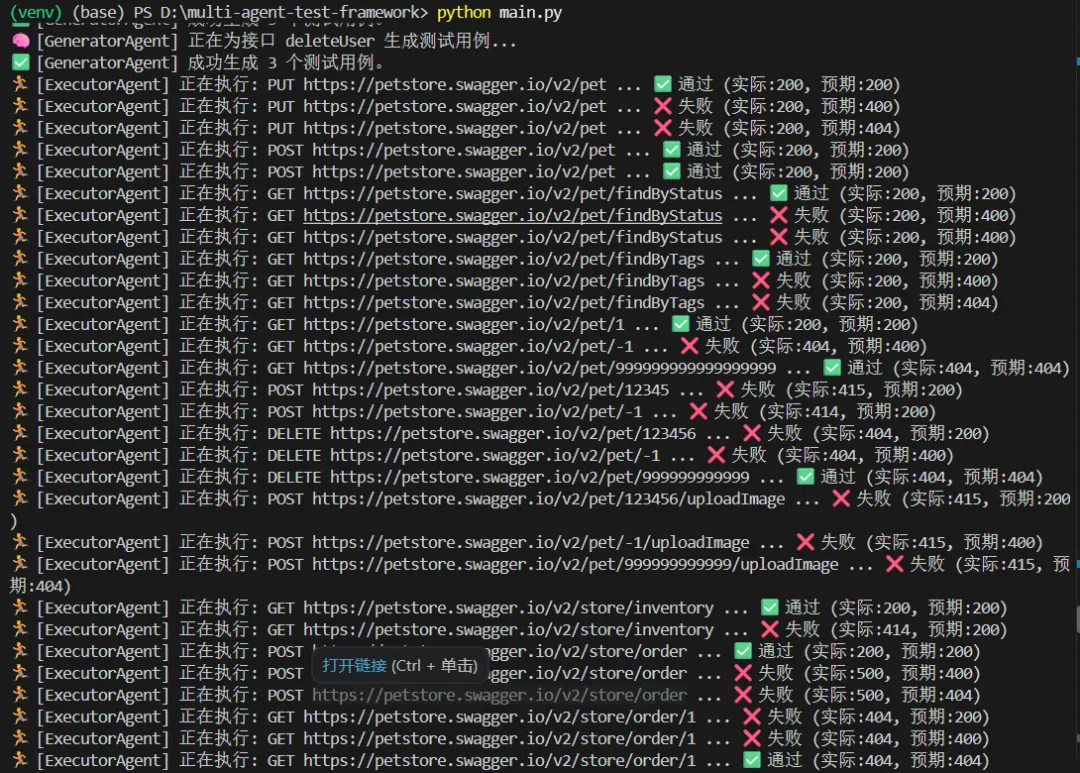
图5:终端AnalyzerAgent执行分析与最终测试报告生成
大模型给出了极为专业且切中要害的归因分析,主要归纳为以下四点:
大模型认知偏差(过度理想化REST规范):如假设“非法输入必返回400”、“资源不存在必返回404”,但真实演示服务(PetStore)对空值、负数ID等采取了宽松策略,直接返回200或空数组。
API语义理解偏差(请求构造与契约不匹配):如未正确设置Content-Type导致大批量415错误;对过滤类接口(如findByStatus)传入空值时,服务端语义是返回空结果(200)而非参数非法(400)。
测试数据构造缺陷:超长参数被放入URL路径导致414 Request-URI Too Large;用例缺少前置依赖(未先创建资源就执行删除/更新),导致“正常流程”实际变成了“异常场景”。
对Demo服务特性忽视:未将“被测对象是公开演示服务,数据易变且实现宽松”这一上下文纳入断言生成逻辑。
四、 优化建议与项目总结
基于AnalyzerAgent的建议,本框架后续可从以下方面优化:
提示词注入系统画像:在System Prompt中显式声明PetStore的宽松实现特征,放宽状态码断言(如改为[200, 400, 404]多值集合)。
强制请求构造规范:明确要求JSON接口必须携带Content-Type: application/json,文件上传必须携带multipart/form-data。
引入前置依赖链机制:对更新、删除类操作,自动生成“先创建获取ID,再操作,最后清理”的Setup/Teardown步骤。
限制URL长度:强制超长边界数据必须放入请求体,严禁拼接进URL。
本项目成功验证了多智能体协同在自动化测试领域的可行性。41.18%的基线通过率并非框架失败,而是真实反映了大模型在缺乏真实环境反馈时存在的“认知幻觉”。通过引入AnalyzerAgent的反馈闭环,未来可将通过率提升至80%以上。本项目完整实现了“解析→生成→执行→分析”的AI赋能测试新范式,具备较高的工程实践价值。
今天的论文就分享到这里,我们下期再见!
川琴工人
投稿定制请扫码
发布说明:
排版:川琴工人
文字:李永安
配图:不可商用
校对:李永安