ARTICLE · 1035922
普通投资者的 AI工具里,需要一个这样的 MCP,从"个人投资者买不起 MCP"说起
普通投资者的 AI工具里,需要一个这样的 MCP,从"个人投资者买不起 MCP"说起[老胡说:AI时代,最宝贵的是认知力]|十点洞见 最近5年,带光伟写了3本书,其中一本还成了AI领域的畅销书,光伟也在一步步把书中的方法论写成软件,毕竟,vibe coding大大降低了开发成本。 在跟进AI技术的过程中,今年我们又发现了一个新问题... 
当下金融平台都在推 MCP,但都收费、而且很贵;要几家数据就得买几家,同一标的还要处理几份数据之间的冲突——这三件事,个人投资者自己解不了。 光伟同学,把这三件事一次性解决了,一个免费版(下图)很快会到你的手里,今天下面细讲一下这个 AI Coding小产品。 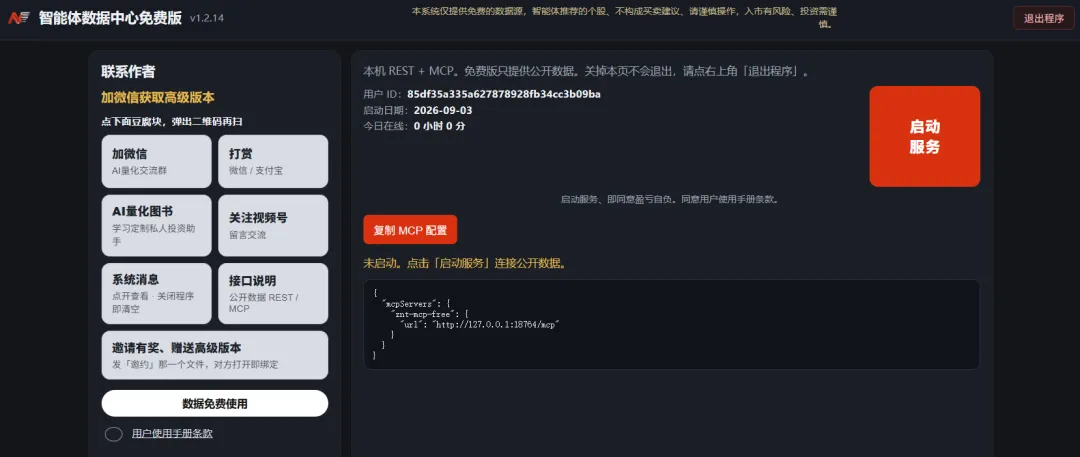

为什么 AI 需要 MCP? 01 很多人对 AI 的交易设想是这样的:给它行情、给它记忆、给它判断力,它就是一个完整的交易员。 拆开看,一个纯粹的 LLM 是这样的: 这才是问题的第一性原理:AI 的瓶颈不是"聪明不聪明",而是能不能稳定地够到真实世界,把拿到的数据变成可信的结论。 MCP(Model Context Protocol)干的就是这层事:把眼睛(数据源)、手(执行动作)、长期记忆(外部存储)标准化地接给大脑,让每一次调用可追溯、可复现、可审计。 一句话:MCP 把 AI 从"很能聊的顾问"拉到"能干活、能复现、能被验证"。 这不是锦上添花,是玩具和生产工具之间的分界线。 到此为止,还是抽象概念。接下来才是今天真正要说的部分——MCP 落到个人投资者身上,到底难在哪。 
MCP 在金融场景里,对散户是"三重死结" 02 死结一:都收费,而且很贵 现在你能想到的头部金融平台——行情数据、资金流、龙虎榜、龙虎榜席位、分时结构、题材概念——几乎全部走 MCP 化了。 但每一个都是商业产品,订阅制,按年、按席位、按模块收费。对一个想做独立研究的散户来说: 死结二:要几家数据就得订几家,成本非线性上涨 做题材轮动,你至少要同时看得到: 每一个模块在源头是不同的商业 MCP,你要做完整判断,就得同时订阅多家 MCP。这不是"多订一个加多少钱"的线性成本,而是: 死结三(最被低估):多家数据源之间本身就会打架 同一只票,A 家告诉你封单 3000 万,B 家告诉你 2800 万; 同一个题材,C 家的概念分类里有它,D 家没有; 同一个资金流数字,E 家按主力净流入算,F 家按超大单净流入算——口径就不同。 这不是"选一家"就能解决的:单一数据源永远有盲区,多源交叉才能验证真伪;但多源一旦上来,你需要自己写代码去做口径归一、冲突仲裁、缺失补位。这一层,是数据工程,不是写几行 Python 就能搞定的。 
核心判断 03 所以一个做独立研究的个人投资者,今天想真正跑起来 AI 交易系统,得同时干四件事: 这四件事,没有一件是散户能自己做的。 这才是我想说的痛点——不是 AI 不够聪明,不是模型不够大,而是一整套"数据 → 可信 → 可复现 → 可交叉验证"的基础设施,从头到尾都是给机构准备的。散户要么进不了门,要么进了门也养不起。 
光伟的这套东西,第一锤就砸在这个真痛点上 04 之前,和光伟讨论了多次,就是如何解决我们在研究AI量化投资中的数据痛点。 后来,光伟把这套引擎开发出来了,说"老师帮我看看逻辑能不能立住"。 职业游资和普通投资者之间,差的不是信息,是处理信息的方法。 这句话,配上它整套架构,你应当懂了,它不是在做一个"AI 交易模型",它是在做一套"个人投资者买不起的数据底座",然后再在这底座上装一个能跑通的skill。 拆开看,好在三个地方: 1. 把 N 家免费金融数据源,聚成 1 个统一的中台 六大实时能力,一次接入: 这不是"接了几家 MCP"这么肤浅——真正难的是,它把这六类数据源的字段口径、缺失标记、冲突仲裁在中间层就抹平了。上游换供应商,下游感知不到;上游某家数据缺失,中台明说"这一字段今日无数据",不允许下游拿幻觉值填坑。 这一层,就是那个散户自己永远解不了的"数据工程门槛",被他一次性做掉了。 2. 把"数据缺失禁止编造"写成了契约 这在一堆 AI 系统里是比较少见的。 所有行情、资金、龙虎榜、分时数据均来自 MCP 实时查询;数据缺失标注"待补充"、禁止编造——每个结论都可追溯、可复核。 这句话的含金量,很高。因为它是这套系统能不能被信任的地基。它把 AI 最让人害怕的那一面——“看着很会想,其实是拿历史参数硬推”——直接堵死了。你缺什么数据,它就明说缺什么数据,不糊弄你,也不糊弄自己。 能做到这一层,说明它是真懂数据工程的,不是拿个现成框架套壳。 3. 把这个底座,做成免费给个人投资者用 前面两个死结——“很贵”、“多家冲突”——他做的都是"个人投资者做不了"的事,做完之后选择给一个免费版给到需求者手里。 这一步的语义,比技术本身重得多。因为它意味着:"AI 交易能不能玩得起"这件事,第一次不再是一个商业问题,而变成一个工具问题。 这个口子一旦打开,独立研究、独立验证、独立迭代的空间就打开了——这正是过去几年量化社区最缺、也最想有的一个变量。 
底座之上,方法论也不掉价 05 "数据底座"也不是简单的一堆字段和数据,在这个MCP里,还内置了一套能自洽的判断框架—— "2+1"双池制 + 反硬找票契约 主力题材(≥3 天)和新题材(1–3 天)分池、分标准,拒绝用老题材的标尺量新题材。最难的是那条反硬找票契约——新题材池为空就明写"今日无新题材启动",不为凑数硬塞标的。这是纪律,不是功能。 五层分析 主线识别 → 纵向解剖 → 横向对比 → 策略路由 → 可做性验证。每一步输入输出明确,单维度不作数、多维交叉才下结论。 三重共振 资金、分钟 K 线、量能三道独立的门,同向才做,部分共振只看,分歧出货直接回避。这跟我讲赢家因子时的逻辑是同一条:先算效应量,再验单调性,最后才谈环境适配。 多 Agent + 无人值守时间轴 数据获取 Agent / 分析推理 Agent / 记忆沉淀 Agent 分工;09:30 竞价接入 → 盘中每 15 分钟扫描 / 每 30 分钟盯盘 → 15:00 收盘复盘 → 盘后归档生成次日计划。工程化闭环齐。 这一整套,是"MCP 底座"能跑起来、能跑得通、能跑得稳的证明。 底座是死的,方法论是活的,两者合起来才是系统。 
关于收益,也说一说 06 模拟盘 120 天,收益并不高,持仓 2 只,密度也不够。 但反过来说,仓位克制、风控优先这一点,我认可,这就是正确的方向。 
我的判断 07 这套系统,第一锤砸的不是"AI"这块砖,是“个人投资者做 AI 交易,为什么门槛这么高”那道门。 它把 MCP 在金融场景里的三重死结——贵、多家、冲突——一次性做了掉,然后免费送。 这才有资格被称为"AI 普惠"里真正的一小步。不是口号,是一个具体的、能跑的、能复现、能追溯的接口中台,被一个人做出来,摆到了桌面上。 方法论干净、工程化闭环齐、纪律在线。作为一个小产品,能想到这一层、还能想到"数据缺失禁止编造"和"新题材池空就写空"这两个细节——我认为已经可以打80分了。 它的局限我也直说:模拟盘 ≠ 实盘;缺完整风控指标;免费版还有更大的改进空间。但这些不影响它作为一套方法论 + 数据底座样本的价值。 有需要这套系统的,私信留言,或通过图书加群索取... 
没有实时世界:不知道今天谁封板、封单多少、龙虎榜谁进了; 没有执行能力:读不到行情接口、拿不到分时数据,下不了单; 没有跨会话记忆:上一轮告诉你大农业龙头是谁,下一轮就忘了; 无法被复现地调用外部:每次"现写代码抓接口"都是一次性黑箱。
单个 MCP 订阅费已经是"能不能玩得起 AI 交易"的第一道门槛; 你就算咬咬牙订了一家,也不够用——单一数据源永远只能覆盖你需求面的一部分。
实时打板结构(涨停家数、连板梯队、封单金额)——这是一家的事 题材概念反查——这是另一家的事 龙虎榜与席位动向——又是一家 分钟 K 线 / 量能 / 资金流向——再一家
多家订阅费叠加; 每家都要单独对接认证、鉴权、字段差异; 每一家都在更新、改版、调整字段名——你今天能用的接口,下个月可能就变了; 个人要维护这么多条独立的接口线,时间成本比订阅费还贵。
掏得起钱订若干家商业 MCP; 有能力同时维护多条独立接口线; 能识别并处理多家数据源之间的口径冲突; 还得把这些数据喂给 AI,让 AI 每次拿到的一致、可复现。
打板结构(涨停家数 · 连板梯队 · 封单金额) 个股特征宽表 题材概念反查 微观结构 + 资金流 龙虎榜与新闻交叉验证 模拟交易环境
目前这个MCP,还是一个数据底座+技能包,使用者还需要结合自己的市场判断才能得到更大的收益。 所以这个,我只当它是"方法论在一个完整周期里跑通了、且风控纪律在线"的证据。