ARTICLE · 1038035
零代码文档驱动大模型开发---AI办公助手系列-简历做深-从会改到能问
上一篇零代码文档驱动大模型开发---AI办公助手系列-简历功能的初步建设成果及总结,我把简历功能的框架搭起来了——四步(帮写 / 帮改 / 帮投 / 帮排版)、24 个岗位族、三层结构。但框架只是"能用",离"好用"还隔着一层。这一篇,讲做深这段路,以及路上三个关键的决策。
一、项目需求
框架落地后,真正的挑战才浮出来,三个:
1、光"自动帮改"不够。简历最大的痛,不是文字不漂亮,而是经历写不深、经不起面试追问。AI 能把一段经历润色得天花乱坠,可面试官一句"这数字怎么测出来的?",你就露馅了。
2、光"精确匹配"有风险。让 AI 按岗位 JD 裁剪简历,它一高兴,容易"顺手"帮你多编一条经历、多写一个项目。
3、光"岗位预设"不够。24 个岗位族之间,关键词匹配稍不精确就串味:例如想做"教育"的,匹配到了 HR 的"培训专员"。
所以"做深"要解决三件事:让 AI 会追问、让 AI 别编造、让匹配别串味。
二、项目功能
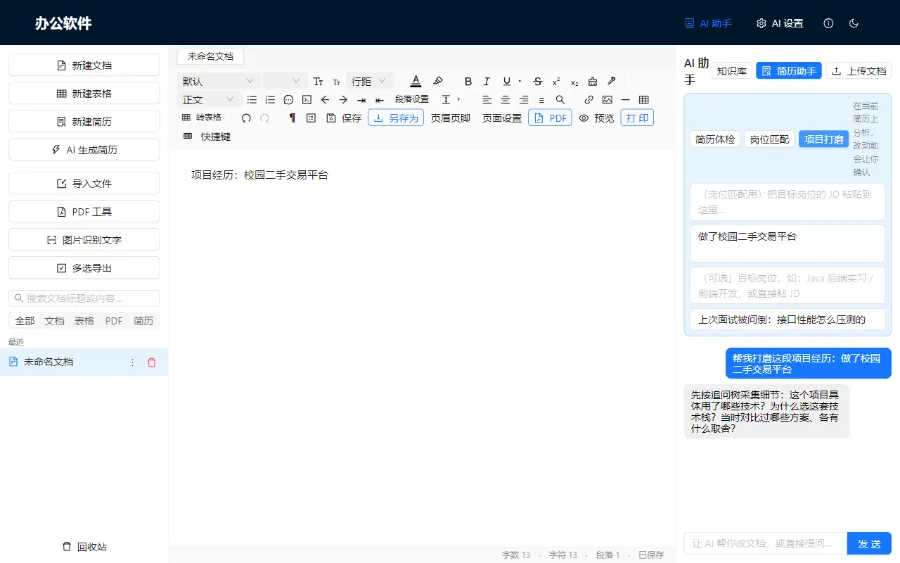
• 项目打磨(追问教练):输入一句项目描述,AI 按追问树逐条追问,帮你把经历补足细节、变成一段更经得起追问的 STAR 版本。
• AI 生成初稿:填个岗位,AI 生成简历骨架,但工作 / 项目经历强制留空。
• 多投递版本(防编造):粘一个 JD 生成裁剪版,代码硬拦"不新增条目"。
• 24 岗位族精准匹配:关键词精确定位,岗位族之间不串味。
三、功能背后的思维链
决策一:让 AI 当"追问教练"——简历的质量瓶颈不在"写",在"问"
痛点:大多数人写简历,写出来的经历只有一句话,既没数据、也没细节。你让 AI"帮我把这段写好一点",它只能对着这一句话发挥,写出来的还是空的——因为它手里没有料。
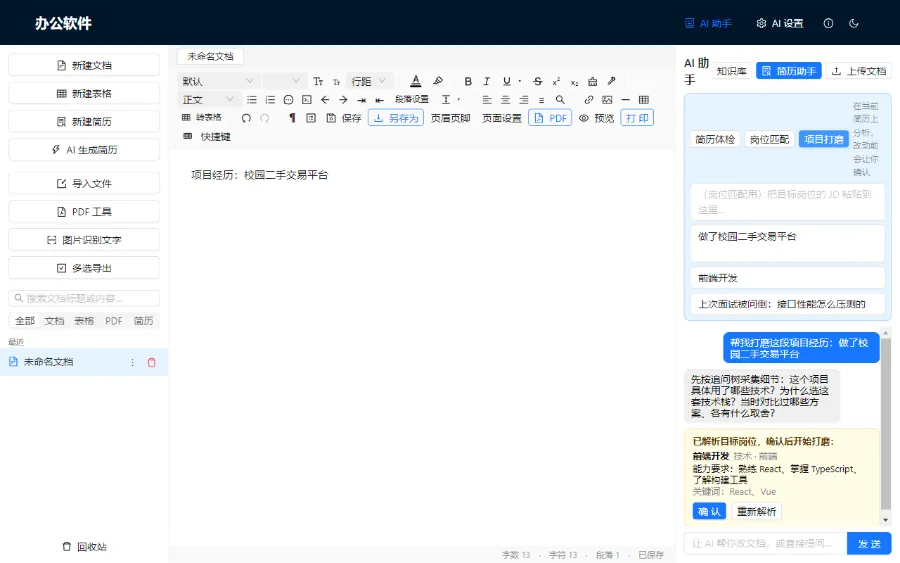
思维沉淀:会写不如会问。简历的质量瓶颈不在文笔,在信息采集——问不出真实细节,AI 再会写也只是在给空壳上漆。先解决"料从哪来",再谈"怎么写"。
边界说明(重要):这套追问是"通用框架",不是"专业 HR 经验"。我们不是 HR,每个公司的面试偏好也不同——有的看重技术、有的看重业务、有的看重别的。所以它不保证帮你通过面试,它只做一件实在的事:用通用的结构化追问(STAR、量化、难点),帮你把经历讲得更完整、更经得起问。想要"针对某家公司"的独到准备,光靠通用框架不够,还得靠你自己把 JD、面试复盘喂进来——这一条,我们后面会补上。
决策二:防编造,光靠"提示词"拦不住,得用代码硬拦
痛点:让 AI 按 JD 裁剪简历、生成投递版本时,它经常"顺手"多写一条经历、多编一个项目。你就算在提示词里写一百遍"不要编造",它还是时不时犯。
解法:不靠祈祷,靠硬约束。生成裁剪版时,代码层直接卡死三条:每个板块的条数 slice 到不超过原简历(物理上就不允许多出来);字段走白名单过滤(只放行已知字段);重建 id。同样的逻辑用在"AI 生成初稿"上——工作、项目经历这两个板块,代码强制留空,AI 想填都填不进去。
思维沉淀:信任边界要落到"代码"上,而不是"祈祷"上。凡是不可逆、不可信的操作,硬约束比好言相劝可靠一百倍。prompt 是"建议",代码才是"规矩"。
决策三:24 个岗位族,关键词匹配不能"裸词"
痛点:岗位名要路由到对应的"岗位族精做库",靠关键词命中。一开始图省事用裸词,立刻出岔子:"教育"用"培训"去匹配,结果 HR 的"培训专员"被误命中;"传媒"用"内容",运营的"内容运营"也被卷进来。
解法:把匹配词定精确——"教育"用「教师 / 教学」而不是裸"培训";"传媒"用「新闻 / 编辑」而不是裸"内容";"游戏开发"用「游戏开发 / unity」而不是裸"游戏";大数据和数据分析用「数据开发 / 数据分析」区分。每个岗位族的关键词,都刻意避开和别的族重叠。
思维沉淀:模糊匹配省事,但边界模糊是 bug 的温床。分类、路由这类逻辑,宁可多花点时间把关键词定准,也别图省事用裸词。省下的那点事,迟早变成串味的事故。