ARTICLE · 1038025
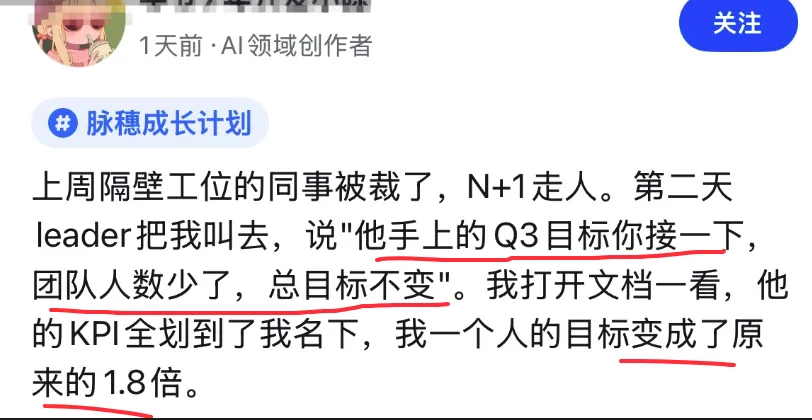
上周隔壁工位的同事被裁了,我打开文档一看,他的KPI全划到了我名下,我一个人的目标变成了原来的1.8倍.
某网友吐槽,同事被裁后拿着N+1离开,第二天 leader 直接把对方 Q3 的目标划到自己名下,一个人的目标变成原来的1.8倍。
先不讨论这个目标是否合理,我看到这个场景第一反应反而是之前接手过的一套批处理系统:业务量涨了接近一倍,机器和线程数没变,需求却要求处理时效不变。
这种问题在 Java 系统里很典型。吞吐量不是把任务数乘1.8,线程池也跟着乘1.8就能解决。系统里只要有一个共享瓶颈,扩线程甚至会让它更慢。
当时有个结算任务,每天凌晨扫描待处理记录,调用计费服务,再更新处理状态。最初数据量不大,代码非常直接:
List<Long> ids = settlementDao.queryPending(2000);for (Long id : ids) { executor.execute(() -> settle(id));}voidsettle(Long id){ Settlement row = settlementDao.findById(id); BillingResult result = billingClient.calculate(row.getAccountId()); settlementDao.markSuccess( id, result.getAmount() );}线程池配置也不复杂:
new ThreadPoolExecutor(20,20,0, TimeUnit.SECONDS,new LinkedBlockingQueue<>(10000),new ThreadPoolExecutor.CallerRunsPolicy());每天40万条的时候,凌晨任务大概两小时结束。后来业务合并,待处理数据涨到70万左右,产品要求仍然在原来的窗口内跑完。
最自然的处理方式就是加线程。20改成40,上线以后确实快了一点,但远没有达到两倍。更麻烦的是凌晨开始出现接口超时:
02:13:41 BillingClient - read timeout, cost=3012ms02:13:42 BillingClient - read timeout, cost=3008ms02:13:43 HikariPool - Connection is not available,request timed out after 3000ms我一开始判断是数据库压力上来了,因为 Hikari 已经报连接获取超时。查慢 SQL,却没发现特别异常的语句。
SELECTid, account_idFROM settlementWHEREstatus = 0ANDid > ?ORDERBYidLIMIT2000;执行计划走的是联合索引:
KEY idx_status_id(status, id)单次查询基本在几十毫秒以内。继续看监控才发现方向错了:数据库连接池耗尽只是结果,真正先被打满的是下游计费接口。
调用链数据很明显:
settlement-worker -> billing-service20 threads:QPS 185P99 420mstimeout 0.2%40 threads:QPS 207P99 2.8stimeout 11.7%线程翻倍以后,下游吞吐量只从185涨到207,P99却从420ms冲到了2.8秒。大量工作线程卡在 HTTP 调用上,同时事务没有及时结束,最终把数据库连接也占住了。
这里其实还有个更隐蔽的坑。当时 settle() 外层加了事务:
@Transactionalpublicvoidsettle(Long id){ Settlement row = settlementDao.findById(id); BillingResult result = billingClient.calculate(row.getAccountId()); settlementDao.markSuccess( id, result.getAmount() );}这意味着线程调用下游的几百毫秒甚至几秒里,数据库事务一直没有结束。业务量小时问题不明显,一旦下游开始抖动,连接池就会被迅速拖死。
所以第一步没有继续扩线程,而是把远程调用移出事务,只让最终状态更新进入短事务。
publicvoidsettle(Long id){ Settlement row = settlementDao.findById(id); BillingResult result = billingClient.calculate(row.getAccountId()); transactionTemplate.executeWithoutResult(tx -> {int affected = settlementDao.markSuccess( id, result.getAmount() );if (affected != 1) {thrownew IllegalStateException("settlement state changed: " + id ); } });}对应 SQL 也加上状态条件:
UPDATE settlementSETstatus = 1, amount = ?, finished_at = NOW()WHEREid = ?ANDstatus = 0;这样即使任务因为超时发生重复调度,也不会无条件覆盖已经处理完成的数据。
事务缩短以后,Hikari 超时基本消失,但70万任务还是无法在两小时内完成。这时候不能再靠“线程数感觉应该够”来判断,而是直接算吞吐量。
两小时处理70万条:
700000 / 7200 ≈ 97 TPS单次结算不是只有一次调用。高峰时计费接口P95大约650ms,如果40个线程大量时间都在等待远程响应,理论并发需求已经接近:
97 × 0.65 ≈ 63但直接开64个线程还是会重新压垮下游,所以后来把“本地执行能力”和“下游允许吞吐量”拆开。线程池负责消费,限流器控制真正进入计费服务的并发。
privatefinal Semaphore billingSlots =new Semaphore(24);voidsettle(Long id){boolean acquired = false;try { acquired = billingSlots.tryAcquire(500, TimeUnit.MILLISECONDS );if (!acquired) { retryQueue.offer(id);return; } doSettlement(id); } catch (InterruptedException e) { Thread.currentThread().interrupt(); } finally {if (acquired) { billingSlots.release(); } }}这里没有简单地把线程池缩回20。线程池可以维持较高并发,因为任务还有查库、状态更新等操作;真正昂贵的下游调用单独限制并发。这样某个依赖变慢时,不至于把整个 worker 的资源一起拖死。
继续看调用链后发现,每条记录都会先根据 account_id 查询账户配置。70万条记录实际只有8万多个账户,同一个账户配置被重复查询很多次。
原来的代码:
for (Settlement task : tasks) { AccountConfig config = configDao.findByAccountId(task.getAccountId()); calculate(task, config);}后来每批2000条先把账户ID去重,再批量查询:
Set<Long> accountIds = tasks.stream() .map(Settlement::getAccountId) .collect(Collectors.toSet());Map<Long, AccountConfig> configMap = configDao.findByAccountIds(accountIds) .stream() .collect(Collectors.toMap( AccountConfig::getAccountId, Function.identity() ));for (Settlement task : tasks) { calculate( task, configMap.get(task.getAccountId()) );}SQL 从大量单行查询变成批量查询:
SELECT account_id, rate, rule_versionFROM account_configWHERE account_id IN (?, ?, ...);最终数据库 QPS 明显下降,任务完成时间才真正压回窗口内。整个过程中没有上 MQ,也没有拆新服务,因为当时的问题还没严重到需要改变任务模型;缩短事务、限制下游并发、消除重复 IO,已经能解决。
回到那个“一个人接1.8倍目标”的场景,软件系统也经常收到类似要求:流量涨80%,资源和时效不变。这个时候最危险的操作,就是把线程数也乘1.8。先把调用链里的真实瓶颈找出来,通常比继续堆并发有效得多。