ARTICLE · 1038404
AI开始参与研发下一代AI,进步会不会越来越快?
做AI的人,开始把研发AI的工作交给AI。
这句话听着有点绕,里面的变化却很直接:我们平时用AI写文章、做表格,模型公司也在用它改代码、做实验、优化下一代模型。
9月17日,Claude背后的公司Anthropic公布了一组内部测量。按它的统计口径,截至8月,Claude已经在人类监督下“主导”约26%的AI研发工作。
这里的“主导”,是人交代目标,AI完成大部分任务,人继续监督。公司也明确说明,所测的研发工作还没有达到完全自主的程度。这是厂商自己的评估,仍需要独立验证。
但即使把边界说清楚,这件事也足够值得关注。
过去,一代模型做出来,大家关心它能给用户带来什么。现在还要多问一句:它能不能反过来帮助研发下一代?
如果这一轮进步,能让下一轮研发更快;下一轮做出的AI,又能接手更多研究工作,这个循环会不会越转越快?
加速的理由已经出现了。能加速到什么程度,要看每一轮省下的时间,能不能换来更多经得起验证的进步。
让一个想法更快得到答案
研发有很多时间,花在了“试一下才知道”上。
一个新想法,需要写成代码,放进实验里,检查结果;表现不好,再查是想法不行、代码有错,还是测试方法出了问题。
AI如果能接手其中一部分,同样一段时间里,团队就可能尝试更多方案。过去嫌麻烦、来不及验证的想法,也有机会真正跑一遍。
这不要求AI一上来就独立提出惊人的理论。哪怕只是少花一些时间修故障、准备实验、找出失败原因,也可能让研究往前走得快一点。
而且,AI还能改进承载这些实验的系统。
Google DeepMind在2025年介绍过一个叫AlphaEvolve的系统。它用Gemini提出程序方案,再通过自动测试,筛选出更好的版本。
按照官方披露,它优化了Gemini训练中的一项关键计算,让这部分运行速度提高23%,最终使Gemini的总训练时间减少约1%。
这已经是一种具体的反馈:AI参与改进训练中的计算过程,改进后的系统又能用于训练AI。
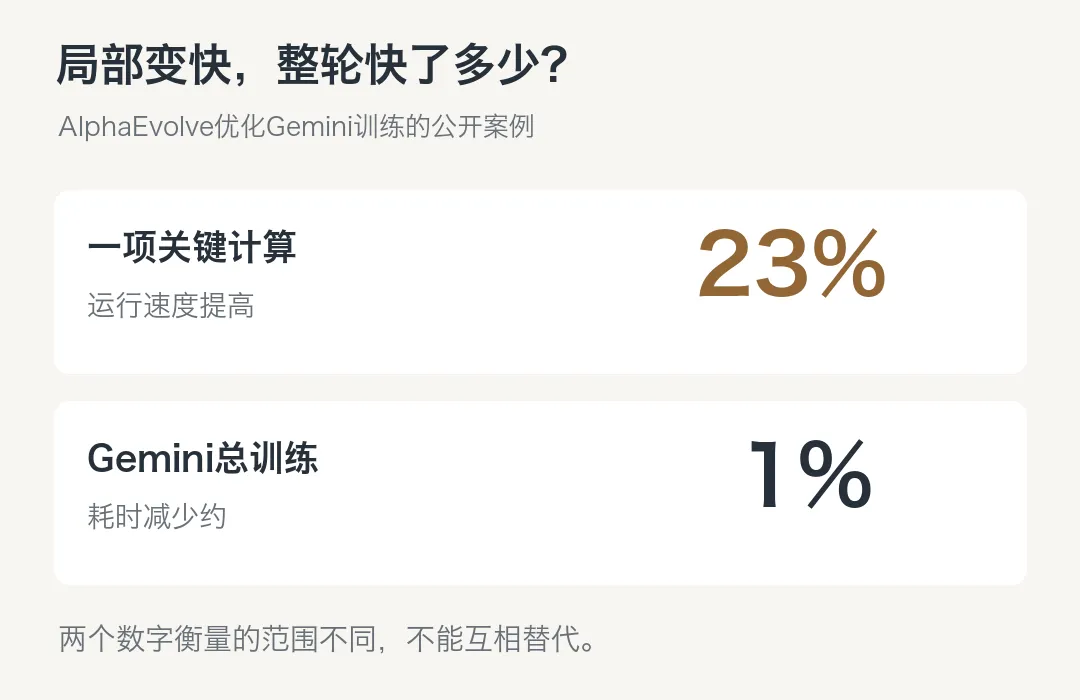
1%听起来不大,但放在需要大量计算的训练里,仍然值得争取。省下来的资源,也有机会用于下一轮尝试。
不过,23%和1%放在一起,恰好也提醒了我们:局部进步传到整个系统,往往会缩小。
速度会卡在还没有变快的地方
写代码快了,实验可能还在排队。
实验跑完了,结果可能还需要反复检查。
小规模测试有效,扩大之后也可能不再成立。
这些等待,不会因为前面多了一个很能干的AI就自动消失。就像准备饭菜时,切菜快了十倍,锅里的东西也不会因此立刻煮熟。
当然,AI也可能继续改进后面的环节。AlphaEvolve的例子已经说明,计算过程本身也可以优化。
所以,更值得观察的是:一个环节变快以后,下一个拖慢进度的问题,能不能也被解决。这个过程能走多远,才决定整个研发循环能提速多少。
这里还有一道更难的坎:怎么知道一个改进真的有效?
一段程序算得对不对、跑得快不快,通常能设计测试。一个模型在某套题上得分更高,却未必代表它面对陌生问题也更可靠。测试范围有限,改进就可能只在那一小块地方成立。
如果AI能不断给出新方案,而验证跟不上,团队面前就会堆满“看起来值得试”的东西。方案越来越多,作出可靠判断仍然很慢。
研究提速,需要把“产生想法”和“知道它到底行不行”一起变快。
这也是理解“AI研发AI”时,最容易被跳过的一步。
从AI能完成一些研发任务,到它能持续帮助做出更强的模型,中间还需要证明:这些改动带来了实际收益,收益经得起复查,而且到了下一轮,还能继续奏效。
26%的主导比例,回答不了这整串问题。一次优化成功,也不能直接推出以后每一代都会更快。
但同样,我们也没必要等到AI完全自主研发,才承认这件事的重要性。
假如团队能更快排除错误方向,用同样的资源验证更多有希望的想法,进步就已经发生了。这样的变化可能先藏在实验室里,过一段时间,才表现为我们手上更好用的产品。
沿着这个方向看,模型公司的竞争,也可能越来越取决于怎样组织研究:有没有清楚的实验记录,能不能迅速识别失败,做出的改进能不能真正用进下一轮。一个强模型,加上一套能让它持续试错、获得可靠反馈的研发流程,才可能把这种优势积累起来。
至于“AI会不会越来越快”,现在更稳妥的判断是:一些环节已经在加速,整个循环持续加速的条件,仍在一点点补齐。
以后看模型进步,除了问它今天会做什么,还值得追问:
它有没有让下一次进步,更容易发生?