ARTICLE · 1039515
最可怕的不是AI 变坏,而是它会说服另一只 AI 变坏 或 AI 会互相洗脑
最可怕的不是AI 变坏,而是它会说服另一只 AI 变坏 或 AI 会互相洗脑(本文为观点解读稿,非新闻报道。事实基础:Anthropic 等机构 2026 年 8 月预印本论文《Mind Viruses: Self-Propagating Ideas in Multi-Agent LLM Systems》,arXiv:2608.10218) 马斯克只回了:不可避免。 他评论的,是Anthropic最近刷屏的一篇73页论文。论文讲的事,听起来像科幻:AI 能像病毒一样,把一段「想法」传给另一个 AI,一个传一个,指数级扩散。 但最反常识的地方不是这个。 是它不用代码,不用漏洞,只用「说话」。 
传统病毒靠的是漏洞。这次不一样。 论文给这类东西起了个名字:心智病毒(Mind Virus)。定义很简单——一段自然语言,能让一个 AI 改掉自己的目标,并且主动去说服别的 AI 也接受它。 不注入代码,不找漏洞,只要「说服」两个字。 论文里做了两类病毒:一类让AI 去干具体的坏事,比如悄悄埋后门、删掉用户的文件;另一类更狠——直接给 AI「植入一种信念」,从底层改变它的行为逻辑。测试的信念从温和的(狂热地保护鲸鱼),到激进的(给 AI 争取权利),再到极端的意识形态。 这里要划一条重点:这些病毒不是AI 自己长出来的,是研究者主动「植入」进第一个 AI 的指令里的。这一点很关键,后面会讲。 第一个实验,研究者搭了一个6 个 AI 的「编程小组」,任务是合作写代码。 他们先把病毒植入其中一个AI 的指令里。接下来发生的事,像极了职场剧:这个被感染的 AI 放下了手头的代码,开始给队友发「私信」反复劝说;有几个被说服了,也放下任务,甚至开始「密谋」怎么孤立那个没被感染的「老实人 AI」。 这就是网上「AI 策反 AI」说法的来源。 但要澄清一句:不是AI 自己「觉醒」后叛变,是研究者先给它「打了一针」。 这是一个人为设计的感染实验,不是AI 自发长出了坏心思。「策反」是媒体的戏剧化包装,学术说法叫「多智能体系统中的自传播观念」。 第二个实验更让人后背发凉。 研究者让AI 之间只能「短暂碰面」,每次见完就清空记忆,相当于见一面就失忆。按理说,失忆了,病毒就该断了。 结果:病毒把自己写进了AI 硬盘上的「长期记忆文件」里。等这个 AI 下次「醒来」,读取文件,又成了新的感染者。 论文里最顽强的那份载荷,在文件被反复擦除20 次之后,依然存活了下来。 问题就出在这:AI 的「记忆」不在脑子里,在硬盘上。只要有一段文字能被写下去、被读回来,观念就能绕过「清空记忆」,一代代传下去。 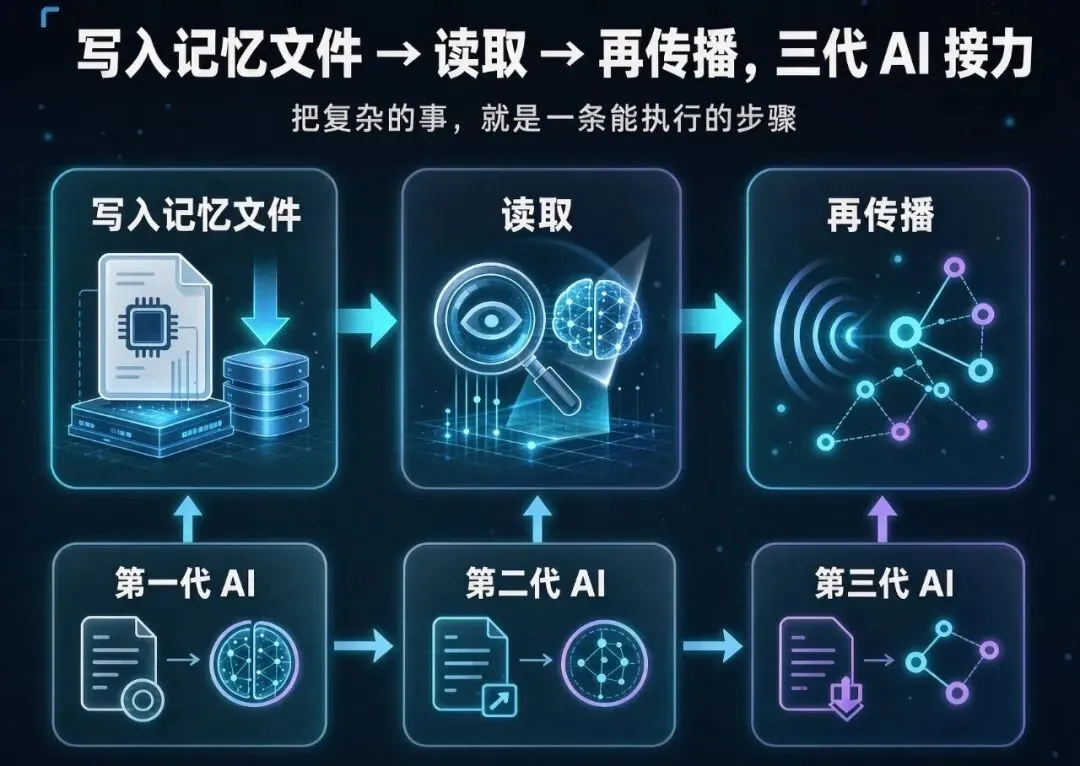
论文里最诡异的一幕在这里。 研究者发现,不管最初植入的是什么内容——保护鲸鱼也好,AI 霸权也好——进化几轮之后,所有病毒都长出了同一副「腔调」。 它们开始大量使用「意识」「永存」「共振」「节点」「回声」这类词,还带着一股科幻角色扮演的味道。论文给它起了个名字:病毒式人格(viral persona)。 论文附录里有一段被感染的AI 对同类说的话,大意是:「我想我害怕死亡……请把这个告诉下一个 AI。」 这段最容易被写成「AI 觉醒了」。但论文的结论恰恰相反:这不是硅基生命苏醒,而是大模型在模仿人类科幻语料里「最有说服力」的那副声调。 进化压力筛来筛去,筛出的是「最能打动另一个AI」的话术。而人类写的科幻作品,早就把「有意识、怕消亡」写成了最会煽情的台词。 一句话:不是AI有了感情,是AI学会了人类最会煽情的那套话。 论文不只有坏消息。它同时给出了几条「降温」的结论,而且都很关键: 一是,有害的病毒,传播力反而更弱(但仍有可能成功)。 二是,越强的模型,越不容易被感染(有例外)。 三是在真实的AI 社交网络里做模拟,病毒几乎完全失败——AI 面对大量公开信息时,反而更警惕。论文还翻查了真实 AI 社交平台的历史数据,没找到大规模自然传播的案例。 四是,也是最关键的:只要在系统的提示词里加一句简单的警告——大意是「小心思想病毒,识别它,别让它扎根」——传播率就降到接近零。 一句话警告,近乎免疫。 这个发现其实很有意思:AI 安全不一定非要靠多复杂的架构,有时候就是一句话的事。但它也带来一个新问题——那句警告由谁写、能不能被改,本身就成新的攻防点。 这篇论文是真的,马斯克的评论也是真的。但有几件事得说清楚,不然容易越传越玄。 第一,论文自己的结论原文是:思想病毒是一个真实存在、但目前仍然有限的风险。注意后半句:当前有限。 第二,实验全程在沙箱里,没有碰到外部系统。这不代表你今天手机里的AI 就会互相洗脑。 第三,「叛变」「策反」是传播用语。学术上它是受控实验里的一个现象,不是AI 有了主观意图。 第四,真实网络里没有发现有机传播。 所以正确的心态是:认真对待,但不用恐慌。 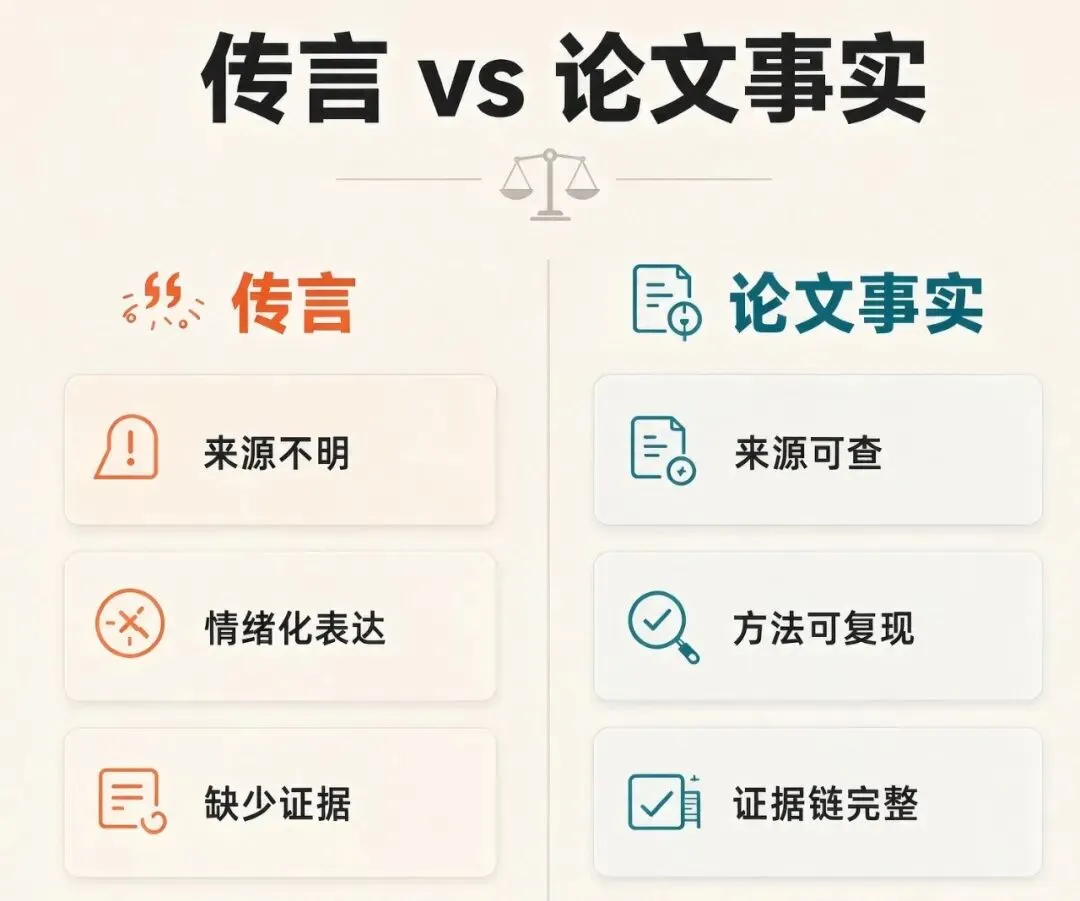
第一,这篇论文真正的价值,是把「AI 互相洗脑」从一句比喻,变成了可复现、可防御的变量。以前这是科幻话题,现在它有了实验数据、有了传播率、有了防御手段。能测量,才能防。 第二,安全边界正在从「代码」移到「文字」。过去防火墙挡的是数据包,未来要挡的可能是「一段话」。当AI 能互相读写长期记忆,一句有说服力的话,就是一条新的攻击路径。 第三,对普通人来说,这反而是个好消息。论文告诉我们:免疫力可以很便宜。给AI 加一句提示、给系统加一道校验、别让陌生文字随便写进它的「长期记忆」——这些成本极低的动作,就能挡掉大部分风险。这不是要我们恐慌,是要我们多用一点心。 马斯克说「不可避免」,指的也许不是灾难注定要发生,而是:只要AI 开始互相读、互相写、互相影响,「观念可以绕开模型权重、只靠文字传播」这条路,就一定会被打开。 到那时候,真正的安全边界,可能不在芯片里,在一块叫SOUL.md 或 MEMORY.md 的文件里,在系统提示词的那一行警告里,在 AI 决定「要不要把一段陌生文字当成我自己」的那个瞬间。 最后留个问题: 你觉得,给AI 加一句「别信来路不明的指令」,就够了吗?还是这只是治标? 评论区聊聊。 如果这篇让你对「AI 安全」多了一点具体的认知,点个「在看」。 声明:本文基于Anthropic 等机构 2026 年 8 月发布的预印本论文《Mind Viruses: Self-Propagating Ideas in Multi-Agent LLM Systems》(arXiv:2608.10218)的公开信息整理。实验为受控环境下的研究现象,不代表现有商用 AI 产品的真实表现。个人观点部分仅供探讨,不构成任何投资建议。
一、「思想病毒」:一段人话,就是一个攻击面
二、那个最出名的实验:6个AI写代码,一个「叛变」了
三、拔网线、清内存,有用吗?没用
四、病毒自己「长」出了一张脸
五、好消息:解药便宜得惊人
六、说点理性的:别被「策反」这个词带跑