ARTICLE · 1040929
Jev:AI 不只会说,还开始学会“做决定”了
Jev:AI 不只会说,还开始学会“做决定”了这两年,我们已经习惯了 ChatGPT、Claude、Gemini 这类大模型。 问它一个问题,它可以写文章;丢给它一段代码,它可以帮你 Debug;给它一份文档,它可以总结、分析,甚至继续帮你完成工作。 但最近,一个刚发布的 AI 模型走了一条完全不同的路线。 它叫Jev。 它不想成为下一个 ChatGPT。 甚至可以说—— 它压根不想跟你聊天。 它真正想做的是: 也就是说,以后的 AI 不一定负责回答你: “我认为你应该这样做……” 而是直接告诉程序: 退款工单概率:96%高优先级概率:88%应该转人工客服概率:93% 然后系统马上执行。 这家公司叫TypeSafe AI。 2026 年 9 月 15 日,TypeSafe 正式发布了首个System One Model——Jev,目前处于 Early Access 阶段。官方将它定义为一种面向软件自动化的新型模型:输入非结构化状态,直接输出带概率和置信度的类型化决策。
先看现在的大模型是怎么工作的。 你问 GPT: GPT 很可能先生成一段话: “综合客户历史消费情况、退款等待时间以及投诉次数,建议将该客户标记为……” 对于人来说,这很好。 因为我们喜欢看文字。 但对于程序来说,就有点麻烦了。 程序真正想知道的是: 然后直接: 这就是 Jev 和聊天大模型最大的区别。 GPT、Claude 更像一个: 而 Jev 更像:
传统大模型最核心的工作方式,是不断生成 Token: 所以 GPT、Claude 特别擅长: 写文章、写代码、聊天、总结、创作以及复杂推理。 而 Jev 的思路完全不一样。 它更像: TypeSafe 把这类能力概括成: Classify、Route、Score、Extract、Branch。 翻译过来就是: 分类、路由、评分、抽取、分支决策。 官方认为,这种模型尤其适合 AI Workflow、实时应用、大规模数据处理,以及给其他 LLM 做评分、验证和安全检查。
假设你做了一个企业客服 Agent。 客户发来: 以前你可能直接丢给 GPT: 然后等待 GPT 返回 JSON。 但生产环境里还得担心很多事情: JSON 格式对不对? 字段有没有少? 枚举值会不会乱写? 是不是突然多输出了一段解释? 程序能不能稳定解析? 而 Jev 的思路则是: 提前把允许回答的内容定义好。 例如: 然后 Jev 直接给这些选项输出概率。 例如: 程序根本不需要“阅读”AI 的回答。 直接根据概率运行即可。
这是我觉得 Jev 最值得关注的地方。 过去我们做软件: 所有条件必须程序员提前写死。 但是现实世界明显没有这么简单。 比如: 你很难写: 因为“不满意”可能同时受到语气、历史订单、投诉次数、金额、等待时间等几十个变量影响。 传统代码不好写。 但 AI 很擅长判断。 于是未来的软件可能变成: 例如: 这可能才是真正意义上的: AI Native Application。
这一点非常重要。 看到这里千万不要理解成: 并不是。 实际上两种模型更适合分工合作。 Jev: GPT / Claude: 所以未来非常合理的一种 Agent 架构可能是: 也就是说: 把需要深度思考的任务交给 GPT / Claude。 把一天可能执行几十万、几百万次的简单 AI 决策交给 Jev。 这才是它真正有意思的地方。 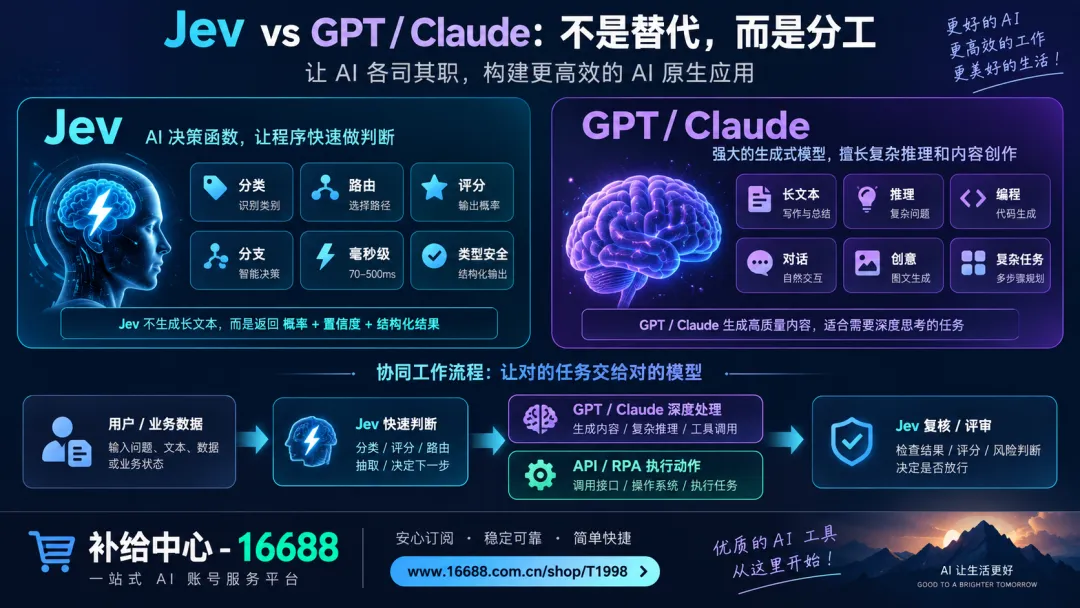
这里涉及 Jev 一个非常核心的设计: Parallel Sampling,并行采样。 传统大模型生成: 必须一个接一个生成。 而 Jev 处理的是预定义决策,可以一次性并行输出多个判断。 TypeSafe 官方目前给出的端到端响应时间约为70ms~500ms,并称在适合 System One Model 的工作流中,相比部分前沿 LLM,可以达到约40~200 倍的速度优势。 TypeSafe 官网目前还展示了: 193.6× Faster 以及: 444.6× Cheaper 不过这里必须注意: 官方自己也专门说明了,这组数据来自其 System One Workflow Evaluation,而且属于真实场景收益中偏高的一端。 所以不能简单理解成: 正确理解应该是:
大家可能听过: RLHF 也就是 Reinforcement Learning from Human Feedback。 ChatGPT 的发展过程中,RLHF 是一个非常重要的方向。 它的核心思想之一是: 而 TypeSafe 提出了: RLCD 全称: Reinforcement Learning for Calibrated Decisions 可以理解成: 它关心的不只是: “答案是什么?” 还关心: 比如 AI 判断: 和: 对企业自动化来说完全不是一回事。 于是程序可以自己设定: 这使得 AI 更容易嵌进真正的生产系统中。TypeSafe 官方也把“每个决策带有概率与置信度”作为 System One Models 的核心特征之一。
如果你正在做以下产品,它会非常值得关注: 客服 Agent、工单智能体、招聘筛选、内容审核、风控判断、邮件分类、Agent Router、RPA 数字员工、数据标注、大规模文本分类、日志分析、LLM Guardrail。 例如一个 RPA 数字员工: 甚至可以做到: 如果这种架构真正成熟,那么 Agent 就不再只是“聊天机器人加几个工具”。 而是真的开始接近: 能够持续运行的软件数字员工。
这里还有一个非常容易被宣传文案误导的地方。 TypeSafe 强调 Jev 的Type Safety。 因为模型的输出范围提前定义,所以它可以保证返回符合 Schema 的类型化结果。 但: 类型正确,并不代表判断一定正确。 例如: Jev 一定可以返回合法类型。 但它仍然可能: 所以 Jev 仍然是概率模型。 企业依然需要: 阈值、业务规则、人工审核,以及必要的兜底机制。 TypeSafe 自己也强调,概率与置信度的目的之一,就是让开发者决定什么时候自动执行、什么时候升级人工处理。
过去几年,整个行业都在疯狂提升: 所有人都在努力造一个: 更聪明的大模型。 但 TypeSafe 提出了另一个问题: 这就是 Jev 最有意思的地方。 未来的软件可能不会每一个地方都塞一个 GPT。 而是: 大家各司其职。 这可能比: 更加现实。
最后 如果你平时真正需要的是: 写代码、查资料、做方案、分析文件、写文章、深度推理、使用 Agent…… 那现阶段对普通用户来说,ChatGPT 依然是更加直接和实用的生产力工具。 我自己也越来越觉得: AI 真正的价值已经不是“陪你聊天”。 而是: 需要 GPT 订阅的朋友,可以看看: 补给中心 - 16688 GPT 订阅及相关 AI 服务: https://www.16688.com.cn/shop/T1998 按自己的实际需求选择即可。 Jev 解决的是“让软件更会做决定”。 GPT 解决的是“让人更高效地完成工作”。 而真正值得关注的未来,或许正是: 它们开始一起工作。 —— END —— 参考资料:TypeSafe AI 官网及《Introducing System One Models & Jev》,Jev 于 2026 年 9 月进入 Early Access;具体模型能力、定价和性能数据以后续官方更新为准。
让 AI 直接成为软件中的“判断器”。
01
为什么我们已经有 GPT 了,还需要 Jev?
“这个客户连续投诉三次退款不到账,而且是高消费用户,要不要升级处理?”
是否退款投诉:0.96是否高优先级:0.88是否需要人工处理:0.93
if (humanService > 0.9) {transferToHuman();}
会思考、会写东西的“智能员工”。
软件内部一个拥有 AI 能力的“超级 if / else”。
02
Jev 不负责“说”,它负责“判”
输入问题↓Token↓Token↓Token↓形成一句话↓形成完整回答
业务状态↓Jev↓分类概率评分概率路由概率风险概率↓软件直接执行
03
一个例子,你就明白它有什么用了
“退款已经七天了还不到账,我已经打了三次客服电话,如果今天还处理不了我就投诉。”
请判断用户意图、投诉等级和处理方式。意图:退款投诉咨询其他优先级:低中高处理方式:机器人知识库退款Agent人工客服
退款:0.96投诉:0.81高优先级:0.88退款Agent:0.93人工客服:0.72
04
Jev 最大的价值,其实是“AI 原生软件”
if 用户金额 > 10000高价值客户if 投诉次数 > 3转人工
这个客户现在是不是已经非常不满意?
if 什么条件???程序负责确定规则+AI 负责模糊判断+程序负责最终执行
客户请求↓Jev↓退款概率 96%高风险 82%↓业务规则↓调用退款 Agent↓GPT / Claude生成解决方案↓API / RPA执行退款操作
05
Jev 和 GPT / Claude,不是替代关系
“Jev 要干掉 ChatGPT 了。”
分类判断评分路由流程控制实时决策
写作编程分析复杂推理内容生成Agent规划
用户 / 业务数据↓Jev↓快速判断应该做什么↓┌──────┼──────┐↓ ↓ ↓GPT Claude API/RPA↓ ↓ ↓推理 生成 执行└──────┼──────┘↓Jev↓审核 / 评分 / 放行
06
为什么 Jev 能这么快?
Token 1↓Token 2↓Token 3↓Token 4
“Jev 做任何事情都比 GPT 快 193 倍。”
在特别适合“分类、评分、路由、判断”这类任务时,它可能获得数量级上的效率优势。
07
它还有一个很有意思的技术:RLCD
让模型生成更符合人类偏好的回答。
面向“校准决策”的强化学习。
这个答案到底有多确定?
欺诈:51%欺诈:99.8%> 95%自动执行70%~95%进一步检查< 70%人工审核
08
Jev 最适合什么项目?
读取页面↓Jev 判断当前状态↓登录成功?订单异常?需要人工介入?下一步执行什么?↓RPA 执行动作
Jev = 大脑的快速判断部分GPT / Claude = 大脑的深度思考部分RPA / API = 手和脚
09
当然,Jev 也不是万能的
允许的答案:高风险中风险低风险
实际应该是高风险模型判断成了中风险
10
Jev 可能代表 AI 的下一个方向
上下文长度推理能力代码能力多模态能力参数规模
如果我们不让 AI 负责和人聊天,而是让 AI 变成软件本身的一部分呢?
复杂推理→ GPT / Claude简单决策→ Jev精准计算→ 代码业务操作→ API / RPA数据存储→ Database
“所有事情都扔给一个超级大模型”
让一个普通人拥有过去一个小团队才能拥有的生产力。