ARTICLE · 1048336
AI为什么能处理超大Excel,却不消耗等量Token?
让AI处理十几万行Excel、生成上百MB的SQL,是否意味着模型必须"读完"全部内容,并消耗同等规模的Token?答案是否定的。关键在于:模型负责思考和编排,程序负责批量计算。
01 | Token到底花在哪里
Token可以简单理解为模型读取和生成文本时使用的计量单位。只有进入模型上下文的内容,才会占用对应的Token。
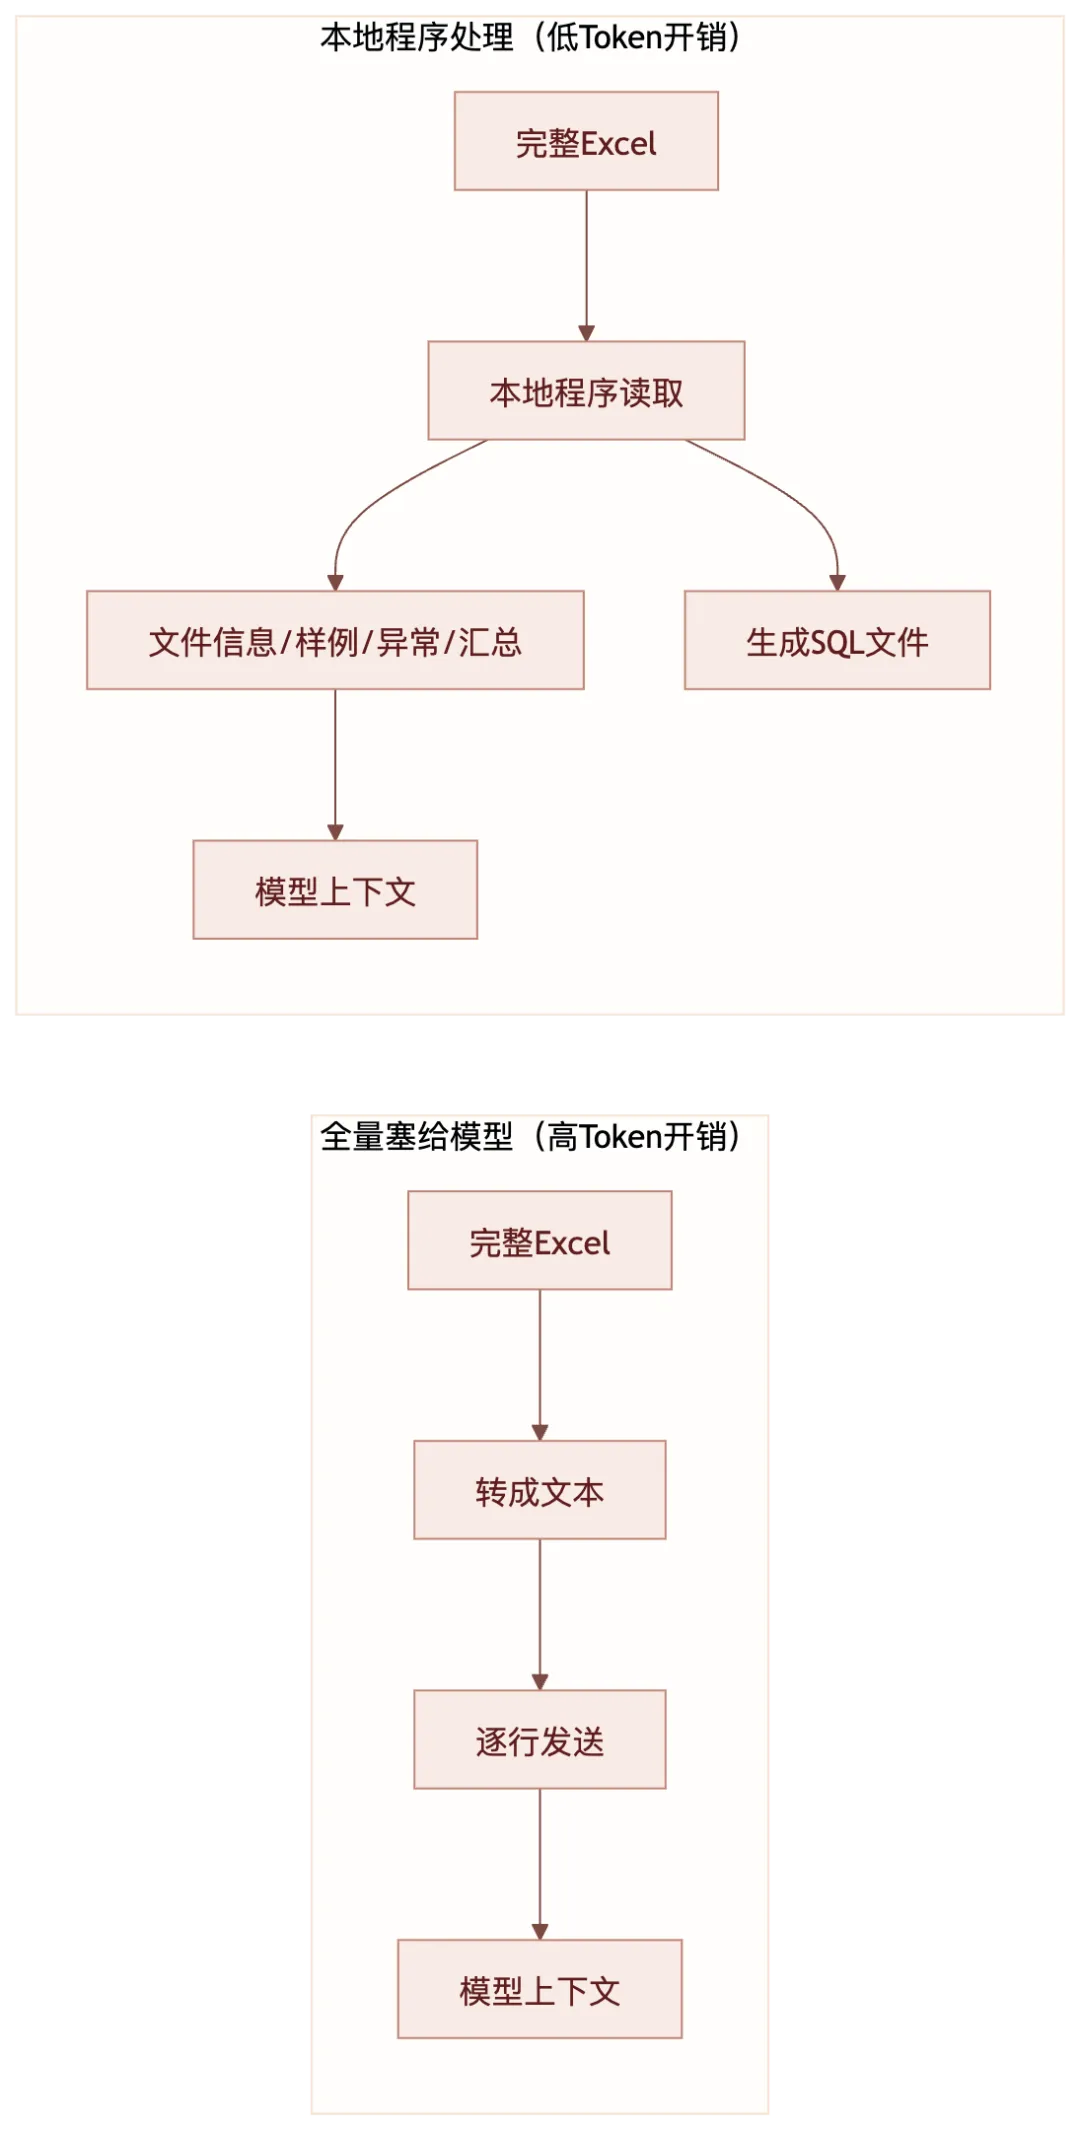
如果把完整Excel转换成文本,再逐行发送给模型,确实会产生巨大的Token开销,还可能超过上下文限制。但在实际工程中,大文件通常留在本地,由Python等程序直接读取。模型只需要看到文件信息、少量样例、异常和汇总结果。
因此,一个145MB的SQL文件可以被生成出来,却不需要让145MB文本全部经过模型。需要说明的是,这里的145MB只是一个示例量级;Token与字节数并非线性对应,具体换算取决于文本编码、语言和分词方式,应以实际模型的计量结果为准。
下面这张图对比了"全量塞给模型"和"本地程序处理"两条路径中,Token实际流经的位置:
02 | 模型与程序如何分工
这类任务可以分成"判断"和"执行"两部分。
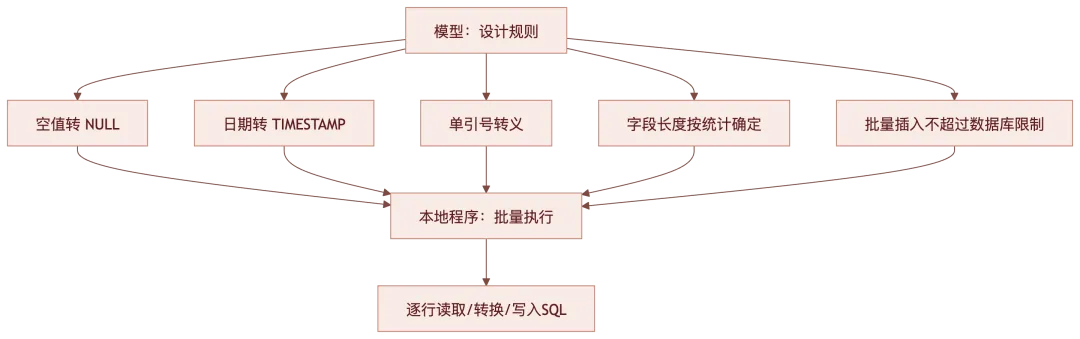
模型负责设计规则,例如:空单元格转换为NULL,日期转换为Oracle的TIMESTAMP,文本中的单引号需要转义,字段长度要根据数据统计,批量插入不能超过数据库限制。
本地程序负责重复劳动:逐行读取Excel、统计字段、转换单元格、写入SQL文件。相同的规则可以稳定执行十几万次,而不需要模型逐个处理单元格。
可以把模型理解成建筑师,把程序理解成施工机械。建筑师不必亲手搬运每块砖,但需要确定图纸、材料标准和验收规则。
这种分工可以用下面的流程表示——模型只参与"判断"环节,重复的"执行"环节完全交给程序:
03 | 大文件仍然需要完整读取
不消耗等量Token,不等于不读取完整文件。
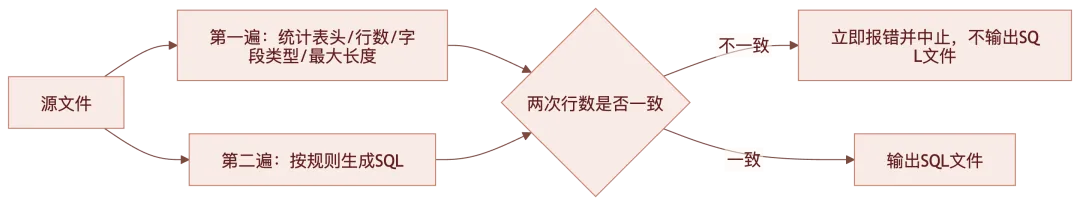
为了保证结果可靠,程序仍然可以流式扫描每一行。所谓"流式",是指读一部分、处理一部分,不把整个工作簿一次性放进内存。需要注意的是,流式读取通常不保留全部原始数据,因此"读取两遍"意味着第二遍需要重新读取源文件(或借助临时文件/中间结果),而不是复用第一遍的内存数据。
例如生成数据库初始化脚本时,可以读取两遍:第一遍统计表头、行数、字段类型和最大长度;第二遍按照确定的规则生成SQL。两次行数不一致时立即报错。该方案假设两遍读取之间源文件未被修改;若文件可能被并发写入,应先做快照或校验和锁定,避免统计结果与生成内容不一致。
文件读取消耗的是本地CPU、内存和磁盘资源,而不是模型Token。
两遍读取的流程如下,第二遍结束后会与第一遍的行数做一致性校验:
04 | 如何保障生成结果准确
准确性主要来自确定性规则和自动校验,而不是依靠模型"记住"全部数据。
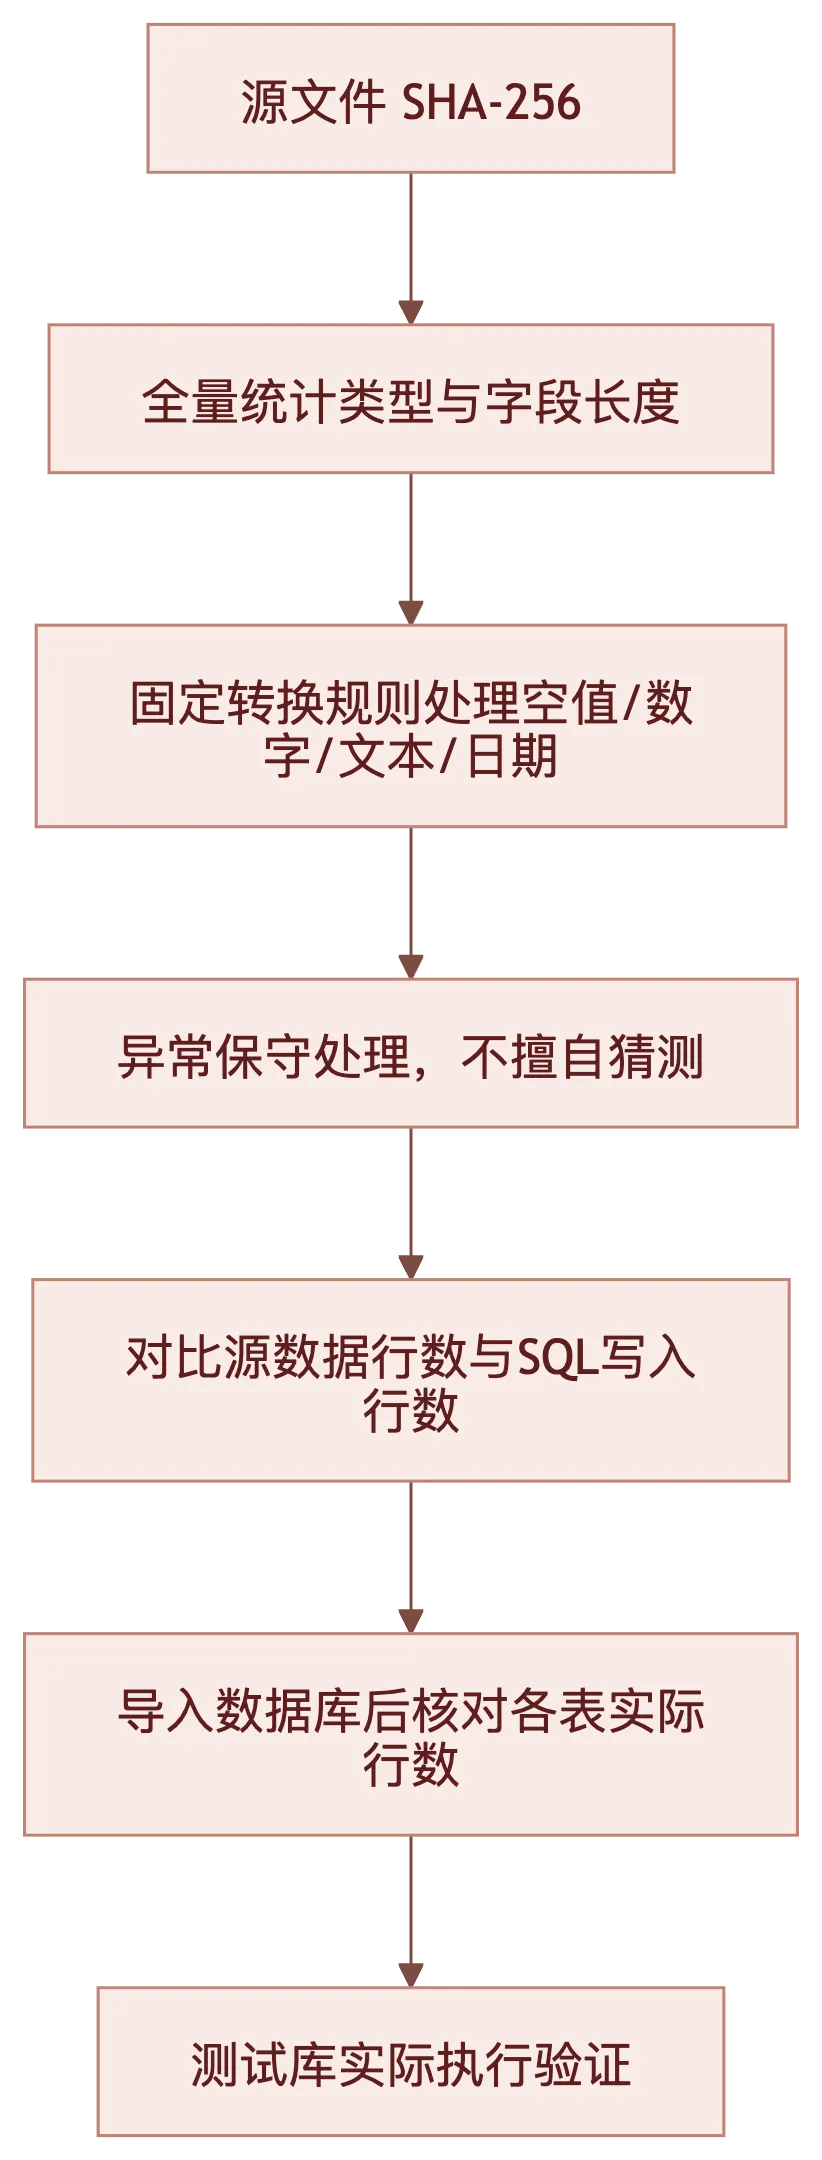
为源文件计算SHA-256,确认输入是否变化。 全量统计数据类型和字段长度,而不是只抽查前几行。 对空值、数字、文本、日期分别采用固定转换规则。 对日期与文本混用等异常采取保守策略,避免擅自猜测。 对比源数据行数和生成SQL中的写入行数。 导入数据库后,再核对各表实际行数。
需要注意:静态检查不能完全替代真实数据库验证。数据库版本、字符集、权限和表空间等问题,只有在测试库实际执行后才能最终确认。
这些校验点分布在从输入到入库的不同阶段,可以按下面的顺序逐层把关:
05 | 这种模式适合哪些任务
当工作同时满足"数据量大、规则明确、重复度高"时,通常适合这种模式,例如日志分析、代码批量修改、数据格式转换、报表生成和数据库迁移。但如果规则难以形式化、需要频繁人工判断,或数据中存在大量非结构化异常,则仍需模型或人工介入,不能完全交给程序。
真正高效的AI工程,并不是把所有内容都塞给模型,而是让模型生成可靠的处理工具,再通过摘要、异常和校验结果掌握全局。这既节省Token,也让过程更可重复、更容易审计。
关注我,和AI一起成长~