ARTICLE · 1053121
AI 这么火,谁赚走了大头?(2)GPU 的生意
AI 这么火,谁赚走了大头?(2)GPU 的生意这个问题可以从一张过去两千年的人均 GDP 图讲起。曲线在绝大部分时间里几乎是平的,直到工业革命:同样的劳动和资本开始创造出更多产出,人们才逐渐拥有超出生存需要的资源。今天看好 AI 的逻辑与此相似——智能的进步,有机会让人完成更多工作、解决更多问题。 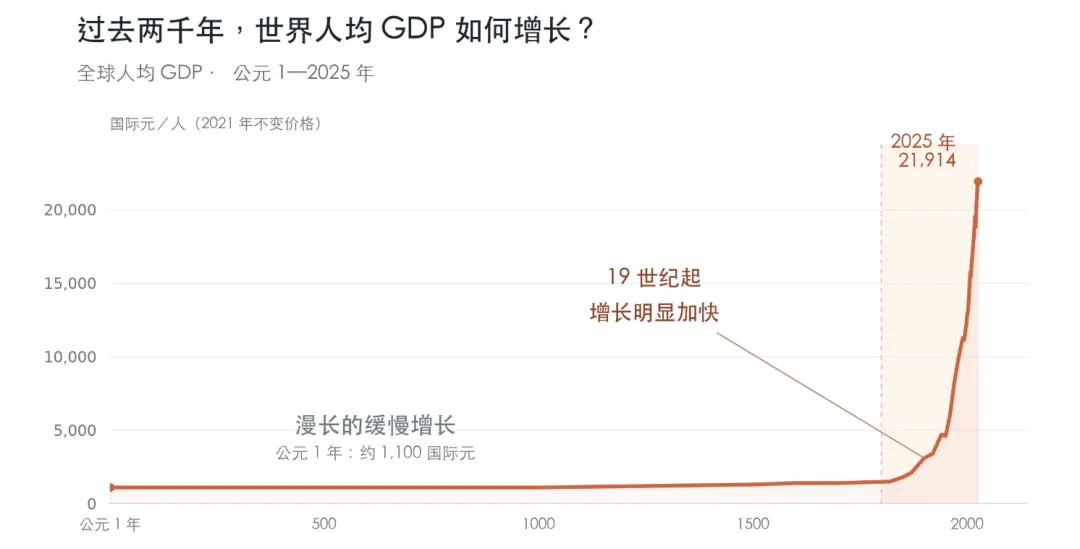
这种增长已经体现在两组数字里。第一组是占比:科技在全球 GDP 中的份额,从约 5% 升到约 13%。第二组是利润的增速:近十年,纳斯达克每股收益的年复合增长率约为 15%,非科技企业约为 6%。所谓每股收益,就是每一股对应的公司利润。AI 有机会让这条曲线继续往上走。 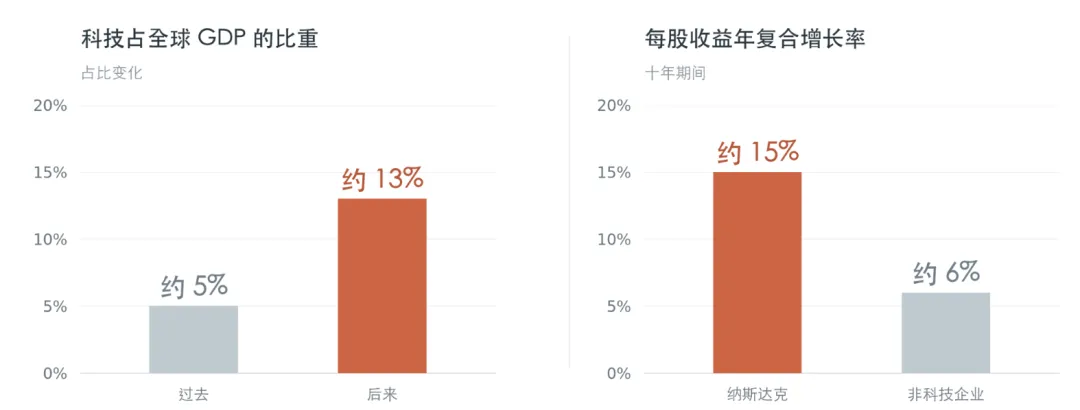
但要理解这些钱从哪里来,得先看这些服务是怎样被生产出来的。写文案、答问题、改代码,每一次调用的背后,都有芯片在运转、电力在消耗。GPU,就是承担这些计算的关键芯片。AI 要走进日常生活,先得有人提供生产它的设备——GPU 的生意,就从这里开始。 一个 AI 模型从开发到使用,主要经历两个阶段:训练和推理。训练让模型从数据中学习、获得能力;推理则是把训练好的模型用起来,回答问题、完成任务。我们平时和 AI 聊天,用到的就是它的推理能力。 很多人以为芯片主要消耗在训练阶段,但事实是:模型训练完成,芯片的工作才刚刚开始。 传统软件一旦开发完成,多服务一个用户的新增成本往往很低。AI 不一样,它有一笔持续发生的计算开销。从数据库里取出一条已有的记录,和让模型现场生成一段回答,两者需要的计算量根本不在一个量级。 差别出在生成的过程里。模型处理和生成文本时,会把文字拆成一个个小单位,叫作 token。你看到的是一句话,背后却是一连串计算。模型越大、需要参考的信息越多,每个 token 的计算负担就越重;一次任务需要生成的 token 越多,总计算量也跟着上去。 而现在 AI 的使用方式,正好在同时放大这两个变量。模型开始花更多计算去“思考”,一步步拆解复杂问题,单次任务消耗的 token 明显增加。再往后,当它能持续执行任务,计算就从一次短暂的问答,延伸成一段更长的工作过程。 所以,芯片的需求贯穿模型的开发与使用:用户更多、任务更复杂、工作时间更长,每一项都意味着更多计算。推理需求迅速膨胀,原有的硬件和云服务也开始吃紧。 这个不断扩大的市场,让一个问题变得重要:这些工作,都要交给 GPU 来完成吗? 大部分答案仍然是 GPU,原因也很自然:模型训练主要在 GPU 上完成,训练结束后,开发者往往顺手继续用熟悉的硬件来跑推理。 但当推理变成一项规模庞大、持续发生的工作,为它单独设计更有针对性的芯片,商业空间也就跟着打开了。 这个想法并不新。早在这一轮热潮之前,Google 研究语音识别时就撞上过一个问题:算法已经有了,计算设备却跟不上。当时参与其中的 Jonathan Ross 设计了专门用于机器学习计算的 TPU,用更有针对性的硬件,让这些算法真正跑起来。后来他离开 Google 创办 Groq,想把专用计算的能力带到更广阔的市场。 Groq 走的是一条不同于 GPU 的技术路线,专攻 AI 推理的效率。但技术准备好了,生意并没有随之而来。Groq 已成立多年,却一度还在为生存挣扎——足够大的市场迟迟没有出现。 推理需求爆发,终于让这些提前押注的技术等到了机会。 服务上线几周就吸引了数十万用户,后来达到约 400 万。Groq 的增长,来自两个条件的交汇:需要推理服务的人变多了,加上用这项技术的门槛降低了。 走到这一步,Groq 看起来已经攒齐了挑战 NVIDIA 的条件:有自己的芯片,也有了客户。但故事在这里拐了个弯——Groq 开始尝试和 NVIDIA 合作。 一家靠不同技术路线打开市场的公司,为什么会想到和 GPU 的主导者联手? 关键在于,开发者调用模型时看到的是一项完整的服务,底层却要走完许多不同的步骤。有些步骤吃计算能力,有些步骤吃数据的读取和搬运速度。不同的芯片,各有各擅长的环节。 NVIDIA 的 GPU 强在计算,Groq 的芯片强在高速存储。把两者连起来,各自负责更擅长的那一段,整套系统就有机会完成更多工作。这就是双方合作的出发点。 合作最终带来的效果是:在相同电力条件下,可以产出原来的 2.5 倍 token。 可以把它想象成一座工厂:一端输入电力和芯片,另一端输出 token。电力供应和厂房都没有扩大,产量却变成了原来的两倍多。同一座工厂,能接下更多活。 这种搭配思路,NVIDIA 自己也在做。它目前已经发展出包含七种芯片、五种机架的生态,从计算到存储、再到芯片之间的通信,整套系统怎么配合都在它的设计范围内。 于是 GPU 的这门生意,早已不只是卖一块算力最强的芯片,而是延伸成多种芯片互相配合的整体方案。两家公司的技术凑在一起,能创造比各自单打独斗更大的价值。 推理成本一年下降了约 90%,两年到两年半下降接近 99%。计算明明变便宜了,为什么算力还是紧缺? 先看供给一侧,主要受三件事影响:供应链、工程创新,以及可用电力。供应链决定芯片怎么制造和封装;工程师则在内存带宽、电路布局、计算精度这些环节上不断改进;电力决定这些设备最终能以多大规模运行起来。 供给确实在进步,但需求变得更快。模型越来越大,要处理的任务越来越多、越来越复杂。即使技术在五年里进步 50 倍,模型和需求也可能跑在前面。H100 价格上涨,就是这种供需压力的直接体现。 换个角度说,生产一件东西所需的资源减少了,并不代表整个社会对生产资源的需求会减少。还要看人们准备用多少,以及想让它完成什么。芯片效率提升腾出来的空间,很可能很快被更大的模型和更多任务吃掉。所以,单位推理成本下降和整体算力需求上升,完全可以同时发生。 这就是 GPU 厂商订单不断的原因。不过,需求能不能持续,还卡在下一道问题上:花钱买算力的公司,能不能把钱赚回来? 芯片卖出去,是上游的收入,也是下游的投入。如果模型公司长期收不回成本,继续加购算力就会越来越难。 AI 公司早期的处境可以用一个很直白的例子来理解:生产一件成本 1 美元的商品,却只能卖 0.2 美元。为什么还要做?因为它们在押注两个变化——生产成本会往下走,模型能力会往上走,用户愿意付的钱也跟着往上走。 第二个变化已经能看到形状。早期的 AI 只是帮你回答问题、补全几行代码;随着 agent 的发展,它开始尝试完成一整件事:开发网站、处理客服问题、预订酒店。回答“网站怎么做”和真正交付一个网站,对用户的价值完全不同。后者会消耗更多 token,但也更有机会让用户掏钱。 那么,未来的收入撑得起眼前这么庞大的投入吗?真正更有说服力的证据,出现在 Anthropic 身上——模型能力突破一个零界线,带来了爆发式的收入增长。神话级别模型 Mythos 在 BSD 系统中找到了一个漏洞,虽然这套代码已经被无数工程师和企业反复使用、检查多年,AI 却仍然挖出了此前被遗漏的问题。当模型能干成这种有实际价值的活,企业为它付钱就有了明确的理由。 Anthropic 的收入连续几个月快速增长:一月新增年化收入约 35 亿美元,二月约 80 亿美元,到三月,仅这一个月新增的年化收入就约为 105 亿美元——相当于 Databricks 和 Palantir 两家公司全年收入的总和。 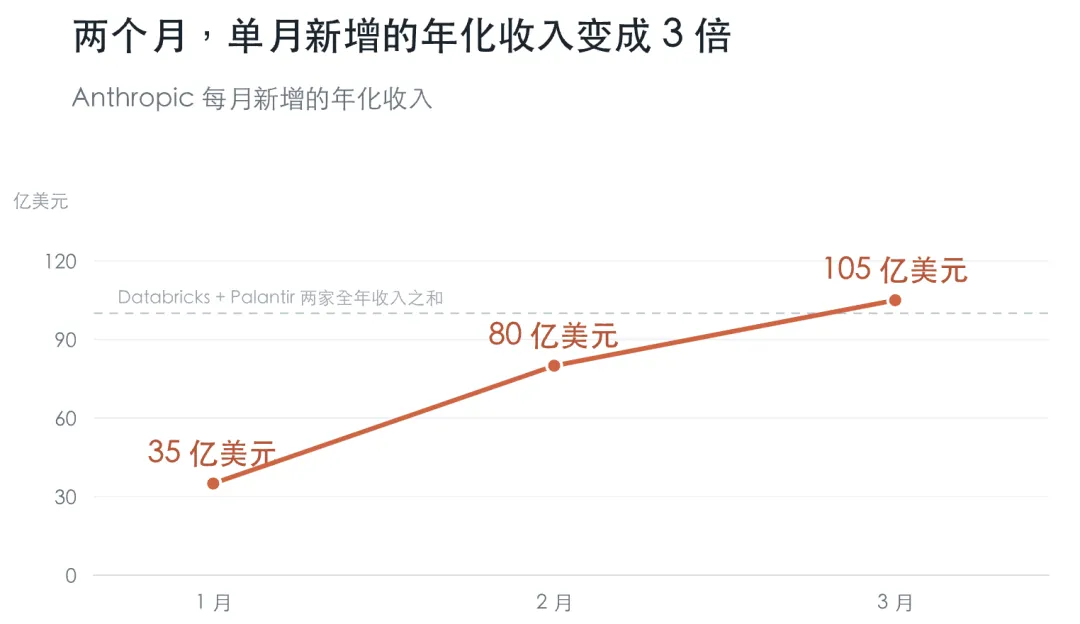
而这条曲线不是靠销售堆出来的。支撑这些数字的,是 Claude Code、Cowork 这些已经被客户用起来的产品。企业愿意加预算,是因为 AI 真的开始参与工作、改善业务、产出价值。 成本决定生产这些能力要花多少钱,实际完成的工作则决定用户愿意付多少钱。 市场足够大,并不意味着一家企业能一直拿走大头。如果 NVIDIA 赚走太多利润,整个生态还撑得住吗?竞争会不会迫使它降价? 当然,竞争是真实存在的。Google 的 TPU、Amazon 的 Trainium,以及其他专用芯片都在往前跑。NVIDIA 必须持续拿出客户愿意多付钱的产品,否则就只能降价、接受更低的利润率。值得注意的是,多家芯片企业同时发展、而 NVIDIA 仍在增长,这本身就说明智能市场可能比人们想象的更大。 而且这个市场还有许多尚未被完全算进来的空间:例如教育和医疗。过去只有少数人负担得起的个性化辅导和家庭医生服务,有机会随着智能成本下降,向更多人开放。 这恰好回到了开头那条生产率曲线:对用户,是更多服务变得可以负担;对提供服务的公司,是更大的市场;对芯片企业,则是更多等着被完成的计算任务。
为什么科技公司愿意为 AI 投入如此多的钱?
一、模型训练完了,为什么还需要这么多芯片?
二、GPU 之外的芯片,等到了机会
三、竞争与合作
四、为什么效率提高了,算力还是不够?
五、上游的订单,最终要靠下游的生意支撑
六、4.5 万亿美元的 NVIDIA,还有多大空间?
相关资料来源:Stanford《AI & E 435》课程讲座