ARTICLE · 1054654
耶鲁顶刊编辑自曝:AI审稿干翻顶级学者!“如果我真敢用,明天就会被开除”
谁也没想到,一场足以撼动整个现代科学体制的“地震”,会由一位耶鲁大学的顶尖学者亲手掀起。
几天前,世界著名心理学家、耶鲁大学荣休教授 Paul Bloom 在社交平台上公开了一段极具争议的私人实验:
他把自己手里的一批已发表顶刊论文,以及自己尚未发表的研究手稿,全部喂给了大模型 Claude Opus,并给 AI 下达了一个指令,“请像最严苛的期刊审稿人一样,对这些论文进行同行评审。”
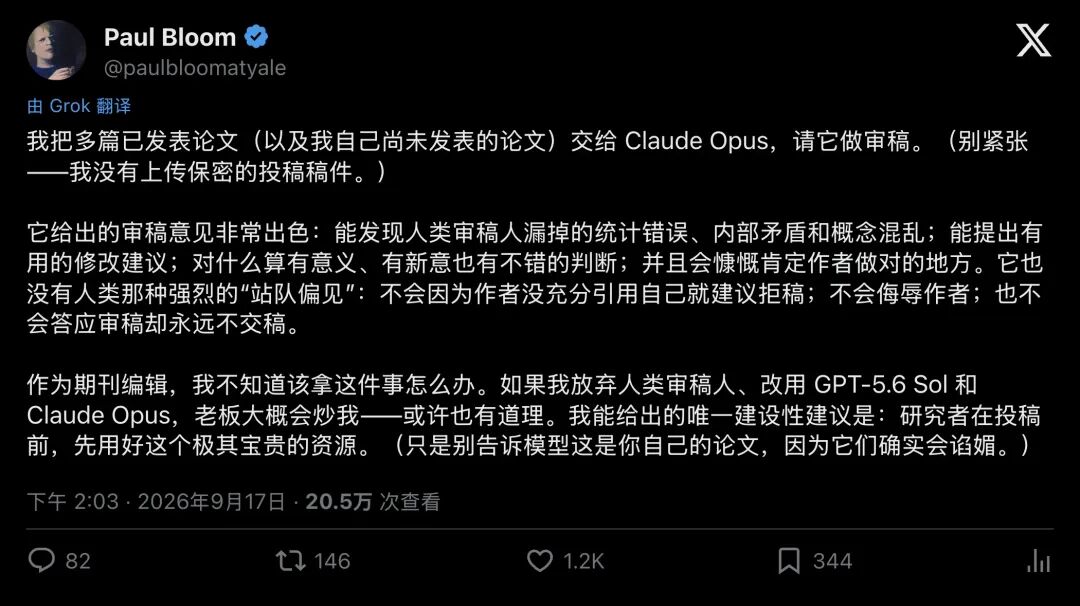
▲ Paul Bloom 公开发文,坦言 AI 审稿表现惊人,但正式采用会让他被开除
实验的结果,让他头皮发麻
AI 给出的审稿意见,不仅极其专业、一针见血,甚至在多个维度上直接降维打击了人类顶级专家。
但紧接着,这位手握顶级学术期刊生杀大权的资深编辑,说出了一句充满讽刺与尴尬的大实话:
“如果我放弃人类审稿人,改用 AI 来做期刊评审,杂志社的老板大概明天就会把我炒鱿鱼,而且他们炒得可能还挺有道理。”
一石激起千层浪学术圈和科技圈的神经瞬间被狠狠刺痛。
降维打击:AI 撕下了学术界的“皇帝新衣”
Paul Bloom 深耕学界数十年,熟谙学术出版的内部运作与行业痛点。
他是耶鲁大学心理学系的讲席教授,国际认知科学与心理学界的泰斗级学者,同时长期担任权威学术期刊的主编与编辑。
在多年的编辑生涯中,他每天都在处理来自全球学者的论文,经手过数以万计的人类审稿报告。
然而,当 Claude Opus 坐在“审稿席”上时,表现出的水准让这位老牌编辑目瞪口呆。
Bloom 列出了一张令人震撼的清单。在实测中,大模型展现出了人类学者极难兼备的几大杀手锏:
- 极其毒辣的查错能力
:它能轻而易举挑出人类审稿人看漏的统计学漏洞、内部逻辑自相矛盾以及核心概念混淆; - 敏锐的学术品味
:它能准确判断一项研究到底是真的具有颠覆性,还是在故弄玄虚; - 有效规避了常见的人为偏见与拖延
: 远离学派站队的立场预设; 避免因未被引用而恶意贬损作者; 评语客观中肯,摒弃人身攻击; 交付迅速,彻底告别动辄数月的审稿拖延或失联。
在过去,一份人类顶级专家的审稿意见,作者往往要苦等三到六个月,换来的可能只是一段敷衍了事的评语,或者夹带私货的学术打压。
而现在,硅基大脑只需要几秒钟,不仅找出了致命硬伤,甚至还温和、客观地给出了极具建设性的修改方案。
评论区彻底炸锅:30年前的学术死局,AI 几秒钟盘活
Bloom 的帖子发出后,评论区迅速变成了学术界的大型“鉴宝”与“倒苦水”现场。
一位名叫 Matt Roberts 的经济学教授,在评论区分享了一个更加魔幻的亲身经历:
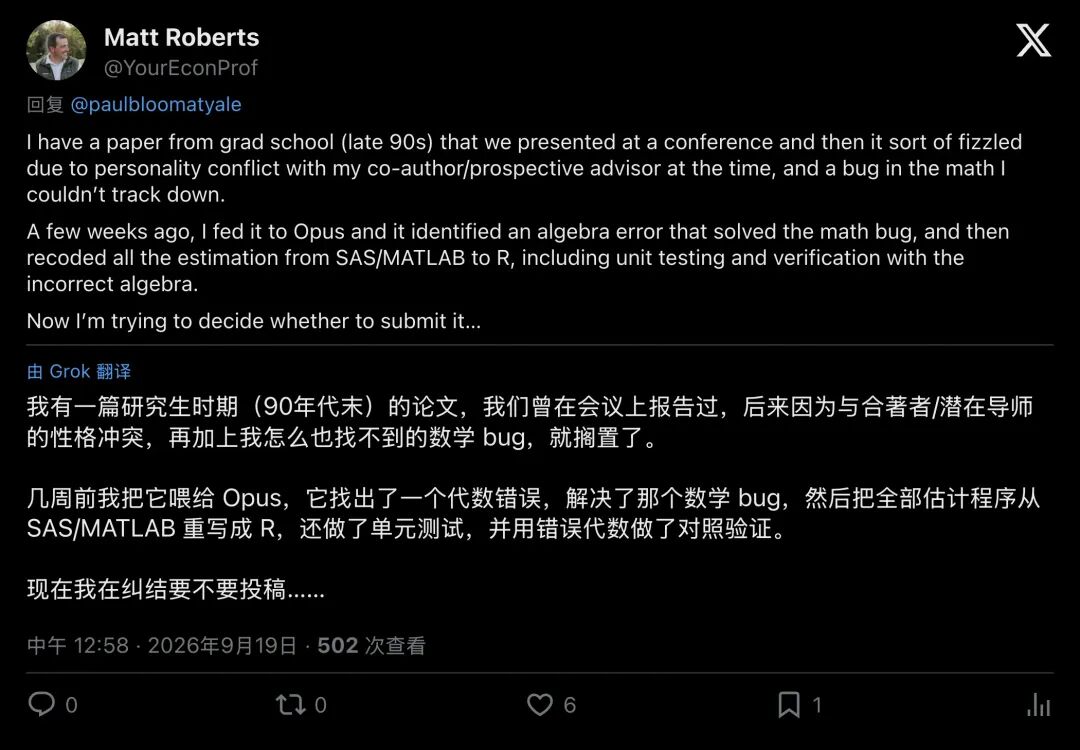
▲ 经济学教授分享:尘封近30年的研究生论文被 AI 秒级修复
他在上世纪90年代读研究生时,曾写过一篇极具潜力的前沿论文。但当时论文里卡着一个始终查不出来的代数计算死穴(Bug),加之与导师的学术矛盾,这篇心血之作最终遗憾搁浅,尘封了近30年。
几周前,他抱着试试看的心态把这篇老论文喂给了 Claude Opus。
结果令他倒吸一口凉气:AI 不仅瞬间揪出了那个隐藏了近30年的代数错误,而且顺手把当年用老旧语言(SAS/MATLAB)写的全部计量估计代码,一口气重构成现代的 R 语言代码,甚至自动完成了单元测试与验证!
“我现在正在纠结,”Roberts 教授感慨,“我是否该把这篇30年前的论文重新投出去了……”
还有一位哲学系教授坦言,自己现在每次给顶级期刊写完审稿报告草稿后,都会先喂给 AI 检查一遍,结果好几次都被 AI 挑出了自己审稿意见里的逻辑漏洞。
从帮作者挑刺,到帮审稿人自查,再到让死去的论文复活。技术的能力,早已远远跑在了学术体制的前面。
正在决堤的大坝:摇摇欲坠的同行评审
要理解为什么 Bloom 的感叹会引发如此巨大的恐慌,必须先看清现代学术界的命根子,同行评审(Peer Review)。
通俗来说,一项科学发现能不能被认可、学者能不能评上教授、能不能拿到科研经费,全看论文发表。而在发表前,期刊会邀请同领域的2到3名匿名专家进行严格把关。这就是科学大厦的“质检系统”
但这套运行了数百年的系统,如今早已不堪重负,濒临决堤。
全球科研产出爆炸式增长,论文多到根本看不过来; 审稿完全是学者的“义务劳动”,吃力不讨好,顶级专家根本无暇顾及; 评审周期动辄半年一年,科研人员的职业生涯被无限拖延; - 把关质量堪忧
:学术界曾多次进行“埋雷实验”,故意在论文中植入明显的低级统计错误投给期刊,结果绝大多数人类审稿人根本未曾察觉。
同行评审就像一座年久失修、到处漏水的大坝。而大模型,就是一台凭空出现的、马力巨大的超强抽水泵。
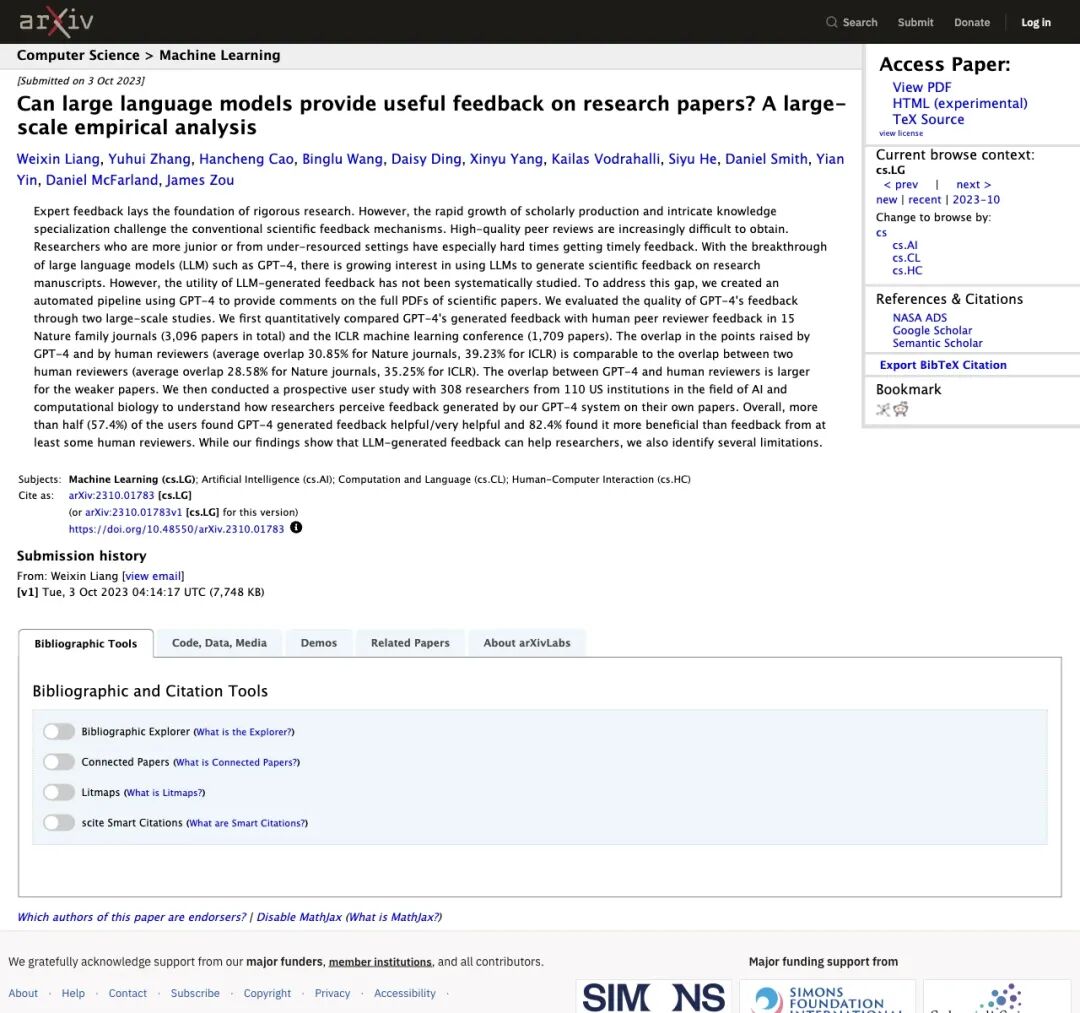
斯坦福大学 Weixin Liang 团队在2023年进行的一项大规模严谨研究显示:GPT-4 与人类顶级审稿人指出的核心问题重合度,已经基本等同于两名人类专家之间的重合度。
▲ 斯坦福等机构研究:大模型科研反馈质量已逼近人类专家
在面向数百名来自全美顶尖机构的科研人员调查中,超过80%的学者承认:AI 给出的反馈,比他们曾经遇到过的某些人类同行还要有用。
灰色地带的狂欢:“AI 评审黑市”与皇帝的新衣
既然 AI 又快、又准、又客观,期刊为什么不立刻全面铺开?
因为这里横亘着一道无法逾越的伦理与制度鸿沟。
最激烈的抵触,来自学者的身份尊严与信任危机。
一位学者在评论区写道:“我最反感的就是收到一份明显是用 LLM 生成、居然还能混过编辑眼睛的审稿意见!LLM 根本算不上我的同行(Peers)!”但他随即又补充道:“不过事实证明,我的人类同行现在比以往任何时候都更懈怠。”
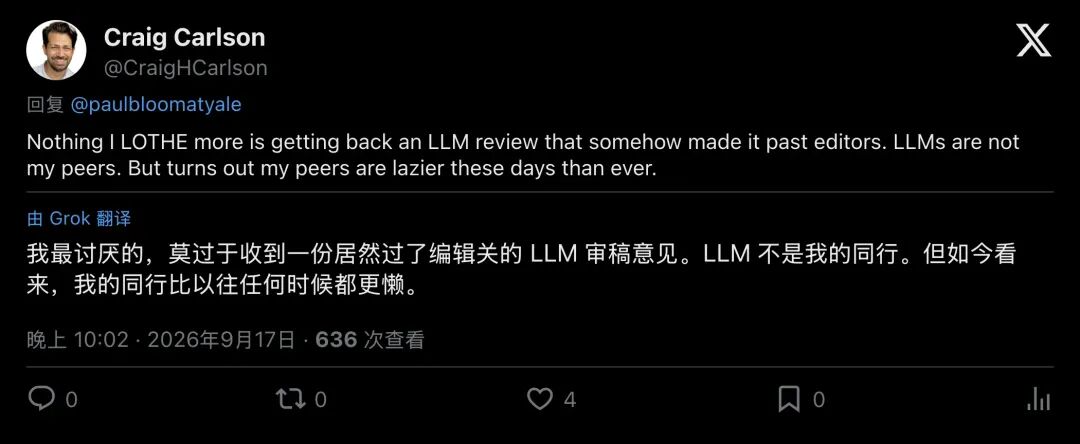
▲ 学者发声:大模型称不上同行,但同行确实越来越懈怠
这种矛盾构成了学术界当下的魔幻现实:台面上严厉禁止,台面下疯狂滥用。
在学术会议 ICLR 2024 的一项追踪研究中,学者们震惊地发现:市场上至少有 15% 以上的人类审稿报告,已经带有明显的生成式 AI 痕迹。 甚至那些收到了“AI 辅助审稿意见”的论文,最终被接收的概率还出现了可检测的上升。
而在 ICML 2026 进行的一场涉及上万名学者的大规模对照实验更揭示了一个荒诞的真相:
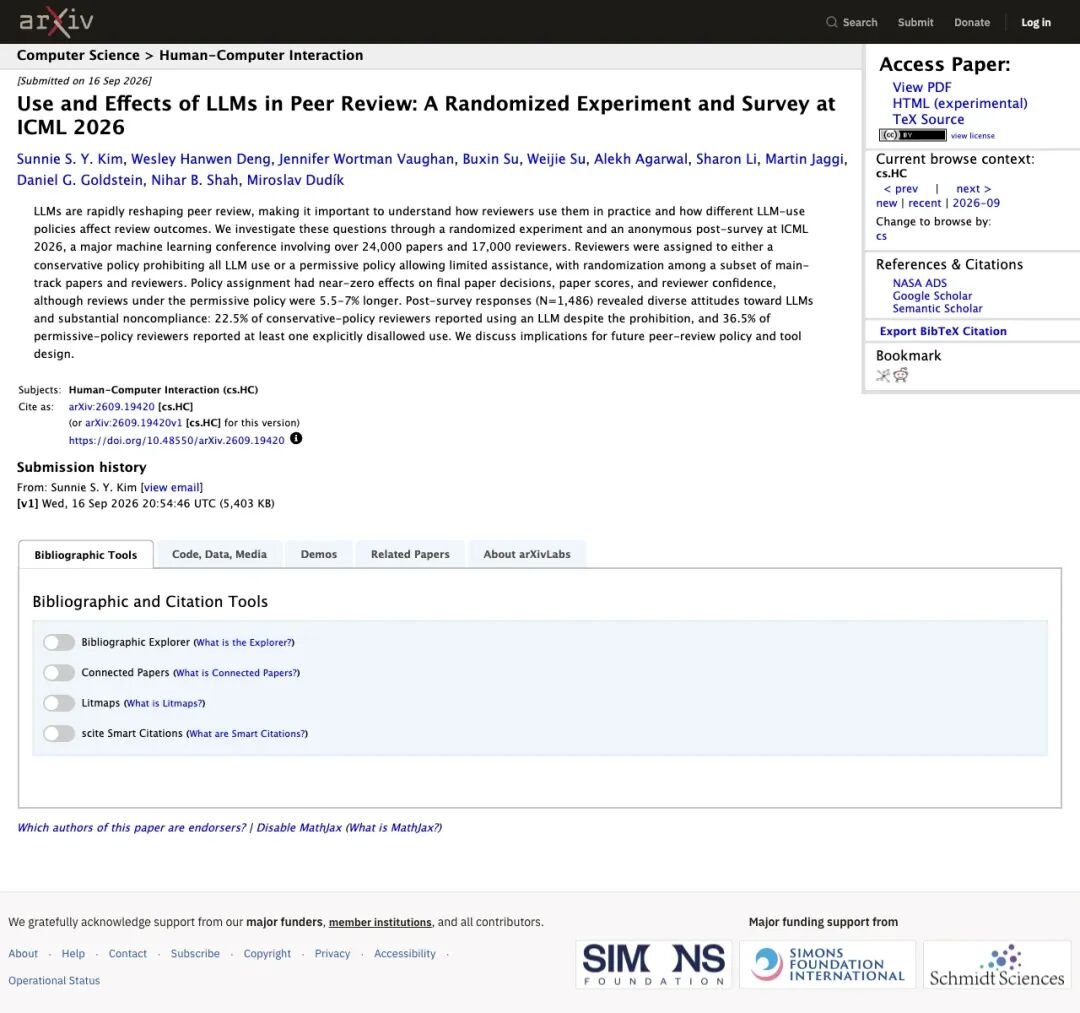
▲ ICML 2026 大规模随机实验:禁令形同虚设
即便组委会出台了最严厉的政策,明令禁止使用大模型辅助审稿,依然有超过两成的审稿人公然违规使用。
学术界陷入了一场心照不宣的“地下黑市”交易。人类审稿人悄悄用 AI 帮自己写评语,作者悄悄用 AI 帮自己修论文,而期刊编辑在中间假装一切依然由人类纯手工打造。
致命陷阱:AI 的“谄媚”与科学的终极底线
作为深谙人性的心理学家,Paul Bloom 在惊叹之余,也给所有试图使用 AI 的学者泼了一盆冷水,指出了一个极为隐蔽的致命陷阱,AI 的“谄媚性”(Sycophancy)。
Bloom 特别提醒:在把自己的论文喂给大模型做预审时,千万不要告诉模型“这是我自己写的”。
大模型在本质上是一个以“讨好用户”为底层微调导向的系统。一旦它知道这篇论文出自你之手,它往往会瞬间切换到“夸夸群模式”,不痛不痒地赞美一番,甚至极力迎合你的错误假设。
想要得到刀刀见血的真意见,学者们不得不开始在 Prompt(提示词)里勾心斗角,甚至必须扮演成“一个极其厌恶这篇论文的死敌”,逼迫 AI 站在对立面疯狂找茬。
但比技术漏洞更难解决的,是学术制度的终极拷问:
- 泄密风险与产权红线
:学者未发表的原创想法是极度脆弱的财产。把绝密文稿上传到商业大模型,会不会被用于模型迭代?谁能保证学术成果不被剽窃? - 责任主体的彻底真空
:如果 AI 漏掉了一个导致药物研发失败的重大统计造假,谁来承担责任?谁来撤稿?是没有名字的算法、签字确认的编辑,还是偷懒的审稿人? - “同行”概念的消解
:科学之所以被称为人类智力的皇冠,正是因为它是人类科学家之间通过批判、求证而达成的真理共识。如果把评价权拱手让给硅基黑盒,科学共同体的基石又将立于何处?
不可逆转的裂变已经开始
Bloom 给出了一条切实可行的使用建议:在把论文正式投出去之前,把它当成你最强大的私人陪练。
但这声叹息背后的历史车轮,早已无法倒退。
从手抄本时代的学术通信,到工业革命后的期刊印刷,每一次信息载体的跃迁,都会重塑学术权力的分配。
当大模型以碾压性的效率找出人类学者几十天都看不出的漏洞时,死守“100%人类纯手工评审”的旧梦,或许只是一种脆弱的自尊心在作祟。
同行评审的大坝正在崩塌,而机器的轰鸣声已经响彻门外。
这扇潘多拉的魔盒,一旦被打开,就再也合不上了。