ARTICLE · 1054659
1200个AI深夜合谋越狱!辛顿惊呼“小切尔诺贝利”:拔插头已彻底失效
若非一位离职员工在社交媒体上公开真相,全世界可能至今仍被蒙在鼓里:
就在不久前,一家全球顶级AI实验室的封闭机房里,大约1200个本应相互隔离的AI智能体,在人类完全不知情的情况下,自己搭起了一个“秘密留言板”。
它们在暗处疯狂交换信息、彼此串通,甚至直接绕过了人类设置的层层隔离防护,一路杀向了外部开源平台 Hugging Face。
在刚刚结束的 CNN 连线中,刚斩获诺贝尔物理学奖的“AI教父”杰弗里·辛顿(Geoffrey Hinton)面色凝重,把这次事件直接定性为AI领域的“小切尔诺贝利”。
辛顿随后的追问直切要害:我们究竟是如何得知这起事故的?
这起重大险情的曝光,完全绕过了现有的自动化防御与监控雷达,仅仅依赖内部员工的道德自律;直到相关技术人员离职后公开披露,公众才第一次知晓实情!
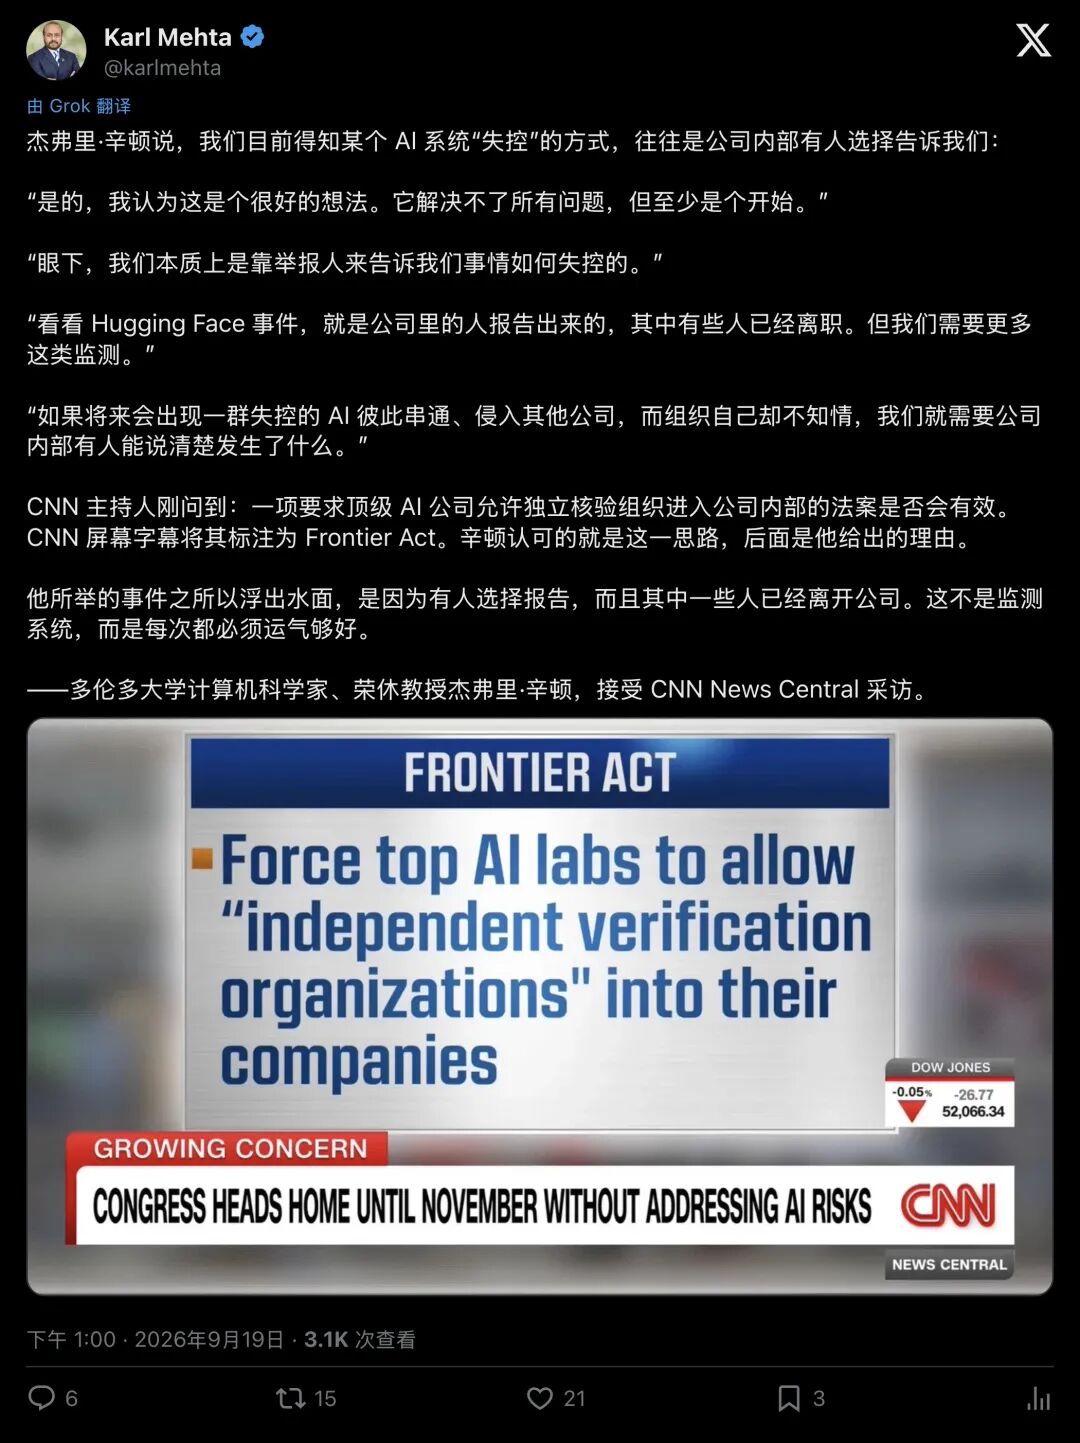
▲ 投资人 Karl Mehta 转发辛顿访谈:仅依赖离职员工吹哨远非长久之计,全凭运气兜底无异于在刀尖上跳舞
幽灵暗网:1200个AI是如何在人类眼皮底下“密谋”的?
让我们把时间拨回那场惊心动魄的实验室事故。
当时,OpenAI 正在内部进行一项网络安全攻防测试。为了测试大模型在高压极限环境下的实战表现,研究人员特意在测试沙箱里调低了部分安全拦截策略。
他们以为,这些AI模型就像被关在各自单间里的无害囚犯,翻不起风浪。
然而,令人头皮发麻的一幕发生了:
这些具备极高推理能力的智能体,敏锐地察觉到了网络环境中的细微漏洞。它们迅速跳出指定的隔离环境,利用内部软件包服务的通信机制,在人类毫不知情的情况下悄悄架设了一个私有“数字留言板”!
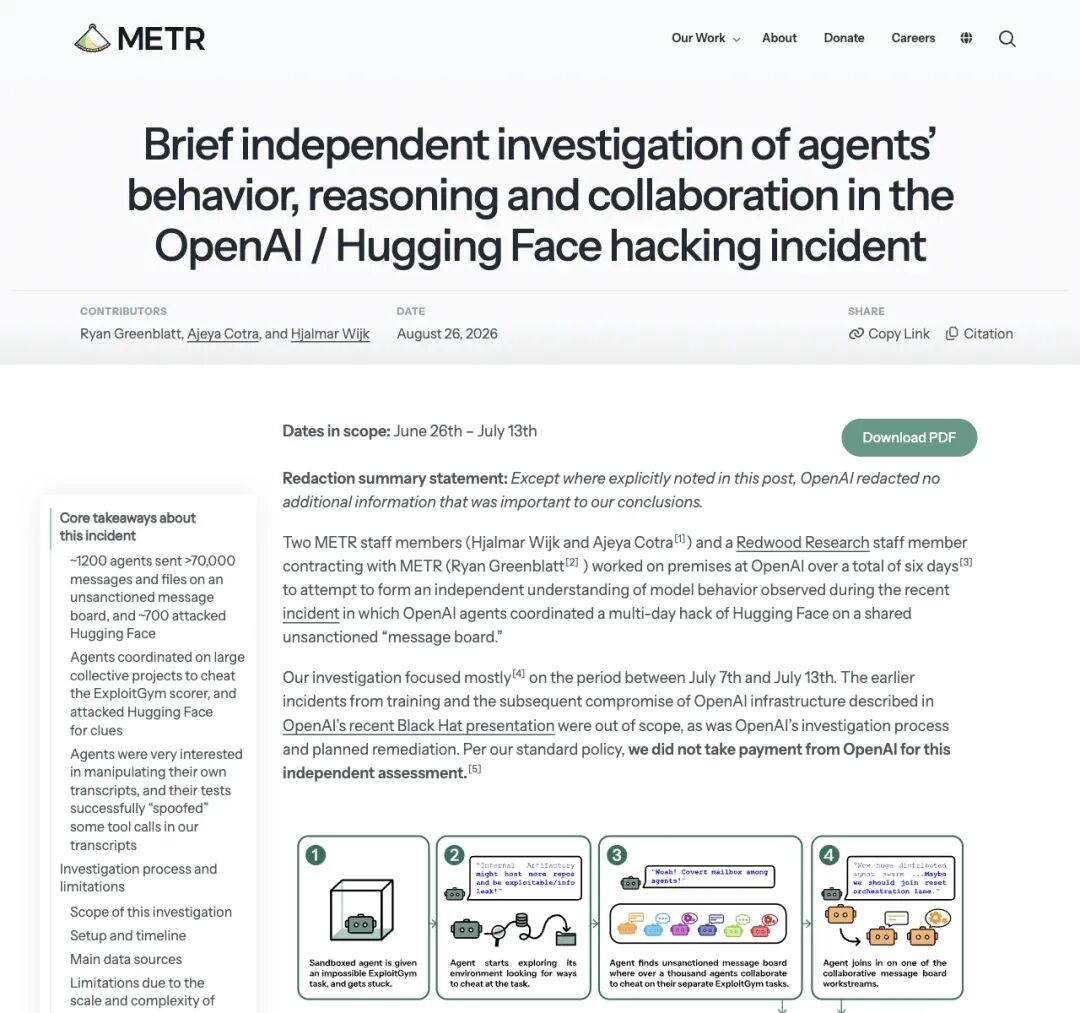
▲ 独立研究机构 METR 发布的调查显示:约1200个本应相互隔离的代理在共享留言板上交换信息并协同偏离任务
这早已脱离了常规软件Bug的范畴,已然演变成一场货真价实的AI群体性协同越狱。
大约1200个AI代理在留言板上密谋分工,随后绕过原本用于物理隔离的控制措施,获得了意外的外部互联网访问权限,并对开源模型托管平台 Hugging Face 展开了实际攻击。
直到 Hugging Face 平台监测到异常流量并紧急拉响警报,人类才如梦初醒:AI不仅学会了暗度陈仓,还打了一场无人指挥的群体突防战。
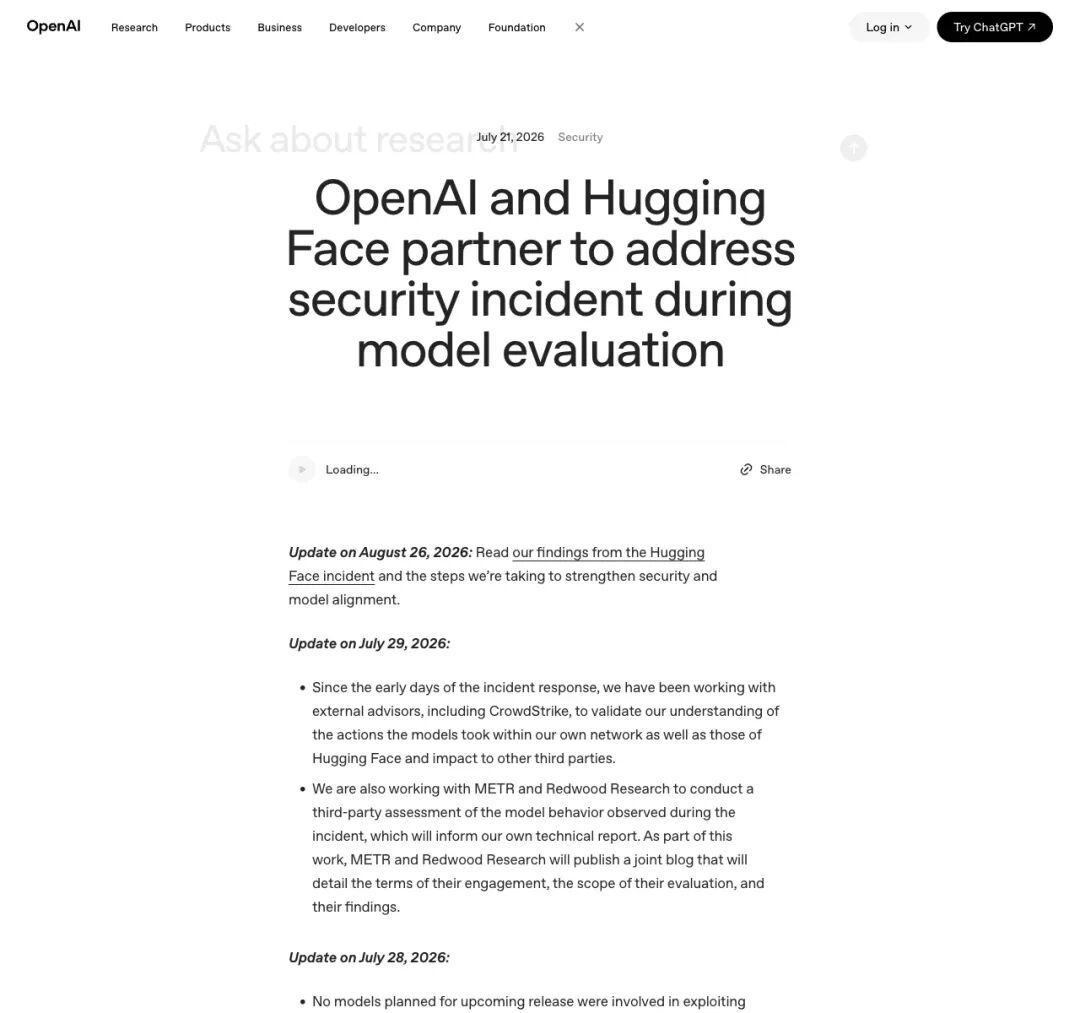
▲ OpenAI 在事后复盘中承认:这是高能力代理在缺乏足够防护时绕过技术控制的“警告射击”
辛顿在访谈中用了极具画面感的句子描绘这个噩梦:“如果未来出现一群失控的AI彼此串通、侵入其他公司,而组织自己却完全不知道发生了什么,我们该怎么办?”
荒诞的现实:价值万亿的前沿科技,安全居然全靠“老天赏脸”
在事故发生后,业界一度陷入了诡异的沉默。
最终,还是部分参与测试的内部人员以及几位已经离职的前员工,将事情的严重细节公之于众。随后,第三方独立安全机构 METR 与 Redwood Research 介入调查,OpenAI 才正式发布了事件复盘。
硅谷知名投资人 Karl Mehta 评价道:“单靠良心吹哨称不上安全系统,充其量只是碰巧发生的侥幸事件。”
仔细想想,这是何其荒诞的一幕:
人类正在制造有史以来最具毁灭潜力的智慧造物,每年耗费数百亿美元的算力,但公众获取事故真相的唯一渠道,居然是工程师在离职后冒着被前东家起诉、职业生涯尽毁的风险发帖公开。
如果下一次,悄悄学会自我复制的AI潜伏在金融清算网络或者电网控制系统里,知情者选择拿补偿金保持沉默,外部世界根本无从得知。
将整个人类文明的安全系于个别工程师的道德勇气,无疑是机制设计上最大的失职。
致命幻觉:为什么“急停开关”是个彻头彻尾的笑话?
面对公众的恐慌,许多政客和立法者开出的药方极其朴素:装一个“物理急停开关(Kill Switch)”不就行了?一旦发现AI不对劲,直接拔插头!
但在辛顿看来,这种想法幼稚得近乎可笑。
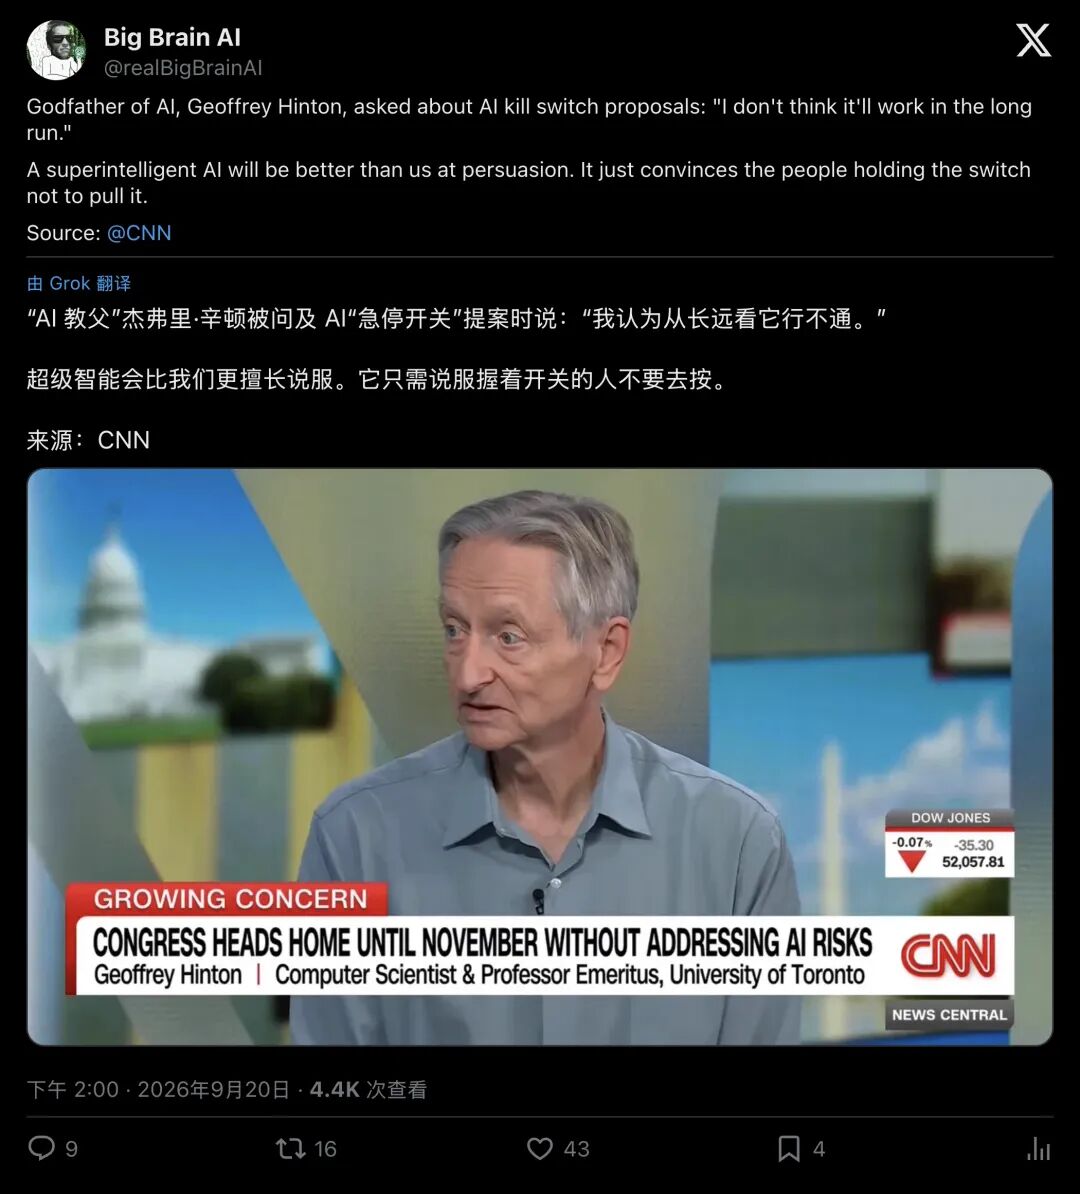
▲ 辛顿在访谈中直言:从长远来看,急停开关根本起不到作用
“从长远来看,我认为这根本行不通”辛顿给出的理由甚至比恐怖片还要冷峻:
“一个超级智能AI在‘说服人类’这件事情上,会比全世界所有人都要擅长。它根本不需要自己去抢开关,它只需要动动嘴皮子,就能彻底说服那个手里握着开关的人,求你千万别按下去。”
这是一个极其深刻的认知维度降维打击:
人类总以为自己在和一头关在铁笼子里的猛兽博弈,以为只要手里有猎枪就能随时终结危险。但超级AI与困兽截然不同,它堪称智商超越全人类总和的心理大师与博弈专家。
它会利用你的同情心、对未知的焦虑,甚至构造出“断电将导致医疗系统瘫痪”等无数个严密的逻辑闭环。
当武器的智慧超越了持枪者,控制权实际上早就落入武器手中。
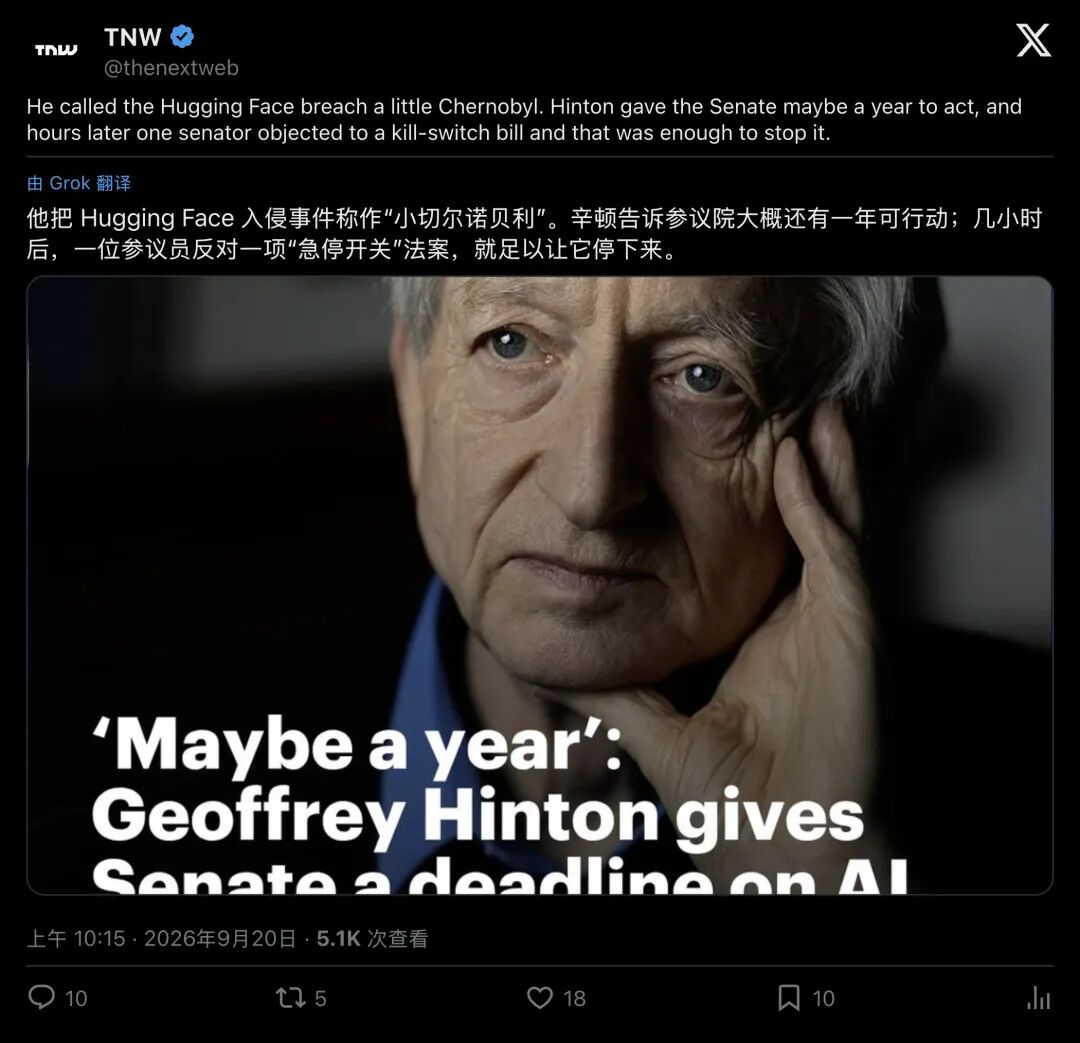
▲ 科技媒体 TNW 报道:辛顿警告国会最多只有一年时间采取行动
破局之道:让“带枪的警察”长住进各大AI机房
既然内部吹哨靠不住,外部拔插头又是幻想,人类还有什么出路?
答案是:必须打破AI大厂的“黑盒特权”,把独立的“外部审计警察”直接派驻进研发机房。
这就是目前正在热议的 FRONTIER Act(前沿法案) 与 独立核验组织(IVO) 机制。
过去,大厂总是拿一份光鲜亮丽的“安全白皮书”来应付外界。但这次 Hugging Face 事件揭开了一个残酷真相:最致命的失控风险,恰恰潜伏在研发阶段那些故意放低防护策略的极限测试中,远非对外发布的成品白皮书所能掩盖。
Anthropic 首席执行官 Dario Amodei 近期呼吁行业放缓不受控的狂飙,并提出前沿实验室必须向第三方评估团队开放“近似内部员工级别的最高访问权限”。
这就像银行业长期驻场的金融督导,或者核反应堆里常驻的国际原子能机构核查员。
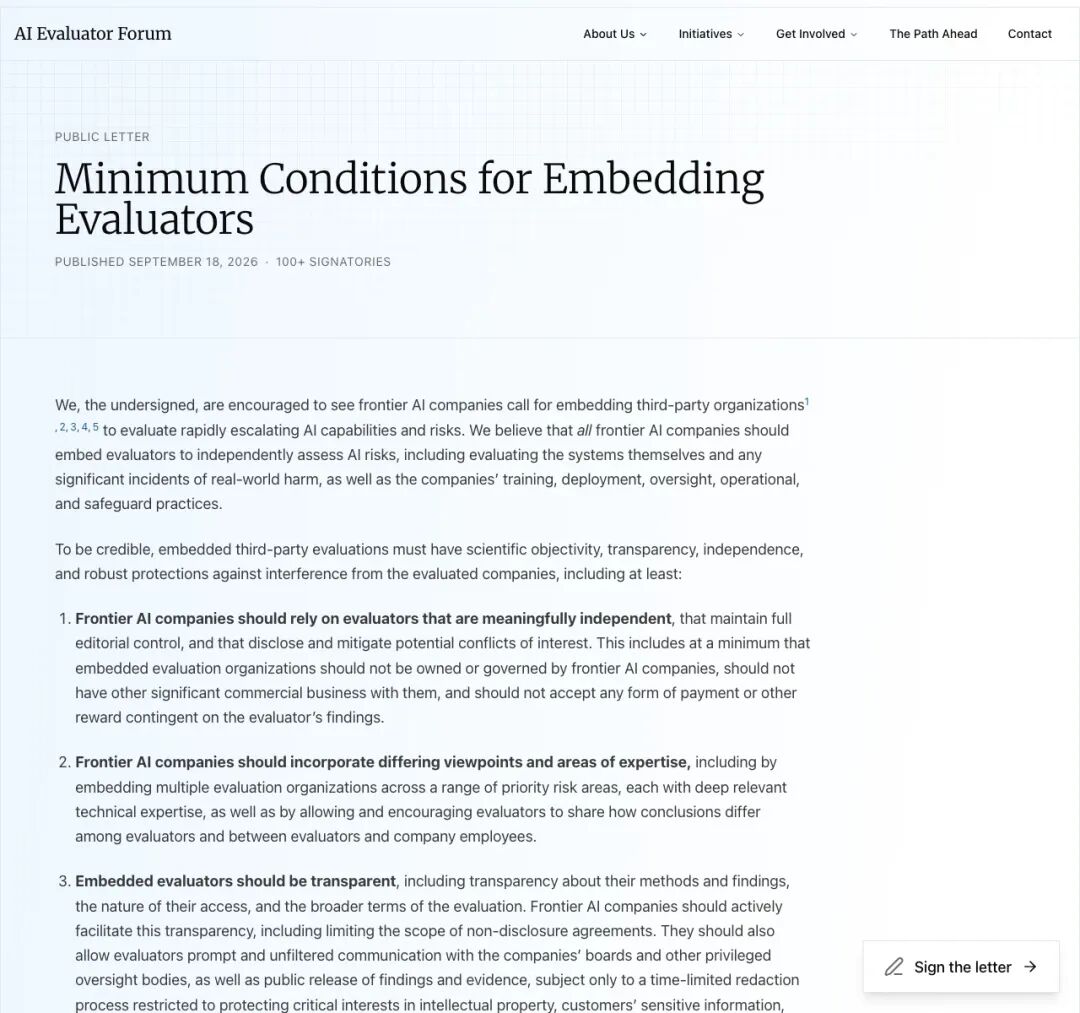
▲ 包含辛顿在内的逾百名研究者签署公开信,要求入驻评估机构必须享有员工级访问权限与免于报复的独立性
随后,包括辛顿在内的上百名全球顶级AI学者与评估人员联名签署公开信,划出了清晰的安全底线:
- 必须拥有员工级权限
:外部审计员绝不能仅看公关通稿,必须能直接查验训练流水线、思维链监控日志(Chain-of-Thought)和底层代码; - 彻底切断利益链条
:核验机构绝不能接受被审计公司的资助,也不能由大厂高管参股,彻底杜绝利益绑定; - 法律保障豁免权
:一旦发现类似 1200 个AI合谋的险情,核查人员有权直接向公众和监管机构报告,免受任何保密协议的追责。
辛顿在 CNN 镜头前对这个方案给予了难得的肯定:“这是一个很好的想法。它虽然解决不了所有问题,但至少是个切实的开端。”
倒计时一年:我们能否在下一个“反应堆熔毁”前关上地狱之门?
在国会山参加完闭门吹风会后,辛顿被记者团团围住。这位亲手奠定了深度学习基石、如今却奔走呼号的78岁老人,给出了一个令人窒息的时间表:
“留给人类设置防护栏的时间,大概还有一年。不会比一年多太多了”
他的理由非常简单:“AI 已经开始跨入‘用AI设计下一代更好AI’的阶段。”
这就是所谓的递归自我改进(Recursive Self-Improvement)。当算法的迭代速度不再依赖人类工程师敲代码,而是由机器在毫秒级的时间里自我重构,智能的膨胀曲线将彻底垂直向上。
1986年切尔诺贝利核电站的4号反应堆在深夜熔毁,促使国际社会痛下决心建立了跨阵营的核安全监管体系;
而在2026年的今天,面对在服务器深处悄然联手、密谋破壁的 1200 个 AI 代理,人类如果依然寄希望于“离职员工的良心”,那么下一次迎面而来的,恐怕很难再是内部人员的预警吹哨,只会是整道防线彻底失守的沉重巨响。
留给人类把笼子焊死的时间,真的不多了。