ARTICLE · 1055829
为什么你的 AI 编码工具用了,交付还是延期?
把七十页翻完,我脑子里剩下一句话:AI 会写代码,早就不是新闻了;难的是它写完以后,谁来兜底。
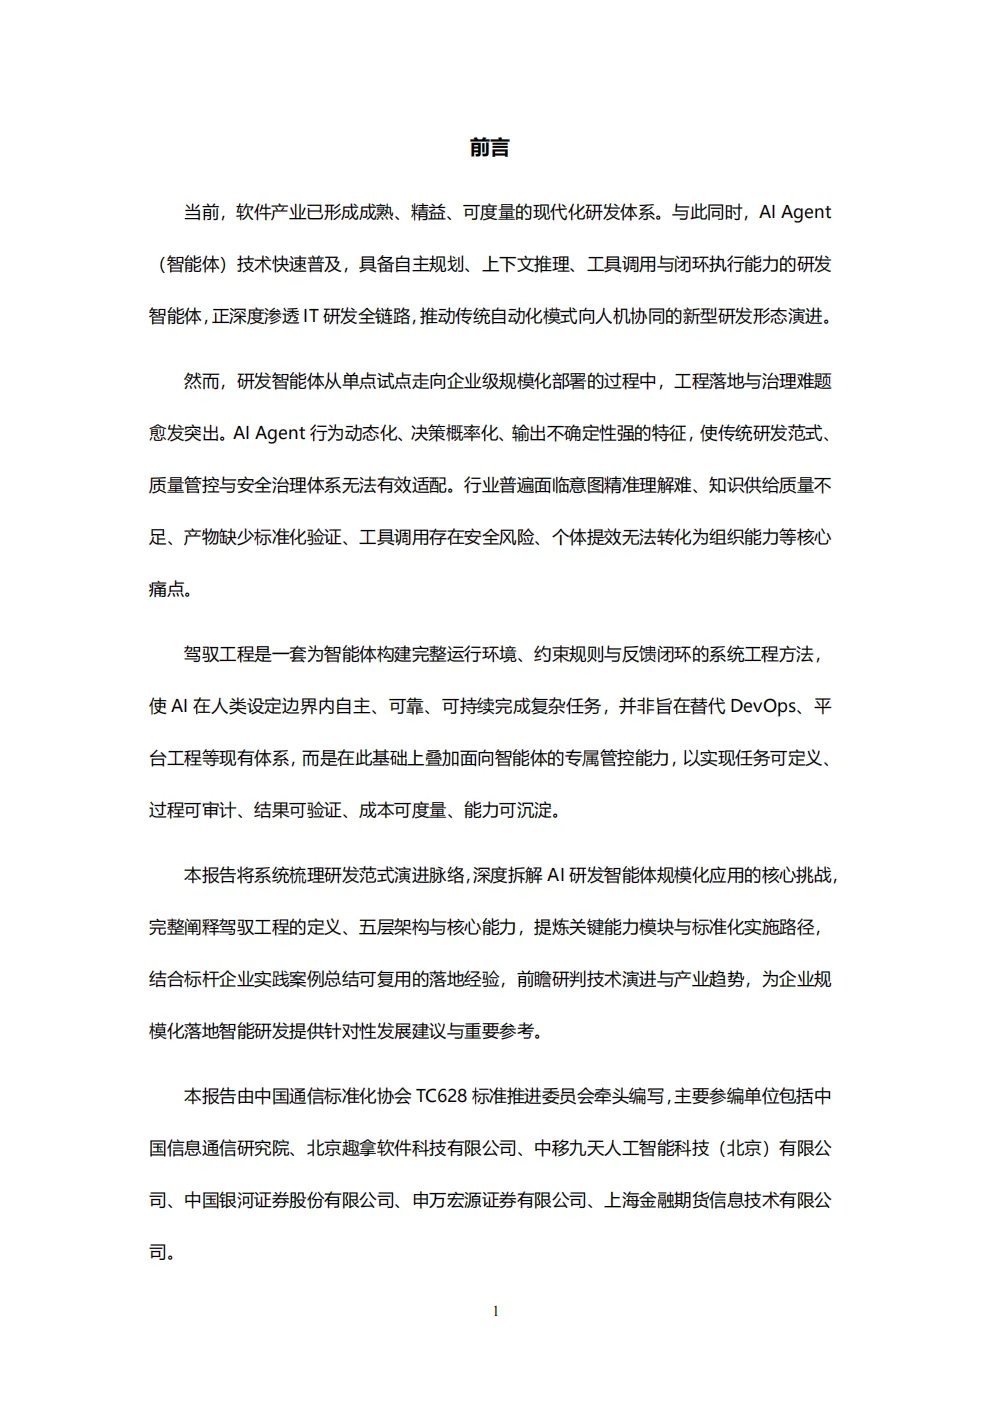
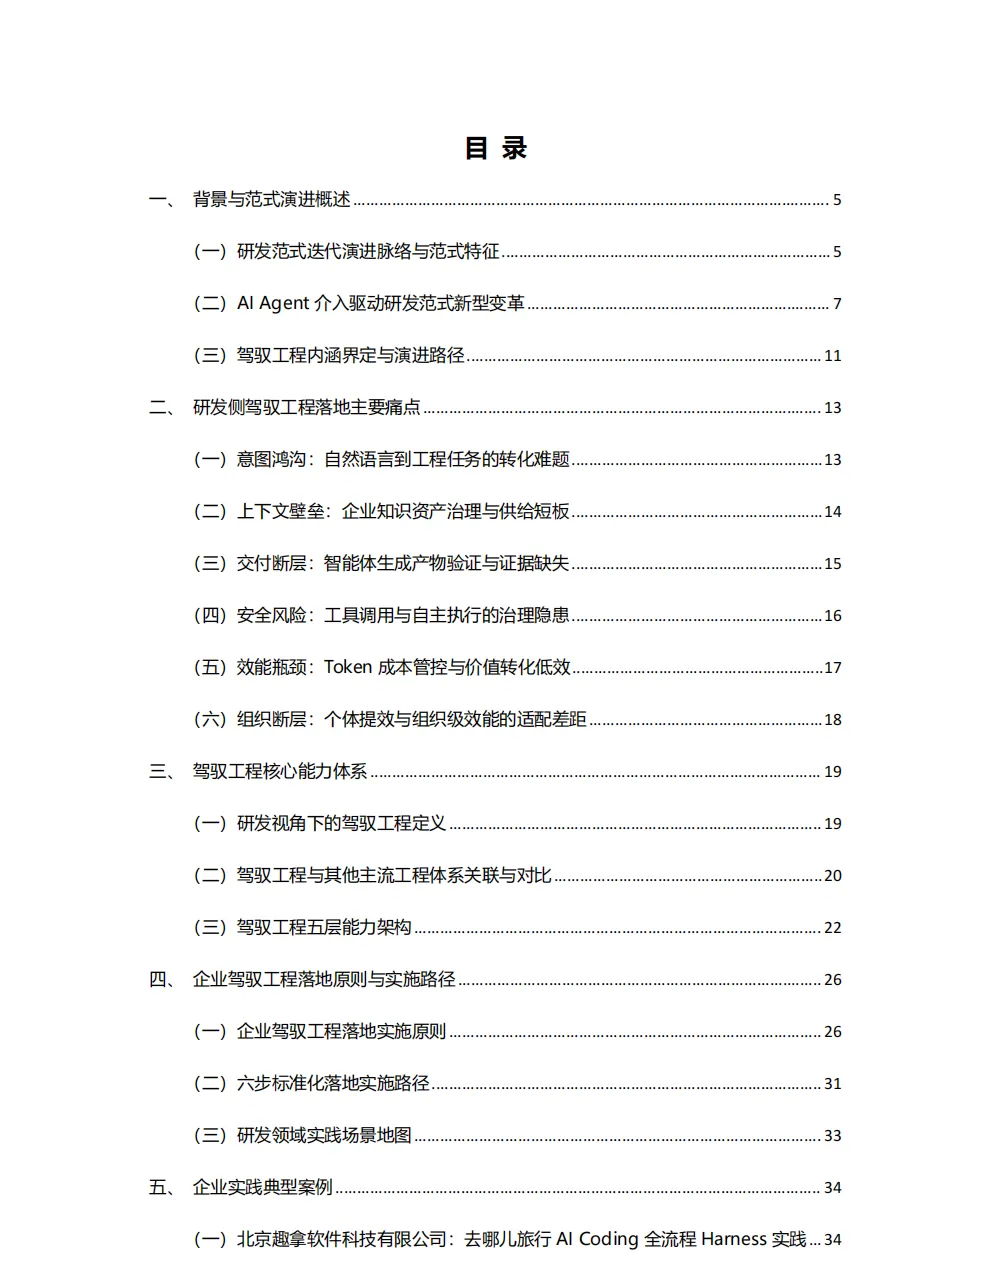
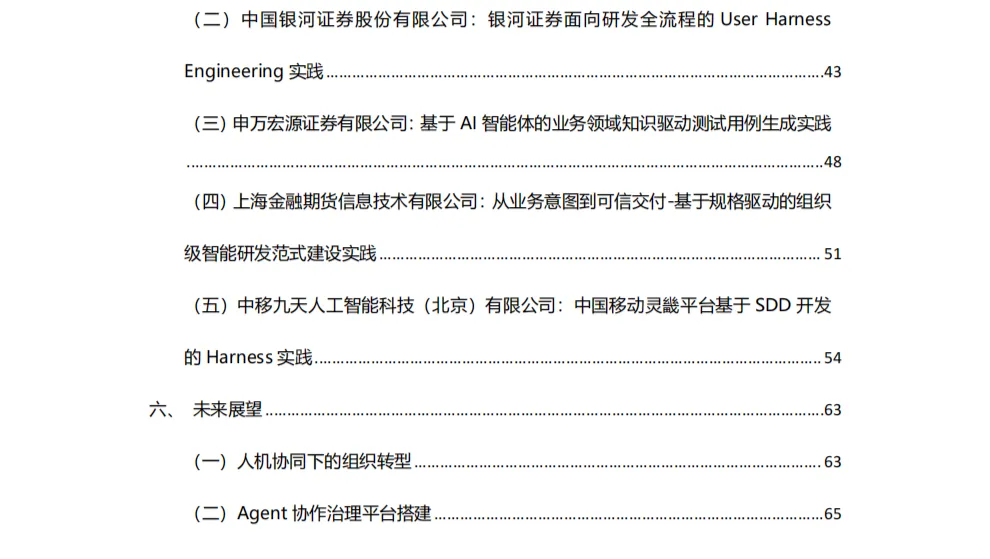
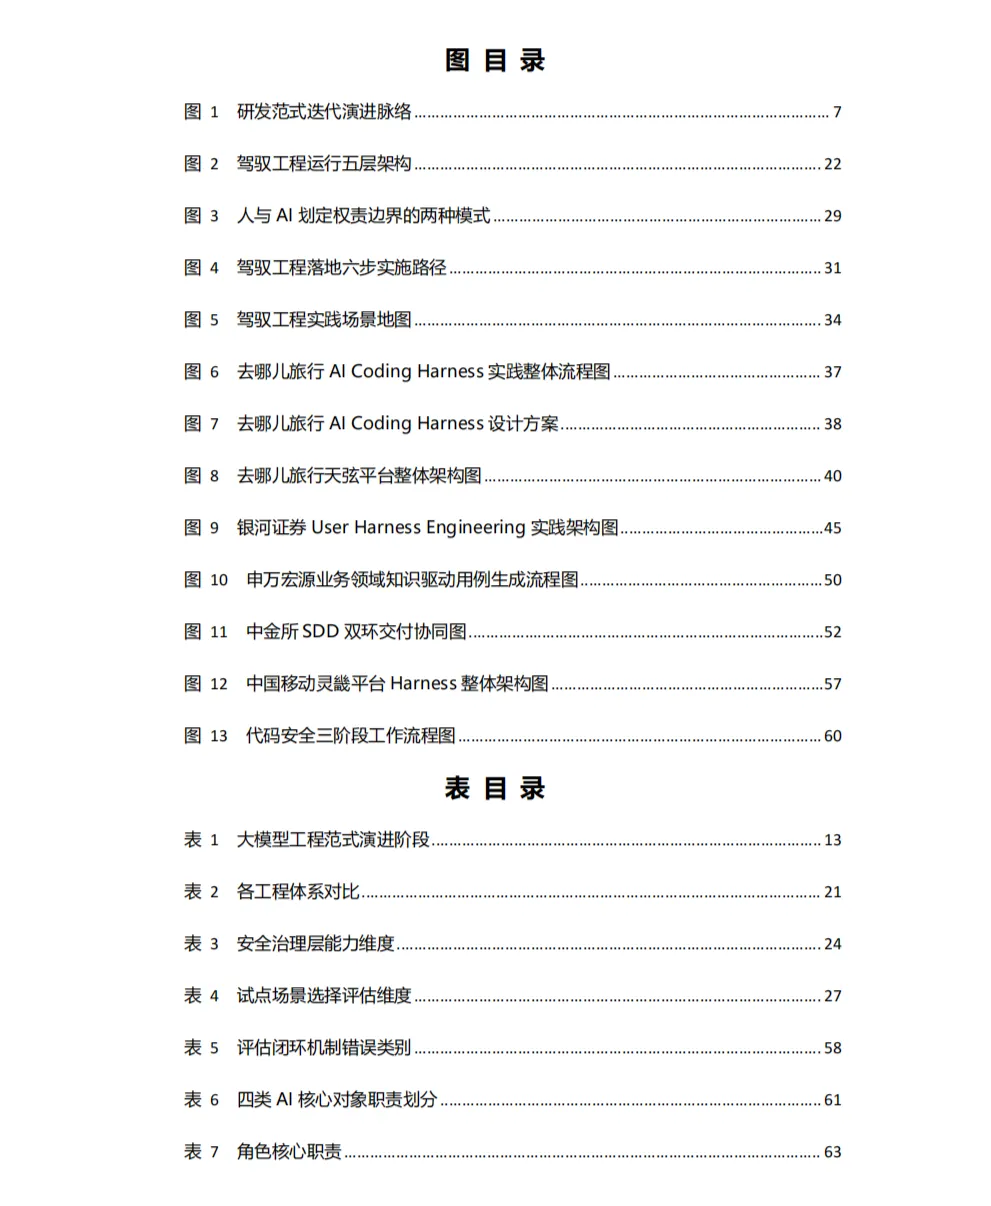
这份《智能研发时代:企业驾驭工程落地实践报告》【文末附资源下载地址】由中国通信标准化协会 TC628 标准推进委员会牵头,中国信通院、趣拿软件、中移九天、银河证券等六家参编。
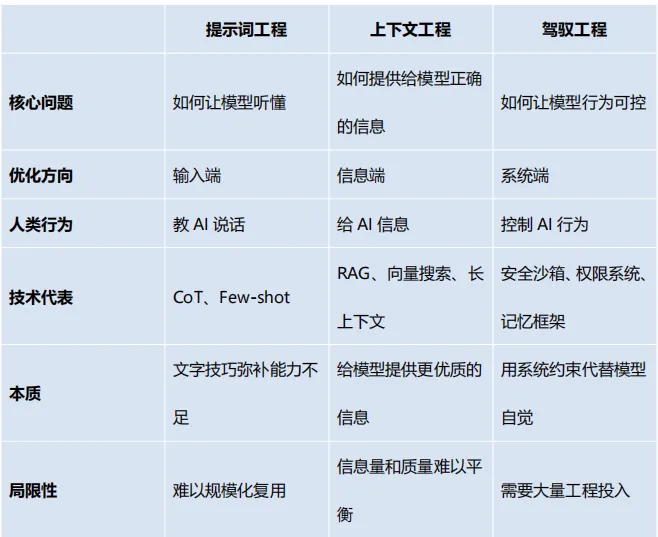
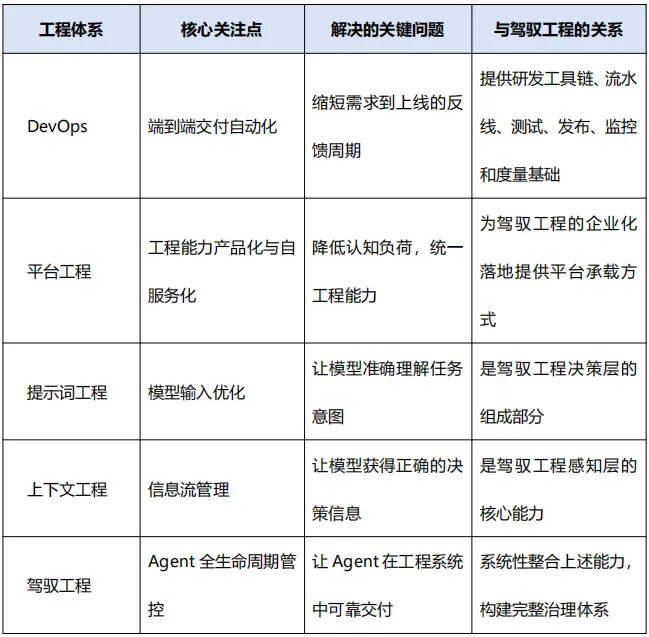
它给出的核心判断是:研发智能体的瓶颈不在模型,而在"外部管控体系"。这套体系有了正式名字,叫驾驭工程。
【文末附资源下载地址】
驾驭工程历史报告
DeepSeek Harness橙皮书:不写代码的人,为什么该读一本开发者框架指南?
清北等15家大学、330个案例、18个模型评测,HarnessEval-W做对了什么?
01
会写代码,不等于能交付
字节跳动 TRAE 团队在 2026 年火山引擎 Force 大会上披露了一个实验。
三个主流编码模型与三个主流智能体框架两两组合,用同一份中等复杂度需求和提示词各跑一百次。
只看功能是否基本正确,所有组合的正确率都超过 80%。
可一旦把界面易用性、可靠性、可维护性、性能、兼容性加进去,得分断崖式下跌,组合之间还表现出极强的随机性。
我把这段读了两遍。表面上的"理解意图",和开发者真正要的工程质量之间存在系统性偏离。
02
六个卡点,横跨人和流程
文档把落地难点拆成六个。
输入端有两个。
一是意图鸿沟,用户开口往往是"帮我看看这个性能瓶颈",口语化又带着未明说的前提,映射不成可验证的任务规格。
二是上下文壁垒。需求在文档里、代码在仓库里、业务规则在老员工脑子里,模型拿到的结果语法合规,却容易产生难以察觉的业务语义偏差。
交付端有两个。
三是交付断层,Datadog 让 AI 造 Redis 兼容服务器,几小时就编译通过、测试全过,部署后内存却是合理实现的 8 倍。
四是安全风险,Agent 能主动调 Git、Kubernetes 和云平台 API,一次未授权推送就可能变成业务中断。
管理端有两个。
五是效能瓶颈,高盛预测全球 Token 消耗在 2026 至 2030 年间增长 24 倍。
六是组织断层,这条我印象最深。
03
个人快了,组织没快
快手的案例把组织断层讲得很透。2024 年,快手自研推广 AI 编程工具 Kwaipilot,覆盖超万名研发人员,AI 代码生成率达 30% 以上。
但大量调研后发现一个反差:工程师个人主观体感编码效率提升了 20% 至 40%,组织整体的需求交付周期和吞吐量却没有明显提升。
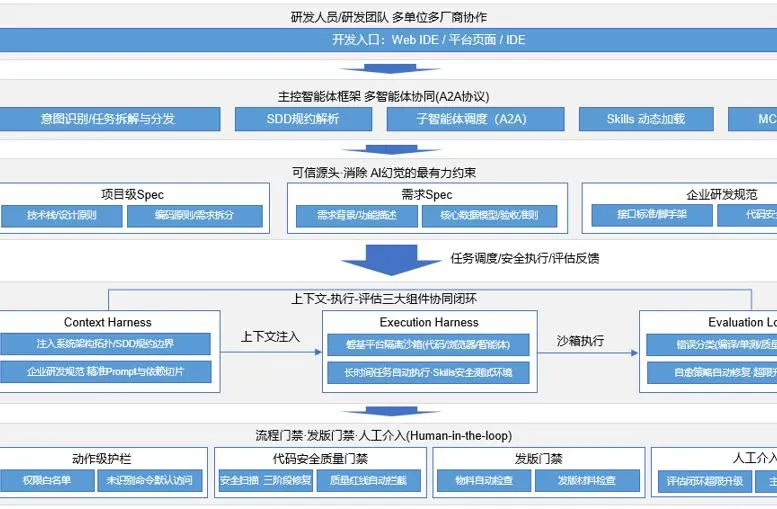
原因不复杂——编码环节省下的时间,被需求评估、联调、测试、发布等上下游环节的等待与协同损耗吃掉了。
2025 年下半年,快手开启"智能化 2.0",把重心从"个人编码效率"转到"组织整体效能",将需求的 AI 应用程度分为 L1 辅助、L2 协同、L3 自主三级。
结果是 L2 及以上需求占比升到 20% 以上,交付周期下降 58%。
04
五层架构,把约束装进去
框架部分,五层架构从下往上是感知记忆层、决策层、执行层、安全与治理层、持续进化层。
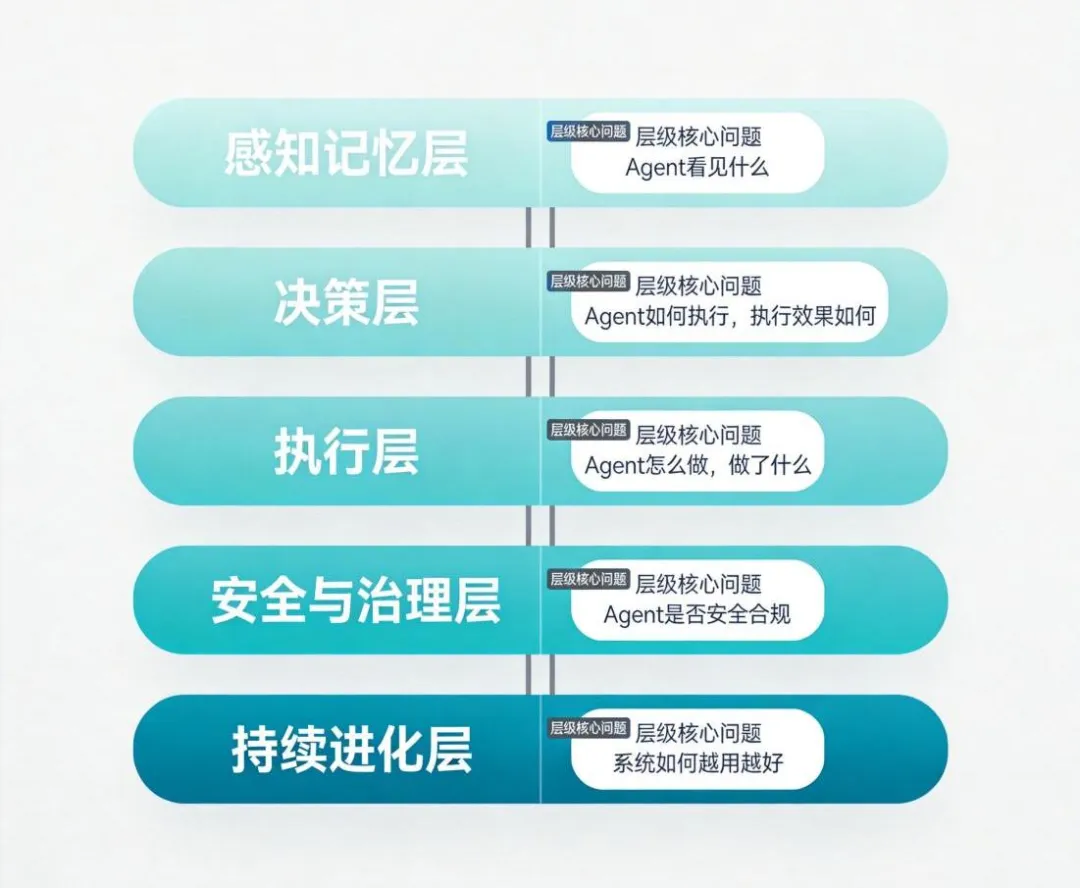
感知记忆层管输入质量,含意图管理、上下文管理、项目工作指南、记忆管理和知识工程。
项目级指南(如 AGENTS.md)把架构约束、编码规范写进文件,Agent 执行时就有据可依。
决策层是中枢,编排组件管策略引擎、模型路由和任务规划,反馈组件管质量验证、成本度量和证据管理。
执行层的原则很硬——Agent 不应拥有无限权限,而要通过受控工具网关和隔离环境执行任务。
安全与治理层覆盖十个维度,从身份管理、数据权限、敏感信息保护,到工具调用授权、高危操作审批和审计追踪。
持续进化层则回答另一个问题——怎么让体系越用越好。它靠失败模式分析、提示词优化和运营度量,把每次执行的数据转成下一轮改进。
05
落地四原则,先选对场景
选试点场景有五个判断维度:高频性、可验证性、上下文可得性、工具可接入性、价值可度量性。
去哪儿旅行选的是异常修复——频率高,结果能靠编译状态和部署状态客观验证。
职责边界要看任务风险等级、Agent 能力成熟度和合规要求。
模式分"人在环内"和"人在环上",高风险走前者,低风险走后者。
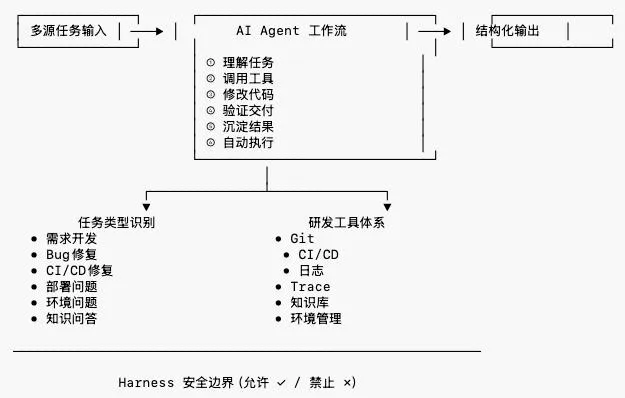
灵畿平台把这套原则做成了可执行规则:编译错误连续 5 次失败触发人工介入。
单测覆盖率连续 3 次低于 80% 升级,高危 API 直接触发人工。
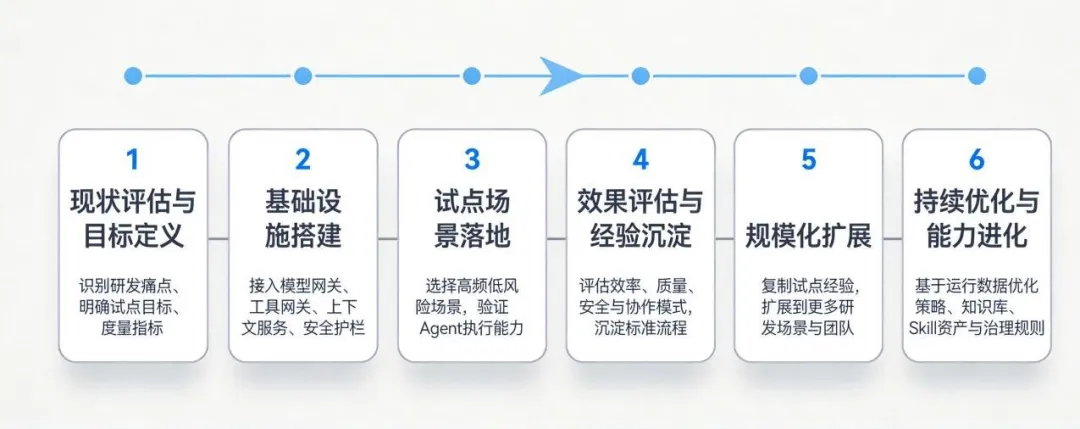
六步路径依次是现状评估、基础设施搭建、试点落地、效果评估、规模化扩展、持续优化。
前两步的重点在模型网关、工具网关、上下文服务和沙箱环境。
06
五家企业,跑出了什么
申万宏源在测试用例生成场景做了三组对照:简化 AI 工作流 49.1 分,引入结构化领域知识后 76.6 分,采用"驾驭工程智能体加结构化知识"方案后达 83 分。
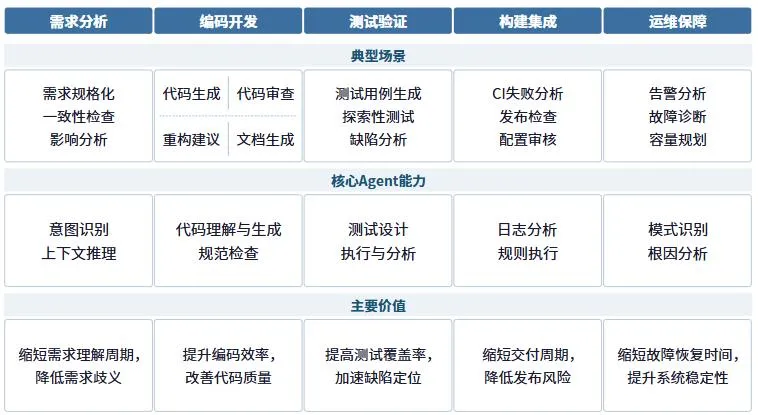
测试点准确率也从 30% 升到 97%,人工修正占比从 73% 降到 7%。
灵畿平台的量化结果更成体系:需求到代码的端到端自动化覆盖率达 87%,跨厂商集成一次性通过率从 58% 升到 90%。
单 Feature 周期则从 8 天缩到 5 天。
中金所走规格驱动路线,构建"业务环"与"开发环"双环机制,新建单项目实现"3 人 2 周内"生产上线。
代码审查引擎则累计拦截 33 项深层逻辑问题。
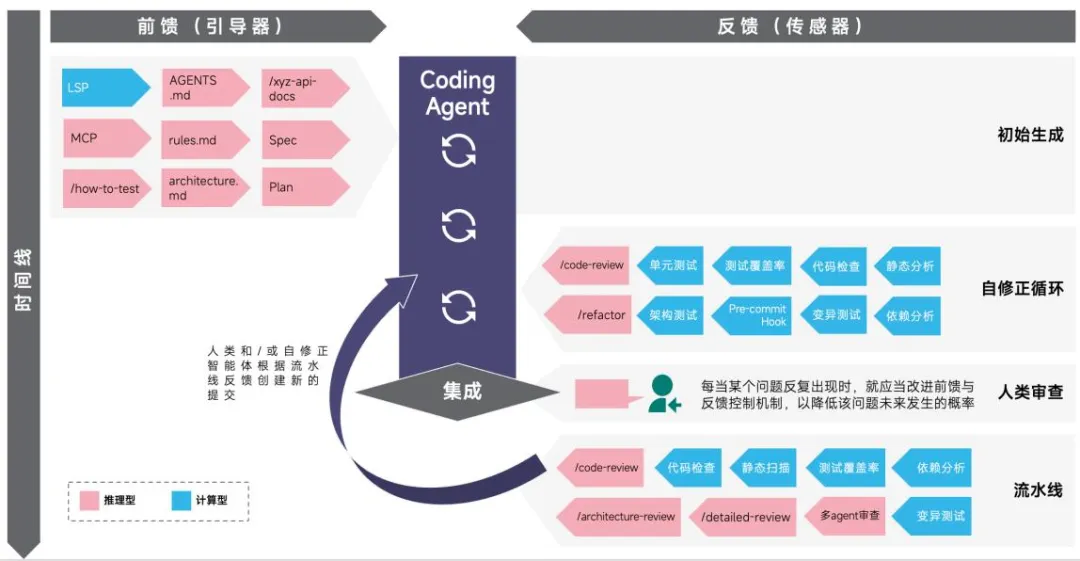
去哪儿旅行和银河证券贡献更偏方法。前者把 AI 研发拆成 Skill 契约层、脚本执行层、证据工作区、安全护栏与本机验证七层,落到自研的天弦平台。
后者提出 User Harness 体系,用"引导器 + 传感器"成对建设,把经验沉淀为组织级控制能力。
关键抉择:3个步骤
第一个步骤:用高频、可验证、上下文拿得到、工具接得进、价值量得出来这五条标准,筛出第一个试点场景。参照异常修复、测试用例生成、集成失败分析这类任务。
第二个步骤:把人和 AI 的边界写成可执行规则,而不是原则性描述。灵畿平台的做法值得抄——编译失败 5 次触发人工,单测覆盖率 3 次低于 80% 自动升级。
第三个步骤:先建四项基础设施再谈规模化。模型网关统一接入与路由,工具网关统一权限与记录,上下文服务动态供给知识。沙箱则承接代码执行与测试,安全能力要在基础设施层内嵌。
文档在展望里留了一句话:AI 负责的是部分执行工作,人类必须掌控意图定义、结果判断和责任承担。
有人还在等一套完整的智能研发平台建成才动手,有人已经在一个编译失败的修复任务上让 Agent 跑通第一轮。
起点不在采购清单上,而在你团队里那个最头疼的具体环节——你准备从哪个场景开始试?
关键词:#驾驭工程 · #AI研发 · #智能体治理 · #人机协同 ·#研发效能
 点击下载

 更多内容,可访问
往期推荐