ARTICLE · 1059881
论文结果报告模板:让每个数字都能回到实验日志
论文结果报告模板:让每个数字都能回到实验日志
系列:开源 AI 论文复现实验与代码解读 · 第五轮 · 080 日期:2026-09-22 适合读者:研究生、科研新人和工程型研究者 复现范围:重放第 079 篇的合成实验摘要,验证日志、统计表与配对区间;不重新训练模型。
目录
复现价值与论文问题 核心思想与统计公式 官方代码阅读路线 最小实验与日志契约 评测协议与实际结果 误差线、失败排查与验证记录 可复用报告模板 后续科研问题与总结
一、复现价值与论文问题
论文报告。 Agarwal、Schwarzer、Castro、Courville 与 Bellemare 在 NeurIPS 2021 讨论了少量运行下的强化学习评测:只比较均值或中位数这样的点估计,会隐藏有限样本造成的不确定性。论文提出区间估计、性能分布和四分位截尾均值等工具,并发布 rliable。[1]
四分位截尾均值,简称 IQM,是保留排序后中间一半分数再求均值的稳健汇总思路。它适合讨论异常任务对汇总指标的影响,却不能修复测试泄漏、错误分母或挑选最好的种子。本篇只有一个合成任务,不为了使用某个指标而把五种扰动预算伪装成五个独立任务。
本次实际验证。 输入来自第 079 篇已有的三个模型运行,每个运行包含五个扰动预算和四种攻击,总共六十条摘要。目标是恢复二十个条件组的均值、样本标准差,并检查弱攻击与强攻击之间的配对差值。模型性能沿用旧日志,本次新增的证据是报告器计算与审计结果。
二、核心思想与统计公式
报告前先定义估计对象:我们关心同一合成生成机制下,完整实验运行变化时,某种攻击得到的鲁棒准确率如何变化。鲁棒准确率记为 RA,本例分母包含全部测试样本;原本就分类错误的样本也计入失败。
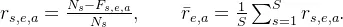
其中,种子索引为 (s),扰动预算为 (e),攻击方法为 (a),(N_s=2048) 是测试样本数,(F) 是失败数,(S=3)。汇总张量形状为 [3,5,4]:三个运行、五个预算、四种攻击。不能把这六十格直接当作六十次独立重复。
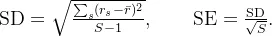
SD 是样本标准差,描述观察到的运行间波动;SE 是均值标准误,在独立同分布运行的假设下估计均值的不确定性。上式中的 (r_s) 固定预算和方法。二者单位相同,含义不同,任何一个都不能直接改名为“百分之九十五置信区间”。NeurIPS 检查表要求明确变异来源、计算方法和误差线类型。[2]
比较两种攻击时,先算 (d_s=r_{s,A}-r_{s,B}),再对 (ar d=S^{-1}\sum_s d_s) 估计区间。这里每对结果共享模型、测试样本与预算;同一数字的种子名本身并不足以证明其他项目也具备这种配对条件。
三、官方代码阅读路线
先读 rliable README 的输入约定:通常是“运行数 × 任务数”的矩阵,并查看指标函数如何消费它。[3] 接着读 metrics.py:aggregate_mean 先求每个任务的运行均值再求任务均值,aggregate_median 则取这些任务均值的中位数,aggregate_iqm 使用截尾操作。[4] 阅读重点是轴和权重,而不只是函数名字。
再到 library.py 的 get_interval_estimates。数组输入走 StratifiedBootstrap,默认不重采样任务;这对应固定任务集合、重做运行的估计问题。多数组输入则走 StratifiedIndependentBootstrap,分别抽取输入样本,不能直接拿来假定保留了方法间配对。[5]
最后对照 SciPy bootstrap 文档:paired=True 才会共享抽样索引,默认区间方法为 BCa;rliable 入口默认是 percentile,即百分位方法。[6] 本文脚本不调用这些库,而是显式枚举三个配对的重采样,避免把不同默认值混为一谈。
本次阅读的是检索日的官方仓库 master,未固定提交;源码阅读已经完成,官方库运行及版本兼容性待人工核验。不能把本文的标准库运行记录写成 rliable 的复现记录。
四、最小实验与日志契约
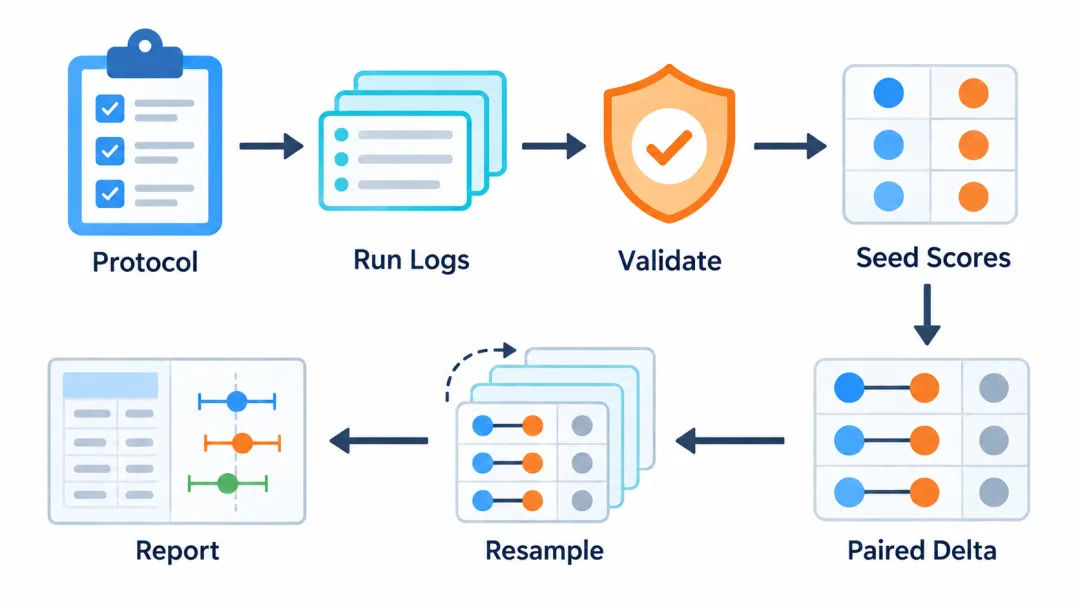
图中先校验日志,再形成种子分数,计算配对差值并重采样。图标和误差线仅示意数据关系,不承载数值结果;报告端不能反馈选择“更好看”的实验配置。
从本篇目录执行:
python3 code/report.pypython3 code/audit.pyPYTHONPYCACHEPREFIX=/tmp/080-pycache python3 -m py_compile code/report.py code/audit.py
仅需 Python 标准库,无须模型下载或加速卡。输入和依赖说明见 code/README.md。input/source_summary.json 是原始摘要的字节副本;manifest.json 记录来源哈希与协议;runs.jsonl 将嵌套结果整理为每行一个条件。
每行保留运行身份、方法、预算、数据划分、指标、样本数、失败数、状态和协议哈希。脚本检查计划网格是否完整,并验证分数能否由失败计数恢复。哈希只能发现内容变化,不能证明上游实验正确;上游预测审计属于第 079 篇的证据范围。
原实验使用三个不同种子同时生成训练、验证、测试数据及初始化,普通逻辑回归训练一千步,取最终检查点,验证集仅用于记录。因此本篇的 SD 混合了数据抽样与初始化等运行变化,不能解释为“纯初始化方差”。四种攻击共享每个运行的数据与权重;零梯度诊断样例已按明确规则排除。
五、评测协议与实际结果
预算全部保留为 0、0.05、0.1、0.2、0.3,正文展示 0.2,完整表保存在 results/table.csv。这是一篇基于已知结果的教学回放,不能宣称预注册或独立确认性实验。方法与显示条件均在说明中披露,没有以测试分数选择新检查点。
本次实际验证。 以下数值由保存的计数重算。表内均值单位为百分比,SD 单位为百分点,三个运行等权;两列不是“均值加减置信区间”。
PGD 是投影梯度攻击,FGSM 是快速梯度符号攻击。此处比较攻击评测器,较高 RA 可能表示攻击漏掉了失败,不表示模型变强。两种强攻击同分是该线性模型与威胁设置的结果,不能推广为任意神经网络上的等价性。
弱 PGD 减强 PGD 的三个配对差值分别为 20.898、22.461、23.047 个百分点,均值为 22.135。脚本穷举有放回抽取三个运行的全部 (3^3=27) 个等概率序列;按逆经验分布函数取两端分位点,得到名义百分之九十五百分位区间 [20.898,23.047] 个百分点。固定随机种子 80 的一万次抽样也保留在验证记录中。
这不是精确覆盖率的保证。“穷举”只消除了这个经验重采样分布的抽样误差,没有增加真实实验次数。三个原始运行仍然太少;论文也展示了少运行时区间覆盖不足的风险。[1] 本文不据此发布显著性胜负结论。
六、误差线、失败排查与验证记录
若要画正式结果图,应将每个种子画成散点,再叠加明确定义的区间;图注写出统计单位、运行数、区间算法和预算。对配对差值画差值区间,而不是凭两根单方法误差线是否重叠判断差异。方法图中的装饰性符号不能当作数据图引用。
例如,同一个模型在两千个样本上测得准确率,增加测试样本能降低某些抽样噪声,却不会凭空产生第二次模型训练。相反,如果两个方法各自换了一份测试集,分数差还混入了题目难度变化。统计单位必须与研究问题对应,代码能运行并不意味着选择的单位合理。
首先排查身份问题:追加日志可能重复同一运行,排序变化可能错配两种方法。脚本使用显式键对齐,乱序后结果保持不变。其次检查失败记录:未完成、空值、非有限值不能填零后继续平均,也不能静默剔除;本示例会停止聚合,要求先说明缺失原因。
再次检查统计层级:同一模型下的测试样本、检查点和攻击预算具有相关性。重采样测试样本可以回答固定模型在样本抽样下的变化,却不能替代重新训练的方差。若数据来自同一患者、文档或对话,还应考虑按组重采样,不能机械照搬逐行抽样。
本次在 Python 3.9.6、CPU 上完成语法检查和 smoke test。九类错误日志被拒绝;恒定配对差值、相同方法和日志乱序检查通过。独立审计脚本不用报告器函数,通过整数失败计数、分数运算和多项式权重复核六十条记录、二十组统计与二十七份重采样概率质量,最大差异低于 1e-14。逐样本预测回放、重新训练和区间覆盖率实验未运行,待人工核验。
七、可复用报告模板
附带的 REPORT_TEMPLATE.md 将报告分成研究问题、运行协议、证据索引、结果、失败与边界六部分。每张结果表应能回答三个问题:比较的条件是什么,统计单位是什么,从哪里重新生成。
模板中的结论应采用“在什么设置下,观察到多大变化,由什么证据支持,尚未排除什么解释”的句式。例如,本例可以说弱攻击在三个保存运行中均报告更高的鲁棒准确率,差值由同模型配对计算;不能写成新防御方法优于基线。若数据尚不足以分辨两个方法,保留不确定性本身也是有效结果,不必通过截断纵轴或增加小数位制造胜负。
正式项目还应记录代码提交、数据版本、环境锁定文件、硬件与执行时间,以及所有失败和重试。若进行了超参数搜索,报告搜索空间、选择所用划分及额外成本;不能只记录最终一次成功运行。若时间或峰值内存没有可靠记录,写“未测量”,不要凭运行规模补估计数字。
八、后续科研问题与总结
作者推断。 下一步可固定测试集,仅改变初始化,再与重新抽取训练集的设置对照,拆分不同随机因素。另一个问题是增加真实运行数后,配对区间的覆盖率是否接近标称值;这需要重复完整实验,而不是把 bootstrap 次数从一万调到百万。
多任务研究还需要决定任务等权还是样本等权,明确结论针对既定任务集合还是新的任务总体。任务选择、归一化和缺失处理改变的是估计对象,不能交给绘图库默认决定。
可靠的结果报告从日志契约开始,到证据边界结束。一个可追溯的均值、解释清楚的误差线和公开保留的失败记录,比没有统计对象的更多小数位更有科研价值。
参考资料
检索日期:2026-09-22。以下一手页面与源码均已实际打开;论文按会议发表版本引用,仓库按检索日 master 阅读,动态版本兼容性待人工核验。
Rishabh Agarwal, Max Schwarzer, Pablo Samuel Castro, Aaron C. Courville, Marc G. Bellemare. Deep Reinforcement Learning at the Edge of the Statistical Precipice, NeurIPS 2021:会议页面、论文 PDF。 NeurIPS. Paper Checklist:统计显著性与实验可复现性,在线指南,检索日版本。 Rliable Authors. 官方仓库与 README,配套开源实现。 Rliable Authors. metrics.py,指标聚合实现。 Rliable Authors. library.py,分层与独立重采样实现。 SciPy Developers. scipy.stats.bootstrap,页面显示 v1.18.0;本文未安装或执行该版本。