ARTICLE · 1059886
“从一道笔试题说起:链表是什么?它从哪里来?有什么用?”——从数组的死穴到链表的诞生
【引言】
数组大小固定、插入删除代价高。链表正是为了解决这两个问题而诞生的——每个节点分散在内存中,靠指针串起来。链表到底用在哪些地方?什么时候必须用它?
一、一道笔试题,全部答对率不到60%
先看一道某厂C语言笔试题:
以下哪些操作,链表比数组更高效?
A. 随机访问第 n 个元素
B. 在序列开头插入元素
C. 已知指向某个节点的指针,在该节点之后插入一个新节点
D. 按顺序遍历所有元素
很多同学的答案:A、B、C、D 或 A、C
正确答案:B、C
A 错:数组随机访问是 O(1),链表是 O(n)——链表要一个一个找。
B 对:数组在开头插入要移动所有元素 O(n),链表只需改两个指针 O(1)。
C 对:链表在已知节点指针时,插入只需改指针 O(1);数组即使知道下标,插入仍需 O(n) 移动元素。
D 错:两者遍历都是 O(n)。
为什么链表在插入/删除上这么快,却在随机访问上这么慢?这得从数组的“死穴”说起。
二、数组:已经很好理解,但有一个死穴
2.1 数组:连续内存,随机访问快
数组是计算机科学中最古老的数据结构之一。它的设计完美映射了计算机内存的物理布局——连续编址。
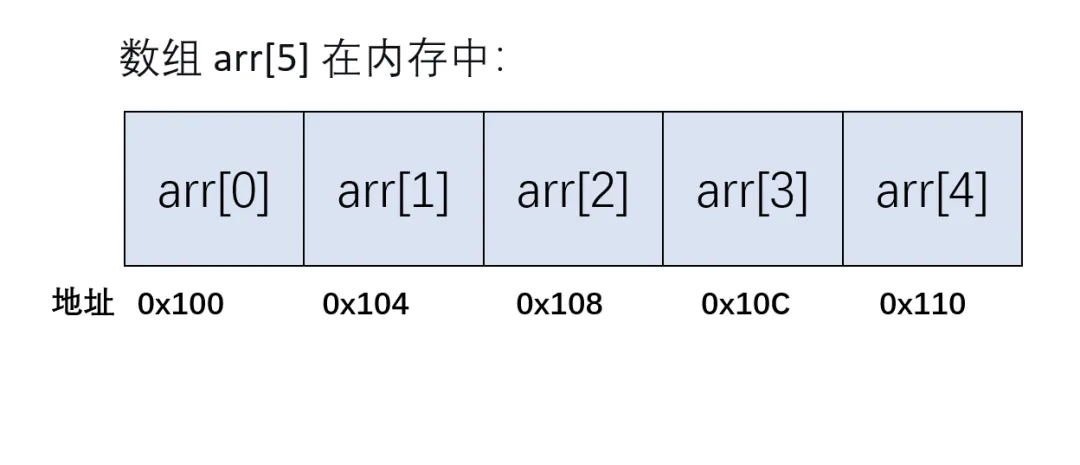
数组的优点极其突出:
随机访问 O(1):要访问
arr[i],只需计算地址 = 首地址 + i × 元素大小,一步到位。缓存友好:连续内存,CPU 缓存命中率极高。
实现简单:硬件层面直接支持。
在 1950-1960 年代,当内存只有几 KB 时,数组几乎是唯一的选择。
2.2 但数组有一个“死穴”——大小固定
数组的所有优点,都建立在一个前提上:大小必须在编译时或创建时确定。
int arr[1000];// 编译时确定:最多1000个元素
如果你不知道要存多少数据呢?
场景:读取用户输入的一串数字,直到输入0为止用户可能输入10个,也可能输入100万个数组怎么办?你只有三个选择:
预估一个最大值:
int arr[1000000];——浪费内存,而且如果不够用呢?动态扩容:当数组满了,申请一块更大的连续内存,把旧数据全部复制过去——O(n) 的拷贝代价。
放弃:告诉用户“数组满了,不能再存了”。
而且,数组中间插入/删除元素更痛苦:
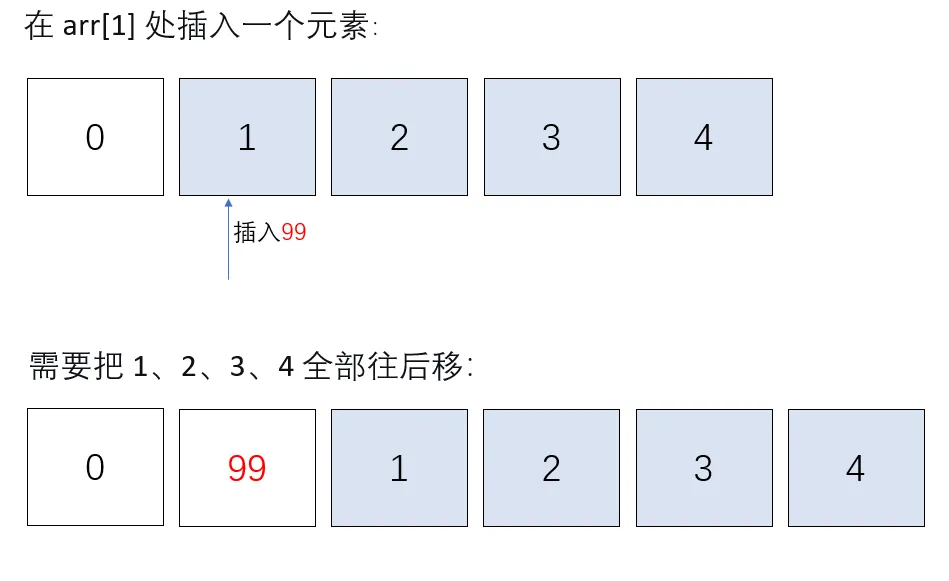
移动了 4 个元素——如果数组有 100 万个元素,插入一个就要移动 100 万个。
数组的“死穴”总结:
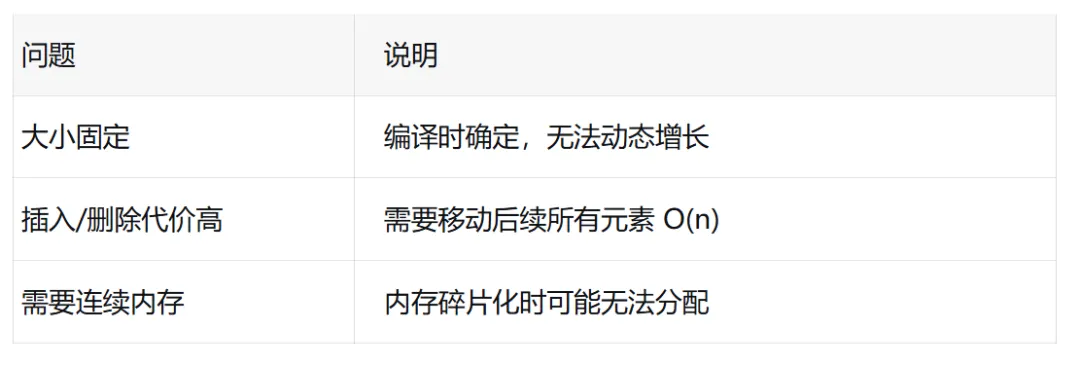
三、链表的诞生:打破“连续”的枷锁
3.1 链表的起源(1955-1956年)
链表的概念最早由 Allen Newell、Cliff Shaw 和 Herbert Simon 在 RAND 公司开发 IPL(Information Processing Language) 时提出。他们当时正在研究人工智能,需要一种能够动态增长、灵活插入删除的数据结构来表示列表和树。
他们的核心洞察是:
如果每个节点都知道下一个节点在哪里,那么这些节点就不需要连续存放。
这就是链表的本质——用指针把分散的节点“链”起来。
3.2 链表如何破解数组的三大死穴?
破解一:大小不再固定
数组的大小在创建时就固定了。链表呢?每需要一个新元素,就动态分配一个节点。
typedef struct Node {int val; // 数据struct Node *next;// 指向下一个节点} Node;// 需要新节点时,动态申请Node *newNode = (Node*)malloc(sizeof(Node));newNode->val = 42;newNode->next = NULL;
想存多少就存多少——只要内存够,链表就能一直长。
破解二:插入/删除 O(1)
在链表中插入一个节点,只需要修改两个指针:
在节点 A 和节点 B 之间插入新节点 N:插入前: A → B → C插入后: A → N → B → C操作:N->next = A->next; // N 指向 BA->next = N; // A 指向 N
没有移动任何已有元素——无论链表有 10 个节点还是 100 万个节点,插入都是固定的两步操作。
破解三:不需要连续内存
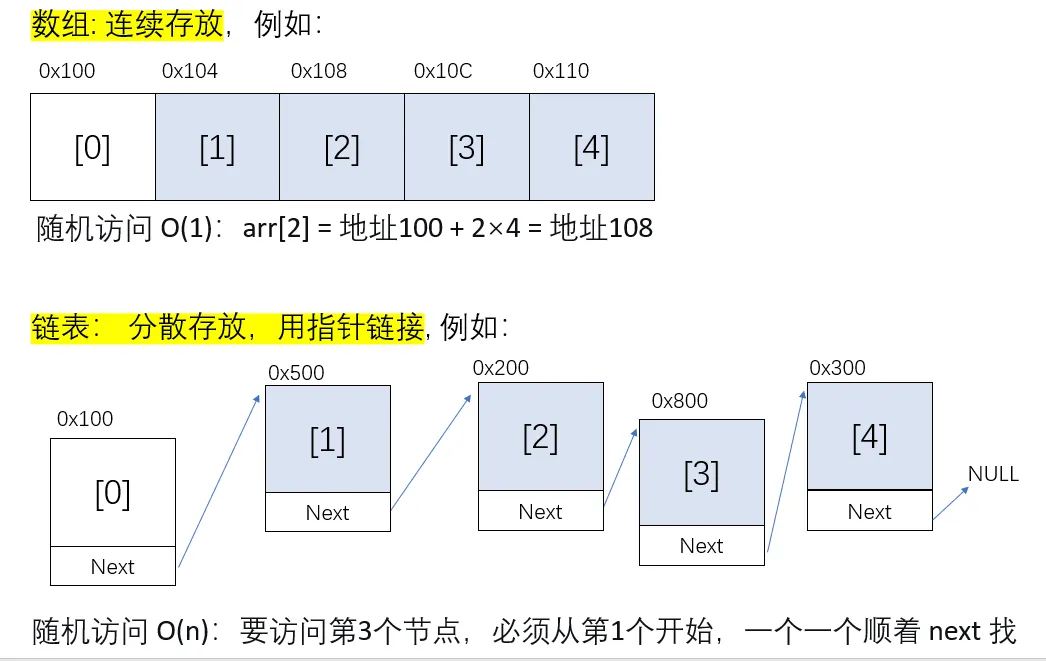
数组要求所有元素在内存中连续存放。链表没有这个要求——节点可以分散在内存的任何位置,只要每个节点知道下一个节点在哪里就够了。
这意味着:只要内存中有零散的空闲块,链表就能利用起来。而数组必须找到一块足够大的连续内存,否则就无法分配。
四、链表长什么样?——内存图
4.1 一个简单的链表
typedef struct Node {int val; // 数据域struct Node *next; // 指针域(指向下一个节点)} Node;// 创建三个节点:1 → 2 → 3 → NULLNode *n1 = (Node*)malloc(sizeof(Node));Node *n2 = (Node*)malloc(sizeof(Node));Node *n3 = (Node*)malloc(sizeof(Node));n1->val = 1; n1->next = n2;n2->val = 2; n2->next = n3;n3->val = 3; n3->next = NULL;
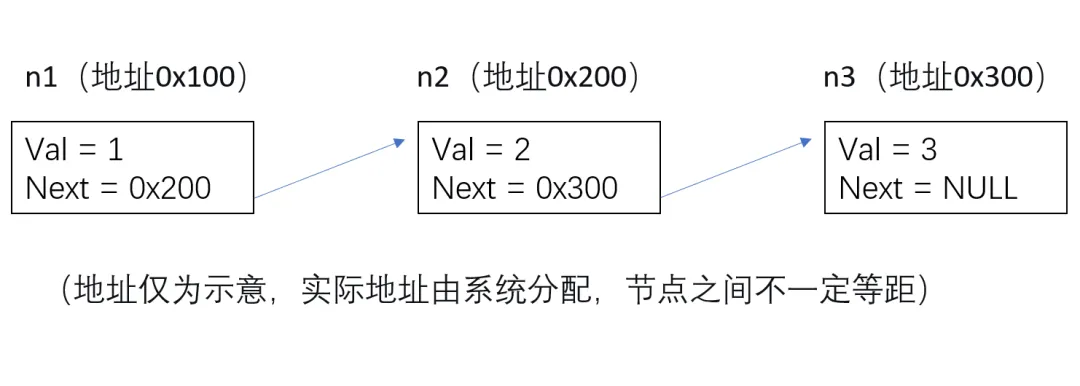
注意:n1、n2、n3 的地址不一定连续——它们可以分散在堆内存的任何位置。
但链表也有代价:每个节点除了存储数据,还要额外存储一个 next 指针。
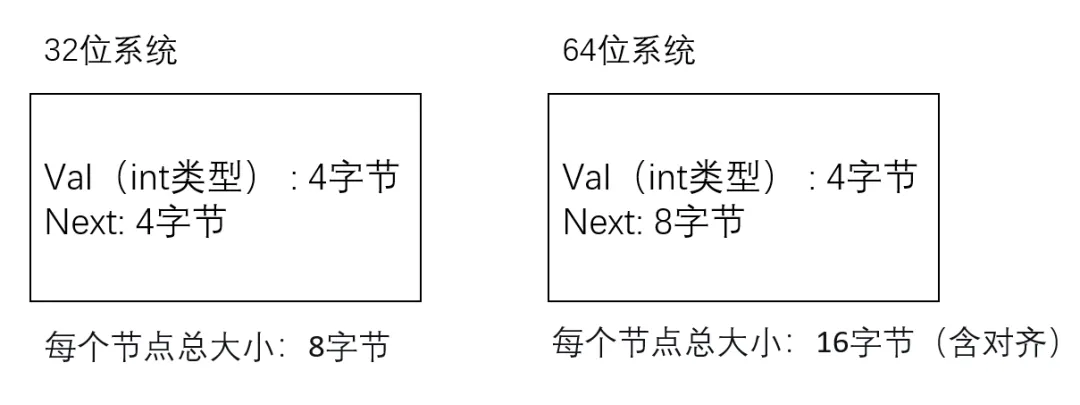
存储同样的数据,链表比数组多消耗一份指针空间。以 int 为例:
每个元素/节点占多数字节
💡 这就是链表的代价:用额外的指针空间换取动态大小和 O(1) 插入删除。
📌 以上是单链表——每个节点只指向下一个节点。链表还有其他形式:
双向链表:每个节点同时指向前面和后面的节点,支持双向遍历
循环链表:尾节点的
next指回头节点,形成一个环本文以单链表为例讲解,理解了单链表,双向链表和循环链表只是多了一个指针或改了一个指向而已。
4.2 数组 vs 链表:内存布局对比
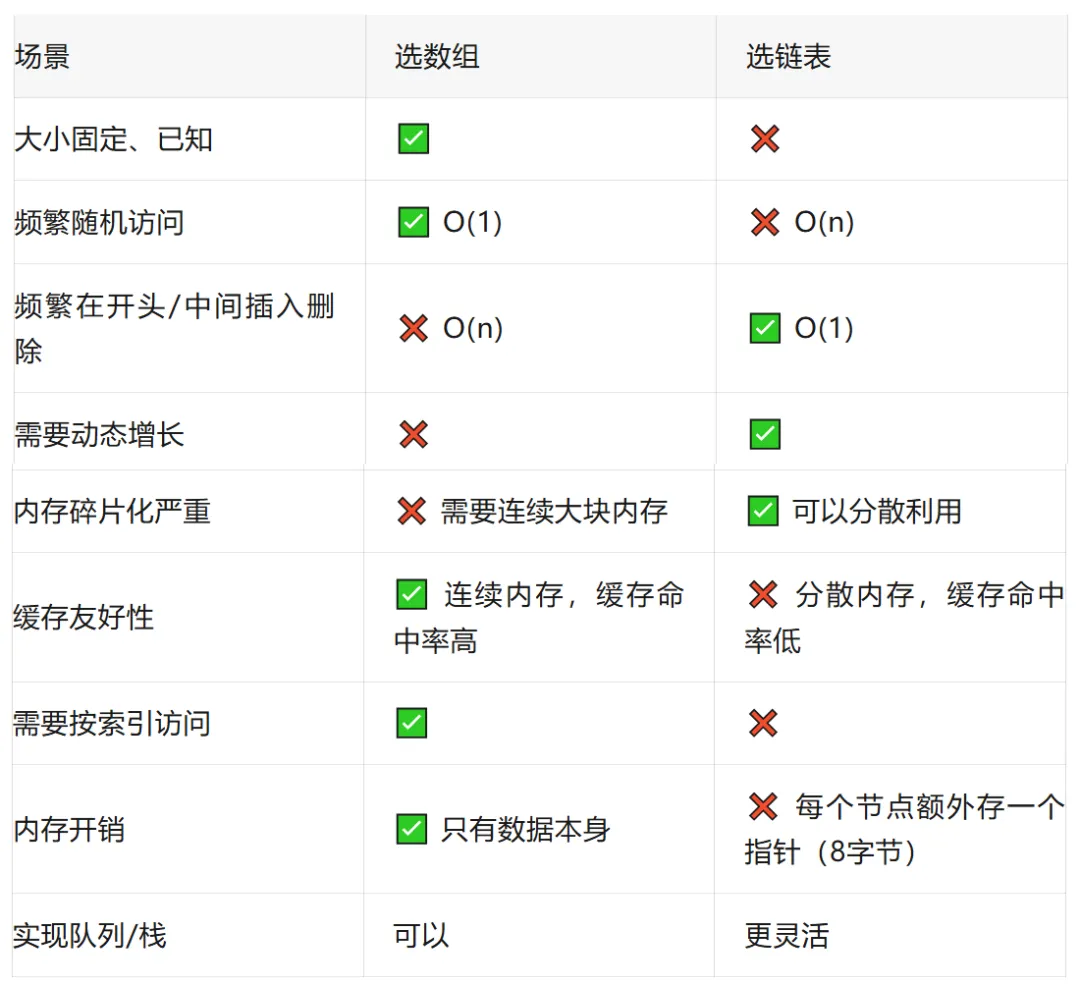
五、链表和数组,到底该选谁?
六、链表到底有什么用?——从编程场景看链表的真实价值
链表不只是笔试题里的“反转链表”“找环”。在实际编程中,以下场景链表是天然的选择。
场景一:读取未知长度的数据
你写一个程序,读取用户输入的一串整数,直到输入结束为止。问题:你不知道用户会输入多少个。
// 数组方案:必须预估一个最大值int arr[10000];// 如果用户输入超过10000个呢?int count = 0;// 链表方案:来一个,分配一个节点typedef struct Node {int val;struct Node *next;} Node;Node *head = NULL;Node *tail = NULL;while (1) {int x;scanf("%d", &x);if (scanf("%d", &x) != 1) break; // 输入结束或格式错误,退出Node *newNode = (Node*)malloc(sizeof(Node));newNode->val = x;newNode->next = NULL;if (head == NULL) {head = newNode;tail = newNode;} else {tail->next = newNode;tail = newNode;}}
为什么用链表? 因为输入数量完全未知。数组必须预估一个最大值,而链表可以随时加节点。
场景二:动态增删的学生信息管理
你写一个学生信息管理系统,学生随时可能转学(删除)、插班(插入)。人数不确定,而且需要频繁在中间插入删除。
typedef struct Student {char name[20];int score;struct Student *next;} Student;// 插入学生(在指定学生之后)voidinsertAfter(Student *prev, Student *newStu){newStu->next = prev->next;prev->next = newStu;}// 删除学生(删除指定学生的下一个)voiddeleteAfter(Student *prev){Student *toDelete = prev->next;prev->next = toDelete->next;free(toDelete);}
为什么用链表? 因为学生人数不确定,而且随时可能在中间插入或删除。用数组的话,每次插班/转学都要移动后面所有学生。
场景三:按优先级处理的任务队列
你写一个打印任务调度器,高优先级的任务要排在前面。任务随时可能新增,优先级也随时可能变化。
typedef struct Task {char name[50];int priority;struct Task *next;} Task;// 插入任务时,按优先级找到正确位置voidinsertByPriority(Task **head, Task *newTask){if (*head == NULL || newTask->priority > (*head)->priority) {newTask->next = *head;*head = newTask;return;}Task *cur = *head;while (cur->next != NULL&& cur->next->priority >= newTask->priority) {cur = cur->next;}newTask->next = cur->next;cur->next = newTask;}
注意:这里用
>=表示相同优先级时,新任务排在已有同优先级任务的后面(FIFO)。如果希望新任务排在前面,把>=改成>即可。
为什么用链表? 因为任务需要按优先级插入到中间位置,而且数量不确定。数组做不到“在中间插一个位置,还不移动其他元素”。
场景四:内存池的空闲块管理
你写一个简易的内存分配器,需要管理一块大的内存,随时分配和释放不同大小的块。空闲块的数量和大小都不确定。
typedef struct FreeBlock {size_t size; // 这块空闲内存的大小struct FreeBlock *next; // 下一个空闲块} FreeBlock;FreeBlock *freeList = NULL; // 空闲块链表
分配内存时:从链表中找到一个足够大的块,摘下来。
释放内存时:把块插回链表。
为什么用链表? 因为空闲块的数量和大小都是动态变化的,而且需要频繁插入删除。
什么时候“不需要”链表?
链表虽好,但不是银弹。以下场景,数组更好:
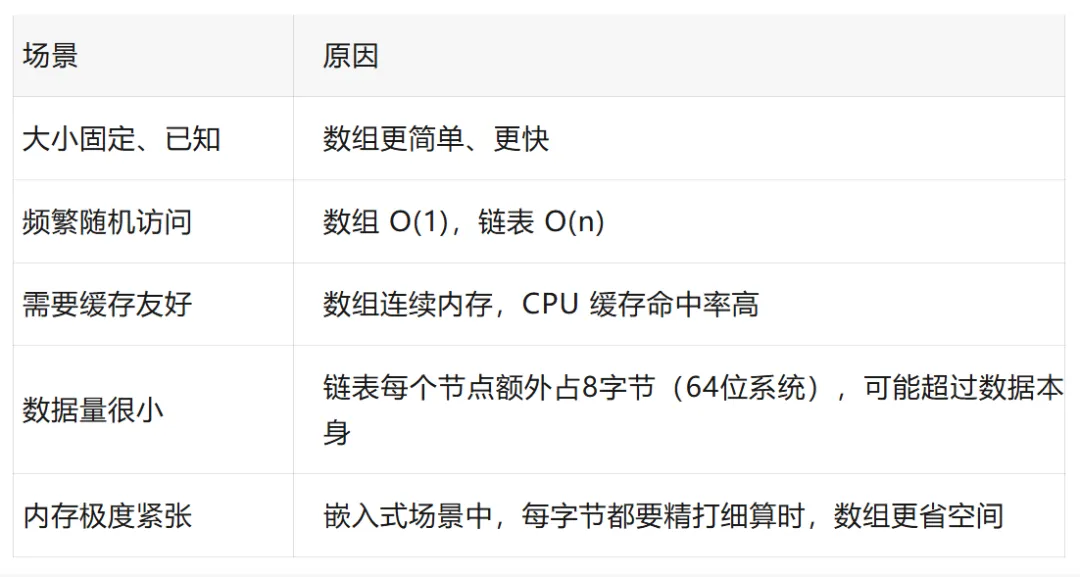
总结:什么时候用链表?
数量不确定 → 用链表
频繁在中间插入删除 → 用链表
不需要随机访问 → 用链表
大小固定且已知、频繁随机访问 → 用数组
七、回归笔试题
以下哪些操作,链表比数组更高效?A. 随机访问第 n 个元素B. 在序列开头插入元素C. 已知指向某个节点的指针,在该节点之后插入一个新节点D. 按顺序遍历所有元素
答案:B、C
A 错:数组随机访问 O(1),链表 O(n)——链表要顺着指针一个一个找。
B 对:数组在开头插入要移动所有元素 O(n),链表只需改两个指针 O(1)。
C 对:链表在已知节点指针时,插入只需改指针 O(1);数组即使知道下标,插入仍需 O(n) 移动元素。
D 错:两者遍历都是 O(n)。
为什么链表插入快,访问慢?
因为链表放弃了连续内存,换来了动态大小和 O(1) 插入删除。这是计算机科学中最经典的“灵活性换效率”的权衡。
八、一张图总结
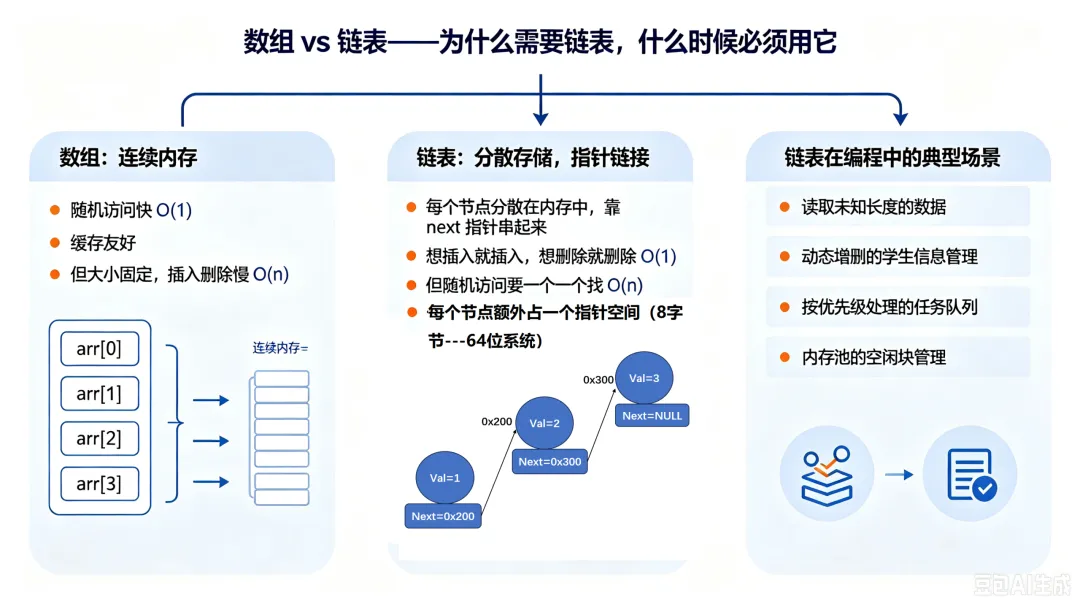
写在最后
为什么需要链表?
因为数组有一个致命的“死穴”——大小在编译时固定,插入删除需要移动元素。链表用指针把分散的节点链接起来,完美破解了这两个死穴。
链表用在哪里?
读取未知长度的数据
动态增删的学生信息管理
按优先级处理的任务队列
内存池的空闲块管理
记住一句话:
数量不确定、频繁插入删除——用链表。
大小固定、频繁随机访问——用数组。
没有谁更好,只有谁更合适。
🎁 彩蛋:链表节点的“自我介绍”
typedef struct Node {int val; // 我身上背着的数据struct Node *next;// 我知道下一个节点在哪里} Node;
每个链表节点都在说:
“我不知道链表有多长,也不认识所有的节点。我只知道自己的数据,和下一个节点的地址。但只要跟着我走,就能找到整条链表。”