ARTICLE · 1061360
击溃传统OCR!腾讯微信开源端到端文档神器 WeVisDoc:越是恶劣环境,它越能打!
做过 RAG(检索增强生成)、知识库构建或者文档智能处理的朋友,对下面这一幕一定不陌生:
为了把一份 PDF 或扫描件转成大模型能读的 Markdown,你的后台往往堆砌着一套庞大而臃肿的 “拼装流水线” ——
先跑一遍版面分析检测文本块、表格和公式区域;再把图片切成无数碎片分别扔给 OCR 识别文字、公式识别器(LaTeX OCR)以及表格结构还原模块;最后还要绞尽脑汁编写复杂的启发式规则,把它们按所谓的 “人类阅读顺序” 重新拼接起来。
只要中间任何一个环节出现微小的偏差(比如公式切碎了、表格框偏了),下游就会出现灾难性的连锁反应。更要命的是,一旦遇到手机拍照倾斜、光照不均、折痕阴影或者模糊压缩的 “真实退化场景”,整条流水线往往瞬间瘫痪。
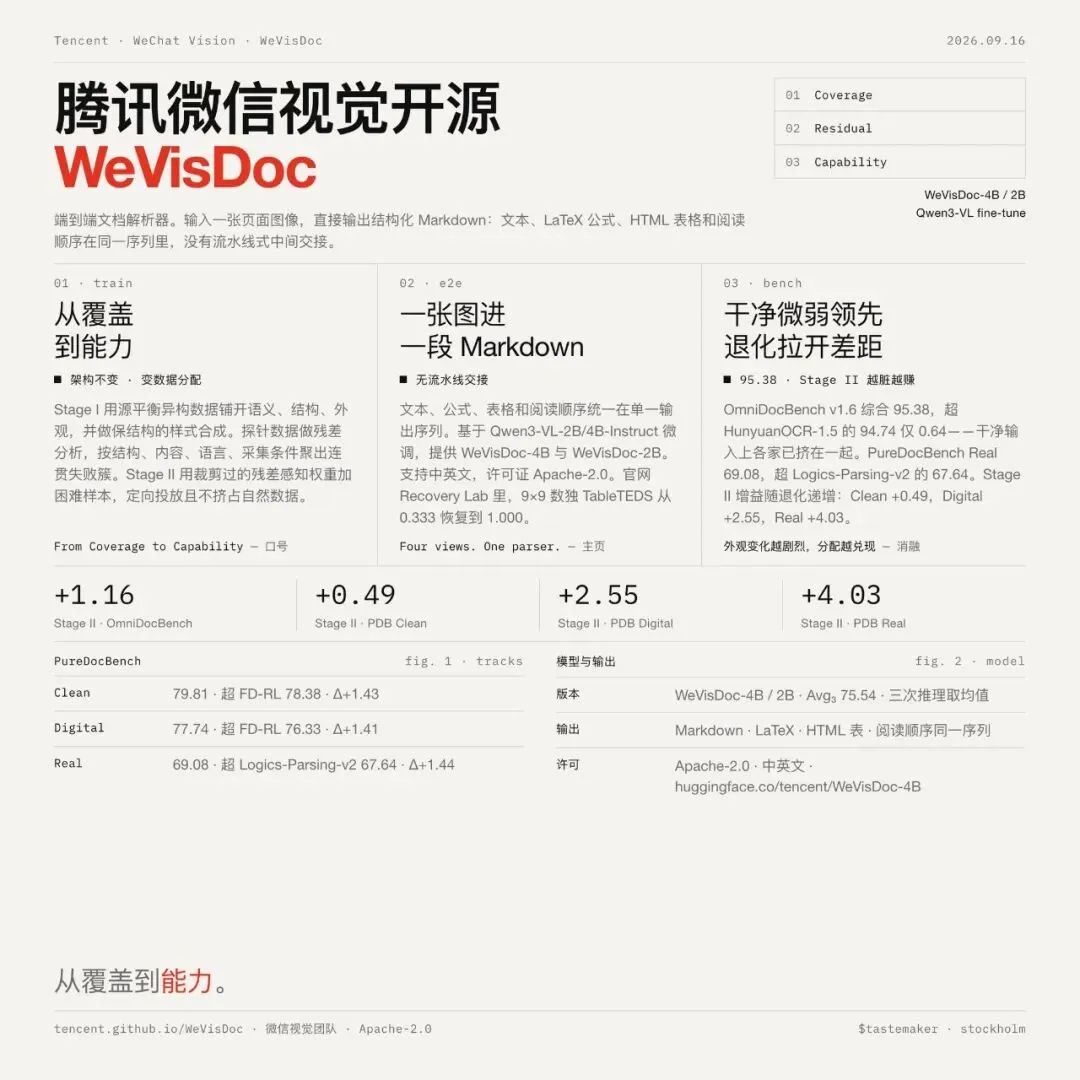
近日,腾讯微信视觉团队 正式开源了全新端到端文档解析器 —— WeVisDoc,不仅彻底打破了这一僵局,更在全部四个主流评测设置中强势拿下 “全满贯第一”!
一张图进,结构化 Markdown 出:端到端终结“流水线噩梦”
与传统的拼装方案截然不同,WeVisDoc 采用纯粹的 端到端(End-to-End)生成范式:
输入一张页面图像,直接一步到位输出完整的结构化 Markdown!
在单一输出序列中,WeVisDoc 将文本、LaTeX 公式、HTML 表格以及全局阅读顺序无缝统一,完全没有流水线式的中间交接与误差累积。
为了兼顾不同计算资源的落地需求,WeVisDoc 基于开源底座 Qwen3-VL-2B / 4B-Instruct 进行了深度微调,同时提供 WeVisDoc-2B 与 WeVisDoc-4B 两个版本,原生支持中英文文档解析,并采用极度友好的 Apache-2.0 协议开源,企业与开发者皆可自由商用与微调。
核心方法论:从覆盖到能力(From Coverage to Capability)
既然底座模型大家都能拿到,为什么 WeVisDoc 能脱颖而出?
答案就在其极具启发性的 “以数据为中心的两阶段训练策略”。官方提出的口号 “From Coverage to Capability”,精确诠释了其核心精髓。
值得注意的是,在整个训练过程中,模型的网络架构在两阶段之间 完全保持不变,核心差异全部来自于 数据分配与 token 预算的精准投放:
1. Stage I:覆盖扩展(Coverage Expansion)
首先利用来源平衡的异构大规模数据,全面覆盖文档的 语义、结构、外观 三大维度。配合特有的 “保结构样式合成” 技术扩充外观多样性,核心目标只有一个:让模型先“什么都见过”,建立广袤的基底视野。
2. 诊断阶段:残差分析(Residual Analysis)
模型练完第一阶段后,研究团队并没有盲目继续灌数据,而是用预留的探针数据集执行精细的 残差分析。系统会根据文档结构、语义内容、语言类型、采集物理条件等多维度进行聚类,从而准确定位出 “系统性薄弱簇” —— 找到那些连贯出现的失败模式,而不是孤立的偶发错误。
3. Stage II:能力分配(Capability Allocation)
基于前一步的诊断结果,引入经过精细裁剪的 残差感知权重 与精选困难样本,把宝贵的训练 token 预算像手术刀一样,定向投放到模型的薄弱区域。同时,刻意保护自然数据的固有份额,防止“按下葫芦浮起瓢”,实现能力的靶向突破。
权威基准评测:四项设置全冠,恶劣退化场景绝对统治
在标准、干净的文档场景下,各家大厂的头部文档解析模型往往已经 “神仙打架、挤在一团”。
但一旦进入真实复杂环境,真实差距立刻暴露无遗。官方在 GitHub 开源仓库中公布了极其详尽的评测数据:
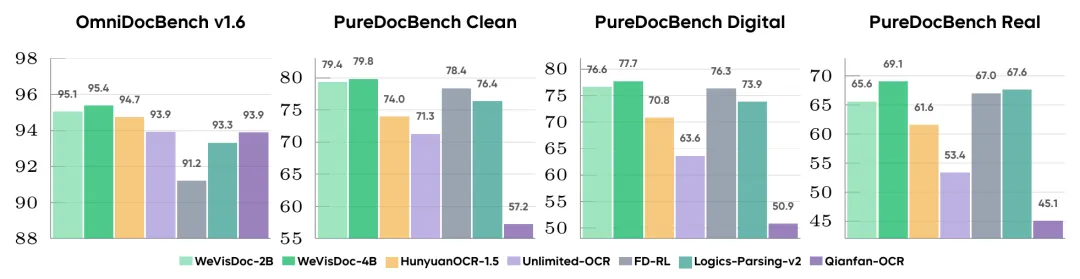
1. OmniDocBench v1.6:规整文档全维度登顶
在包含多领域文档的权威基准 OmniDocBench v1.6 上,WeVisDoc 表现出极高水准:
| WeVisDoc-2B | 2B | 95.06 | 0.038 | 95.94 | 93.03 | 95.26 | 0.130 |
| WeVisDoc-4B | 4B | 95.38 | 0.036 | 96.81 | 92.95 | 95.34 | 0.125 |
可以看到,WeVisDoc-4B 斩获 95.38 分,各项指标(文本编辑距离 0.036、公式 CDM 96.81、阅读顺序编辑距离 0.125)均大幅领先;甚至仅有 2B 参数量的 WeVisDoc-2B 同样拿下 95.06 分,超越了此前所有的 3B/4B/7B 竞品!
2. PureDocBench:真实退化场景逆袭拉开代差
真正体现技术壁垒的,是按采集条件分为三条赛道的 PureDocBench:
| WeVisDoc-2B | 2B | 73.86 | 79.36 | 76.62 | 65.60 |
| WeVisDoc-4B | 4B | 75.54 | 79.81 | 77.74 | 69.08 |
在真实拍摄(Real Degraded,含光照不均、透视变形、阴影折痕)设置下,WeVisDoc-4B 拿到了惊人的 69.08 分,将优势彻底拉开!
更具说服力的是内部消融实验:Stage II(能力分配)带来的增益,随着场景恶劣程度呈倍数级放大!
• 在标准 OmniDocBench 上仅增益 +1.16; • 在 PureDocBench Clean 上仅增益 +0.49; • 在 PureDocBench Digital 上增益升至 +2.55; • 在面对真实拍照恶劣退化的 PureDocBench Real 上,增益直接飙升至 +4.03!
在项目官方的 Recovery Lab(恢复实验室) 中,面对一张极度扭曲退化的 9×9 数独表格,WeVisDoc 成功将 TableTEDS 结构准确率从崩溃的 0.333 极限拉升至满分 1.000,充分验证了其拓扑还原的硬核实力。
开箱即用:原生支持 vLLM 高并发部署
除了模型能力出众,WeVisDoc 在工程落地上的友好度同样拉满。
项目原生支持 vLLM(>=0.11.1) 高吞吐部署,并提供与 OpenAI 兼容的标准接口,一键即可启动本地高性能服务:
# 启动 vLLM 部署(支持多卡并行与长上下文)CUDA_VISIBLE_DEVICES=0,1 TENSOR_PARALLEL_SIZE=2 MAX_MODEL_LEN=65536 \ bash scripts/serve_vllm.sh Tencent/WeVisDoc-4B --dtype bfloat16客户端调用同样轻量,不仅支持单图解析,更支持多进程目录级批量并发:
# 单张文档一键转换python -m wevisdoc.client --image page.png --output results/page.md# 目录批量并发处理python -m wevisdoc.client --image-dir images --result-dir results --workers 4总结
从碎片化的多模块拼接,走向纯粹高效的端到端序列建模;从盲目刷量堆算力,走向 “残差诊断驱动的精准能力分配” —— 微信视觉团队开源的 WeVisDoc,无疑为当前的 RAG 知识库与复杂文档数字化建设树立了全新的工程标杆。
目前该项目代码、权重与技术报告已全面公开,感兴趣的开发者不妨第一时间上手实测!
开源项目与信息源
• GitHub 代码仓库:https://github.com/Tencent/WeVisDoc • 官方项目主页:https://tencent.github.io/WeVisDoc/ • Hugging Face 模型(4B):https://huggingface.co/Tencent/WeVisDoc-4B • Hugging Face 模型(2B):https://huggingface.co/Tencent/WeVisDoc-2B • 技术论文(arXiv: 2609.20423):https://arxiv.org/abs/2609.20423