ARTICLE · 1061354
企业知识库内容与数据工程实战 11|文档切分为什么不能只按固定字数
1. 检索命中了,答案为什么仍然断章取义
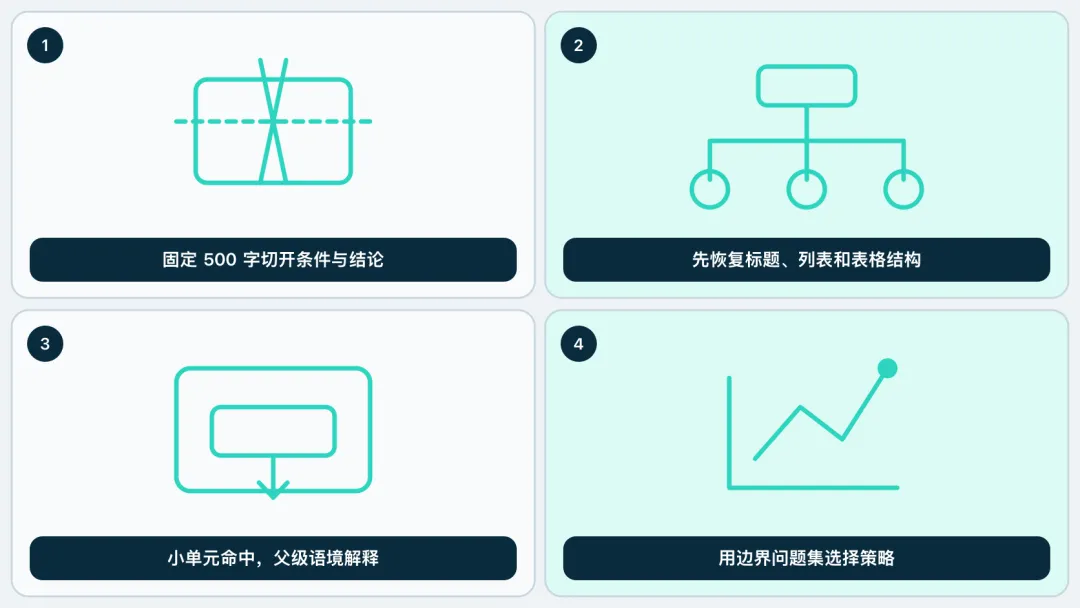
某企业把制度文档统一切成 500 字一段,并保留 100 字重叠。上线后,搜索指标看起来并不差,业务却不断反馈:报销上限能搜到,适用对象在上一段;操作步骤能搜到,前置条件在前一页;表格某一行被召回,表头和脚注却不在上下文中。
这不是“向量模型不够强”,而是切分阶段已经破坏了知识对象。系统召回的是一段相似文本,却没有召回构成事实所需的完整条件。
切分的工程目标不是让文本满足 embedding 的长度限制,而是生成可检索、可理解、可引用、可授权、可撤回的知识单元。
2. 一个好的知识单元要同时满足五个约束
知识单元至少要回答五个问题:它在讲什么;它依赖哪些上文;它从原件哪里来;它是否可以独立参与检索;源内容变化时如何让它失效。
固定窗口只解决“长度不超过上限”。它不理解标题、列表、表格、代码符号和例外条款,也不知道两段文字之间是并列、补充还是条件关系。结构切分则先恢复文档对象,再从结构中派生检索单元。
因此,段落不是天然的最小知识单位,token 数也不是跨场景通用的常数。制度条款、表格行、代码函数、工单事件和会议决议需要不同的边界。
3. 理论依据:更多上下文不等于更好利用
RAG 与 DPR 的公开研究说明,先检索外部知识再生成可以改善知识密集任务,但这些实验并没有证明任意切分方式都有效。检索器只能在已经生成的候选单元中选择;边界切错后,后续模型无法可靠恢复被丢弃的条件。
《Lost in the Middle》的受控实验显示,长上下文中的信息并不会被均匀利用,位于中间的相关内容可能更难被模型使用。这意味着“把整篇文档塞进去”也不是稳定解法。LongRAG 进一步提供了长单元或文档级检索的比较路线,但它仍需要在具体任务、语料和成本约束下验证,不能据此宣布长块永远优于短块。
信息觅食理论则解释了为什么标题、章节、摘要和邻近语境很重要:用户和系统都依赖这些“信息气味”判断内容是否值得继续使用。脱离父级标题的孤立文本,即使语义相似,也可能缺少业务判断所需的范围线索。
4. 先建立结构树,再生成检索单元
建议把处理分为两层。第一层是结构化中间表示,保留文档、章节、段落、列表、表格、图注和脚注之间的关系;第二层才是面向检索派生的 unit。
一个最小 unit 可以包含:
{ "unit_id": "u_2048", "source_id": "policy_17", "revision_id": "rev_6", "node_type": "clause", "title_path": ["差旅制度", "住宿标准", "特殊地区"], "content": "……", "parent_unit_id": "u_2039", "locator": {"page": 8, "paragraph": 3}, "valid_time": {"from": "2026-01-01", "to":null}, "acl_version": "acl_31", "parser_version": "layout-v4"}这里真正重要的不是字段多少,而是 unit 没有脱离 source、revision、locator 和权限独立存在。否则切分完成后,引用、删除和权限控制都会再次发明一套映射。
5. 四类常见切分策略如何取舍
固定窗口
实现简单、吞吐稳定,适合作为未知格式或结构解析失败时的回退。代价是跨边界错误多,容易把标题与正文、条件与结论切开。
结构切分
按标题、段落、列表、表格和代码符号生成边界,可解释性最好。但它依赖解析质量;标题层级恢复错误时,切分也会跟着错误。
父子单元
用较小子单元参与召回,命中后返回较大的父级语境。它兼顾精确匹配和上下文完整性,但需要控制父级扩展范围,避免把无关章节一起送入模型。
长单元或文档级检索
适合跨段推理、叙事连续或结构难以分割的材料。它减少碎片化,却增加重排、上下文成本和中间信息被忽略的风险。
工程上通常不是四选一,而是按源类型配置候选策略,再用真实问题集比较。
6. 表格、列表和例外条款不能套普通段落规则
表格单元至少要携带表名、表头、行列坐标、单位和脚注。只召回“北京 600”没有意义,必须知道它对应住宿上限、币种、人员级别和生效时间。
步骤列表应尽量保持顺序和前置条件;把第 4 步单独召回,可能让用户绕过第 1 步的审批。例外条款则需要与主规则建立 exception_to 关系,不能因为篇幅短而被归入下一段。
当一个单元必须依赖上文才能解释时,可以补充受控上下文,例如父级标题和一段简短说明。但补充内容属于派生数据,应记录生成方式和版本,不能伪装成原文。
7. 用问题集选择策略,不用经验拍一个数字
建立包含边界问题的评测集:答案跨两个段落、标题决定含义、表格依赖表头、否定词位于上一句、脚注修改主规则、代码调用跨文件。对每种策略记录 recall@k、引用完整率、可定位率、无关上下文比例、平均 token 成本和最终答案正确率。
解析质量与检索质量要分开测。若标题树本身恢复错误,不能把失败全部归因于 chunk;若 unit 正确但召回失败,才进入索引、查询和重排排查。
不要追求一个全公司统一的“最佳 800 token”。更合理的结果是一张策略矩阵:制度按条款和父子单元,表格按区域和语义行,代码按符号与提交,会议按议题、决议和行动项。
8. 上线前的最小验收
• 任一 unit 都能回到原件页码、段落、单元格、代码行或时间戳; • 标题、适用范围、否定条件和例外条款不会因切分丢失; • unit 继承 revision、ACL、有效期和删除状态; • 更换切分器后可从同一结构化中间表示重跑; • 对边界问题集至少比较固定窗口、结构切分和父子单元; • 指标改善必须在本组织语料上成立,不把公开实验结果写成企业收益。
9. 小结
切分不是文本预处理的小步骤,而是知识对象建模。固定字数可以做回退,却不应成为所有内容的默认契约。
可迁移的原则是:先保结构,再派生 unit;小单元负责命中,大语境负责解释;边界由问题集验证;每个单元始终绑定来源、版本、定位和权限。不同业务真正需要调整的是单元粒度、父级扩展范围和成本预算。
主要参考资料
• Lewis et al., Retrieval-Augmented Generation, NeurIPS 2020:https://papers.nips.cc/paper/2020/file/6b493230205f780e1bc26945df7481e5-Paper.pdf • Karpukhin et al., Dense Passage Retrieval, EMNLP 2020:https://aclanthology.org/2020.emnlp-main.550/ • Liu et al., Lost in the Middle, TACL 2024:https://aclanthology.org/2024.tacl-1.9.pdf • Jiang et al., LongRAG, EMNLP 2024:https://aclanthology.org/2024.emnlp-main.1259/ • Pirolli & Card, Information Foraging:https://doi.org/10.1037/0033-2956.106.4.643