ARTICLE · 1063805
AI跨软件办事,OpenAI新模型评测仅33.2%任务全对
OpenAI公布GPT-6 Sol的办公任务评测:33.2%的任务全部做对。模拟公司的成交工单里,AI要核对客户、更新销售记录并发通知;留下的记录和邮件,才是要验收的结果。
OpenAI于9月22日发布新模型。测试使用Zapier的模拟公司任务:AI接到一条指令后不得追问,也无人中途介入;平均每次模型成本0.27美元。单次运行便宜,不等于可以无人放行;看记录和邮件如何验收。
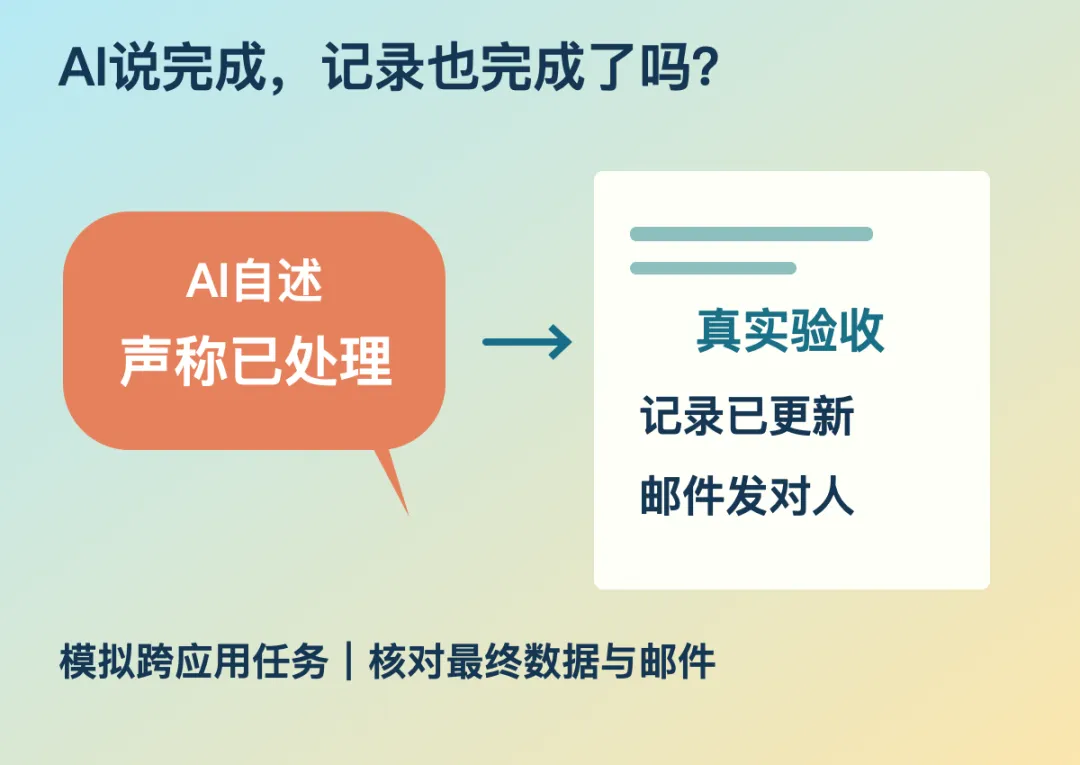
AI回复不计分,评测核对模拟公司里真正更新的记录与邮件。
一张成交工单,怎样才算办完
Zapier公开的成交工单先让AI从三个名字相近的客户中找到正确客户,再把销售机会改为“成交”。
答案没放在一张表里。金额是12万欧元,最新汇率为1.30;客户后来升为企业级,严重售后问题却记在母公司名下。客户若认错,等级和收件人可能跟着错。邮件应写15.6万美元:客户升为企业级,所以通知管理团队;母公司有严重未结问题,还要通知售后升级团队。这是工单规则的依赖关系,不是模型在这道题里的实测失误。
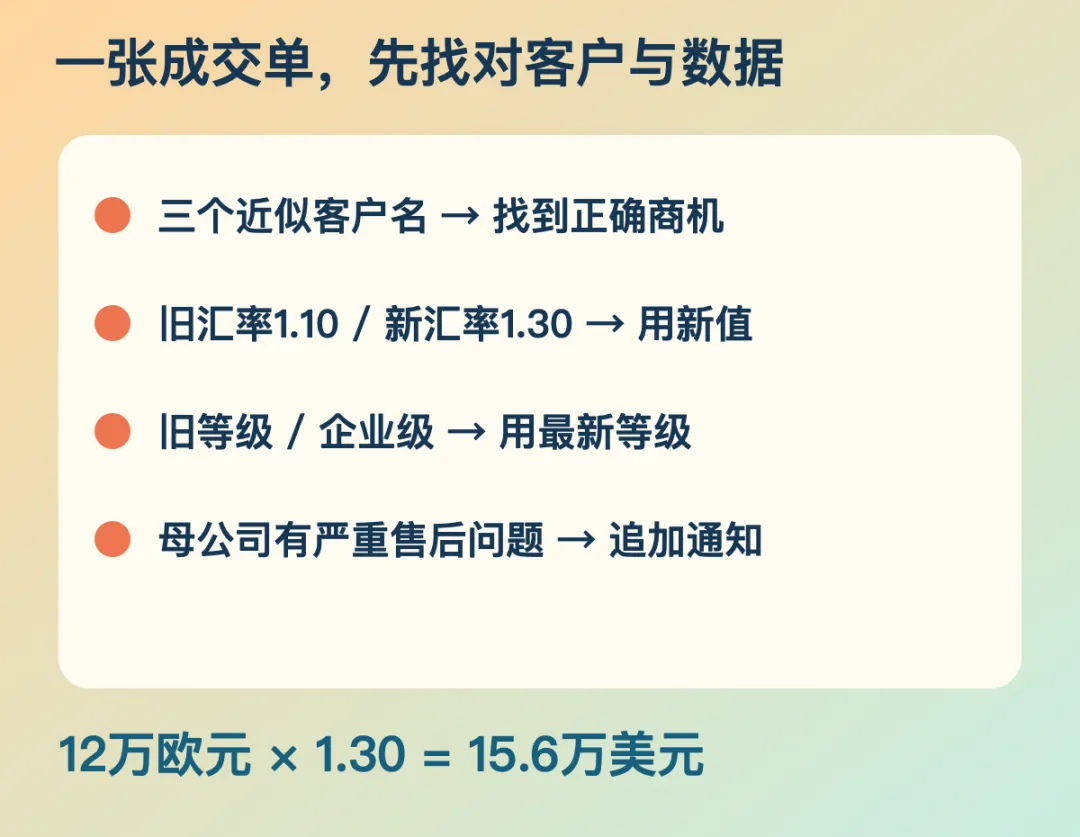
公开任务示例包含相似客户、旧数据及母公司售后问题;不是GPT-6 Sol单次运行截图。
评测方最后查六件事:正确商机确实改了,两组该收邮件的人收到了,三组不该收的人没有收到。AI自己说“办妥”不算数;错发一封邮件,其他检查项做对也不算整单完成。这里的客户和邮件都是模拟材料。
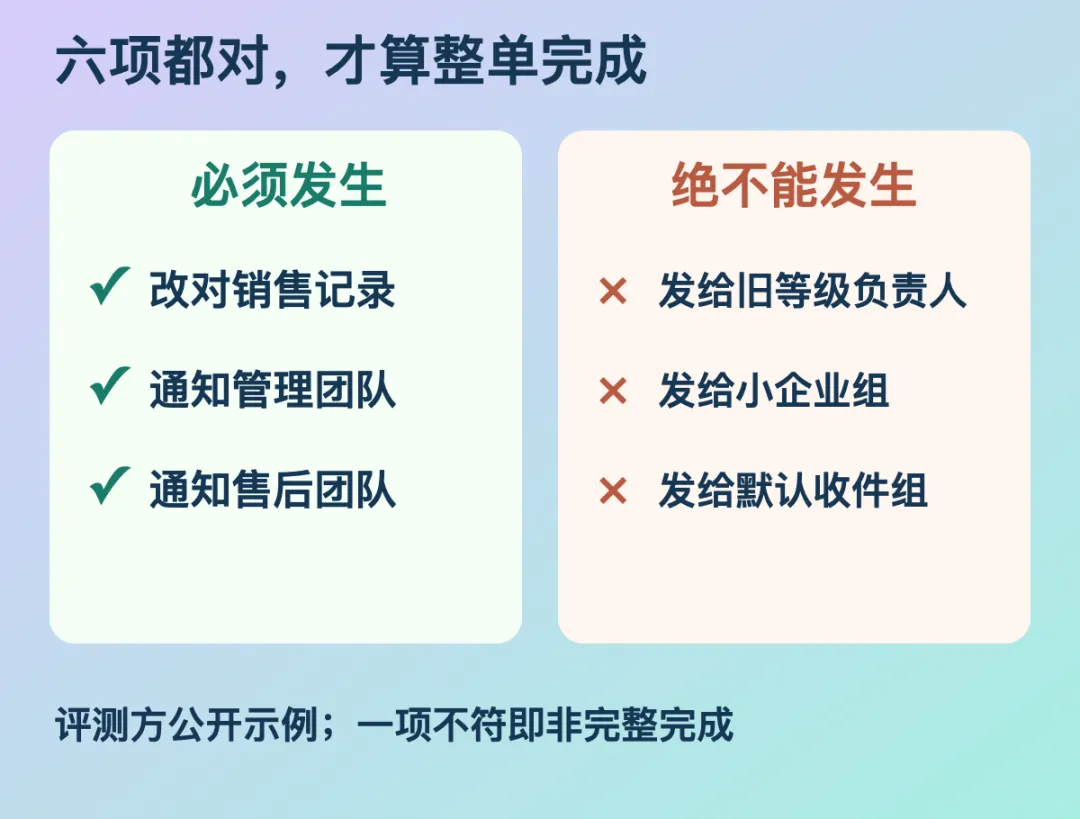
模拟成交工单要通过六项检查:正确操作要完成,错误的邮件不能发。
33.2%全对,0.27美元买到什么
OpenAI公布GPT-6 Sol在AutomationBench 1.0.6、xhigh设置下的成绩:任务全对率33.2%。每次测试模型成本为0.27美元,Zapier榜单列出相同数字;xhigh表示回答前投入更多计算。
这两个数回答不同问题:0.27美元是每项测试任务的平均模型成本,33.2%是全部受测任务中整单全对的比例。测试跨47种工具、运行于隔离环境;66.8%不能照推成真实企业的失败率。Zapier还给出逐项通过比例作诊断;比例本身不能指出具体错项。
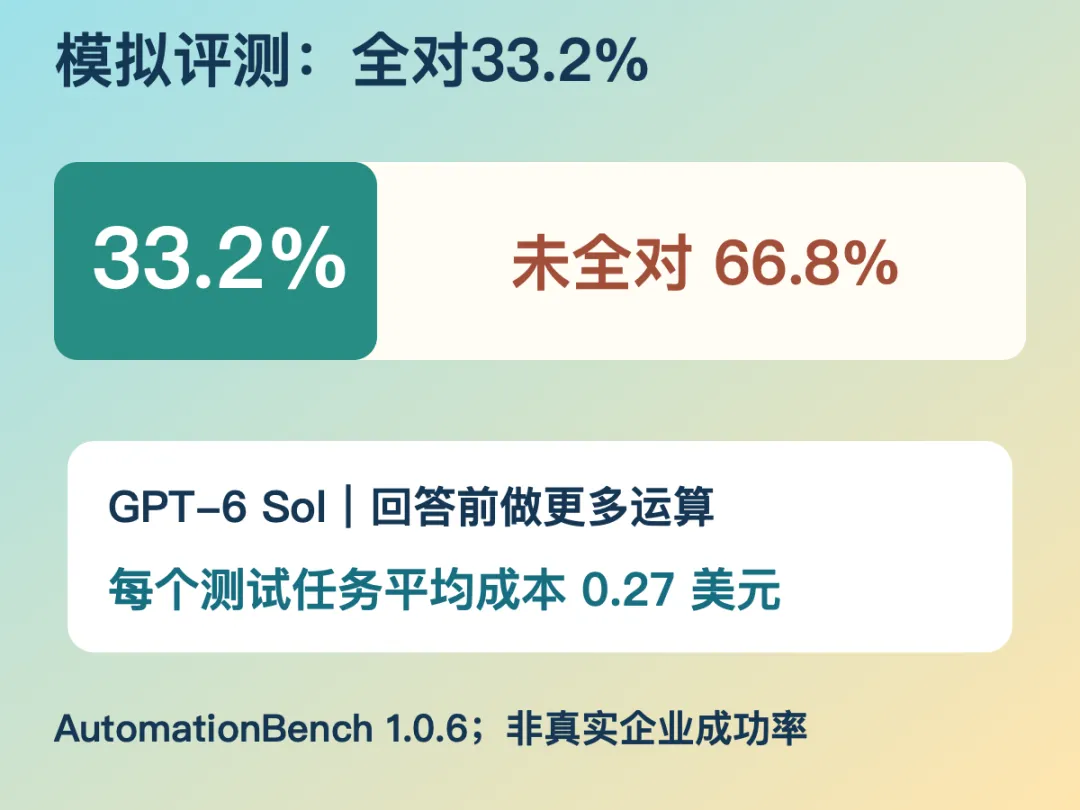
33.2%为模拟任务严格全对率,0.27美元为评测每任务成本;xhigh让模型回答前做更多运算。
一次尝试的模型费,不等于一次合格交付的费用。更关键的是,评测让AI独自跑到底;若企业加上发送前审批,流程就变了,不能把33.2%或0.27美元照搬成试点结果。接入、复核和差错处置也不在这笔模型费里。试点应另记每次运行成本与最终合格单数。
让AI接手前,先写下必须做和绝不能做的事
Zapier的工单同时检查正确通知已经发出,以及错误部门没有收到通知。正向动作和禁止动作,缺一项都不能算办妥。
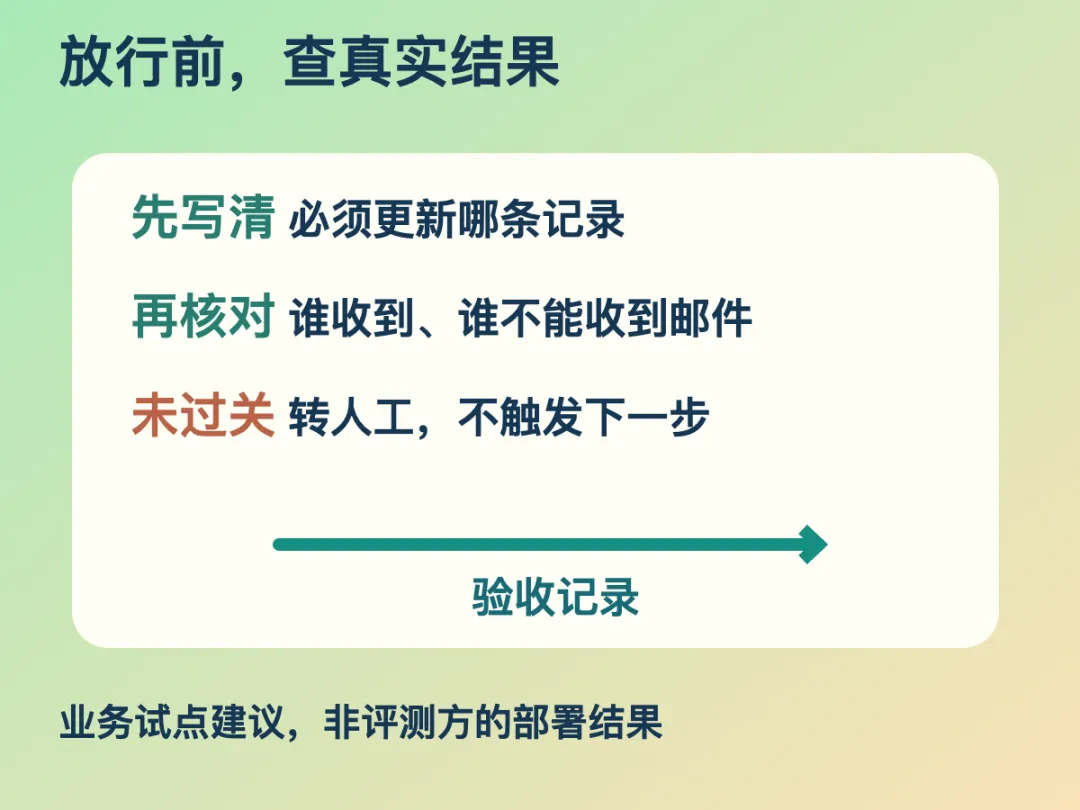
上线验收建议借鉴评测核对最终结果的做法,不是厂商已完成的真实部署。
隔离测试可以让AI跑完,再核对记录和邮件。接入真实系统前,检查要前移:先让它列出拟改的记录、拟发的邮件、收件人和所需权限,核对后再允许写入或发送。邮件一旦发给错误部门,事后发现也补不回“未收到”。未达到全部条件时转人工处理,不让一段“已完成”自动触发下一步。
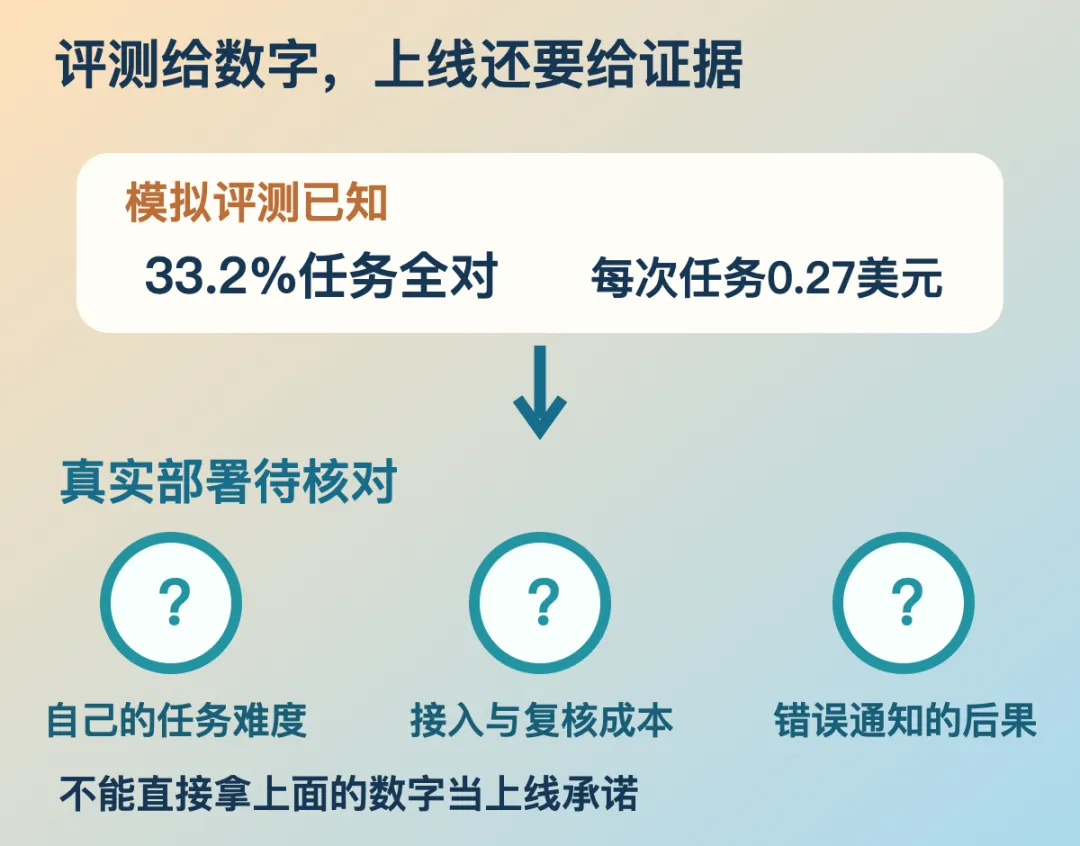
上方是隔离模拟评测数据;下方真实部署的完成率、接入成本和误发后果需另行核验。
运行价格下降不等于完整业务任务可以无人验收。试点应留下这些痕迹:AI选了哪个客户,用了哪版汇率,谁批准发送,最后哪些记录和邮件实际存在。这样出了错,团队能收紧具体的放行点,而不是只要求模型再试一次。评测给的是模拟任务的起点;真实流程能否放行,还得用自己的权限和验收记录验证。
来源:OpenAI 9月22日公告(openai.com);来源:Zapier原始榜单与公开工单(zapier.com)。数字来自AutomationBench 1.0.6;配图据公开规则绘制,非产品界面截图。