ARTICLE · 1065520
Jev:一个不写文章、只替软件做判断的 AI 模型
01|Jev 到底是什么?
TypeSafe AI 在官方介绍中把 Jev 称为第一个 System One Model。
这里的 System One,不是“系统一号”的产品编号,而是借用了心理学里“快速、直觉判断”的概念。对应到软件里,就是那些不需要写一篇解释,只需要尽快给出明确结果的任务。
比如:
这封邮件是不是售后问题? 这个用户的问题应该交给哪个客服队列? 这条内容的风险等级是低、中,还是高? 这个工具调用要不要继续? 这条线索值不值得进入下一步流程?
传统大模型当然也能做这些事。但它通常返回的是一段文字,程序还要从文字里解析出“售后”“高风险”“继续”这些结果。
Jev 的思路是:问题的答案形状先由开发者定义,模型只负责在这个范围里做判断。
你给它一段状态,再给它一个明确的问题,它返回的是选择、评分或是非概率,而不是一段自由发挥的说明。
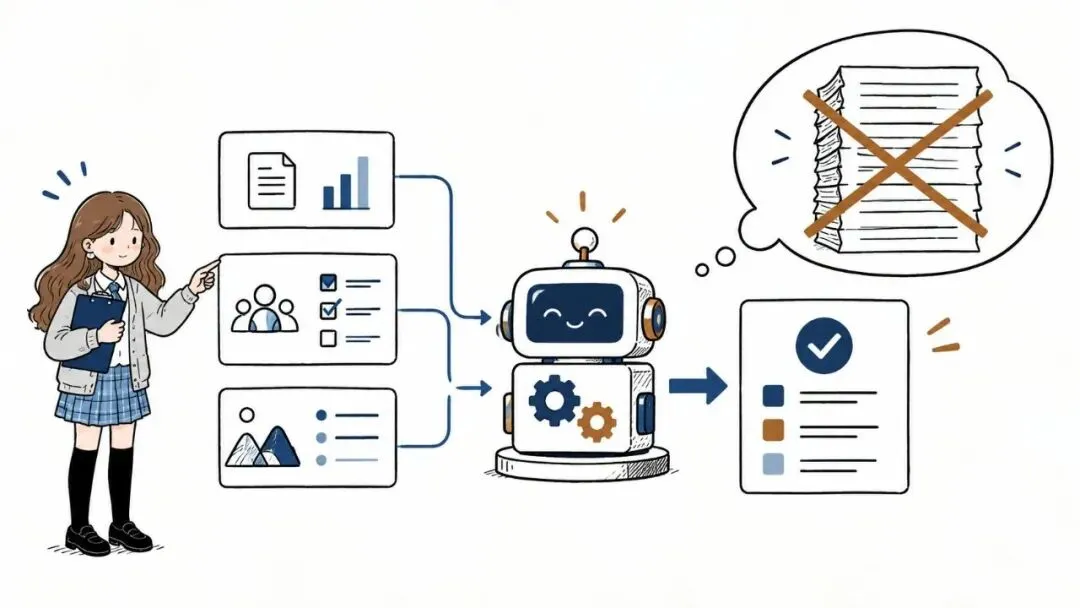
Jev 的定位:不生成长文本,而是给软件返回结构化判断
● ● ●
02|它不写文章,反而是它的优点
很多人第一次听到 Jev,会下意识问:它能不能写得像某某大模型一样好?
这个问题问偏了。
Jev 本来就不是拿来写文章的。TypeSafe AI 的官方说明明确表示,它放弃了自由文本生成,重点放在结构化决策上。也就是说,如果你需要一篇公众号文章、一段解释、一份方案,还是应该用生成式大模型。
Jev 更像是工作流里的一个判断节点。
举个例子。一个客服系统收到一封邮件,完整流程可能是:
- 01
读取邮件内容; - 02
判断是不是售后问题; - 03
判断紧急程度; - 04
决定进入哪个队列; - 05
只有需要回复时,才调用大模型生成文字。
以前,可能每一步都交给同一个大模型。Jev 的位置,是把第 2、3、4 步先接过来。
这样做的好处,不是让所有事情都变快,而是让不需要文采的判断,不必付出生成长文本的成本。
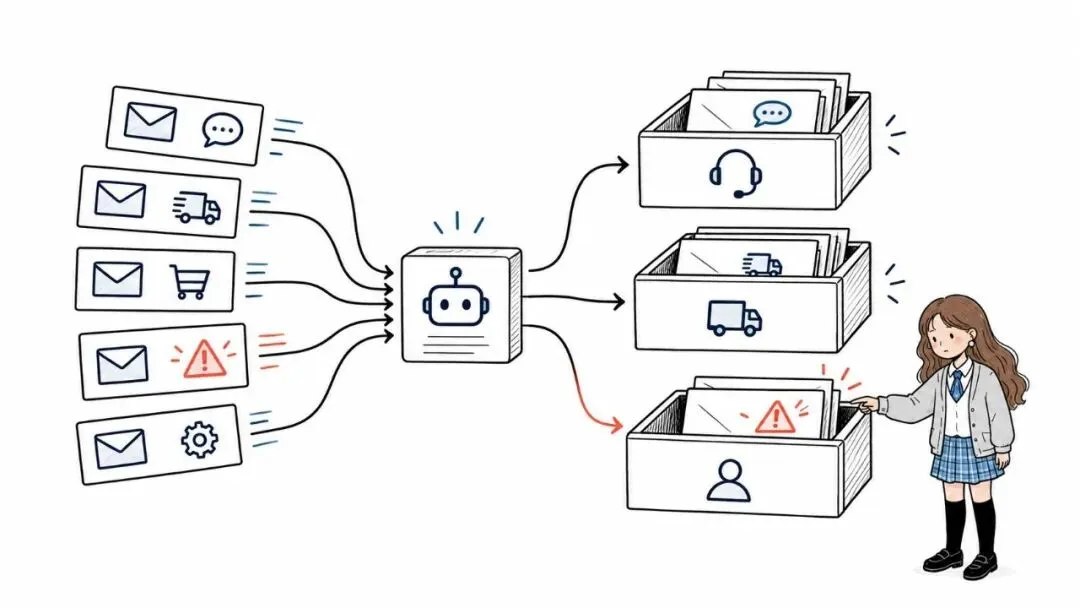
邮件分类案例:先判断,再把任务分到正确的队列
● ● ●
03|Jev 主要做三类判断
根据 TypeSafe AI 的公开介绍,Jev 目前围绕三种基本问题工作。
Choice:从几个选项里选一个
比如把客服邮件分到“售后、退款、物流、其他”中的一个类别。
开发者先定义选项,模型返回选择结果以及对应的概率信息。程序拿到结果后,可以直接进入下一步,不用再猜它那段话到底是什么意思。
Score:按规则打分
比如给一条线索做意向评分,或者判断一份材料的完整程度。
重点不是“打出一个看起来很精确的分数”,而是让评分标准提前写清楚,并且在不同样本上保持相对稳定。
Noul:回答是或不是
这是最像开关的一类判断:是否包含敏感内容,是否值得升级人工,是否满足进入下一步的条件。
但要注意,Jev 返回的概率或置信度,不等于事实正确率。一个模型可以非常确定地判断错,所以开发者仍然要设置阈值、人工复核和失败兜底。
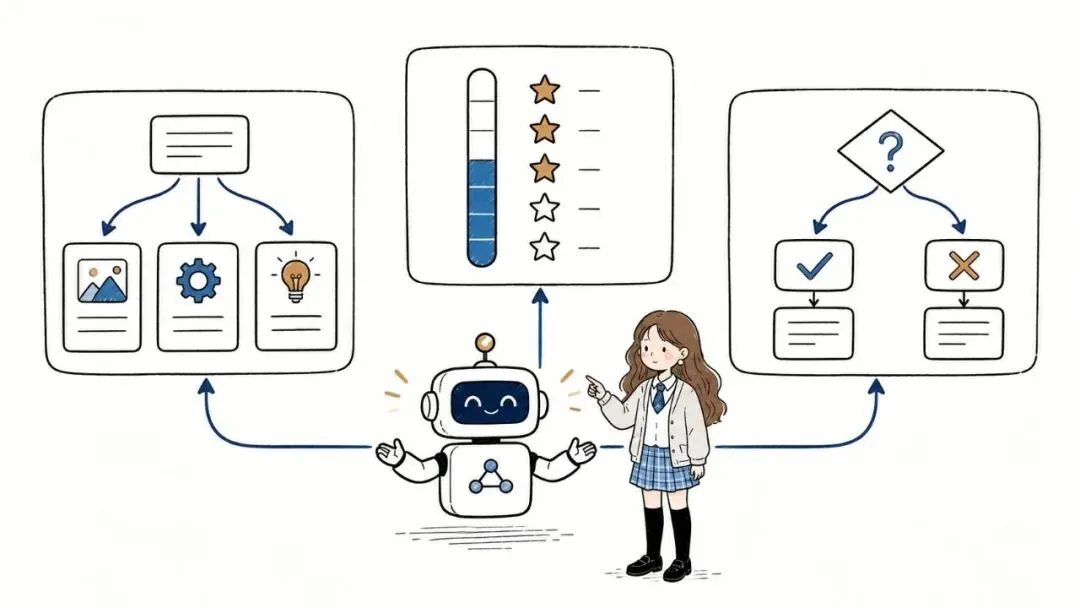
Choice、Score、Noul:把开放式回答变成可执行的判断类型
● ● ●
04|官方说它快很多,但数字要看清楚
TypeSafe AI 官网目前展示了两组醒目的数据:在它公布的 System One 工作流评测中,Jev 的速度最高可达到约 193.6 倍,成本约低 444.6 倍。
这两组数字可以引用,但必须把限定条件一起带上:它们是 TypeSafe AI 自己发布的评测结果,针对的是特定工作流和任务类型,不代表所有场景都能得到同样的提升。
换句话说,这不是“Jev 永远比所有大模型快 193.6 倍”,而是:在适合它的结构化判断任务里,官方评测显示出非常大的速度和成本差异。
价格也不要只看宣传图。官方主页目前写的是每十亿输入 Token 42 美元,并展示了约 0.000081 美元的单次成本示例;具体账单还取决于输入量、调用方式、早期访问政策和第三方网关加价。
所以更稳妥的写法是“官方评测称”,而不是“实测就是”。本文没有进行 Jev API 的独立压测。
官方评测数字:速度和成本有吸引力,但要看评测范围
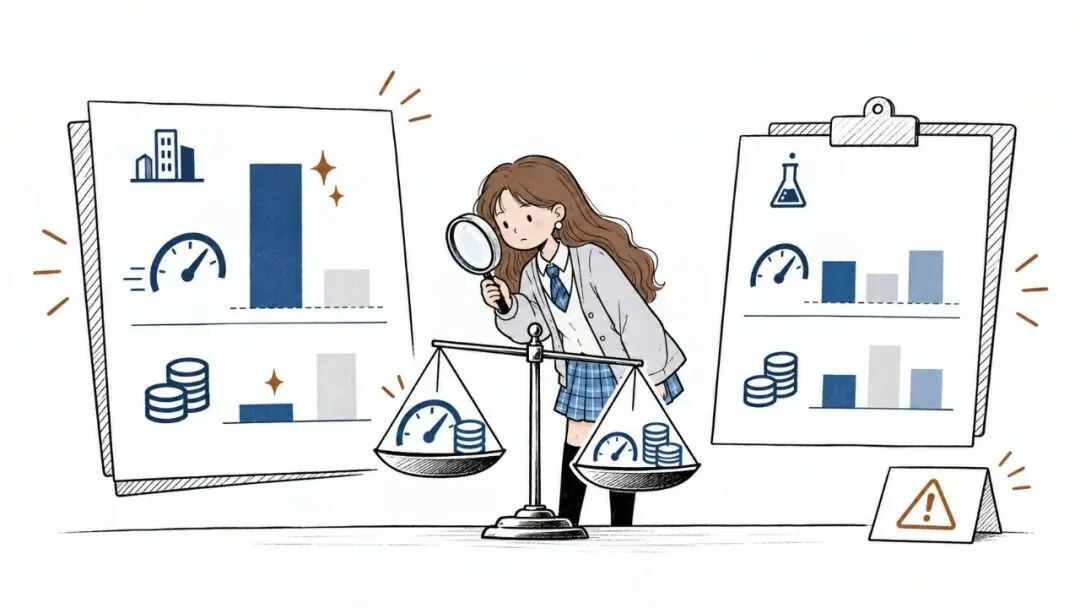
看懂评测数据:官方结果和独立验证要分开
● ● ●
05|它最适合放在 AI 工作流的哪里?
Jev 不太像一个单独面对用户的聊天窗口,更像藏在软件里的一个判断层。
一个比较清楚的组合方式是:
生成式大模型负责理解、规划和写作;Jev 负责路由、筛选、评分和拦截。
比如做一个内容审核流程:
大模型先理解内容语义; Jev 判断风险等级和是否需要升级; 低风险内容自动进入下一步; 高风险内容转人工复核; 需要解释时,再调用大模型生成说明。
这样分工的好处,是不用让一个模型承担所有工作。能用规则解决的,交给规则;需要快速判断的,交给决策模型;需要长文本和复杂推理的,再交给生成式模型。
这比“所有问题都扔给一个超级模型”更像工程,而不是更换一个聊天窗口。
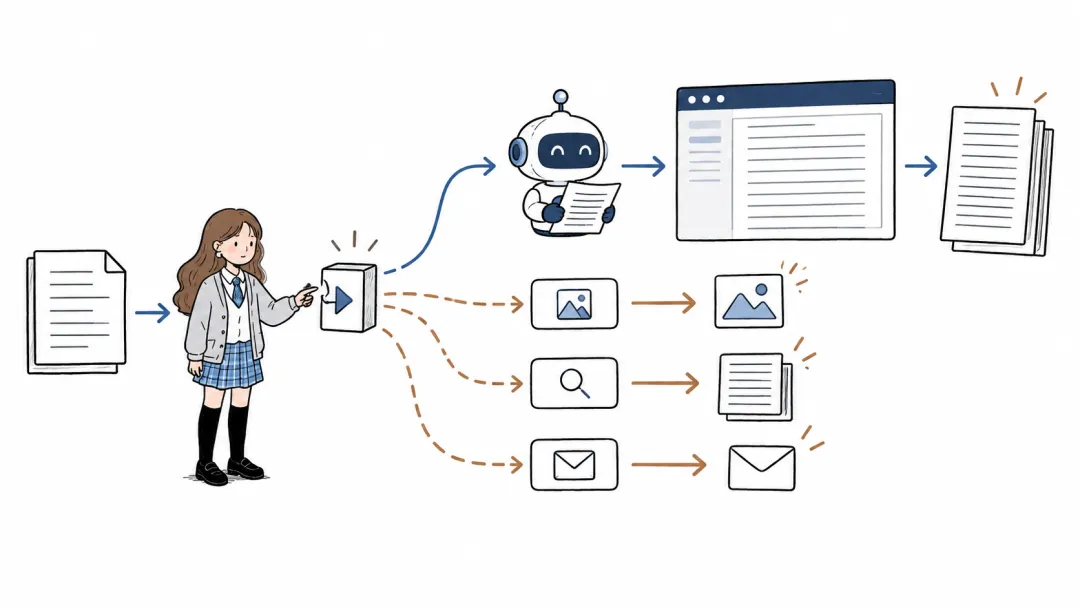
Jev 在工作流中的位置:先判断是否需要,再调用更重的生成模型
● ● ●
06|它也不是“不会出错”的神奇模型
关于 Jev,最容易被误读的一句话是“它不会幻觉”。
更准确的理解是:它的输出格式被限制在开发者定义的类型里,不会随意生成一段不符合格式的长文本。但这不代表它对现实世界的判断永远正确。
比如你让它判断一封邮件是不是诈骗,它仍然可能判断错;你让它给一条线索打分,分数也不等于真实转化率。
真正接入生产环境前,至少要做四件事:
用固定样本测试准确率和稳定性; 给低置信度结果设置人工复核; 对高风险动作设置硬性拦截; 记录每次判断,方便之后回看和改进。
另外,Jev 目前是 API 服务,不是一个下载到电脑里就能离线运行的开源模型。需要用它,通常要申请访问权限或通过支持的网关接入。具体开放状态以TypeSafe AI 官方网站和官方文档为准。
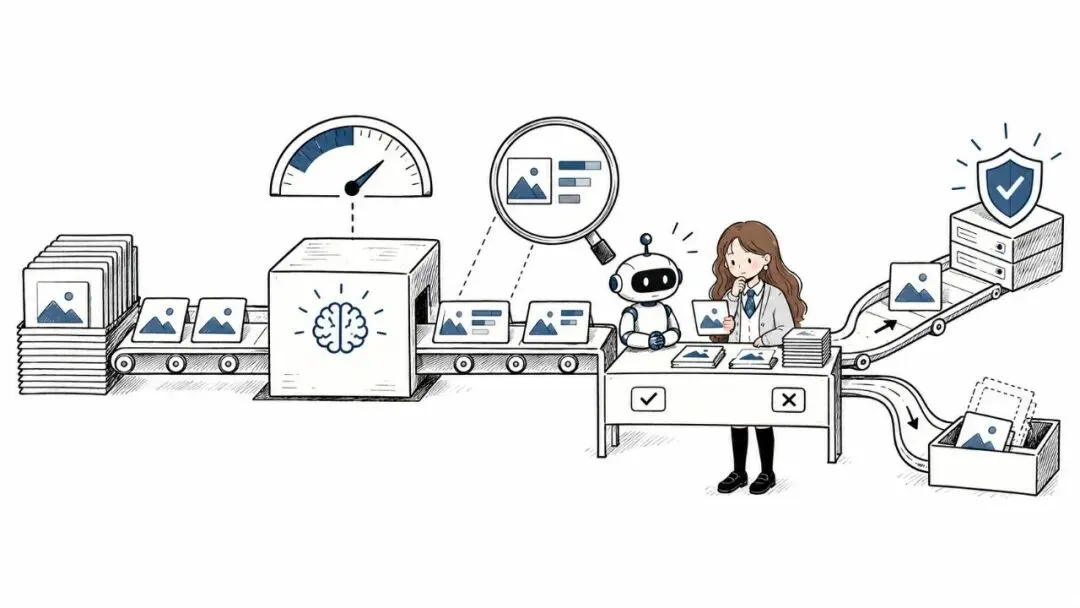
上线前的安全检查:置信度、人工复核和失败兜底缺一不可
● ● ●
写在最后:AI 可能会先从“做判断”开始变便宜
过去我们讨论 AI,注意力总在几个大问题上:它能不能写得更像人,能不能看懂更长的材料,能不能完成更复杂的推理。
Jev 提醒了另一条路线:AI 也可以不负责表达,只负责在软件里快速判断。
它不一定更聪明,也不一定适合所有任务。但当一次判断的成本足够低,程序就会愿意把更多小决定交给 AI:邮件要不要升级、内容要不要拦截、模型要不要继续调用、用户要不要进入下一步流程。
这可能才是 System One 的真正价值。
不是让 AI 写出更多字,而是让软件敢于调用它做更多次判断。
判断变便宜之后:更多小决定可以被 AI 接住
资料来源
- 01
TypeSafe AI 官方:Introducing System One Models & Jev - 02
TypeSafe AI 官方主页:System One Models 与公开数据 - 03
Jev 官方产品说明页
注:本文根据 TypeSafe AI 截至 2026 年 9 月 22 日公开信息整理。速度、成本和价格数字均为官方公开数据,未进行独立压测;具体访问资格、价格和 API 能力以官方页面为准。