ARTICLE · 1070406
让互联成为 AI 的第二引擎 ——恒瀚微电子亮相 2026 全球 AI 芯片峰会
让互联成为 AI 的第二引擎 ——恒瀚微电子亮相 2026 全球 AI 芯片峰会

9 月 20 日至 21 日,2026 全球 AI 芯片峰会(GACS 2026)在上海中星铂尔曼大酒店举行。本届峰会以「芯路求索,聚力致远」为主题,由智东西发起、智猩猩主办、芯东西协办,汇聚了来自高校、大厂与国产芯片公司的 60 余位重磅嘉宾,围绕大模型 AI 芯片、Agent 推理芯片、具身智能芯片三大高峰论坛,以及超节点、Token 工厂异构混训混推、AI 芯片架构创新、新型存储器、大模型 KV Cache 五场闭门技术研讨会,全景透视从 TOPS 到 Token 的 AI 算力关键链路。 恒瀚微电子受邀参会,不仅携自研 RDMA 智能网卡产品方案亮相展览区,公司高级产品总监张自渊还在 9 月 21 日全天举行的超节点技术研讨会上,发表了题为《下一代 AI 超节点互联:Scale-up Fabric 与 RDMA SuperNIC 的协同架构》的主题演讲,并参与圆桌 Panel 环节交流。 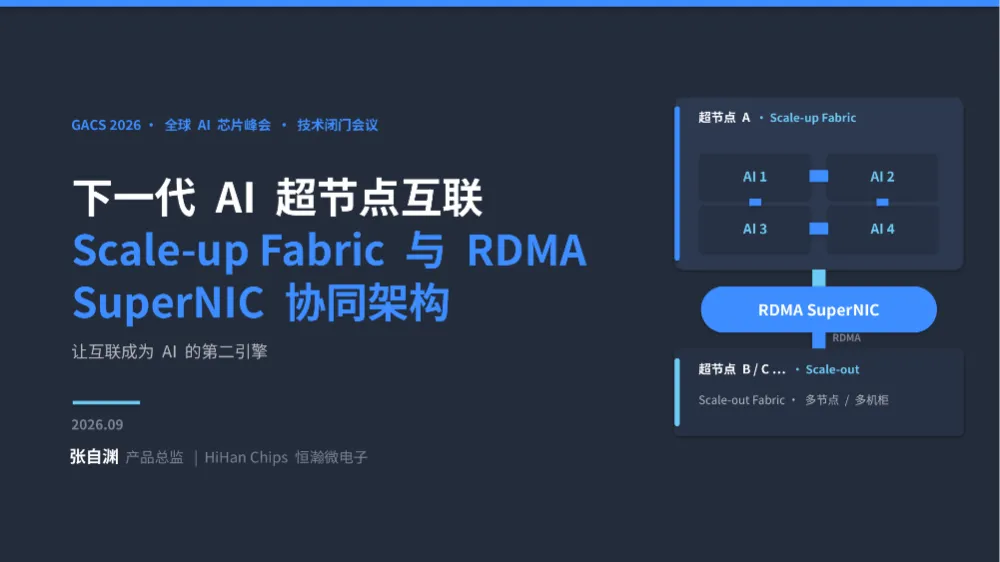
2026 全球 AI 芯片峰会·超节点技术研讨会(张自渊演讲首页) 
「超节点量产元年」,互联成为第二战场 01 2026 年被业界称为「超节点量产元年」。从年初到 WAIC 2026,昇腾、沐曦、摩尔线程等国产算力厂商的超节点密集落地,算力竞争的主线已从单芯片的跑分比拼,转向整机、集群、软硬件一体化的系统能力较量。业界测算,到 2028 年国产超节点市场规模有望达到 3400 亿元级别。 在这样的背景下,作为五场闭门研讨会中唯一全天的场次,超节点技术研讨会汇聚了新华三、华为云、南京大学、上海人工智能实验室、北京大学以及恒瀚微电子等 12 位产学研嘉宾,围绕超节点全栈协同架构、Scale-up 互联、智能网卡、通信库、NPO、OCS 等核心议题展开研讨。 
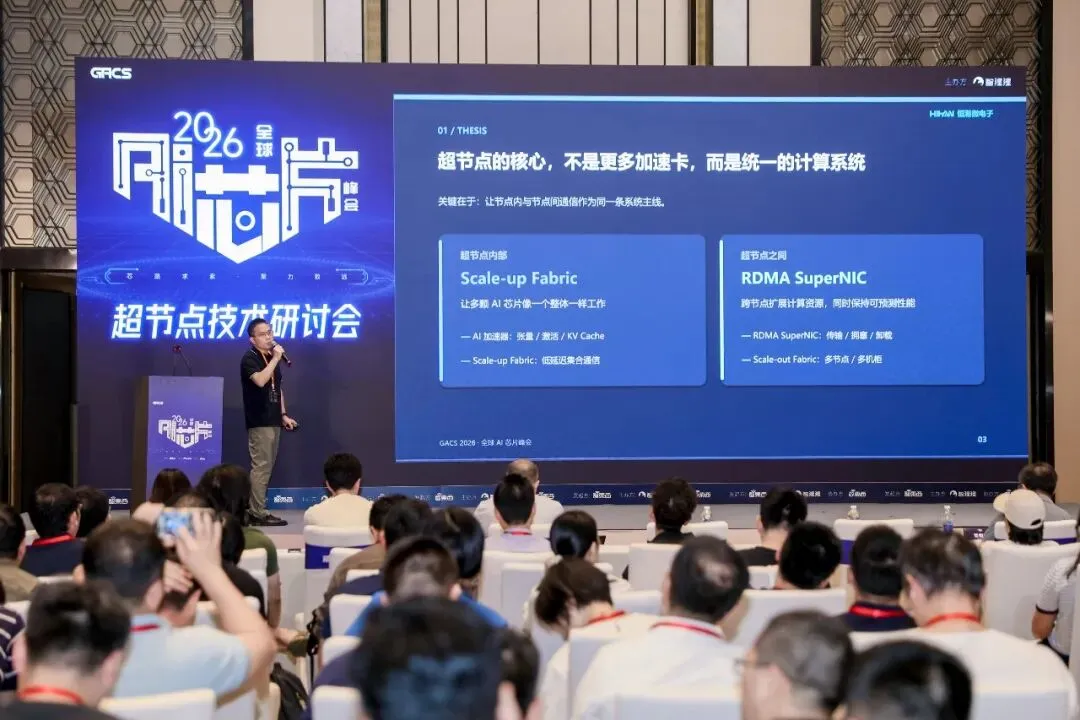
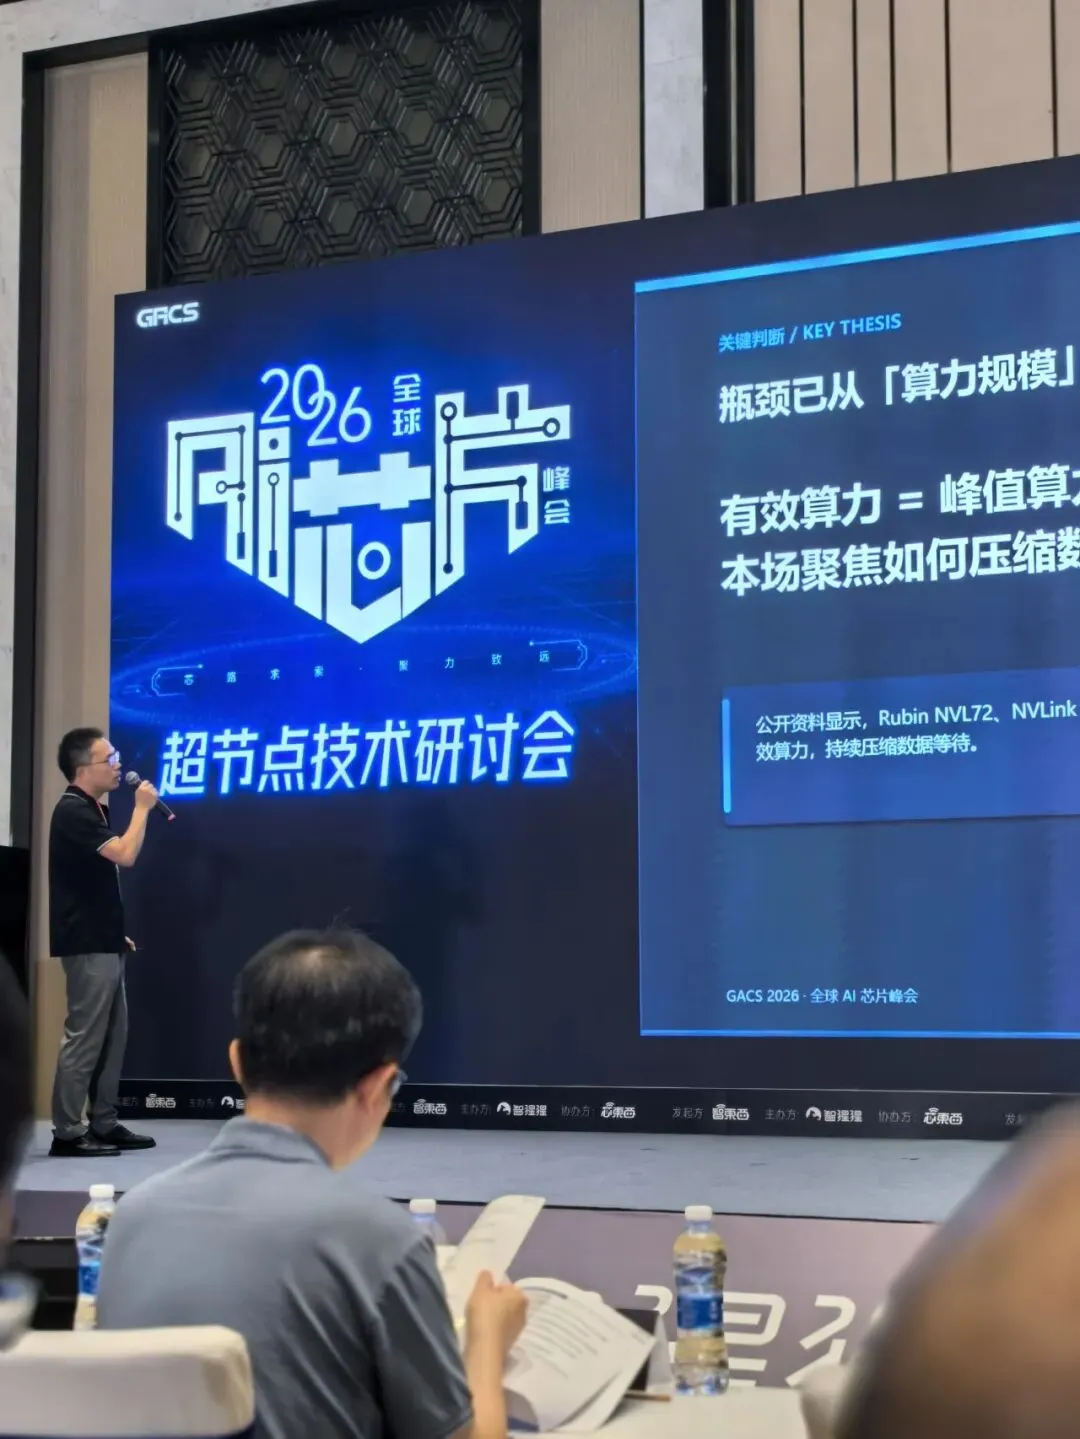
张自渊受邀出席超节点技术研讨会并发表演讲 张自渊现任恒瀚微电子高级产品总监,拥有近二十年芯片研发与管理经验。他曾在中兴微电子/中兴通讯任职十四年,历任 IC 数字专家级工程师、交换领域 COP/APO 及网络处理器芯片项目经理,主导 640G 网络处理器芯片项目,带领峰值 300 人的团队完成从需求定义到芯片流片的完整闭环,深耕 IC 前端设计十余年,先后主导多颗大型芯片的交换子系统研发。 
核心判断:瓶颈已从「算力规模」转向「互联架构」 02 演讲伊始,张自渊给出了一个直指行业痛点的判断:随着模型规模走向万亿参数、训练集群走向万卡乃至十万卡,瓶颈已经从「算力规模」转向「互联架构」——有效算力 = 峰值算力 − 数据等待。当大量 GPU 在等待数据同步,花重金采购的算力就被通信开销「吃掉」了。演讲聚焦的,正是如何持续压缩这段「数据等待」,把峰值算力转化为有效算力。 
超节点的核心,不是更多加速卡,而是统一的计算系统 03 在张自渊看来,超节点的核心不是把更多加速卡堆在一起,而是构建一个统一的计算系统:让节点内与节点间通信成为同一条系统主线。 超节点内部——Scale-up Fabric:让多颗 AI 芯片像一个整体一样工作,承担张量、激活、KV Cache 等低延迟集合通信; 超节点之间——RDMA SuperNIC:跨节点扩展计算资源,同时保持可预测的性能,承担传输、拥塞控制与卸载。 以大模型训练中最典型的跨节点 All-Reduce 为例,恒瀚微提出把大流量数据留在最适合处理它的层级:本地切分 → 节点内汇聚 → 跨节点交换 → 本地分发。同一份拓扑、同一套通信语义、同一个性能目标,减少复制次数、缩短同步路径、提高有效吞吐。 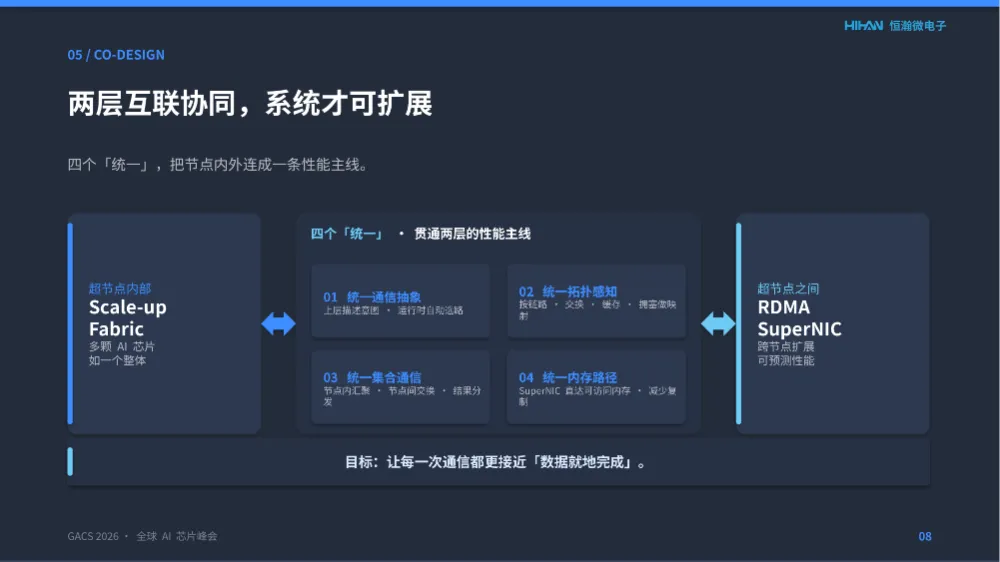
两层互联协同:四个「统一」贯通性能主线 要让两层互联真正协同,张自渊提出了四个「统一」:统一通信抽象(上层描述意图,运行时自动选路)、统一拓扑感知(按链路、交换、缓存、拥塞做映射)、统一集合通信(节点内汇聚、节点间交换、结果分发)、统一内存路径(SuperNIC 直达可访问内存,减少复制)。目标只有一个——让每一次通信都更接近「数据就地完成」。 
互联芯片:从连接设备走向「通信处理器」 04 另一个值得关注的观点是互联芯片的定位之变。张自渊认为,下一代互联芯片不只是提供端口和带宽,而是要深度参与感知、决策、执行与反馈——通过队列、拓扑、拥塞、故障的实时感知,做出路径、优先级与传输窗口的决策,再由 DMA、RDMA 与集合通信卸载执行,并以遥测、限速、重路由形成闭环。互联芯片正在从「连接设备」走向面向 AI 资源调度的「通信处理器」,进入 AI 系统的性能闭环。 这一判断直指万卡系统的真实痛点:同步完成时间由最慢的节点决定,当最慢一条路径拖住同步点,平均性能就失去了意义。SuperNIC 的价值,正在于把拥塞控制、流量整形、故障绕行与遥测前移到硬件路径。 
产品落地:汇川 400 测试完成,Hi1600 排队中 05 支撑这一架构理念的是恒瀚微电子的两款自研产品: 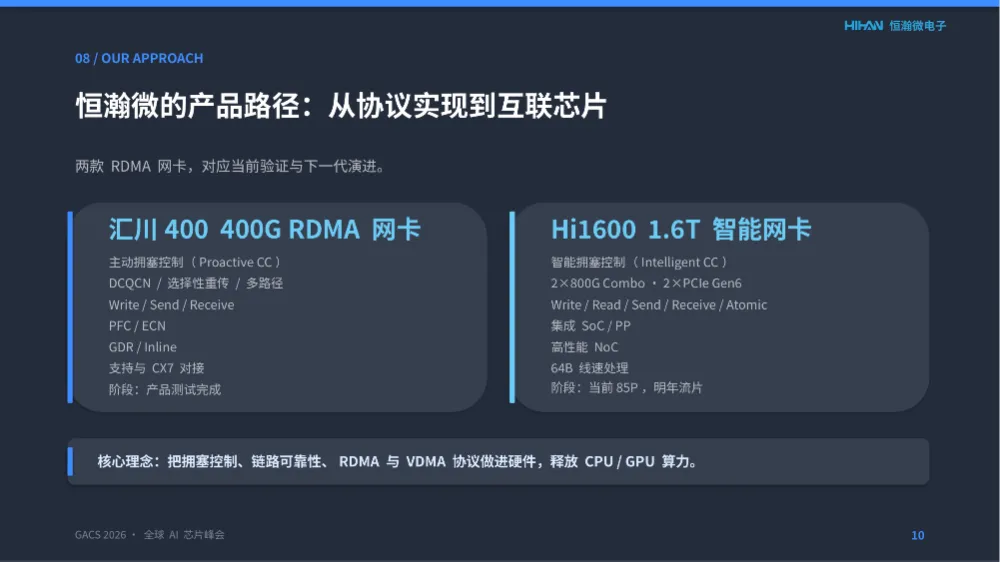
恒瀚微产品路径:汇川 400 与 Hi1600 在拥塞控制这一 RDMA 网卡的「试金石」上,张自渊对比了被动式与主动式两种路线:传统 DCQCN/PFC/ECN 方案在拥塞发生后才由源端降速,反馈跨越 RTT、队列与尾延迟先上升;而主动式方案实时采集 RTT、队列深度与遥测信息,在拥塞形成前调节注入速率,控制闭环位于网卡硬件路径,以多路径与选择性重传兜底。 演讲分享了严格对齐口径的对比测试:4096B 报文、2:1 Incast(两打一)、QP 数 1→8190、开启主动拥塞控制,同拓扑、同主机配置、同负载、同软件栈,只更换网卡。在本测试配置下,汇川 400 双口聚合带宽稳定在 190+ Gbps,P99 延迟约为对比标杆产品的 1/3,且双口带宽保持公平。 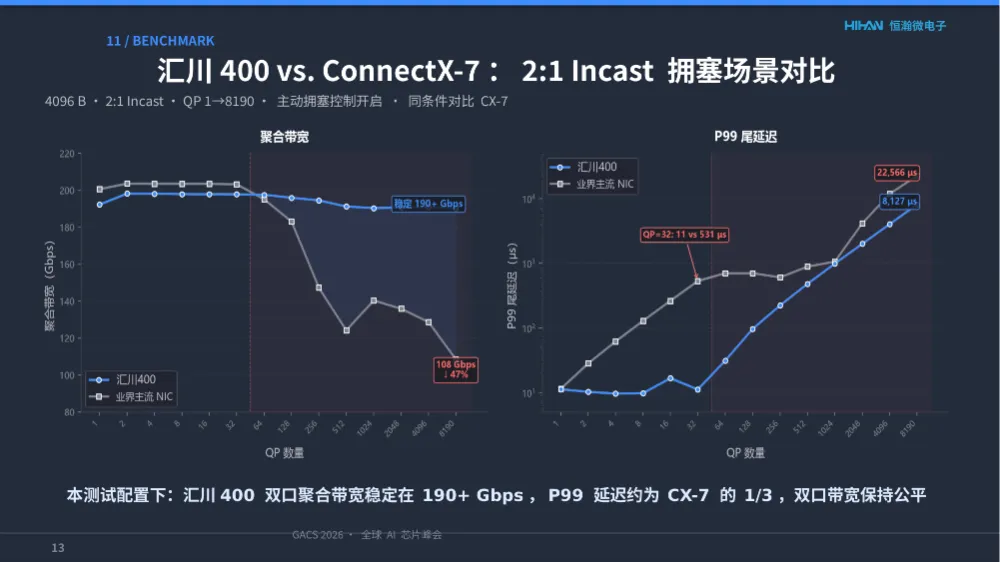
2:1 Incast 拥塞场景对比测试 
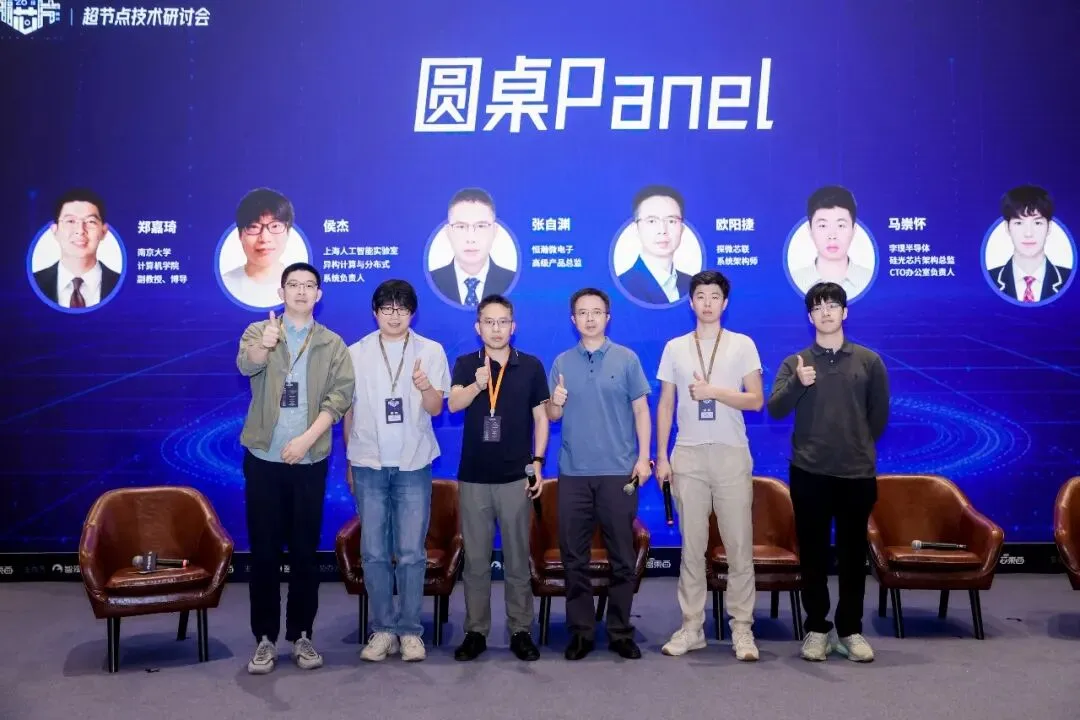
圆桌对话:与产学研同行共话超节点演进 06 主题演讲之后,张自渊还参与了研讨会下午场的圆桌 Panel,与南京大学、上海人工智能实验室、北京大学、探微芯联、光为科技、孛璞半导体等机构的专家学者同台交流,围绕 Scale-up 互联、光互连演进、国产超节点生态等话题分享了来自网卡与互联芯片一线的工程视角。 张自渊在总结中重申了恒瀚微电子的核心理念:下一代超节点的关键,不是更多芯片的集合,而是统一的计算系统。Scale-up Fabric 让超节点内部更加协同,RDMA SuperNIC 让超节点间高效扩展,协同架构让堆叠的算力真正转化为有效算力——让互联成为 AI 的第二引擎。 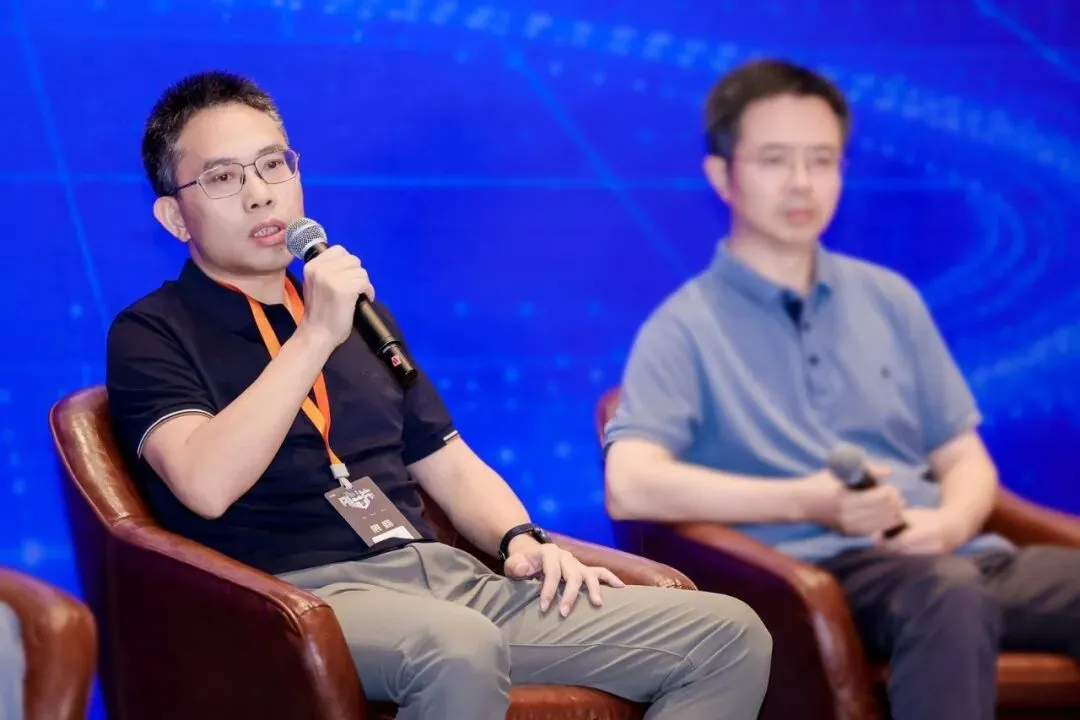

关于恒瀚微电子 07 成都恒瀚微电子有限公司(HiHan Chips)成立于 2024 年,是一家专注于 AI 智算网络互联芯片设计的硬科技企业,总部位于成都,在上海、南京设有研发中心。核心团队出自中兴微电子、华为海思、阿里巴巴、腾讯等头部科技企业,具备芯片架构设计、产品工程化及市场落地的完整能力。 公司聚焦 AI 算力集群的关键互联硬件——高性能 RDMA 智能网卡,坚持全栈自研的结构化 RDMA 架构与 Credit-based 主动拥塞控制路线。400G RDMA 智能网卡「汇川 400」已完成客户送样并斩获正式订单,1.6T 智能网卡 Hi1600 加速研发推进中。2026 年 8 月,公司宣布完成近亿元人民币天使轮融资,由国泰创投、成都科创投、成都高新创投、中信聚信联合投资。 恒瀚微电子,让互联成为 AI 的第二引擎。 
<< 滑动查看下一张图片 >>
汇川 400:400G RDMA 网卡——采用主动拥塞控制(Proactive CC),支持 DCQCN、选择性重传、多路径、GDR/Inline 等,可与业界主流网卡对接,目前产品测试已完成; Hi1600:1.6T 智能网卡——2×800G Combo 端口、2×PCIe Gen6,集成 SoC 与协处理器(PP),内置高性能 NoC,支持 64B 线速处理与智能拥塞控制,计划明年流片。
<< 滑动查看下一张图片 >>