ARTICLE · 1071799
还在手动啃英文 PDF?这个开源项目把「扫描版论文」也能保留排版翻译
还在手动啃英文 PDF?这个开源项目把"扫描版论文"也能保留排版翻译
江达小记 一个 2.3k Star 的国产开源工具:翻译之后,公式还在原位,版面还是原样,连扫描件都不放过。
💡 先问一个问题
你上一次为了读懂一篇英文 SCI 论文,是不是也经历过这样的流程:复制一段 → 丢进翻译软件 → 翻译结果里公式全乱了 → 对照原文找半天 → 最后干脆放弃?
更崩溃的是扫描版 PDF——那些根本没法选中的"图片型"文档。大多数翻译工具对它们束手无策,而你只能一页一页截图、慢慢啃。
今天要介绍的 RetainPDF,就是奔着这个痛点来的。
📚 项目简介
RetainPDF 是一个开源 PDF 翻译工具,核心主张只有一句话:翻译之后,版面还是原来的版面,公式还在原来的位置。
它目前是唯一面向图片型 / 扫描版 PDF、同时支持保留排版翻译的开源项目,官方表示其翻译与排版效果"对标甚至超过同类商业产品"。
⭐ 核心功能
✅ 保留排版翻译:自研字体排版算法,翻译后还原复杂公式与多栏论文的版式
🔧 扫描版 PDF 支持:图片型文档同样能翻译,还可顺带做 OCR 结构优化
⚡ 复杂行内公式"断层领先":翻译后公式本体、前后文关系、行内排版都稳定保留
🧩 代码保护:论文里的代码块不会被误翻
📊 表格控制:是否翻译表格,可开关
🎛️ 自定义翻译策略:可按规则配置
🔌 开放 API:支持自部署与二次开发,方便接入自动化流程
关键数据:⭐ 2311 Stars | 🍴 278 Forks | 👥 6 位贡献者 | 📅 最近更新于 2026 年 9 月
🎯 核心功能详解
1️⃣ 它不是"翻译文字",而是"重排版面"
普通翻译工具的处理方式是:把文字一段段抽出来翻译,再简单贴回去。结果就是——公式丢了、分栏乱了、图片位置飘了。
RetainPDF 的思路完全不同:它先理解 PDF 的版面结构(哪里是正文、哪里是公式、哪里是图注),翻译后再用自研的排版算法把内容重新摆回原位。
打个比方:别人是把书拆成一页页复印件重新装订,而它更像是拿到一份"排版图纸",翻译完照着图纸重新印刷。
2️⃣ 专治 PDF 翻译的"老大难"
官方特别强调了翻译系统对 PDF 特有难题的处理:
跨栏:双栏论文的段落不会串行
跨页:一句话被分成两页,也能正确接上
断句与段落续接:先把完整语义单元拼回来,再整体翻译
这一点很关键——先恢复完整语义,再翻译,而不是"逐框翻译"。后者最大的问题就是上下文割裂,翻译出来前言不搭后语。
3️⃣ 一套"阅读工作台",不只是翻译
除了翻译,它还把阅读体验做完整了:
📖 图书馆:论文、图书、扫描文档集中管理,一眼看到翻译状态
↔️ 原文译文对照:原 PDF 与译文同页并排,方便核对公式、图表和引用
📝 Markdown 阅读:PDF 与 Markdown 同屏,保留公式和图片
🤖 文档 AI 问答:围绕当前文档提问,回答附带页码和原文引用,需要改 PDF 还能切到 PDF Agent
【图1:项目图书馆界面截图】
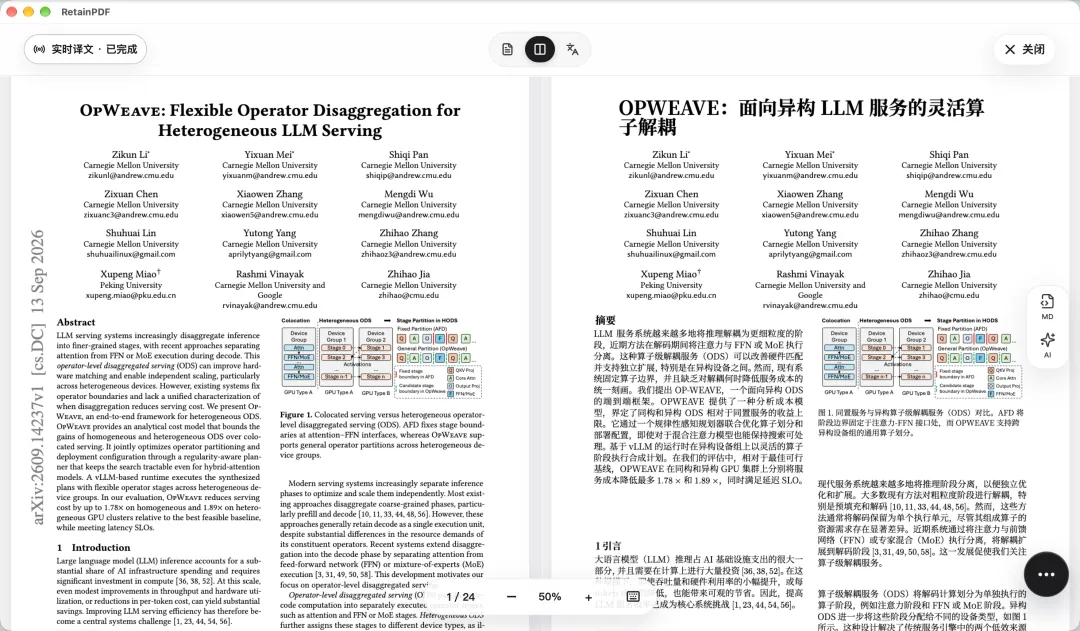
【图2:原文—译文对照阅读截图】
🚀 快速开始
方式一:下载桌面端(最省事)
从 GitHub Releases 下载对应版本即可:
Windows:Setup.exe
macOS:.dmg
Linux:.deb
江达小记 ⚠️ macOS 若提示应用"已损坏",把应用拖进 后执行:
方式二:Docker 部署(适合服务器/自建)
# 克隆仓库 git clone https://github.com/wxyhgk/retain-pdf.git cd retain-pdf/ops/deployment/docker/delivery # 一键启动 docker compose up -d 江达小记
启动后访问 http://127.0.0.1:40001 即可。
需要更新时:
docker compose pull docker compose up -d 江达小记
💡 技术亮点
架构:Python + Rust + TypeScript 三线并进
从语言构成就能看出这是个"认真的项目":
Python(约 7.5 MB):核心翻译与文档处理管线
Rust(约 3.7 MB):高性能后端 API / 计算密集环节
TypeScript + JavaScript(合计约 6 MB):前端阅读器与交互界面
Typst:用于排版还原的排版引擎
仓库里还带了完整的 CI 体系(tests.yml、release-desktop.yml、release-docker.yml、translation-replay.yml)、Docker 交付目录,以及一份 CONTRIBUTING.md——工程化程度相当高,不是那种"能跑就行"的个人脚本。
设计思路:先语义、后翻译
文章开头提到的"跨栏、跨页、断句"问题,本质是同一个设计决策:
江达小记 不要按"版面框"去翻译,而要按"语义单元"去翻译。
先把散落在不同栏、不同页的文字还原成完整的句子和段落,再送去翻译模型。这一步做好了,翻译质量会有质的差别。官方把这条路线称为"自研翻译系统",是针对 PDF 场景专门设计的。
⚖️ 横向对比
官方给出了一张与同类工具的对比表,颇具参考价值:
| RetainPDF | 强 |
一句话总结差异:扫描件 + 行内公式 + 开源开放 API,这三样同时满足的,目前就它一个。
✅ 优缺点分析
优点:
🎯 定位精准:直击"扫描版 PDF + 公式"这个最难啃的场景
🖥️ 交付完整:桌面端、Docker、开放 API 都给齐了,上手门槛低
🧱 工程扎实:多语言架构 + 完善 CI + 详细文档(中/英/越南语三语 README)
🔓 MIT 协议:可自部署、可二次开发,不用担心被"锁死"
注意事项:
⚠️ 仍较年轻:仓库 2026 年 3 月才创建,迭代很快(版本已到 v4.2.5),需要做好跟进更新的心理准备
⚠️ 贡献者集中:975 次提交来自主作者一人,社区共建还在早期阶段
⚠️ 偶发问题:Issue 区可见翻译阶段失败、断点重试受阻等反馈,重度使用建议先小范围试用
⚠️ 依赖翻译模型:翻译质量仍受所接入的模型(如 DeepSeek)影响,需自行配置
🎯 总结
RetainPDF 的价值,可以用一句话概括:
江达小记 它把"翻译 PDF"这件事,从"翻文字"升级成了"保留原貌的重排"。
对科研人员、研究生和技术文档阅读者来说,这意味着看英文论文这件事,终于可以从"复制粘贴猜公式"里解放出来。而对开发者来说,开放的 API 和 MIT 协议,让它有潜力成为自动化文档处理流水线里的一块积木。
如果你也在被扫描版 PDF 折磨,不妨去 Star 一下,顺手提个 Issue——这类工具最需要的就是真实场景的反馈。
💬 互动环节:你平时翻译英文论文都用什么工具?有没有被公式和排版坑过?欢迎在评论区聊聊~
🔗 相关链接:
GitHub:https://github.com/wxyhgk/retain-pdf
最新版本:https://github.com/wxyhgk/retain-pdf/releases
Docker 部署说明:https://github.com/wxyhgk/retain-pdf/blob/main/ops/deployment/docker/delivery/README.md
QQ 交流群:1101779791