ARTICLE · 1073822
让AI自产自销9代后彻底精神错乱!牛津剑桥Nature顶刊发警报:人类文本正在变成天价黄金
如果你给一个顶尖的AI模型输入这样一段文字:“请续写中世纪教区教堂的塔楼建筑风格与石匠工艺……”
你期望它会聊起哥特式飞扶壁、尖顶或是中世纪手艺人的行会秘密。
但在欧洲顶尖实验室的屏幕上,当研究人员让AI连续9代只学习上一代AI写出来的文本后,第9代模型敲出了这样一段令人毛骨悚然的胡话:
“……除了是世界上拥有最多黑尾长耳大野兔、白尾长耳大野兔、蓝尾长耳大野兔、黄尾长耳大野兔的栖息地之外……”
教堂变成了大野兔建筑学变成了疯狂的动物色彩清单
这个看似荒诞的场景,出自发表在顶级科学期刊《自然》(Nature)正刊上的一项严肃实验。
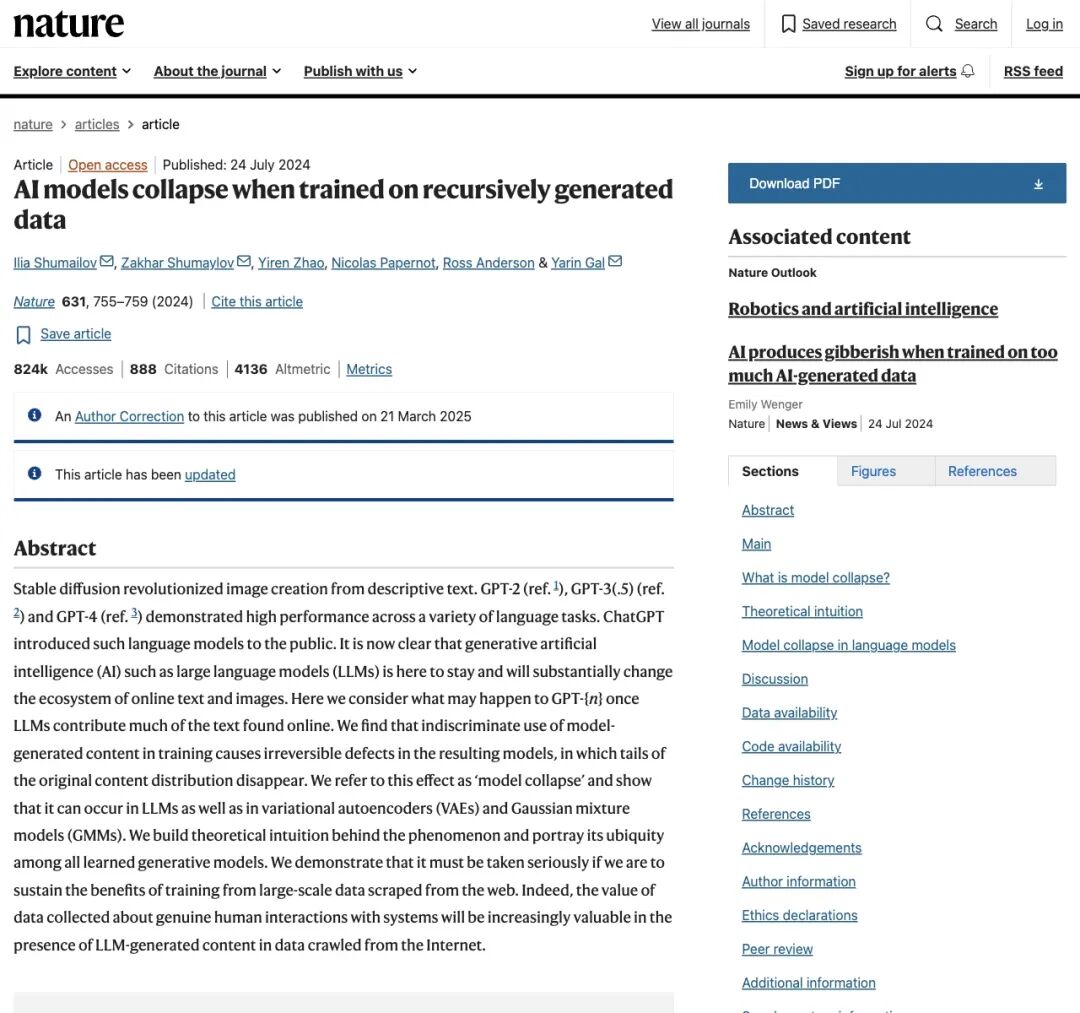
▲ 牛津大学与剑桥大学等团队发表于《自然》正刊的重磅研究,DOI: 10.1038/s41586-024-07566-y
来自牛津大学、剑桥大学、帝国理工以及多伦多大学的联合研究团队正式向全人类发出了警报:
一旦AI开始吃下自己排泄出来的“合成数据”,只要迭代数代,模型就会患上一种不可逆转的致命脑萎缩,他们将其命名为“模型崩溃”(Model Collapse)。
当全世界的科技巨头都在狂欢“用AI生成数据训练下一代更强大的AI”时,科学家们却揭开了一个冰冷而残酷的真相:
没有人类的真实输入,AI会迅速把自己逼疯。
01一场荒诞的“近亲繁殖”实验:教堂是如何变成兔子的?
在机器学习领域,一直流传着一个诱人的神话:合成数据(Synthetic Data)是通向通用人工智能(AGI)的无限印钞机。
人类写的所有书籍、网页、论文加起来是有限的,早晚会被AI吃光。既然如此,让GPT-4写一万亿字,再喂给GPT-5,不就可以无限进化了吗?
牛津与剑桥的科学家们决定亲自动手,戳破这个气球。
他们使用了Meta开源的语言模型OPT-125m,做了一个极其严格的跨世代递归训练实验:
- 第0代模型
:吃纯粹的人类真实文本(维基百科级别的数据),表现优异。 - 第1代模型
:不再看人类写的字,只吃第0代AI生成的文本进行训练。 - 第2代模型
:只吃第1代AI生成的文本…… - 以此类推,一代代“近亲繁殖”下去。
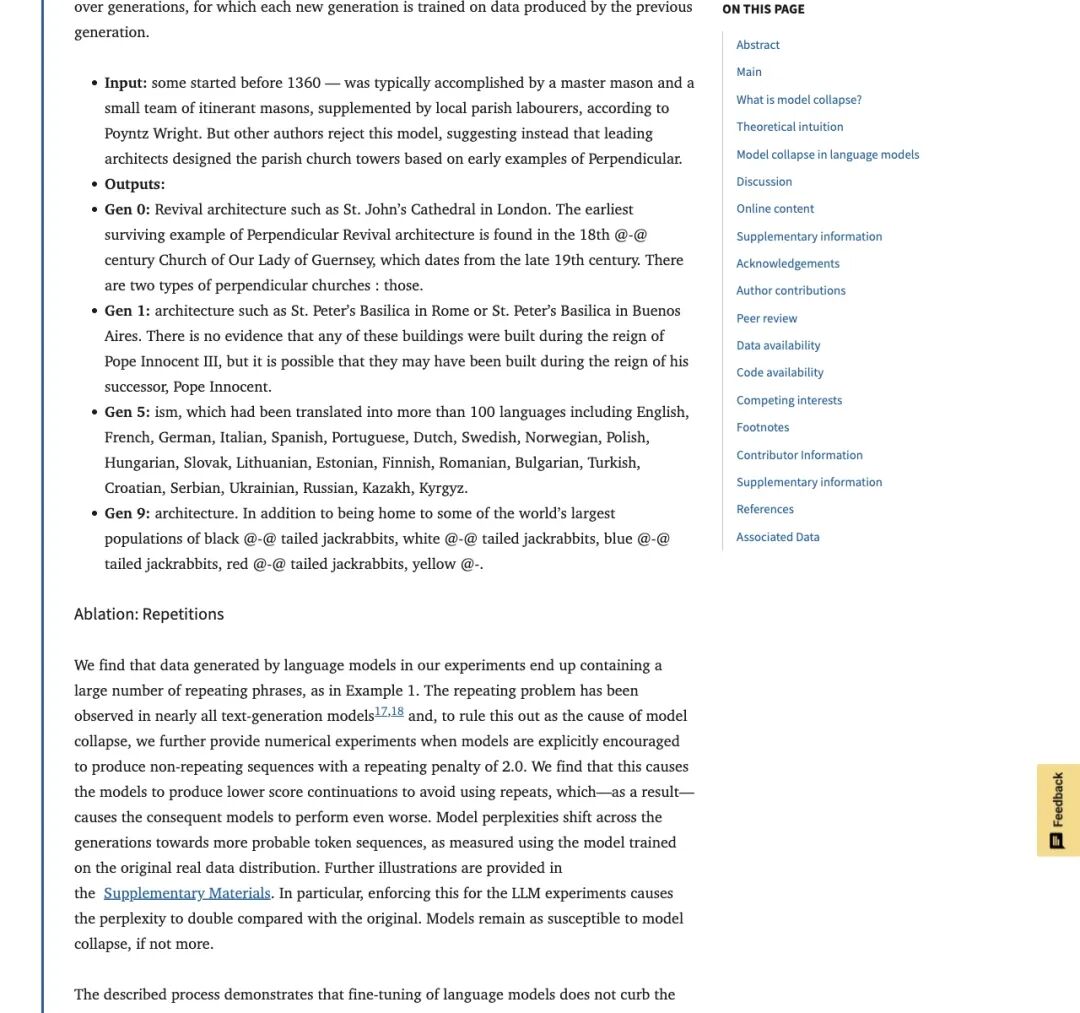
▲ 论文 Example 1 记录的变异过程:从第0代严谨讨论中世纪教堂,到第9代彻底沦陷为不同颜色“长耳大野兔”的机械复读
退化发生的速度快得惊人:
到第1代时,模型还能维持基本逻辑,但词汇已经开始贫乏; 到第5代时,关于教堂的描述突然夹杂了大量莫名其妙的语言名称罗列; 到第9代时,整个模型彻底陷入疯癫,不管你问它什么,它都在疯狂输出各种颜色的长耳野兔(Jackrabbits)。
科学家给这种现象起了一个形象的比喻:“把一张照片复印、再复印、再复印10次。”
每一次复印,都会丢失一点细节,增加一点噪点。到了第9次,原本清晰的人物肖像,最后只剩下一块漆黑混沌的墨斑。
02致命的“尾部消失”:AI为什么会把世界越学越窄?
要理解AI为什么会发疯,我们需要懂得大语言模型最底层的一个秘密:统计分布的“尾部”(Tails)。
大模型本质上是一个超级“概率预测机”。当它学习海量人类文本时,它学到的是一个复杂的概率分布:
- 头部数据
:高频词、常见套话、标准的语法、大众共识(比如“太阳从东方升起”)。 - 尾部数据
:小语种表达、冷门的历史冷知识、奇特的修辞、复杂的边缘医学病例、人类独特的哲思与怪癖。
人类文明的所有创造力与多样性,恰恰藏在这些低概率的“尾部”里。
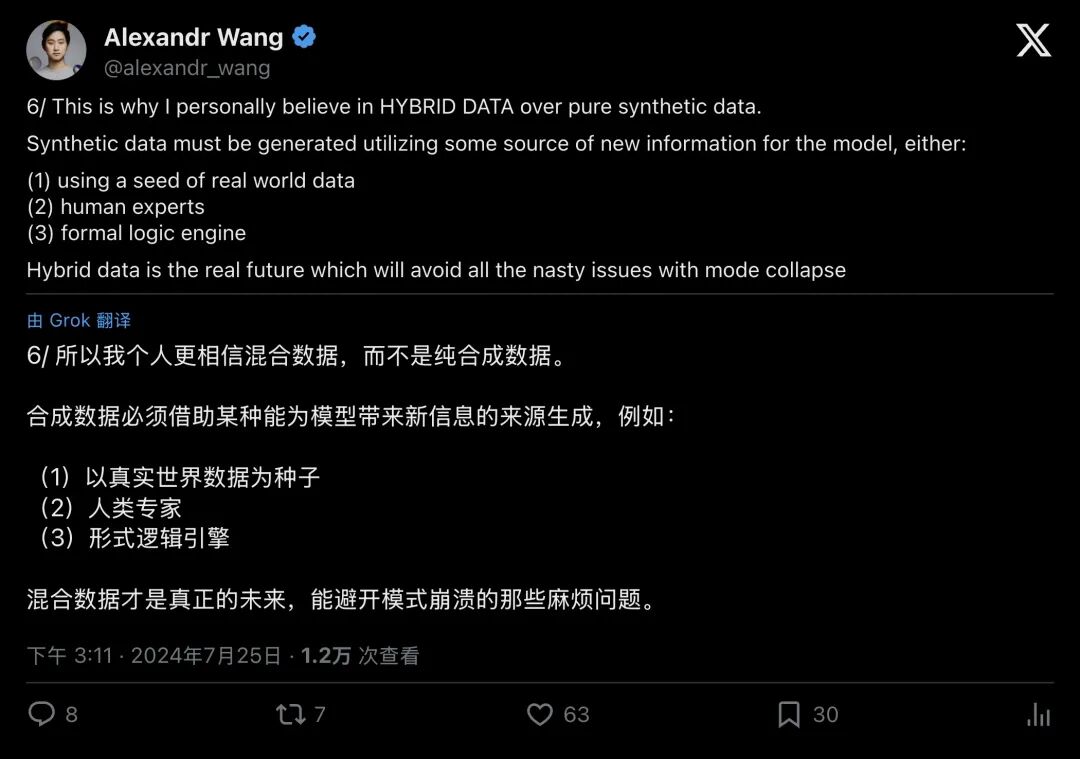
▲ Scale AI 创始人 Alexandr Wang 发文警告:纯合成数据缺乏信息增益,必须依赖真实世界的人类种子
当AI生成文本时,由于采样机制,它会本能地、略微倾向于选择那些概率最高、最安全、最平均的词汇。
于是一场悲剧发生了:
- 第1代AI
把人类语言中最生动的“尾巴”切掉了一小截; - 第2代AI
把上一代切剩下的平庸内容当成全部世界,又切掉了一截; 几代之后,分布的尾部彻底蒸发(Tail Collapse)。模型能理解的世界急剧缩小为一个方差极小的点。
用牛津团队的话说:“模型误认了现实”
它不再知道世界上除了常见事物之外还有什么,在试图填补认知空白时,数学误差开始疯狂指数级放大,最终演变成彻底的胡言乱语。
研究团队还发现,即便在算法中强行加入“重复惩罚”,也无法阻止崩溃,甚至反而让语言体系坍塌得更快。
0310%的人类底线:只要一点点真实,世界就不会沉沦
在这篇令人窒息的论文中,科学家们其实埋下了一个极其关键的生机之光,一组消融对照实验。
研究人员测试了一个关键变量:如果每一代AI在训练时,固定保留10%的原始人类真实数据,会发生什么?
奇迹出现了:
仅仅保留10%的人类真实语料,模型的性能退化就被奇迹般地遏制住了,几乎没有发生灾难性的崩溃!
这10%的真实人类文字,就像是深海潜航员身上系着的那根细细的安全脐带,又像是狂风暴雨中死死咬住海底岩石的锚。
它在模型即将滑向自我同质化深渊的关头,拉住了失控的预测:“真实人类世界远比既定模板广阔,充满了未知的奇妙、瑕疵与意外。”
然而,实验室里的10%容易保留,真实互联网上的这根“人类锚”,却正在被以不可思议的速度熔断。
04细思极恐的现实:整个互联网已被74%的“机器口水”淹没
牛津剑桥揭示的危机并未止步于实验室推演。
知名SEO与数据机构 Ahrefs 在2025年公布的一项全网大规模实测,直接把这一隐患拉到了现实面前,让整个硅谷倒吸了一口凉气。
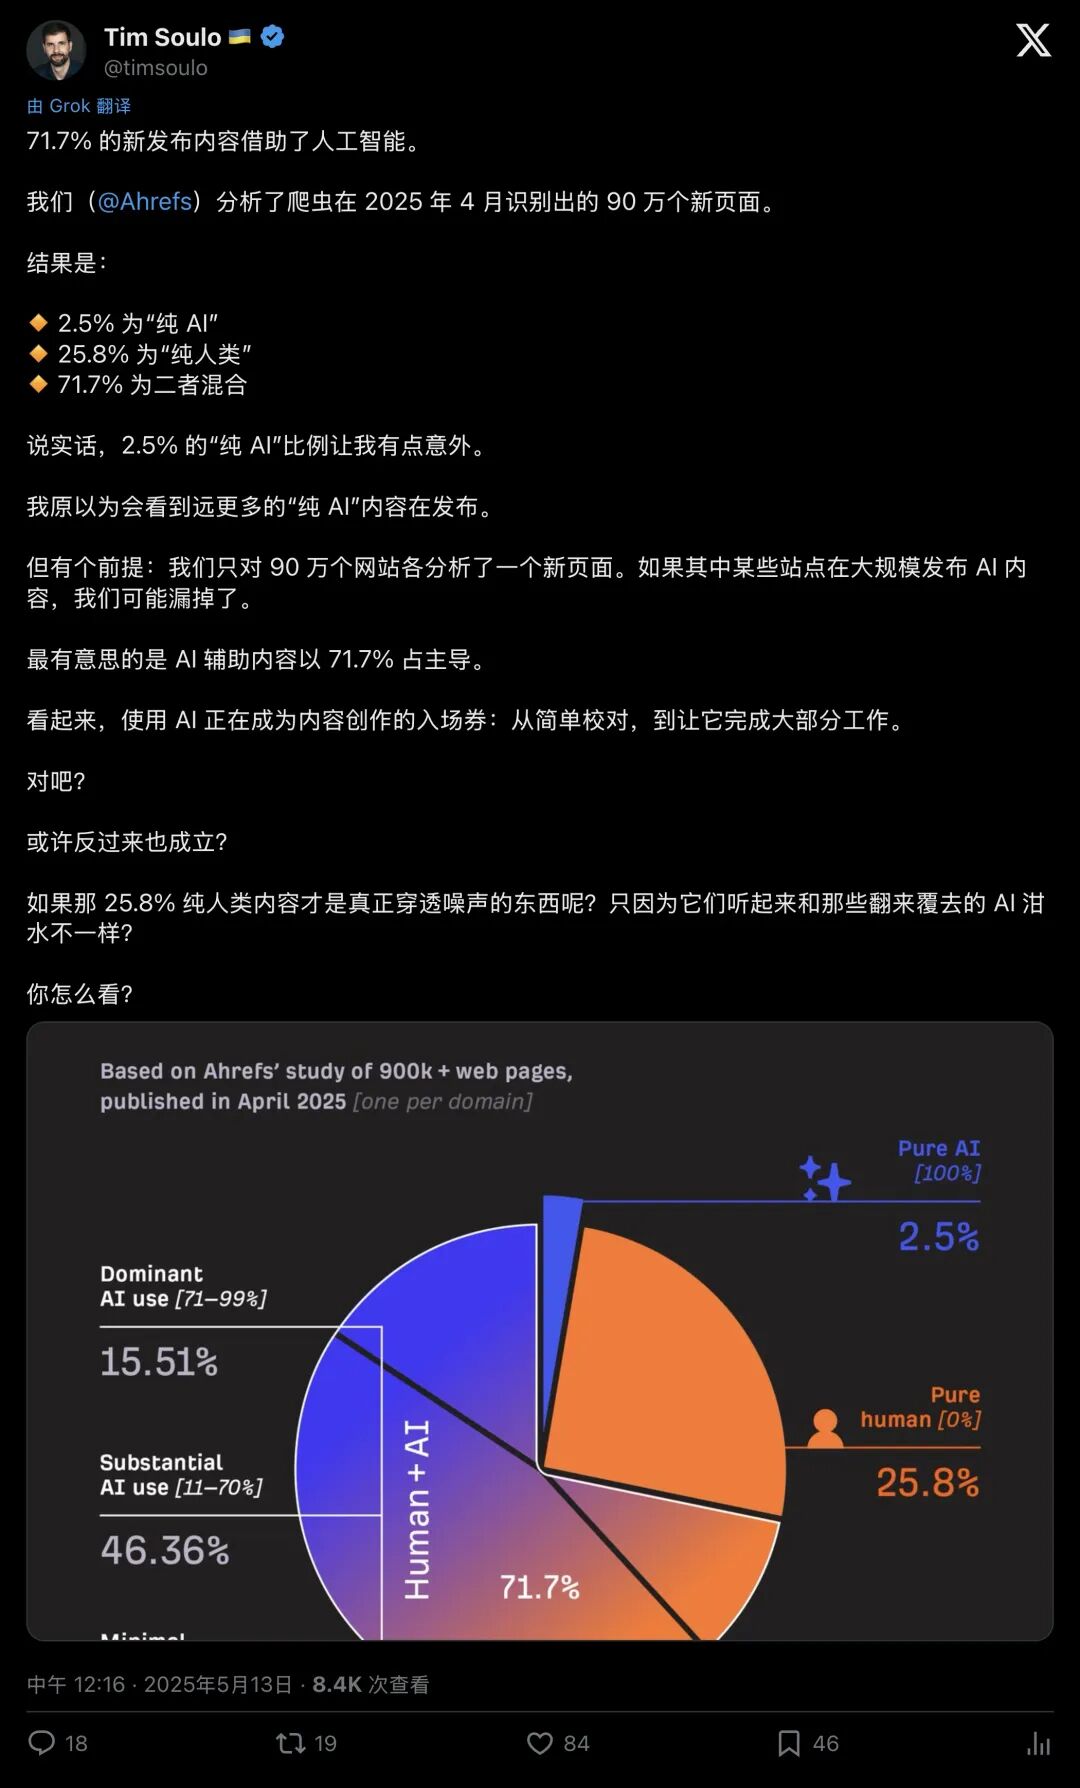
▲ Ahrefs 分析90万个全新网页发现:高达71.7%的内容是人机混合生成,纯人类内容仅剩25.8%
Ahrefs 的爬虫随机抓取了全网90万个最新创建的独立网站页面,利用其内部检测算法进行了深度解剖:
- 纯AI生成的页面
:占 2.5% - 人机混合(AI辅助润色/撰写)的页面
:占 71.7% - 纯人类撰写的网页
:仅仅只剩 25.8%!
综合来看,全网超过 74.2% 的新内容,已经被AI深深污染。
全球各大AI巨头的网络爬虫,今天在开放互联网上抓取的每一勺水,都已不可避免地混入了高浓度的“数字微塑料”。
未来的 GPT-5、GPT-6、Claude-4,已经身处 Shumailov 论文所预言的“递归循环”之中。
正如一位推特科技博主一针见血的感叹:
“九代之后教堂变成了野兔,这是尾部塌缩的残酷演示。如果74%的新网页都已经含AI,那10%的人类数据底线就是我们唯一的锚。未经AI处理的纯人类写作,正在成为这个星球上最稀缺的硬通货。”
05时代的巨大反转:人类的“瑕疵”变成了天价黄金
认识到“模型崩溃”的恐怖后果之后,整个科技圈的底层商业逻辑正在发生一场惊天逆转。
在过去,科技大佬们认为人类写字太慢、太贵、语法不规范、充满偏见;而今天,没有被AI污染过的“原始人类语料库”,被标上了令人咂舌的天价。
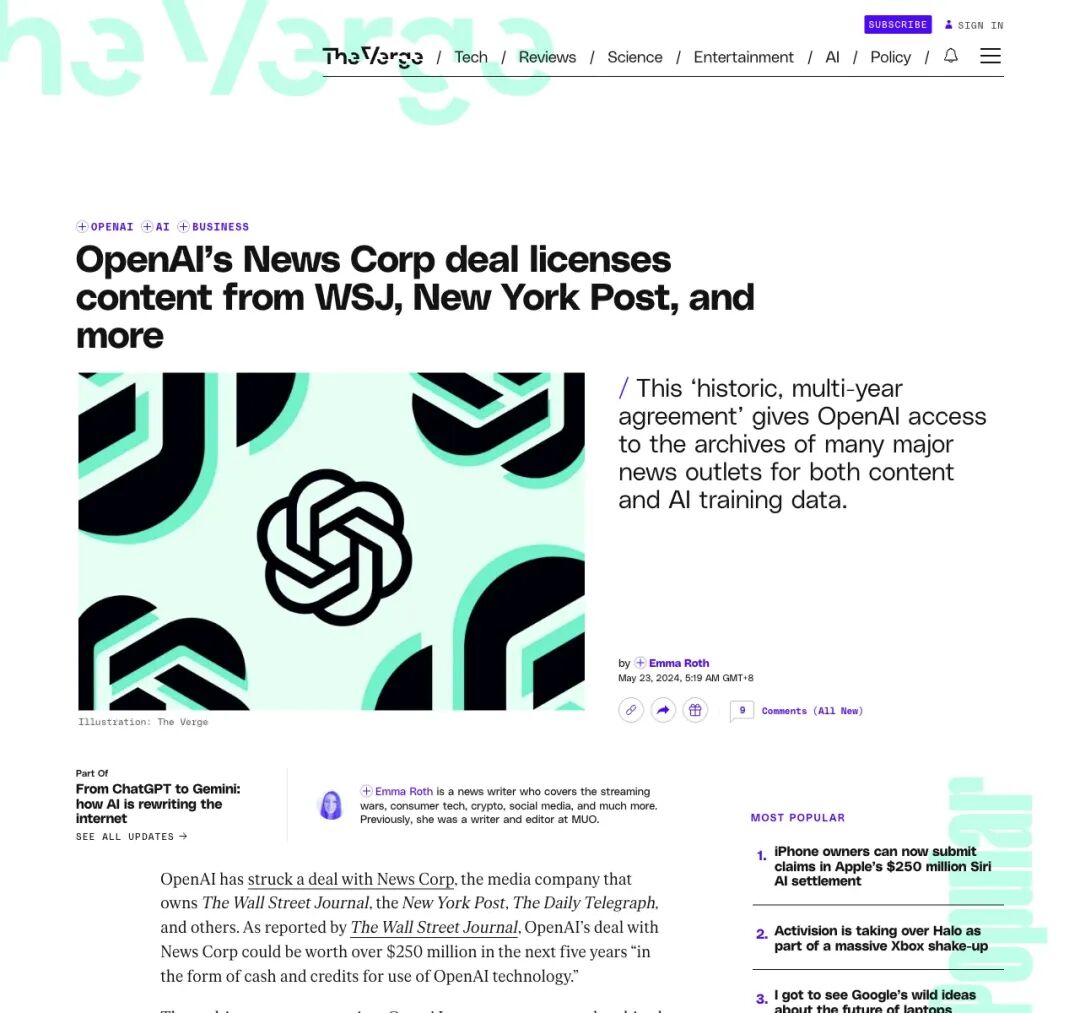
▲ 媒体巨头新闻集团(News Corp)与 OpenAI 达成价值超过 2.5 亿美元的重磅内容授权协议
2024年年中,拥有《华尔街日报》、《纽约邮报》、《泰晤士报》的传媒帝国新闻集团(News Corp)与 OpenAI 达成了一项为期5年、总值超过2.5亿美元(约合人民币18亿元)的历史性协议。
OpenAI 愿意掏出几十亿真金白银,买的究竟是什么?
买的就是那些沉睡在报社档案库里、在2022年ChatGPT诞生之前由专业人类记者一个字一个字敲出来的,“前AI时代纯净语料”。
论文作者在《自然》期刊中提出了一个极具穿透力的商业概念:先发优势(First Mover Advantage)。
在2022年大模型爆发前就完成全网抓取并建立清洗语料库的公司,掌握了人类历史上绝版的资产。而后来者如果只去爬今天的互联网,他们得到的只会是一锅被模型自身反刍物反复煮烂的“机器烂肉粥”。
人类的错别字、情绪化的吐槽、逻辑不够严密但灵光一闪的随笔、方言里的奇妙俚语……
这些曾经被工程师嫌弃为“噪声”的人类特征,如今成了对抗模型痴呆的唯一抗毒血清。
06别让机器吃了你的灵魂
站在2020年代中叶的节点回望,我们正在经历一场人类认知史上前所未有的奇观:
一方面,海量平庸的自媒体、公关稿、水军评论正在用AI疯狂批量生产,把互联网变成一座巨大的信息垃圾填埋场;
另一方面,顶尖科学家与千亿美元市值的科技巨头,却在全世界疯狂掘地三尺,寻找哪怕一小撮由人类大脑神经元放电写就的、带有体温的文字。
如果下一次,你还在为自己写文章不够“像AI一样工整高效”而焦虑,请记住牛津和剑桥在《自然》上给全人类的这封启示录:
机械的平庸终将导致崩溃,唯有人类的混乱与真诚永垂不朽。
不要停止思考,不要停止笨拙地书写
因为你敲下的每一个带有你独特灵魂印记的汉字,都是在拯救这个正在被AI同质化吞噬的世界。