ARTICLE · 1074482
《AI互连路线图》系列 · 第 02 篇-GPU 为什么必须"抱成团":Scale-up 网络三国杀
英伟达的整机柜里,72 颗 GPU 被一种叫 NVLink 的互连织成一台机器;AMD 的新机柜里,72 颗 GPU 走的是开放协议 UALink;华为的超节点更激进,一个标准单元直接连 1024 颗卡,还能继续扩到 8192 颗。
为什么所有厂商突然都不拼单芯片、改拼"谁把更多的卡抱成一团"?这一团内部又在争什么?本篇讲清三条路线的真实牌面,以及它们各自可能在哪里翻车。
一、单个 GPU 已经不是"产品"
先回答"为什么必须抱团"。
大模型的工作方式决定了这件事。训练时,一批数据被拆给许多颗 GPU 同时算,每算一步,各卡之间要交换中间结果,交换的频率高到每秒钟发生成千上万次;推理时,一个用户请求里的每生成一个词,都要读取规模越来越大的 KV Cache(缓存的对话上下文),单卡显存放不下,就必须摊在多卡之间共享。
于是真正干活的不是一颗 GPU,而是一个被高速网络捆在一起的"Scale-up 域"。域内卡与卡之间的互连带宽和延迟,直接决定了同样一批芯片实际能吐出多少算力——网络慢,再多的 GPU 也只是在排队等待彼此。
过去三年,这个域的规模在急速膨胀:从 8 卡、16 卡的服务器,到 72 卡的整机柜,再到上千卡的超节点。芯片公司的竞争主战场,也就从单芯片 FLOPS,搬到了机柜内部的互连。
二、先拆穿一个混淆:协议不是线缆
讨论三条路线之前,必须先分清两层——这是公众讨论里最常见的混用。
NVLink、UALink、灵衢,是协议与交换体系:它们规定数据怎么寻址、消息怎么送达正确的卡、内存能不能跨卡共享。而高速铜缆、正交直连、"取消背板",是物理电连接方式:它们规定电信号沿什么材料走、能走多远、损耗多大。协议是语言,线缆是公路,二者不是一回事。
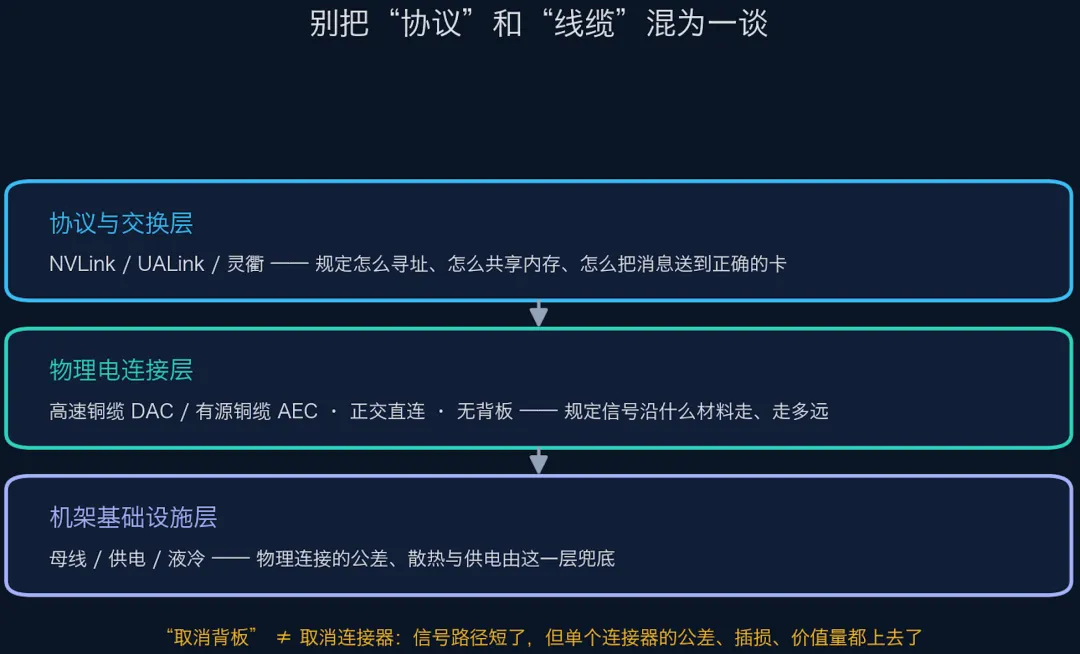
图1|别把协议和线缆混为一谈:机柜里的三层结构
国产超节点在物理层有一个热门方案:高速铜缆加正交直连、取消传统背板。信号从一张卡到另一张卡的路径被大幅缩短,损耗更低。但请注意一个反直觉的细节:"取消背板"不等于取消连接器。卡与卡之间仍然要靠大量高速连接器对接,路径短了,对连接器的尺寸公差、插损、散热的要求反而全部抬高——单个连接器的技术含量和价值量是上升的,不是消失了。
三、NVLink:单卡带宽之王,和它的封闭帝国
第一条路线是英伟达的 NVLink,第六代为 Rubin GPU 提供单卡 3.6 TB/s 的双向带宽。什么概念?一颗芯片每秒能与其他卡交换的数据量,已经超过它自身显存带宽的一个可观比例。
落到整机柜,Vera Rubin NVL72 把 72 颗 GPU 连成一个 Scale-up 域,域内互连带宽合计 260 TB/s——72 颗卡在软件看来接近一颗超级 GPU。
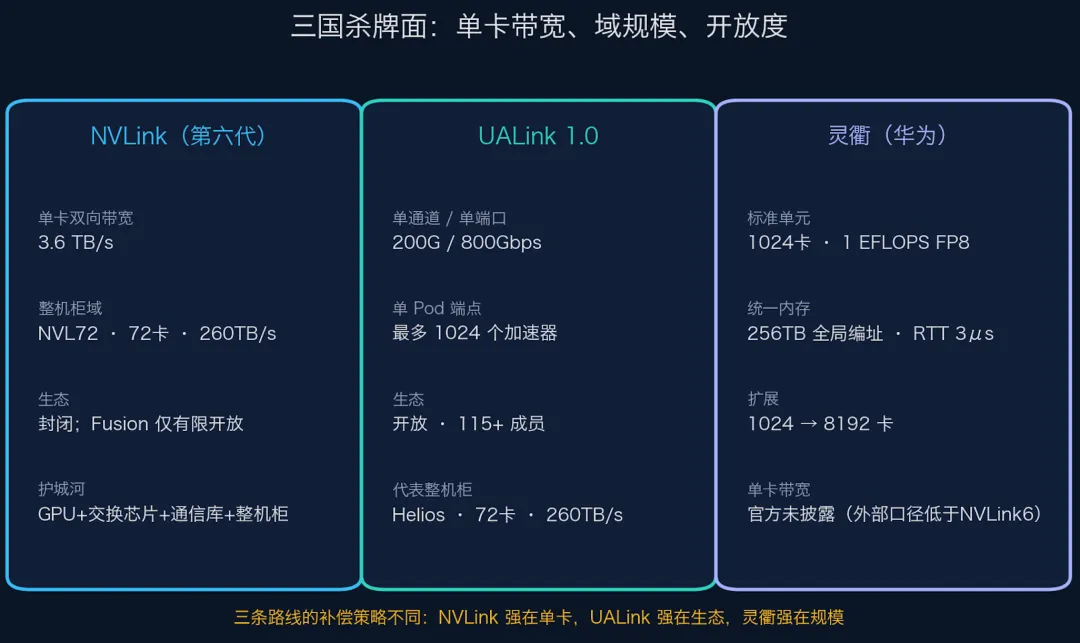
图2|三国杀牌面:单卡带宽、域规模与开放度
NVLink 真正的护城河不是带宽这一个数字,而是整套垂直整合:GPU、交换芯片、通信库、整机柜全部自己定义、协同优化。它的代价同样明显:生态封闭,外部的 CPU、第三方加速器很难进这个域。英伟达后来推出 NVLink Fusion 作有限开放,但 GPU 与 GPU 之间最核心的高速通道,仍掌握在自己手里。
四、UALink:开放联盟的反攻
第二条路线是 UALink,一个由 AMD 等公司发起、成员已超过 115 家的开放联盟。1.0 规范单通道 200G、单端口 800Gbps,一个 Pod 最多连接 1024 个加速器端点,底层建立在成熟的以太网 SerDes 生态上。它的诉求很直接:用开放标准和规模生态,替代封闭的 NVLink。
第一个落地的整机柜是 AMD Helios:72 颗 MI455X GPU 组成的域同样做到 260 TB/s,全柜 31 TB HBM4 显存、1.4 PB/s 聚合带宽,整机功耗 225 到 245 千瓦,2026 年三季度末开始交付。AMD 给出的口径是,Helios 每美元产出的 Token 比 NVL72 高约 30%——这是厂商自述,需要真实部署检验。
订单侧的声势不小:OpenAI 签署最高 6 GW 的多年期合作(协议还附带 OpenAI 可收购 AMD 至多 10% 股权的条款),Anthropic 最高 2 GW,Meta 有约 6 GW 的定制芯片合作,Oracle 采购 5 万颗 MI450,加上微软 Azure 部署,公开协议合计超过 14 GW。需要说明的是,GW 是电力口径的多年期框架,不等于当期已交付的机架。
五、灵衢:单卡不够,就用规模来凑
第三条路线是华为的灵衢。Atlas 950 SuperPoD 的标准单元是 1024 卡,FP8 算力 1 EFLOPS,256 TB 全局统一编址内存,卡间往返延迟 3 微秒,并支持从 1024 卡线性扩展到 8192 卡,按厂商口径 2026 年四季度批量交付。
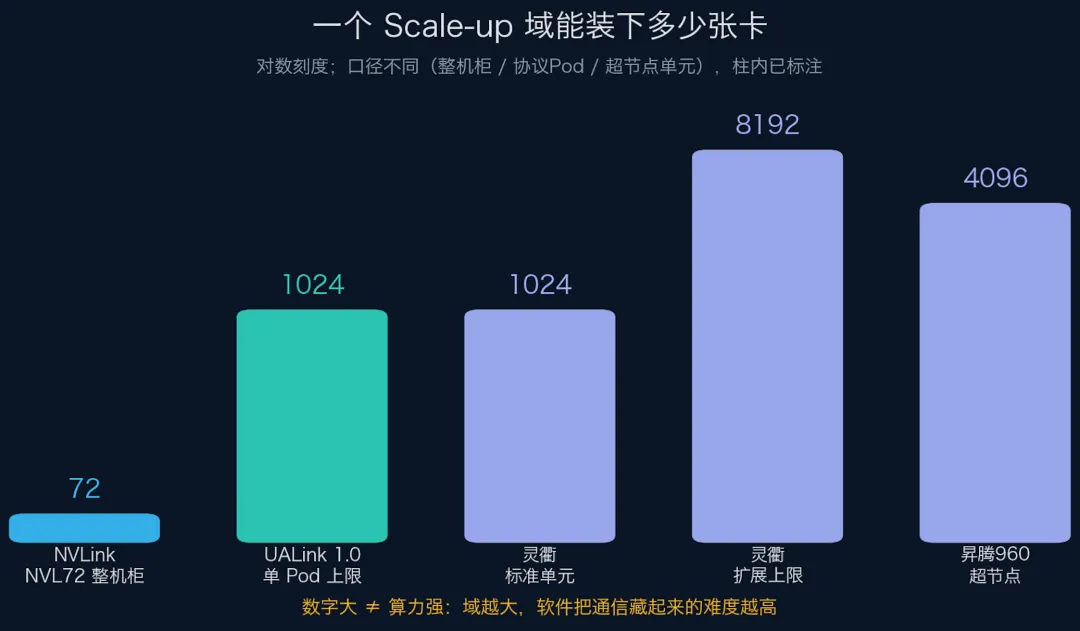
图3|一个 Scale-up 域能装下多少张卡(对数刻度;口径已标注)
它的补偿策略与英伟达恰好相反:英伟达用最强的单卡带宽,配 72 卡的小而密;灵衢用 1024 卡的规模,补偿单卡带宽的差距。灵衢单卡互连带宽官方未披露,外部口径认为低于 NVLink 第六代——在这个数字公开之前,不宜替它假设。
更大的昇腾 960 超节点是 4096 卡、FP8 算力 8 EFLOPS,但状态要说清楚:目前仍在系统测试中,配套的 960DT 芯片计划 2027 年一季度发布,不是已部署的事实。
灵衢还押注一层更深的东西:内存语义。256 TB 全局统一编址意味着卡与卡之间不只是"发消息",而是可以像访问本地内存一样访问对方,KV Cache 得以跨卡共享。互连正在从"搬运数据的配套件"变成"第二颗算力大脑"。
六、Scale-up 的钱,先流向哪一层
三条路线无论谁赢,产业价值的迁移顺序是相对确定的,可以拆成三层。
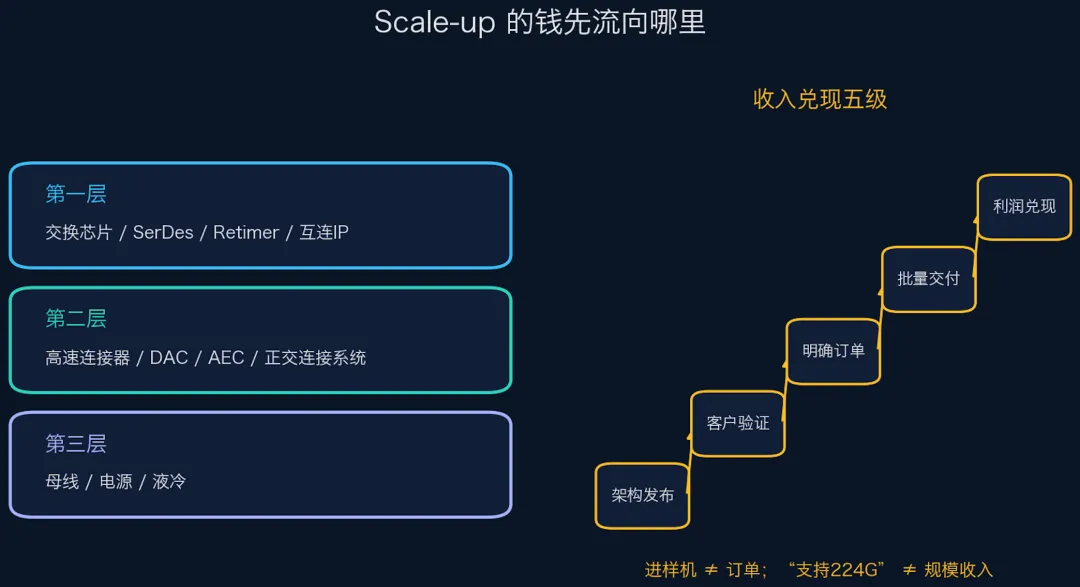
图4|价值迁移三层与收入兑现五级
第一层是交换芯片、SerDes、Retimer 和互连 IP;第二层是高速连接器、DAC/AEC 铜缆与正交连接系统——物理层创新直接利好这一层;第三层才是母线、电源与液冷,物理连接的公差、散热与供电最终由机架基础设施兜底。
但要记住收入兑现的五级阶梯:架构发布 → 客户验证 → 明确订单 → 批量交付 → 利润兑现。进入样机不等于形成订单,"支持 224G"也不等于规模收入—这是过去一年题材行情里最容易被跳过的一级。
七、七盆冷水
老规矩,反方单独成章。
第一,单卡带宽差距是真实的物理。灵衢的单卡互连数字至今未披露,外部口径低于 NVLink 第六代;规模能补偿多少,取决于软件效率,不是堆卡就自动成立。
第二,软件比线缆难得多。把成千上万卡的通信"藏"起来,靠的是通信库、编译器和故障处理;域越大,单卡故障牵动的范围越大,整机可用度是硬指标。NVLink 的真正壁垒恰恰在这里,不在铜缆。
第三,开放规范的成熟度待验证。UALink 1.0 产品 2026 年才开始交付,多家厂商跨阵营互联互通还没有大规模现场演示,"开放"目前更多是生态势能。
第四,线性扩展是厂商口径。1024 到 8192 卡的"线性"二字,是实验室和规划目标;真实负载下,通信占比随卡数上升,加速比几乎必然打折,只是打多少的问题。
第五,标准仍可能分裂。NVLink、UALink、国产自研协议长期并存,押错生态的软件迁移成本和硬件库存成本都是真实成本。
第六,30% 的每美元 Token 是 Helios 自述。这个数字要等 OpenAI 等真实客户跑出利用率与功耗账单,才知道口径是否一致。
第七,14 GW 是框架协议,不是收入。多年期合作、附带股权条款的协议,与按机架确认的当期交付是两件事,中间还隔着交付节奏和客户资本开支两道变量。
八、接下来盯什么
节点很清楚:盯 Helios 三季度末的首批交付,以及 OpenAI 部署是否如期;盯 Atlas 950 四季度能否从"批量交付口径"变成到货现场;盯昇腾 960 系统测试何时结束、960DT 在 2027 年一季度能否如期发布;盯 UALink 联盟何时拿出多厂商互操作演示;也盯各家是否披露大规模域的真实加速效率—那个数字比任何 PPT 都说明问题。
三条路线争的不只是机柜里的带宽,而是"未来的超级计算机由谁定义":是垂直整合的强者,是开放联盟的生态,还是用规模换时间的追赶者。方向真实,胜负要靠交付和效率来揭晓。让订单、良率和真实加速比替你做决定,别让"三国杀"的标题替你做决定。
仅为个人研究记录,所涉公司均为研究层面的映射梳理,不构成投资建议。
《AI互连路线图》系列目录
机柜里的第二个"800V时刻":插头式光模块到顶后,光被请进了芯片旁边 本文:GPU 为什么必须"抱成团"——Scale-up 网络三国杀(待发)
下篇预告:铜的最后一程,和光钻进芯片的那一天—DAC/AEC 还能走多远,光 I/O 进封装之后机柜会变成什么样。