ARTICLE · 1075169
手机端侧AI跨过了可用分水岭,但只走了全程的三分之二
华为全联接大会2026上,汪涛说过一句话:手机模型从2024年的3B发展到今天的30B,未来将进一步走向100B级。
这句话当时被昇腾超节点和百万卡集群的风头盖过去了,但它其实给端侧AI的演进钉了一个实在的坐标。
比数字更值得注意的是,端侧AI正在从演示给你看,变成真的能用。而2026年,就是这个转折点。
判断一个技术到没到可用的份上,不能听厂商怎么说,得有硬尺子。按这把尺子量,端侧AI现在大概走到了全程的三分之二。
什么样才算真的可用
我把可用的标准列成四条,缺一条都不算数。
第一条是离线能力。断了网还能把整条任务链路跑完,这是端侧存在的根本理由,不然直接上云就行了。
第二条是响应时延。首token要压在百毫秒级,解码速度至少每秒20到30个token。低于这个阈值,用户的注意力就断了,直接切出去干别的。
第三条是内存适配。模型得能装进主力价位的机型,还不能把后台挤爆。只在超大杯上跑得动的东西,叫玩具,不叫普及。
第四条是任务闭环。它得能自己完成理解、规划、调用、交付这一整套流程,这才叫智能体,否则只是个高级聊天机器人。
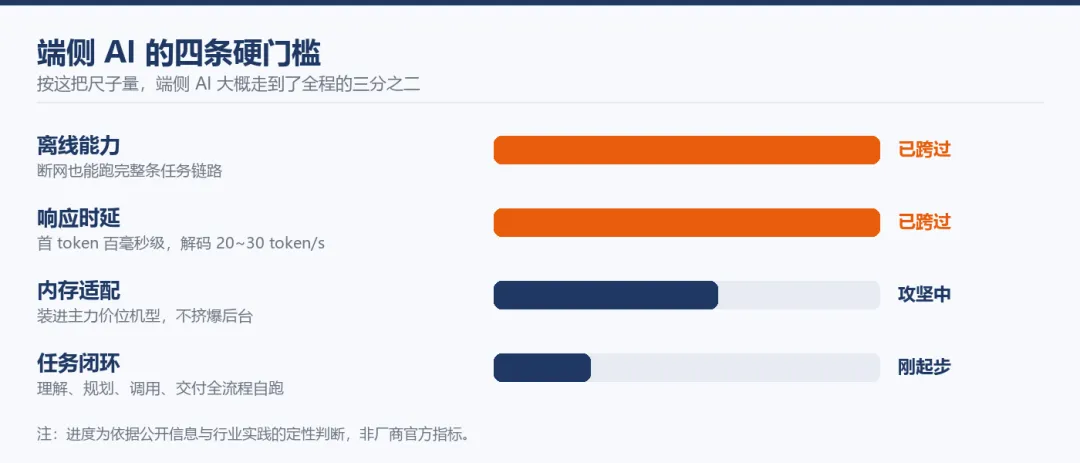
图:四条硬门槛里,前两条基本跨过,第三条正在攻坚,第四条刚起步
前两年说端侧AI是鸡肋,说得很准,那时候充其量只满足了第一条。现在不一样了,前两条基本跨过去,第三条正在咬牙攻坚,第四条才刚起步。
30B为什么能塞进手机
很多人看到30B就吓一跳,觉得手机怎么可能装下300亿参数的模型。
其实现在落地的端侧大模型走的都是MoE路线,也就是混合专家架构。总参数很大,但每次推理只激活其中一小部分。
华为的盘古30B-A2B,就是300亿总参数、大约20亿激活参数。
这个技术选择太关键了。它相当于把能力提上去,功耗和内存却没跟着一起涨。如果走稠密模型的老路,别说100B,30B在手机上根本跑不起来。
所以30B已经商用这句话真正的意思是:端侧AI找到了一条变大但不变重的路。
后面往70B、100B走,已经不是原理问题,是工程问题。工程问题就好办,砸时间砸人,总能往前推。
两颗芯片今年砸钱的方向高度一致
芯片这层最有意思。今年两颗旗舰SoC的升级方向,出奇地一样:都在搞带宽和功耗,没人再单纯堆TOPS。
麒麟9050 Pro这边,晶体管密度做到2.38亿每平方毫米,性能对齐的情况下NPU功耗降了66%。第三方实测的数据是,在Mate XT 2上INT8算力约67.7 TFLOPS,理论峰值70 TOPS左右,比上一代提升约150%。
这里有个细节很重要。这组数据是在LPDDR5X内存上跑出来的,说明带宽的潜力还没完全释放,后面还有空间。
高通那边的骁龙8 Elite Gen 6,Hexagon NPU做了重设计,加了专门加速Token和Transformer推理的单元,共享内存最多扩容50%。现场演示里,30B-MoE跑出了预填充每秒330多token、解码每秒28个token,NPU加GPU双引擎协同比纯NPU又快了30%以上。
两家今年砸钱的方向高度重合:稀疏激活、低比特量化、缓存扩容、KV Cache加速、闪存权重加载、GPU协同推理,全都是围绕数据搬运和功耗在做文章。
这说明行业对瓶颈在哪已经有了共识。核心约束是带宽和功耗,不是算力本身。这反而是好消息,因为带宽和功耗能靠工程迭代一年年磨上去。
还有个细节挺耐人寻味。28 token/s这个解码速度,刚好卡在读起来不费劲的体验下限上。这不像巧合,更像芯片厂商拿着体验门槛在倒推设计指标。
最后一道门在系统层
系统层的价值被严重低估了。HarmonyOS 7今年要往Agent OS转,从底层架构到运行机制再到交互逻辑全面重构,还开放了智能体框架和各种接口。
端侧模型参数再大,如果系统不知道什么时候该唤醒它、该给它什么权限、该让它调哪个能力,那它就搞不清什么时候该介入。
生态层现在的格局是两套体系并行:一边是鸿蒙加盘古加小艺的垂直整合,另一边是安卓加高通AI栈加各家模型厂商的开放组合。
开发者要是想让自己的智能体接入系统级意图流,搞不好得适配两套技术栈。生态一割裂,用户感知到的进步就要打折扣。
还差四道坎
头一道是内存容量下放。运行内存需求压缩50%这件事,意义可能比30B参数本身还大,因为它决定了30B能不能下沉到16GB内存的中高端机型。
第二道是评测口径统一。麒麟的67.7 TFLOPS是第三方INT8测出来的,高通只说相对提升多少、不给绝对值,用的还是INT4和FP8混合精度。INT8的TOPS和INT4的TOPS根本不是一个单位。
第三道是主力机型的实际配置。判断内存门槛过没过,别看芯片支不支持LPDDR6,看主力走量的机型实际装的是什么。
第四道是绕不开的结构性限制。本地模型拿不到实时信息,极限推理和复杂规划还是得靠云端,长时间高负载必然发热降频。
这些不是缺陷,是端侧AI的定位决定的。也正因如此,端云协同从来就不是过渡方案,它就是长期架构。
写在最后
华为画了一条3B到30B再到100B的参数路线图,两家芯片厂商用两颗芯片证明了30B现在就能跑。
把这两件事合起来看,参数竞赛只是浮在水面上的部分,水底下那场关于带宽、功耗、内存和系统调度的工程战,才是主战场。
还有一点值得留意。现在所有可用的证据,都是在LPDDR5X、参考设计、发布会现场这些相对保守的条件下成立的,这意味着真实的天花板还远远没摸到。
至于什么时候轮到普通用户手里的机器,不用等100B落地。等你哪天开着飞行模式,手机能自己独立完成一件以前必须联网才能干的事,那个拐点就到了。