ARTICLE · 1078009
AI 进入企业,是一场治水(中):企业用AI,别只买模型,先搭好这4层水网
一、模型不是答案,是水压
上一篇我们说到,OpenAI 们集体踩刹车,是因为"电力思维"撞了墙——AI 从来不是电,是水。
这一篇落到地面:既然它是水,这条长尾到底该怎么啃?
真正做过一线落地的人大多有同一个体会:耗时间的往往不是“选模型”,而是 Agent、Skill、MCP、评测、监控、工作流、知识库和权限这些细部。模型提供水压;这些细部决定水是否进得了田、会不会漫出来、用后能否沉淀。
先说一个最容易犯的错——把"买模型"当成"治水"。
采购最先进的模型,类似换一台更大的泵;给员工开账号、上线通用智能体,类似在楼里装一个公共水龙头。离让能力进入关键生产流程,还隔着一整套系统。
而这一堆看着琐碎的家伙,用"治水"的思路一捋,其实就四层:引水、分水、治水、回水。
一层一层拆。
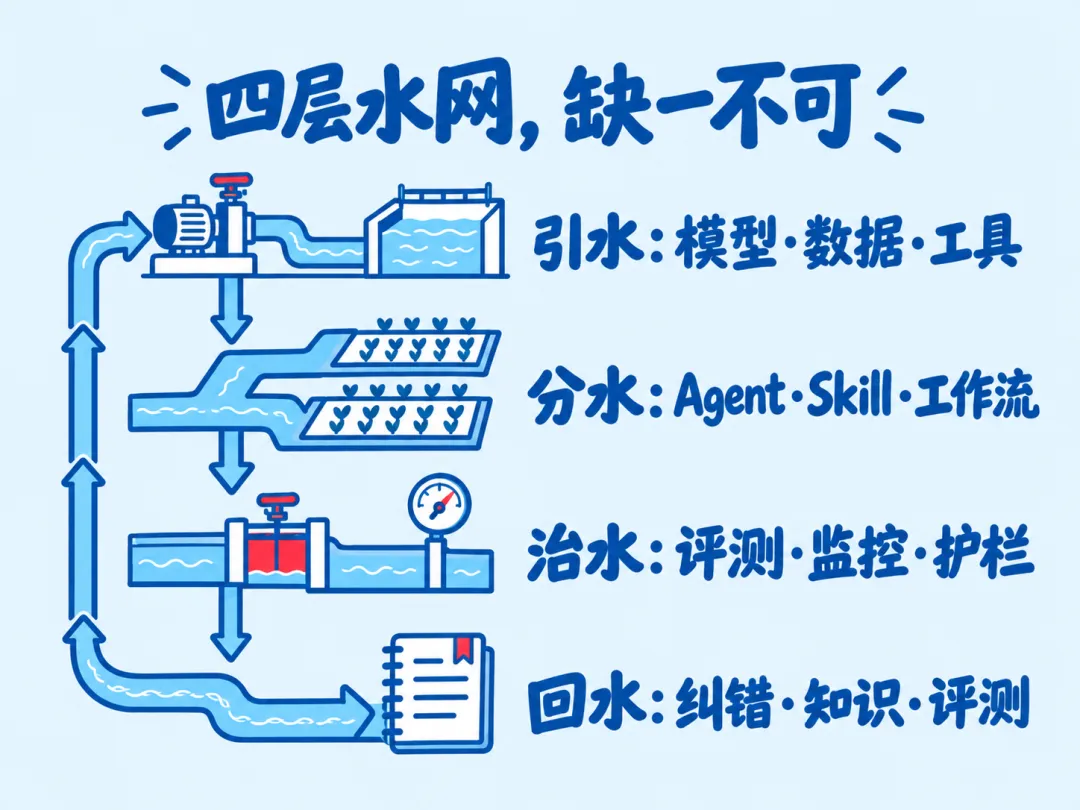
图1|引水、分水、治水、回水,分别对应接入、分配、治理和反馈沉淀。
二、第一层:引水——把模型和数据源接进来
引水,不是开个 API 账号那么简单。它至少得干三件事。
接模型:接入大模型,就像给这套系统装上水泵,并接通“通用水库”——解决的是“水压够不够”的问题。
接数据:企业内部的数据、文档、系统,得能被模型读到。通用知识是"公共水库",你企业的数据是"自己的一口井,一片塘"——知识库和 RAG 干的事,就是把这口井这片塘挖出来、接到水网上,让模型调用的时候,能捞到你自己的地里的水。
接工具:你的 CRM、ERP、数据库,得能和模型对上话。这背后是 MCP 这类标准协议——它把企业五花八门的工具和数据源,统一成模型能读懂的"标准管道"。
泵、井、管三样都通了,水才算真正引进来。否则,模型再强,也是个读不到你数据、碰不到你系统的孤岛。
很多企业现在就停在这一层:员工会聊天、会总结、会生成 PPT,但模型读不到业务数据、碰不到业务系统。水引到了门口,可还是靠人一桶一桶提。
所以引水只是起点,不是终点。
三、第二层:分水——把模型拆成能干活的 Agent 和 Skill
水引进来了,下一步是分:把一池子通用能力,拆到具体岗位上。
这一步在工程上,对应两个概念。
Agent(智能体),是"能干活的具体角色"——一个会审合同的 Agent、一个会查订单的 Agent、一个会做客服的 Agent。它有目标、能规划、会调工具、能连续执行多步任务。
Skill(技能),是这个角色手里的"具体家伙"——查数据库、发消息、调接口、解析 PDF、算账。一个 Agent 挂几个 Skill,就像一个人拎着几件趁手的工具。
借用水利的说法,Agent 是通往具体田块的支渠,Skill 是田里的取水口。
销售线索判断、客服回复、合同审阅、财务核对——每一个场景,背后都是一个或多个 Agent,挂着一组 Skill,在跑一条具体的工作流。
而到底怎么挂、怎么配——什么任务配什么 Skill、什么场景用什么参数、浇多少水——这才是结合本地土壤的"配方"。配对了,水才真正浇到点上。
同一个模型,进入不同的 Agent 和 Skill,价值会完全不同。它可以只是提高一点内容生产速度,也可以在受控条件下帮助核对合同、处理订单、识别异常。差别不在模型本身,而在于能力被接进了哪条流程、能调用什么工具、由谁负责最后确认。
一个只会写周报的 AI,和一个能审合同的 AI,用的是同一个模型。差别不在模型,在"你把水引到了哪块地、装了什么取水口"。
四、第三层:治水——评测、监控、护栏
这是最多企业忽略的一层,也是我最想强调的一层。
水不是越多越好,AI 输出也不是越多越好。企业接入 AI 后,常见的并非“缺水”,而是水患:
·大量低质量内容泛滥;
·错误答案进入正式决策;
·员工把没核验的结果层层转发;
·私密数据流向外部模型;
·多个部门重复购买工具;
·AI 生成的数据,又被拿去训练 AI。
这些对应的不是干旱,是洪水、污染和淤塞。
工程上,治水靠三样硬家伙。
第一样,Harness——评测框架。说白了,就是给 AI 的输出"测水质":准备一批标准问题,看它答得对不对、稳不稳、有没有越界。模型升级一次,回归测一遍;Agent 改了个 Skill,再测一遍。没有评测,你对"这个 AI 到底行不行"的判断,全靠感觉。
第二样,监控——可观测性。每一笔调用花了多少钱、延迟多少、报了什么错、命中了几次护栏,都得记下来。这就是水利里的"计量"——不计量,你不知道哪里在漏、哪里在淤。
第三样,护栏——限流、熔断、人工确认。什么场景必须人工点一下、什么输出必须拦下、什么情况自动切回人工,这是"闸门"和"泄洪道"。
这三样,落到水利设施上,就是一套完整的清单:
·闸门:什么场景必须人工确认;
·沉沙池:哪些输出要先核验;
·水质标准:不同任务,允许多高的错误率;
·分区供水:不同岗位,可以访问什么数据;
·泄洪机制:模型异常时,怎么切回人工。
缺少这一层,引水和分水推进得越快,风险扩散得也越快。
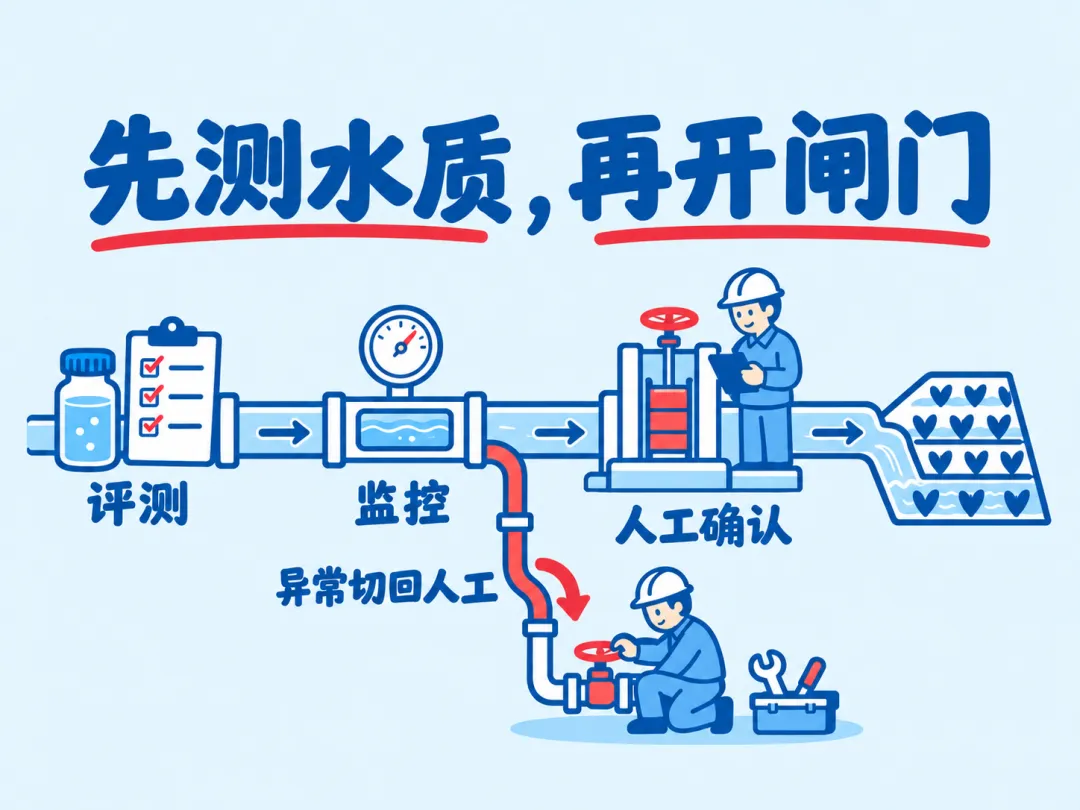
图2|评测检验输出质量,监控记录运行状态,护栏设置人工确认与异常切回人工的路径。
五、第四层:回水——让每一次使用流回组织
这是四层里最有价值、也最被低估的一层。
一次 AI 调用,不应该只产生一个答案。它还应该留下:
·输入了什么问题;
·调用了哪些内部材料;
·AI 给出了什么结果;
·人修改了哪里;
·最终有没有被采用;
·后续产生了什么业务结果;
·哪些规则需要更新。
在工程上,这就是把反馈变成数据、把数据变成改进。这批过程数据,能干四件事:
改提示词和 Skill——哪些回答老出错、哪个 Skill 不好用,从数据里一眼能看出来;
更新知识库——人纠正过的答案、被采纳的内容,回流进蓄水池;
充实评测集——那些"AI 答错了、人改对了"的案例,正是 Harness 下一轮评测最宝贵的测试样本;
回测模型——拿同一批评测集,跑一遍新旧模型,看新的是不是真的更强。
走到这一步,企业才可能把使用过程不仅用于“测泵”,还用于“改泵”:在脱敏、合规并经人工确认的前提下,用本地数据做微调或蒸馏,得到更贴合自身场景的小模型。它标志着企业从采购通用能力,开始沉淀本地能力。
这就是"数据梯次利用",也是古人早就懂的道理——适质适用:不是所有用途都需要最高等级的水,不同质量的水,匹配不同的用途。
原始业务数据,支持正式决策;脱敏数据,用于模型评测;人工修改记录,变成训练样本;失败案例,进风险规则库;低敏过程数据,用于自动化优化。
但这里有一条边界,必须说清楚:
数据的管理逻辑比水复杂。水在使用中被消耗或污染,数据却可以复制。但数据经过 AI 反复加工,也会产生另一种污染——错误被复制、偏见被强化、AI 生成的内容,被再次当成真实数据。
这并非杞人忧天。高质量人类数据日益稀缺,模型过度使用未经筛选的合成数据,可能造成错误和偏见的累积,甚至带来能力退化。企业的闭环也面临同样风险。
所以回水系统必须配一套"水质标记":原始事实、人工确认、AI 生成、待核实、已过期、禁止用于训练。
没有这些标签,所谓"数据闭环",很可能不是学习闭环,而是错误的自我繁殖。
还有一层,得留到下一篇再说:回水能不能流回来,光靠企业自己是靠不住的——末端没人盯着,水只会流走,不会回流。
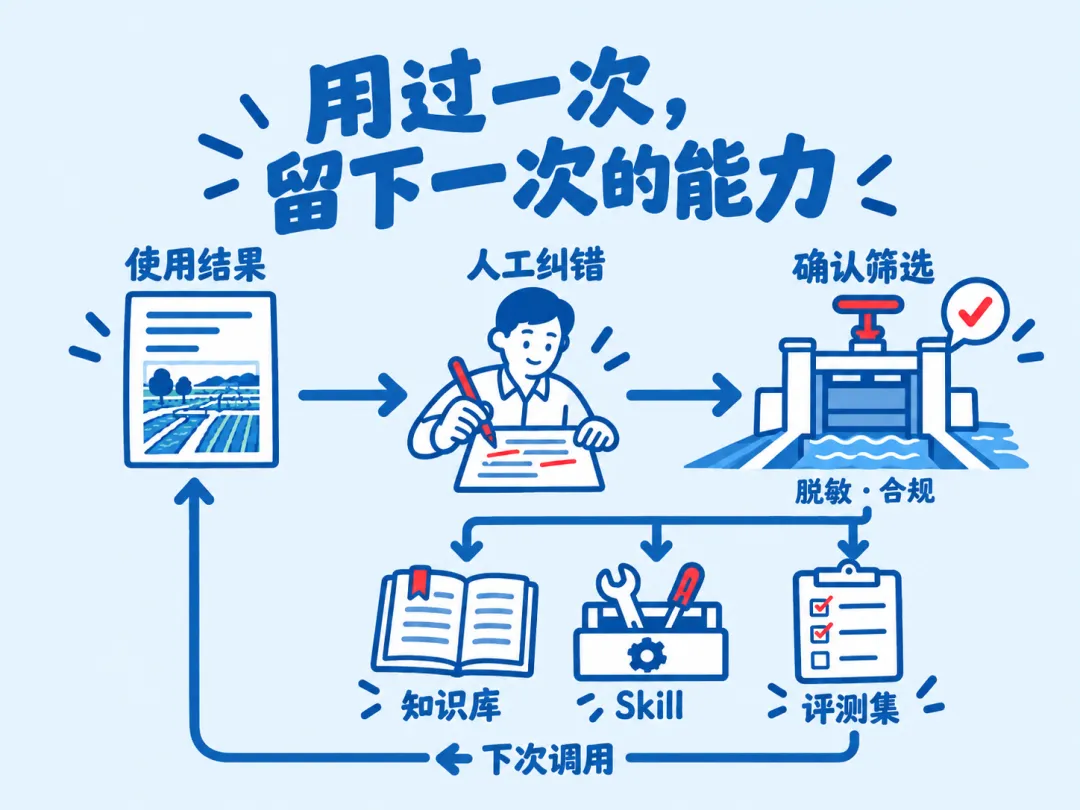
图3|过程记录经过人工纠错、确认和筛选,再用于更新知识库、Skill 与评测集,服务下一次调用。
六、古代治水,教给企业的三件事
四层水网讲完了。现在把时间拨回两千年前,看看古人早就想明白、而我们今天又忘掉的三件事。
第一件:岁修。
都江堰用了两千多年没废。秘密不在工程,在制度——设专门的管水机构,每年必须"深淘滩、低作堰",定期清淤排沙。
对照今天:IDC 的数据显示,工业大模型的应用比例一年内从 9.6% 冲到 47.5%,但绝大多数项目,上线三个月内就沦为摆设。
为什么?因为没人做岁修。企业把 AI 当成一次性的工程,装完就完。而渠道会淤积,年年都得淘。
工程上的岁修,要抓住两件事。第一,Harness 的回归测试别停:模型升级了、Skill 改了、数据换了,都要重新跑一遍评测。第二,监控的告警别关:线上效果变差、调用异常、成本飙升,要第一时间看得见。两件事少一件,三个月后这套系统就会变成摆设。
都江堰两千年不废,靠的不是工程,是岁修。你的 AI 系统,也得有人年年清淤。
第二件:分水。
都江堰最厉害的地方,不是"把岷江水引到成都平原",而是同时完成了分水、排沙、泄洪、流量控制和灌溉。它不是一条管道,是一套会应对水量和泥沙变化的系统。
对应到企业:真正重要的不是某一句神奇的提示词,而是——
什么任务何时触发 AI,AI 读取哪些信息,输出交给谁,谁负责确认,修改记录回到哪里,最终效果怎么测量。
这张流程图,才是企业的"水利图"。在工程上,它就是你的工作流编排,加上 MCP 接好的工具,加上沉淀下来的 Skill 库。提示词,只是其中一个闸门的操作说明。
第三件:因地制宜。
同样的水,在平原和山区,需要完全不同的工程。同样的 AI,在不同企业里,也不能直接复制:
·决策高度集中的企业,适合修"总干渠";
·一线变化快的企业,需要大量小型"水井"和局部 Agent;
·数据敏感的企业,需要封闭水网;
·数据质量差的企业,第一步不是引水,是清淤。
AI 落地失败,很多时候不是模型不够聪明,而是企业没先勘察自己的组织地形,就照搬了别人的工程图。
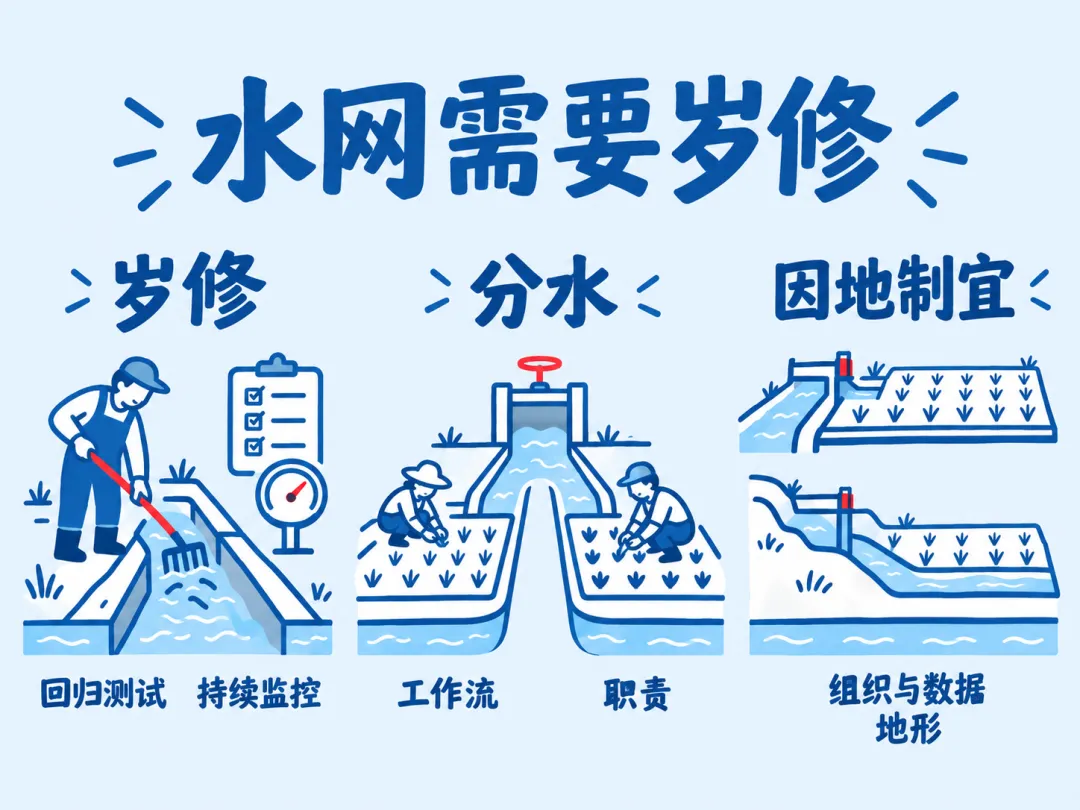
图4|持续维护、流程分工和组织地形,决定一张水网能否长期运转。
七、三个推论
顺着这套水网模型,还能推出三个更深的判断。
第一,模型优势会商品化,渠道优势不会。
当各家模型能力越来越接近,企业的差距不会主要来自"用了哪家模型",而来自:AI 进入了多少关键流程、每条流程有没有数据回流、员工会不会纠错、企业有没有自己的知识蓄水池、能不能把一次成功变成可重复的组织能力。
更准确地说:标准泵会商品化——谁都能买到同样的泵;但你自己用井里的水喂出来的那台定制泵,不会商品化,它抄不走。
未来企业的差异,不会只来自使用了哪台泵,更来自谁拥有一张能持续运转的灌溉系统。
第二,企业最大的 AI 资产,不是提示词,是"渠系图"。
一句提示词可以抄走,一张"什么任务、用什么数据、谁确认、怎么回流"的渠系图抄不走。它长在组织里——具体说,就是你的工作流定义、MCP 连接、Skill 库、评测集这一整套东西。这些,才是真正抄不走的资产。
第三,AI 普及的瓶颈,最终是组织地形。
不是技术,是组织。技术问题三年内会被解决,组织问题十年都未必。
八、本篇小结
可以把这一篇压缩为三点:模型、数据和工具要先接成可调用的水源;能力要按岗位与流程分配,而不是让一个通用助手包打天下;最后必须有评测、护栏和反馈闭环。没有后两项,接入越快,代价往往越大。
下篇预告
到这里,还有一个更大的问题必须回答:
既然 AI 落地靠的是"水网"和"制度",那放大到国家,什么样的制度更会治水?
不同文明,面对水,会给出截然不同的答案。这些答案,几千年后,长成了制度,也正在决定这一轮 AI 竞争的走向。
而中国——一个以治水为制度基底长出来的文明——手里可能握着一张被严重低估的牌。
《AI 进入企业,是一场治水(下):AI竞争下半场,拼的是谁能把AI用进生产一线》,最后一篇见。
内容你随便拿去用,@野生羊老师 就行
让我也顺便蹭蹭你的流量呗
联系我们:YimingAIDada