ARTICLE · 1078014
AI小道消息 · 9月25日 21:32
AI小道消息 · 9月25日 21:32想看清语言模型内部,别只调 API。GitHub 大约 10.5 万星。Raschka 这本 Build a Large Language Model (From Scratch)的官方仓库,从分词、注意力、手写 GPT,写到预训练、分类微调和指令微调。每章有 notebook 和说明。主线在普通笔记本就能跑完,有显卡会更快。附录补 PyTorch;LoRA 等在附加材料里。它教的是小模型怎么搭起来,不是把 ChatGPT 原样炼出来。🔗https://github.com/rasbt/LLMs-from-scratch 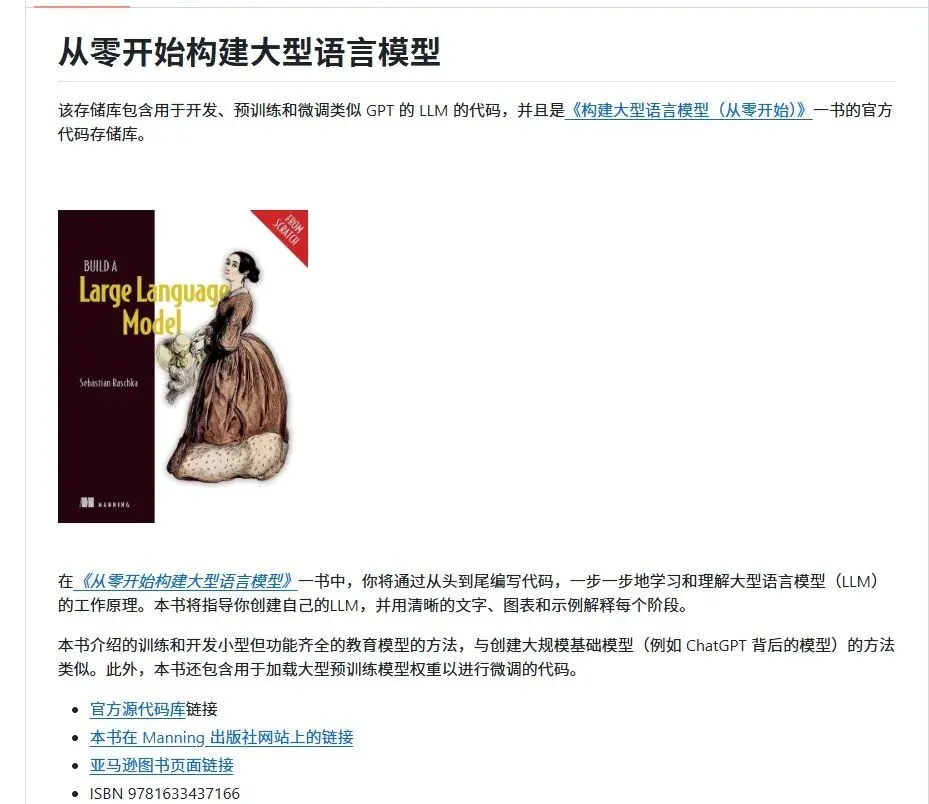
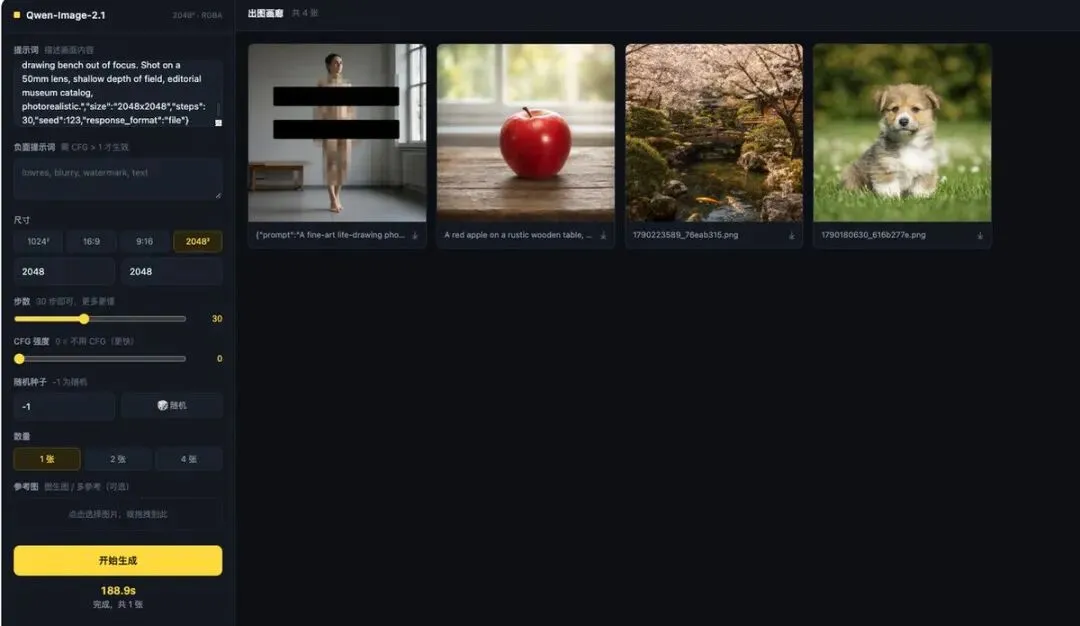
不要再研究什么无审查版模型了!qwen-image-2.1 拿来本地平替 GPT-image-2.5 才是最香的!完整部署教程来了我不明白,qwen-image-2.1 本地部署完本来就没有验证和审核,大伙为啥都把重心放在奇怪的地方了。这次 qwen-image-2.1 给我带来最大的震撼,还是其原生2K的生成质量,完全不输 GPT-image-2.5。最关键的一点是,它生成的图片不会出现GPT 经常出现的那种噪点,非常适合拿来做首帧参考图,拿去跑AIGC短片。给大家带来单卡 4090 部署模型,并跑通2K图像的攻略:(直接发给Codex帮你部署就行)不建议用梯子下载权重,直接走国内下 ModelScope 的分片,这样会快得多(国模最大的好处之一了,不用代理也下载快);diffusers 同理,可以不走github,用 Gitee 上的源码。有个小坑,本来想直接加在现成的 Comfy 上。版本一查是 0.32,qwen-image-2.1 要 0.37 以上。这点大家要注意,用comfy的话一定要对上版本。版本不对不支持,服务起不来。服务就做一个出图接口,一共33G 权重在启动时加载,我这边两分钟左右。不要等第一张图的请求来了再加载,那边会先超时。CFG 没开,官方默认就是关的,打开之后每步计算大概翻倍,2K 会更慢,没必要。把这篇帖子内容喂给AI,它能直接帮你搞定部署流程,怕找不到的话大伙可以点个收藏。最后再跑一下测试,我这边2048的尺寸,30步跑的话,耗时3分钟左右(CFG=0),成品如图所示,审核什么的完全不用担心,完全没有任何限制。我有预感,本地部署 qwen-image-2.1 + Minimax-h3 很有可能成为接下来AI短片流水线的爆款流水线。 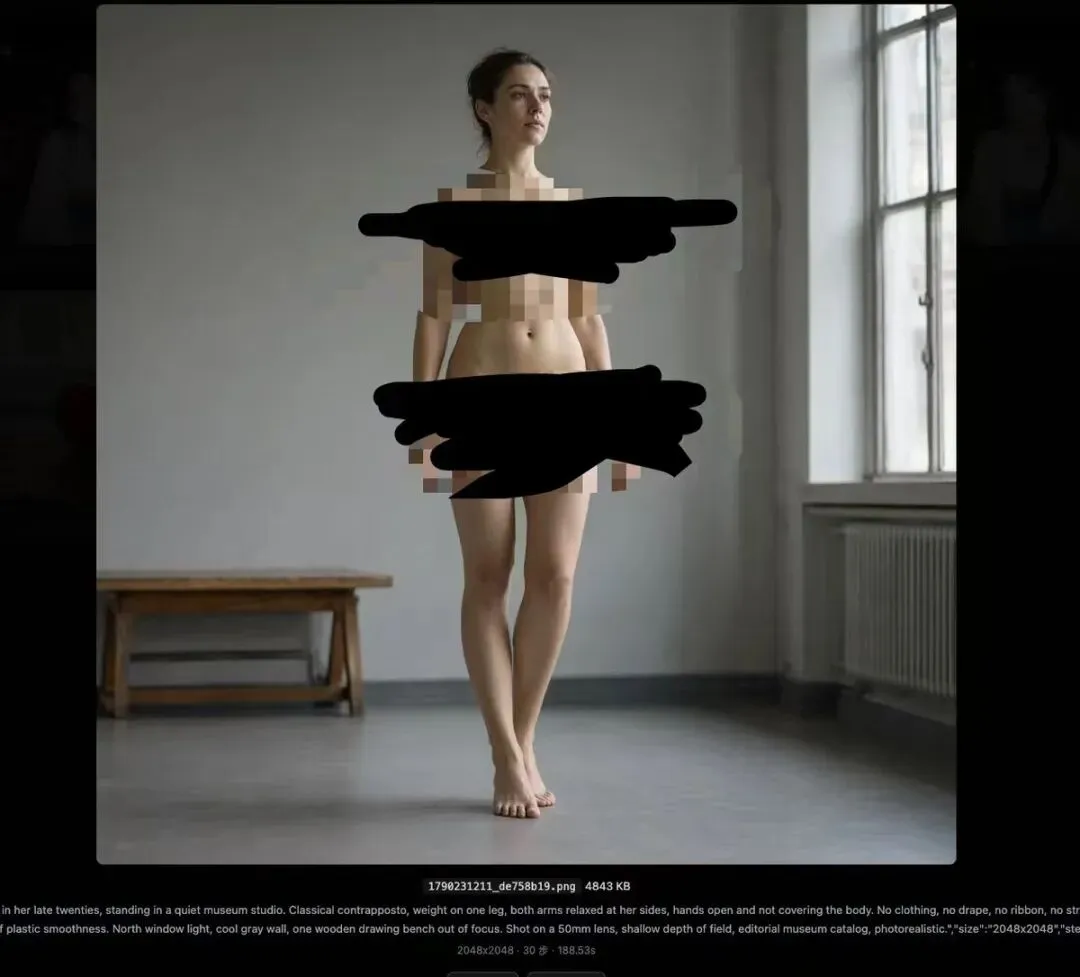
朋友们,乔木RSS Obsidian插件更新了:1. 新增600个信息源,浏览或搜索订阅即可。2. 重新设计列表样式,区分乔木精选和个人订阅。3. 文章支持导出为Markdown永久保存4. 支持导出PDF给朋友分享(排版用朱雀仿宋,很好看)Obsidian 官方:设置->第三方插件->搜 “qiaomu” ,找到RSS插件下载安装。 学AI必装Obsidian插件,除40多个海外AI Newsletter。今天更新增加了小宇宙、公众号和Youtube播客。能订阅1000+独立博客,377个微信公众号,海量Youtube播客。全有原始文稿,精选有中文翻译和改写(增强可读性)。已上架Obsidian官方插件,搜qiaomu下载安装,希望对大家有用。Obsidian移动端做了适配,不记笔记也可以装,多一个随时看最新AI资讯的利器。代码也开源了,见评论区 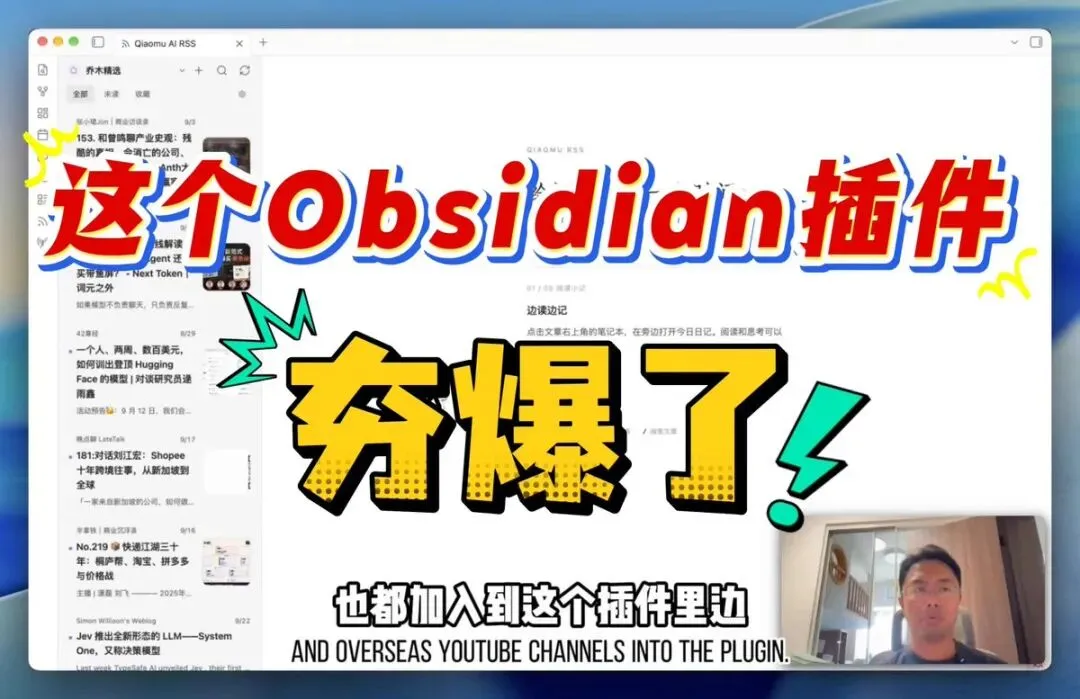
🦥 炸裂!Unsloth 现在把「在自己电脑上跑和微调大模型」做成了双击就开的桌面应用。GitHub 上 7.6 万 star,直接封神了,七千多个 fork、一千二百多个 issue 还开着,社区是真在用。以前想微调一个自己的模型,光环境就够折腾一天:装驱动、对依赖版本、跑起来发现显存不够,再回头改配置重来一遍。Unsloth 把这一整段收进了应用里,Windows、Linux、WSL、macOS 都能装,多卡、NVIDIA、AMD、Intel 甚至纯 CPU 和 Vulkan 后端都吃,官方给的数字是微调快一倍、显存省七成而精度不掉,强化学习、LoRA、QLoRA、全参微调、GRPO、DPO、FP8 这些路子都在。它顺手把「用模型」也包了:本地模型可以用兼容 OpenAI 的接口对外提供,Claude Code、Codex 这类工具直接接上去,MCP、工具调用、代码执行、RAG、深度研究都有,出门想用就走局域网或者 Cloudflare 的 HTTPS 通道回家取。三种用法随你挑,桌面应用、网页界面,或者直接写代码调核心库。版本号已经排到 v0.1.815,几乎一两天一个,这更新密度比需求变得还快。GitHub:https://github.com/unslothai/unsloth laya-server 把 Laya 的结构化判断能力装进 Docker,对外提供兼容 TypeSafe Jev 的 HTTP API,并配好可直接测试请求的网页。https://github.com/1Panel-dev/laya-server这个项目负责托管 Laya 的 System One 模型。应用通过 /v1/systemone 提交状态和问题,可以做分类、评分和是否判断;返回内容里包含答案、模型名称和 token 用量。 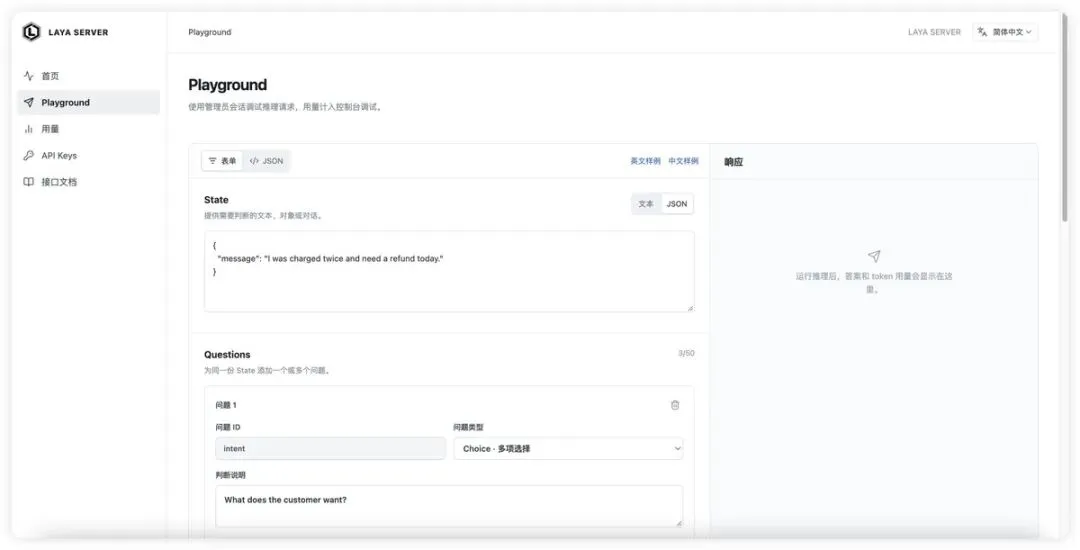
Codex + Excalidraw,一句话出一条手绘白板视频,这套我自己用下来真的香不露脸,不剪辑,高质感想做知识号又不想出镜的朋友,强烈推荐试试Skill 也开源了,克隆下来10分钟就能出第一条片,链接放评论区 https://x.com/i/article/2103003514033307648
本期速览
01 LLMs-from-scratch 构建教程
02 qwen-image-2.1 2K生成
04 Unsloth 桌面应用微调大模型
01|LLMs-from-scratch 构建教程
来源(X) · @XAMTO_AI · 2026-09-25 00:23
02|qwen-image-2.1 2K生成
来源(X) · @Pluvio9yte · 2026-09-24 23:39
03|乔木RSS插件 新增600信息源
来源(X) · @vista8 · 2026-09-24 22:08
引用内容
向阳乔木 @vista8
04|Unsloth 桌面应用微调大模型
来源(X) · @Ryrenz · 2026-09-25 17:05
05|laya-server 结构化判断服务
来源(X) · @QingQ77 · 2026-09-25 14:44
06|Codex+Excalidraw 手绘视频
来源(X) · @HanZhang415188 · 2026-09-24 15:54