ARTICLE · 1078600
AI 说"我接着上次干",最该担心的不是它忘了,是它把干过的又干一遍
我有个用了很久的习惯:每次跟 AI 干一件多步骤的长活,临关窗口前让它把状态存一份档——做到哪一步、定过哪些事、还剩什么没干。下次开新窗口把这份档读回来,接着上次往下。
我一直挺得意这套办法,私心里把它当成自己的断点续跑,就像打游戏存个档、下回读档回到那个点接着打。直到去读 LangGraph 的 persistence 文档和 Temporal 讲 durable execution 的那篇博客,才发现我那套读档,跟工程上真正的断点续跑差着一个要命的东西。
一、工程上的读档,是分毫不差地重走
先说工程师怎么让一个长任务崩了还能续上。
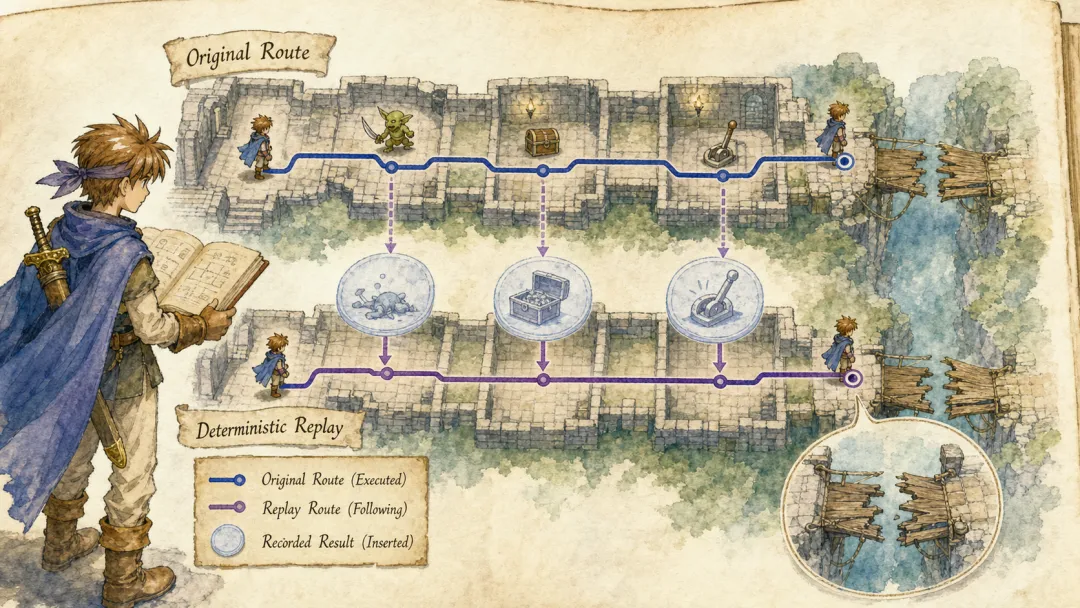
Temporal 那套范式的口号是"写代码就像崩溃不存在"。它不是说崩溃不会发生,而是说故障恢复这件事被从你的业务代码里抽走,下沉成了基础设施。具体机制叫 replay(重放):系统在任务跑的时候把每一步的输入和结果记进一本流水账;万一崩了重启,它不是从头重来,而是把你的代码重新跑一遍——但跑到那些账上已经记过结果的步骤时不真去执行,直接把账本里的结果塞回来。代码于是飞快快进,一路重走到当初崩溃的那一行,再从那儿真正往下干。
这套机制成立靠一个铁打的前提:确定性重放。重放时代码走的每一步必须和第一次分毫不差。第一次在某个岔路走了左边、账上记的是左边的结果,重放时你还得走左边——这次走了右边,账就对不上号,恢复当场崩掉。
所以工程上有条铁律:那些每次结果都可能不一样的东西——取当前时间、取随机数、调外部接口——绝不能直接埋在要重放的骨架代码里,必须单独拎出来、把结果记进账本。
我撞见过一个特别贴切的旁证。我现在用的这个 AI 工具,它那个定时唤醒的功能硬性规定:脚本里不许用取当前时间、取随机数这类函数,写了直接报错,给出的理由是它们会破坏 resume。一模一样的道理——会破坏确定性重放的东西,从源头禁掉。
二、能存下来的,才能恢复
LangGraph 走的是另一条路:checkpoint。它在图执行的每一轮推进结束后,把当前的完整状态打成快照存进持久层,之后凭同一个 thread_id 就能把它唤醒。
存了 checkpoint,三件原本很难的事同时变得可能:断点恢复(崩溃后从最后一个 checkpoint 接着跑,前面做过的不重做)、time travel(回退到任意一个历史 checkpoint,改点东西再往下分叉,用来调试和探索"当初那步换个决策会怎样")、以及中途暂停等人批准(把状态晾在持久层里,人回来了再 resume)。
但 checkpoint 有一道硬约束,很容易被当成细节跳过:状态必须可序列化。
checkpoint 的本质是把内存里的东西写到磁盘上。可内存里有一类东西天生序列化不了——打开的网络连接、文件句柄、数据库 session 、线程锁、一个正跑着的协程。它们的值和当前进程绑死,进程一死这些句柄就是空壳,存下来也没用。
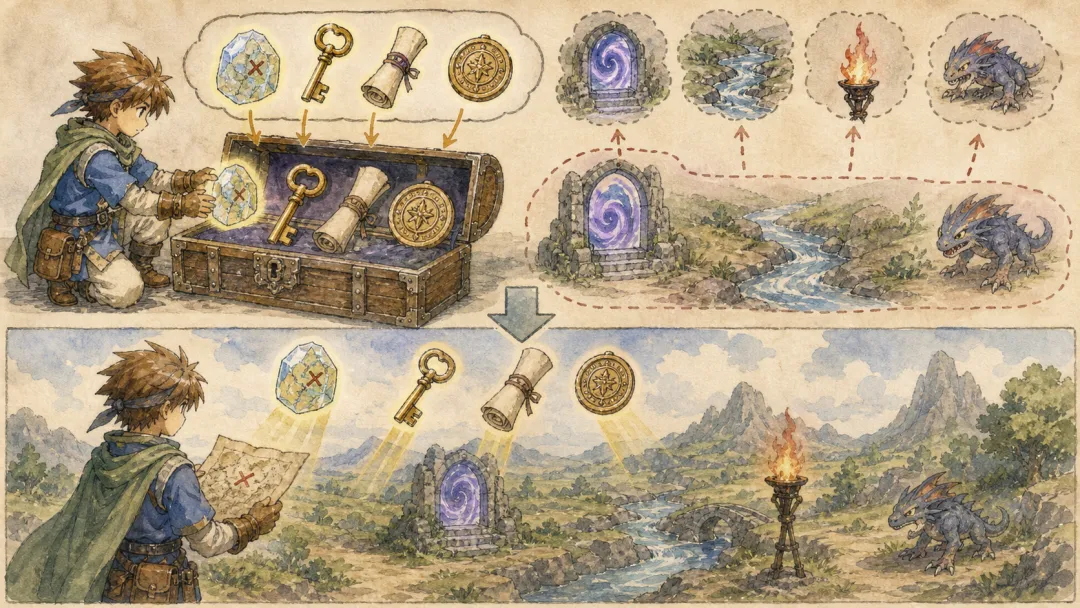
所以 LangGraph 逼你显式定义 state schema,里面只放纯数据:ID 、字符串、数字、消息列表这种离开当前进程依然成立的东西。由此推出一条很实的设计原则——
状态里该存的是"能凭它重新拿到资源的钥匙",不是"资源本身"。存 connection string,不存那个活着的 connection 对象;存文件路径,不存打开的文件句柄;存幂等键,不存那次正在飞的请求。
能不能恢复,第一道关卡就卡在这里:你的状态干不干净、序列化得动序列化不动。
三、 AI 的读档,是失忆者凭便签重走
回到我那套办法。我让 AI 接着上次干,是上面这两种吗?
都不是。因为我这套恢复的主角是 AI 本身,而大模型天生非确定——同样一句话喂给它,两次的回答都可能不一样。 temperature 调到 0 也只是减小漂移,不等于消除。这意味着你根本没法对一个 AI 任务做真正的确定性重放。
我能做的只是留一份笔记,让它下次醒来读着笔记重新判断该往哪走。这四个字是整件事的命门:它不是精确接上上一秒,是拿着我那份潦草的笔记重新做了一遍决策。这一遍完全可能走出一条跟上次不一样的路。
顺带说一句,这也是同一个词在两处的粒度差异:工程上的 checkpoint 存的是"图的完整可序列化状态、为了进程级断点续跑";我那份存档存的是"做到哪、定过什么、还剩什么、为了让下一个窗口的 AI 接得上"。同一个直觉,但恢复的粒度和由谁来重放,完全不是一回事。
打个不太恭维它的比方。工程的断点续跑像游戏读档,世界精确还原。 AI 的读档更像一个每天失忆的探险家:每次醒来只揣着自己昨天写的潦草便签,上面歪歪扭扭写着"好像往东走过、好像开过那扇门"。他靠便签大致拼出昨天干了啥,然后重新决定今天往哪走——可能这次改主意往西,也可能把那扇昨天已经开过的门,又推一遍。
四、“又推开一遍”,正是会出事的地方
平时这没什么大不了。可一旦被恢复的任务是"做了一半、中途动过真东西"的,麻烦就来了。
动过真东西,指它已经产生了实打实收不回的后果——发出去一封邮件、下出去一单、往记忆库里写进一条记录。它干到这一步崩了,你让它读着便签恢复,它重新决策到这一步,盘算着"接下来该发那封邮件"——于是又发了一遍。
工程上对这一刀早有防备,就是 idempotency key:给每个有后果的动作配一把唯一的钥匙,同一把钥匙无论来几次,那件事在真实世界里只发生一次。这两套机制是严丝合缝咬在一起的——durable execution 负责"崩了能续上、续到正确的那一步",幂等键负责"续上去重做的那一步,副作用不翻倍"。少了任何一边,长任务的恢复要么续不上,要么续上了但用户被重复扣款。
可我那套笔记式恢复压根没有这把钥匙。它能让 AI 大致接上上次,却拦不住它把动过真东西的那一步又做一遍。我琢磨了半天才敢承认:这套办法这么久没出大事,多半只是因为我的任务很少恰好崩在"做了一半、又刚好动过真东西"的那个瞬间。
这是运气,不是设计。
所以我给自己记了一条规矩:以后但凡要让 AI 从中断处恢复一个已经动过真东西的任务,我不能想当然地以为它会像游戏读档那样接得天衣无缝。我得自己去当那把幂等钥匙——在放它往下跑之前,先亲手核一遍"这一步它上次到底做没做",确认清楚再让它继续。
便签当然救命,没有它那人连昨天干过啥都不知道。但得始终记着便签的边界:它能帮人大致接上昨天,不能替他保证,他不会把昨天已经寄出去的那封信今天又寄一遍。
专业劈叉式跨界选手:🧬 医学出身,🎭 文化口饭碗,🤖 AI 是我的野路子。不卷参数,不追新模型,只关心一个问题:AI 啥时候能装进我脑子,替我不开心?欢迎围观我和 AI 相爱相杀的日常。——AI不会取代你,但会用AI的人会。所以我先学了,你随意。🔧踩坑副产品已开源 → recallnest,wechat-ai-bridge,telegram-ai-bridge | 更多 → github.com/AliceLJY参与组织 → CortexReach(memory-lancedb-pro 贡献者,setup-memory.sh 一键脚本作者)本文由 Content Alchemy 自动生成,由 Codex 发布。