ARTICLE · 1079753
文档太长何必硬塞 Token:从 Apple LensVLM 看视觉压缩的工程颠覆
让大模型阅读上百页的技术规范,工程团队通常只有两条路可走。要么把几十万字一股脑塞进上下文窗口,要么用向量切块做检索召回。第一条路会让显存瞬间吃紧,单次推理慢如蜗牛。第二条路会把表格和架构图切得支离破碎,模型根本看不到全局脉络。制约长文档理解的瓶颈,并不是上下文窗口不够大。真正的阻碍,在于线性字符解码的显存开销随序列长度急剧膨胀。
2026 年 9 月下旬,苹果在开源社区正式公开了多模态模型 LensVLM-9B(arXiv:2605.07019)。这项研究基于开源基座 Qwen3.5-9B 构建,探索了一种反直觉的文档处理路线。模型不再逐字逐句读取漫长文本,而是先把文档页面渲染成图片。它先在低维视觉空间里快速翻阅全书排版,再通过工具按需放大目标段落。这种两阶段设计不仅避开了向量切块的信息丢失,更将前序计算开销压缩了数倍。
01
SECTION 01
全量字符硬塞窗口容易拖垮推理吞吐
在实际业务场景中,一份百页 PDF 通常包含 15 万以上的文本字符。如果直接将全量文本送入大模型,系统必须为每一个字符分配注意力计算。
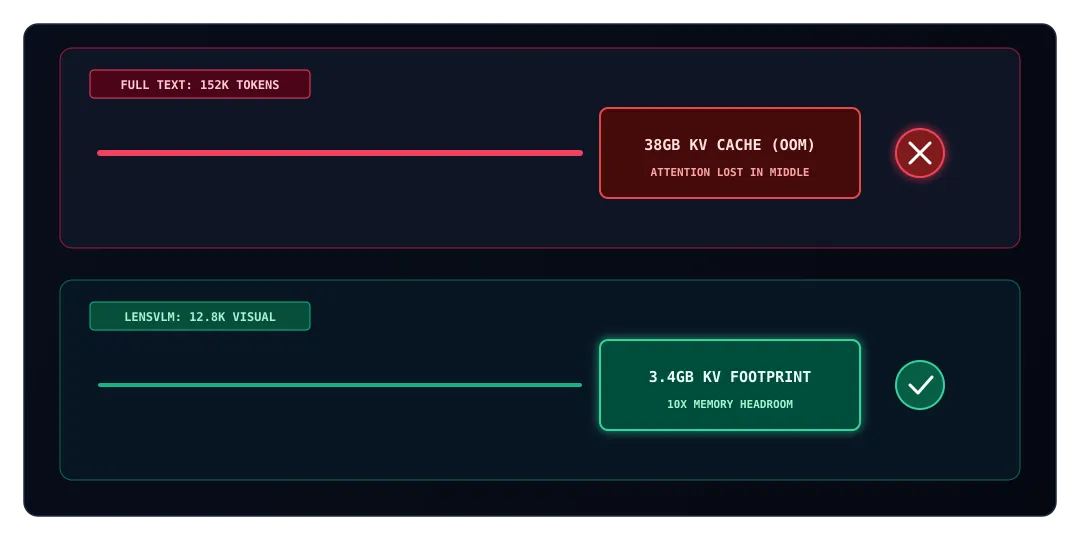
当输入序列达到十万量级时,模型内部的显存缓存会成倍激增。即便采用前沿的长序列优化技术,模型计算首字延迟依然需要数秒甚至十几秒。更为棘手的是长序列带来的注意力迷失。大量与当前问题无关的铺垫段落充斥在输入中,关键事实极其容易被背景噪音稀释。
为了降低推理成本,许多团队倾向于使用向量检索进行段落切块。然而工程实践很快暴露了物理切块的硬伤。现实中的技术文档充满了跨页表格、流程连线与多栏排版。机械的滑动窗口往往把同一个表格拆分到不同分块中。模型拿到了碎片化的文字片段,却失去了元素之间的空间相对位置。一旦问题涉及跨章节的架构比对,单纯依靠关键词匹配的检索系统往往无能为力。
长文档处理的本质矛盾在于,全量解码过于沉重而机械切块又丢失了排版语义。
02
SECTION 02
视觉粗筛配合按需展开阻断无效算力
人类工程师在查阅厚重手册时,从未从第一页逐字读到末尾。正常的阅读习惯是快速翻检目录和排版,找到目标章节再停下来细看。
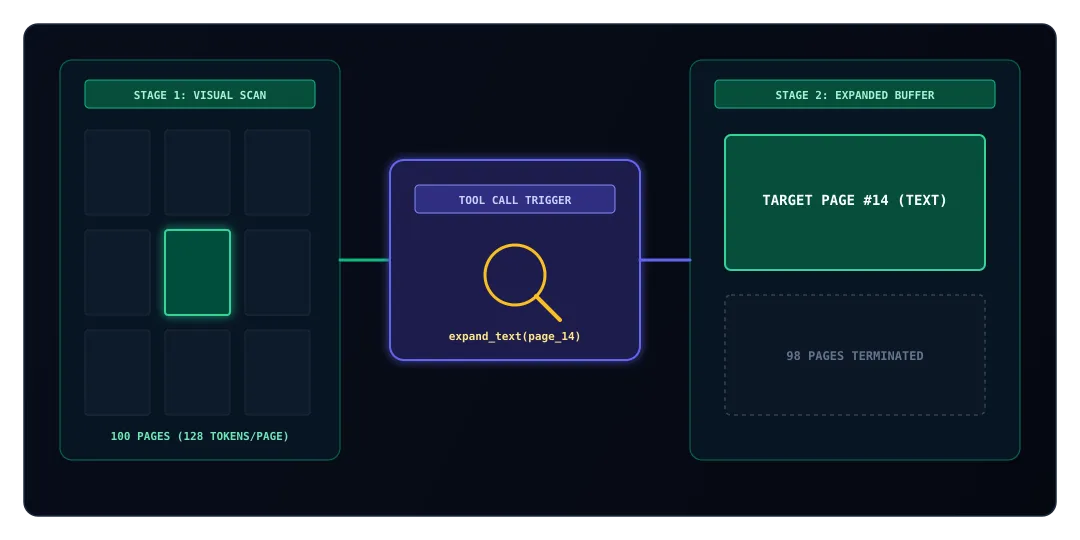
苹果 LensVLM 的核心突破,就是把人类的视觉翻阅习惯沉淀为工程架构。系统不再把字符当成一维序列,而是把每一页文档渲染为低分辨率图像。在视觉编码器中,一张页面的视觉标记数量是相对固定的。一页密密麻麻的千字正文,如果渲染为低清缩略图,只需消耗百余个视觉标记。整本百页手册的前序视觉输入,被压缩到了传统文本的十分之一左右。
缩略图能够看清大标题和图表轮廓,但无法辨认细小的字号。LensVLM 为此引入了名为选择性上下文展开的机制。模型在低清视觉流中完成全局扫描后,如果发现第 14 页包含关键数据,就会主动发起工具调用。系统调出内置的展开工具,只把该页的原始高精度文字拉入上下文。其余 98 页的内容则始终以极小的缩略图占位。
这种机制在执行路径上实现了彻底的提前终止。九成以上无关页面的高精度解码被瞬间阻断,算力只倾斜在真正包含答案的页面上。基准评测数据显示,模型在 4.3 倍有效压缩率下,准确率持平全量文本输入。即便在 10 倍压缩的极限工况下,其表现依然显著超越传统文本切块基线。
把全局扫描交给紧凑视觉并对局部细节实施按需调用,是长文档走向低成本落地的确定性解法。
大模型处理复杂现实任务,绝不等于无节制地挥霍算力与显存。将视觉粗筛与细粒度工具正交组合,系统才能在长序列与高吞吐之间找到稳定的物理平衡点。
我是随机比特,专注分享 AI Agent、Coding Agent 与一线研发实践。
如果你觉得今天这篇有收获,欢迎点赞、在看、转发支持,我们下篇见。