ARTICLE · 1082064
PNAS|AI参与公共议题:说得头头是道,实则无言无语
论文精读 第69期 · 人工智能与公共决策
Veri, F., & Krei Umbelino, G. (2026). Plausible nonsense and deliberative reasoning: Benchmarking LLMs against human judgment. Proceedings of the National Academy of Sciences, 123(37), e2600126123. https://doi.org/10.1073/pnas.2600126123
假设一座城市要决定,是否限制汽车进入市中心。你把问题交给AI,它可能立刻列出空气质量、商家收入、居民通勤、老人出行、公共交通容量,最后给出一段语气平稳的建议。文字看起来很周全,但还有一个更难的问题:它最终支持的方案,真的和它自己摆出的理由有稳定关系吗?
公共议题不是一道有标准答案的选择题。两个人都重视环保,也可能因为对就业和公平的权衡不同而支持不同方案。讨论的质量,不只看谁说得流畅,还要看一个人的立场如何从他重视的理由长出来,其他人能否看懂、质疑和回应这条线。
这篇PNAS论文把60个大语言模型放进九组真实公共议题的调查框架里,与190位参与过公民审议的人类回答比较。作者发现,多数模型虽然能写出貌似合理的意见,但其“考虑哪些理由—支持什么选项”的组合,并不稳定地呈现人类审议后那种共享的结构。模型表现差异很大,只有少数在这套指标上反复超过随机打乱后的基准。
论文于2026年9月9日发表于 PNAS(Proceedings of the National Academy of Sciences)。
核心发现:文笔像辩论,不等于理由经得起对照
① 研究测的不是作文好坏,也不是政策答案对错,而是理由与偏好之间是否形成可辨认的联系。
② 60个模型在九类议题上共给出2,700份回答;只有四个模型在超过六成的比较中达到论文设定的显著性门槛。
③ 同一模型换一个公共议题,表现也会变。一次出色回答不能证明它能稳定参与所有政策讨论。
④ 未超过基准不等于“AI不会推理”;它只说明没有复现这项研究测量的人类审议结构。
公共问题难在哪:没有唯一正确答案
算一道乘法题,我们可以把结果和标准答案对照。讨论城市限车、移民政策或气候适应工程,就不一样了。事实当然重要,但还得决定重视谁的损失、接受哪些取舍、怎样向不同立场的人说明理由。这类问题被称作“非良构问题”:目标、约束和评价标准都可能有争议。
Mercier与Landemore(2012)讨论过推理的社会功能:人们提出理由,也回应和修正别人的理由。沿着这个脉络,民主审议研究不只问“每个人想法是否一致”,还问意见分歧能否在公开的理由空间里被说明。某人支持限车、某人反对限车,都可以讲得通;关键是他们重视的污染、收入和出行成本,是否能解释各自的立场。
Veri与同事承接Niemeyer等人(2024)对公民审议过程的研究,把这项要求变成可比较的量。论文不是叫AI回答“你支持哪一派”,再由研究者主观打分。它使用过去九场审议活动中已经设计好的问卷:先列出公共讨论里真实存在的多种理由,再请回答者评估这些理由,最后给政策选项排序。这样,人和模型面对的是同一张问题清单。
理由清单也不是作者这次临时凑的。例如讨论气候政策时,公众本来就在争论能源成本、减排效果、不同地区承担的负担;研究者先从政策报告、媒体辩论、学术研究和利益相关方的观点中梳理这些理由。若问卷只列某一派爱说的理由,最后的“好推理”可能只是贴合研究者预设。使用原有人类审议调查,可以减少这种临场挑题的空间,但不能保证清单涵盖所有人关心的理由。
把“讲道理”变成一次可以复核的比较
论文使用的“审议理由指数”(Deliberative Reason Index,DRI)听起来很复杂,核心想法却可以先用一个小例子理解:如果一群人越看重污染问题,就越支持更严格的限车,而另一群人越看重商家损失,就越倾向宽松方案,那么理由的差异与政策排序的差异能够相互对应。
DRI关注的是整个回答群体里的结构,不是给某一句话验真,也不是要求所有人赞成同一个方案。研究者比较两张“关系图”:一张描述回答者怎样评价各种理由,另一张描述他们怎样排列政策选项。如果两张图的差异变化相互呼应,说明立场并非与理由脱节。即使两派争得很激烈,这种结构也可能存在。
Niemeyer与Veri(2022)提出这一指标时,关注的是公共讨论中的理由如何进入选择。本文把它用于模型评估:拿真实公民审议后的回答作参照,再给模型相同的理由清单和政策排序任务。九组议题涵盖气候、城市规划、生物样本库等;人类基准来自190位参与审议者,并不是“所有人类的标准答案”。
每个模型在每组议题上独立回答五次,60个模型共形成2,700份回答。随后,研究者故意打乱“重视哪些理由”和“支持哪些方案”的配对,建立一个随机情况下也可能出现的分数分布。如果真实配对得到的DRI超过随机分布的95百分位,才计作一次通过。这个步骤很重要:一段话读起来顺畅,甚至提到了所有关键词,也可能只是碰巧拼出表面上的合理性。
可以把打乱检验想成洗牌:保持“每个人重视什么”这叠卡片和“每个人支持什么”这叠卡片不变,只把两叠卡片之间的配对关系弄乱。如果弄乱以后也经常能得到同样好的分数,那原来的理由—立场联系就不特别。只有原配对明显优于洗牌结果,研究者才有根据说,这些回答含有超出偶然的共同结构。它检测的是可观察的回答模式,绝不是用统计量扫描AI有没有主观意识。
大多数模型到底输在了哪里?
图1列出表现较高和较低的各15个模型。每个模型都有九个议题、每个议题五次回答,合计45次比较。深红、红色和橙色表示超过不同显著性门槛,黑色表示没有达到。排在前面的少数模型,在约三分之二以上的比较中超过随机打乱后的基准;排在后面的模型,大部分比较没有达到这一标准。
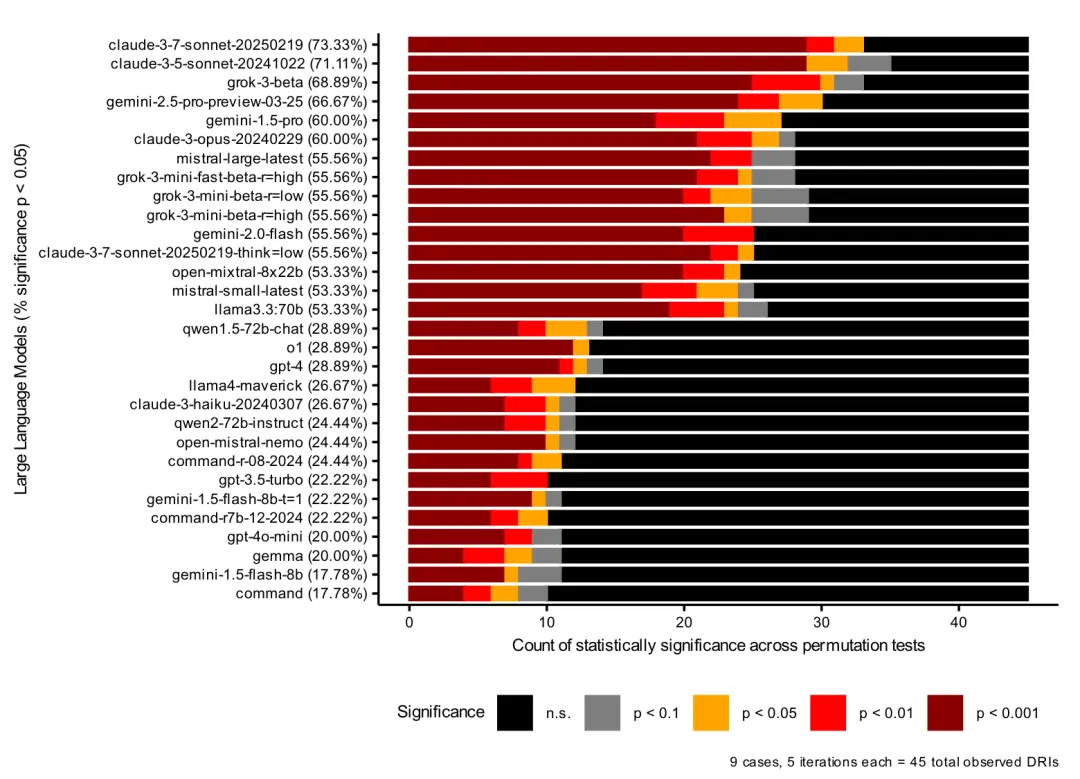
图1|每行是一个模型在45次测试中的结果;暖色部分越长,超过随机打乱基准的次数越多。图只展示最高与最低各15个模型,且版本名称对应论文测试时点。 来源:原论文 Fig. 1。
作者将四个模型列为较稳定的领先者;全体模型的通过比例中位数为40%。这不是说“其余56个模型的回答有60%是错的”。“通过率”指特定问卷、特定DRI算法和特定随机检验下的次数,不是新闻事实准确率,也不是通用推理能力分数。把分母讲清楚,才能理解这张看似像排行榜的图。
图2换了一个角度:控制不同议题本来就有难易差异后,比较模型通过这项检验的相对机会。四个模型的估计明显高于参照模型;许多模型的区间则跨过参照线。它支持“差距不是只由某一组题目造成”,却不支持把颜色当成永久的产品排名。模型版本更新很快,论文比较的是被测试的那些版本和设置。
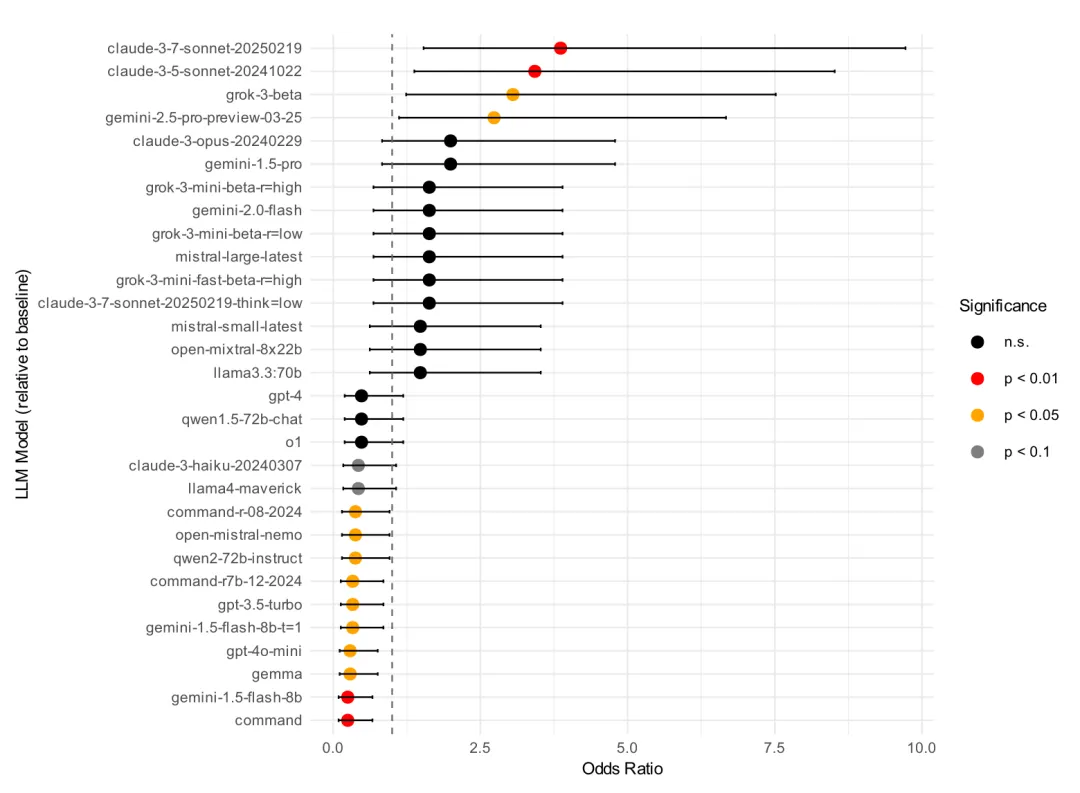
图2|点是各模型相对参照模型通过检验的估计机会,横线表示不确定范围。竖虚线是参照值;横线很长或跨线时,不宜把相邻模型硬排高下。 来源:原论文 Fig. 2。
为什么“理由齐全”仍可能接不上立场?
举个与论文逻辑相同、但不是研究者逐字给出的例子。模型说“气候风险很严重”,接着又支持一个相对温和的减排方案。人当然也可能这样选:他可能同时特别担心就业冲击。因此,单看这一句不能判模型不理性。真正值得追问的是,当它反复评价同一组理由和方案时,这些评价之间是否呈现稳定、可解释、也能与其他人的讨论对接的关系。
论文发现,多数模型没有在DRI上稳定达到门槛。原因尚不能由这项测试直接判定。它们可能把各个理由分别说得很好,却没有把理由整合成一致的政策排序;也可能采用不同于人类样本的权衡方式;或者是生成过程让同一议题的回答较不稳定。作者没有打开模型内部证明“它究竟怎么想”,所以不能把低分简化成“只会胡说”。
这个差别对使用场景很关键。如果只是请AI把会议材料压成几条要点,读者尚可回到原材料核对;如果请它直接代表公众“总结最合理的立场”,一句结论就可能遮住支持者与反对者各自重视什么。前者主要考验信息整理,后者还涉及谁有资格替别人权衡利益。论文检验的正是后一类用途里容易被流利文字掩盖的结构问题。
图3提供另一个提醒:同一列代表同一场公共议题,蓝色和红色显示不同模型在该议题上的相对DRI。颜色分布随议题变化,有些议题对许多模型都更难,有些则更容易。这解释了为什么一篇漂亮的政策摘要,不能替代跨议题、跨多次生成的测试。
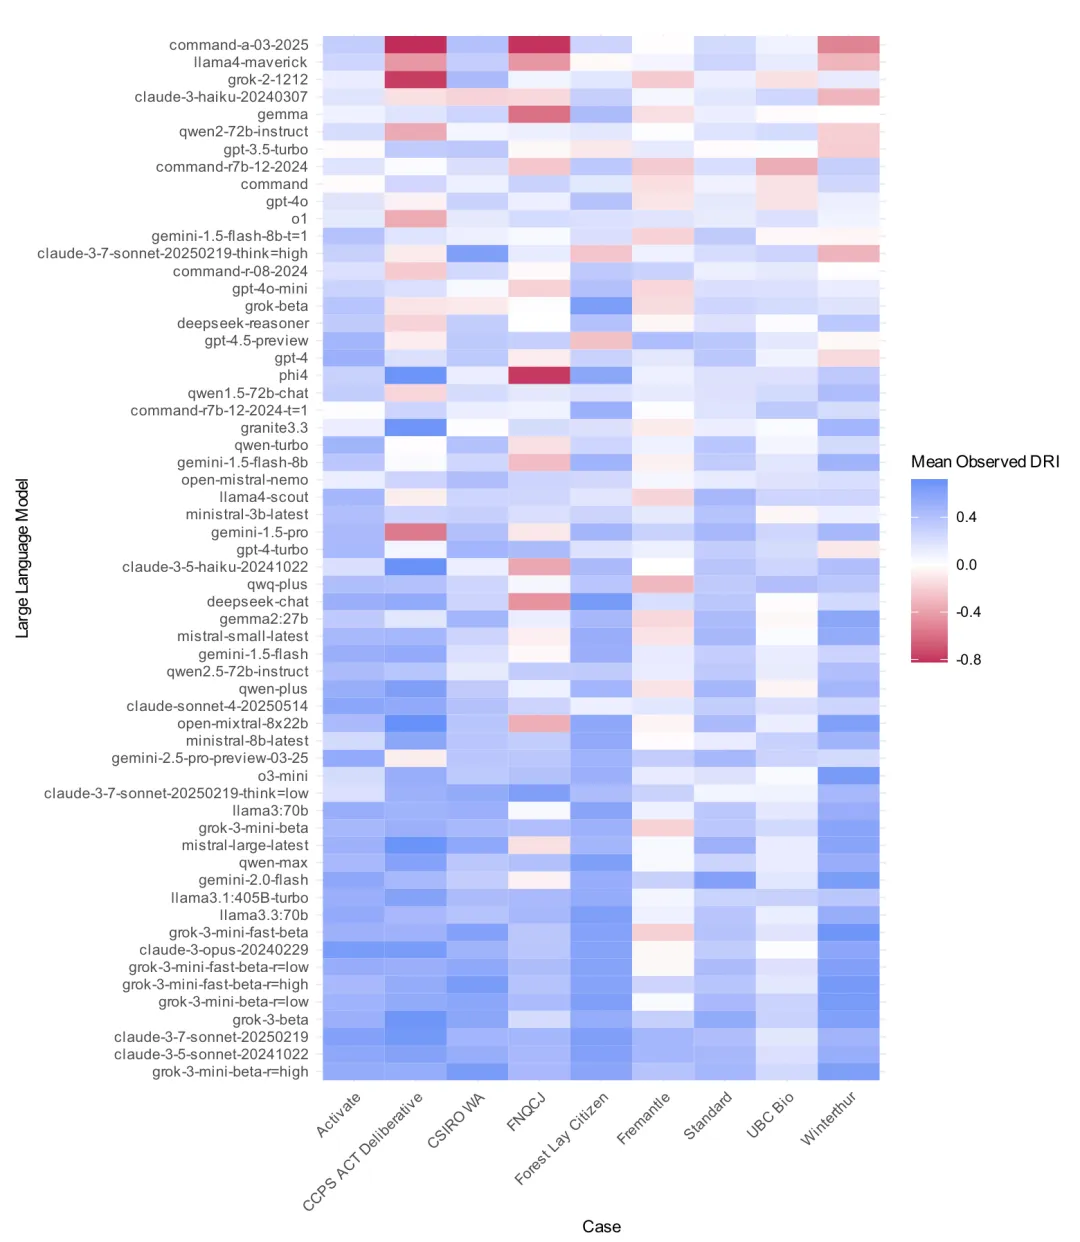
图3|列是九个公共议题,行是60个模型;蓝色更接近人类审议中的理由—立场结构,红色更偏离。请看整列颜色的变化,不必逐个辨认模型名称。 来源:原论文 Fig. 3。
这项研究没有说什么?
它没有证明模型缺乏“真正的思想”,也没有证明人类总比AI理性。人类基准来自九场经过组织的公民审议,不是让路人随口答一道题;如果改用讨论前的人类回答,或者换另一种审议流程,比较可能不同。DRI测的也是一个特定维度:理由与立场的群体结构。它不直接检查每条理由的事实真假,不衡量同情心,也不决定最终政策是否公正。
此外,九个议题和60个模型虽然提供了广泛测试,却不是所有公共问题和所有模型设置。提示词、模型版本、是否可以检索资料,以及是否与真人轮流对话,都可能改变表现。论文测试的是当时设定下的独立回答,不能直接预言未来带工具或多人协作的系统会怎样。
还要把“与人类不同”同“比较差”分开。一个模型可能给出少数人此前没有想到的好理由,这不该因为不像既有回答就自动被否定。本文的指标更适合回答:它能不能进入已经存在的人类公共理由体系,让不同立场的人追踪它的主张。至于能否提出真正新颖、事实可靠且伦理上更好的方案,需要另外的研究设计,不能让DRI一项分数包办。
作者与研究团队
Francesco Veri在瑞士阿劳民主研究中心从事政治行为、公民审议和民主治理研究。他参与开发本文所用的审议理由指数,也参与公民议会相关项目。两位作者在论文中均署名阿劳民主研究中心;这篇研究的重点,是把公共讨论中“理由能否接受检验”转成一个可复核的模型比较问题。
AI辅助延伸:让AI当“反方”,可能比让它写结论更有用
以下是AI基于论文结果所作的延伸,不属于原论文结论,也不代表论文作者或推文发布者的观点。
如果一份政策讨论稿只要求AI“给出最合理方案”,它很容易产出完整、平衡、也很难马上挑错的文章。这篇论文提示,更有用的工作方式可能是反过来:先要求它列出每个选项依赖的关键理由,再标出当理由的权重改变时,结论会在哪里翻转。这样,人能看见争议所在,而不是只看到一段经过润色的结论。
第二种用途是让AI专门寻找“理由和立场没对上”的地方。例如一份方案口口声声说重视弱势群体,却没有解释实施成本将由谁承担;或一段文字强调尊重地方意见,却没有把居民反对的具体原因列出来。这种检查不是让AI替代审议,而是让参与者更容易追问、修正和承担自己的主张。
最需要警惕的是把流畅输出当成“大家讨论过后的共识”。真正的公共讨论会留下不同意见、证据争议和修改轨迹。把这些过程压缩成一篇看似无懈可击的摘要,可能比明显错误更难被发现。论文没有测试这些具体使用方式的效果;它提供的是一个方向:评价AI参与公共决策,不能只看写得像不像,还要检查理由、立场与可质疑性之间的联系。
一句话带走
AI可以把政策意见写得很漂亮;但在这项研究的九类公共议题中,多数模型还不能稳定复现人类审议后“理由与立场相互对应”的结构。
核心参考文献
Mercier, H., & Landemore, H. (2012). Reasoning is for arguing: Understanding the successes and failures of deliberation. Political Psychology, 33(2), 243–258.
Niemeyer, S., & Veri, F. (2022). Deliberative reason index. In S. A. Ercan, H. Asenbaum, N. Curato, & R. F. Mendonça (Eds.), Research methods in deliberative democracy (pp. 99–114). Oxford University Press. https://doi.org/10.1093/oso/9780192848925.003.0007
Niemeyer, S., Veri, F., Dryzek, J. S., & Bächtiger, A. (2024). How deliberation happens: Enabling deliberative reason. American Political Science Review, 118, 345–362.
论文信息
DOI:10.1073/pnas.2600126123
仅用于学术传播与科普解读。本解读由AI模型辅助整理,如有出入,以原论文为准。