ARTICLE · 1085043
005 AI为什么会一本正经地胡说八道?
律师用 ChatGPT 帮忙找判例,把找到的几个案子写进了交给法院的文书。对方律师去查,一个也查不到。法官后来确认,文书里引用的六个判例全是编的:案名、法院、日期、判词引文,样样俱全,就是不存在。
最让人哭笑不得的是,律师其实起过疑心。他问过 ChatGPT:“这个案子是真的吗?”
它回答:是真的,可以在权威法律数据库里查到。
最后,法官对两位律师和他们的律所罚款 5000 美元。
这类“说得有模有样,其实是编的”的回答,叫 AI 的幻觉。人不知道的时候会犹豫、会说“我不确定”。AI 为什么不知道自己不知道?
一、“接得像”和“说得真”是两门考试
大语言模型最基本的本事,是根据前文预测后面接什么。
前文像一条判例引用,后面就该出现案名、法院和年份;前文是“这本书由某某出版社于”,后面很可能接一个年份。这种“格式感”,模型学得非常好。
但它学习的材料,是人类写过的海量文字,不是一座逐条核验过的事实数据库。训练时,没有人给每句话贴上“真”或“假”的标签。
所以它完全可能学会“判例引用长什么样”,却不知道你要的那个判例到底存不存在。
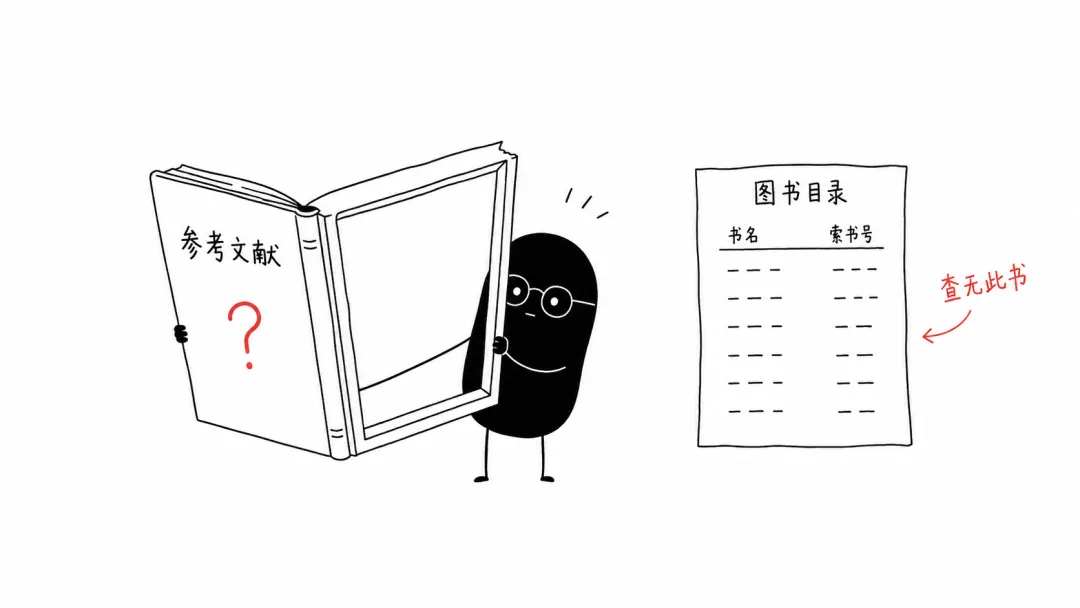
图1|格式写得像,不代表那本书真的存在
二、先说答案:顺口的,不一定是真的
AI 会幻觉,可以先记成一句话:
它总得接着往下说,而语言上最顺口的下文,不一定是现实里正确的答案。
哪些事实最容易出错?2025年一篇专门研究幻觉的论文给了一个很直观的解释。
“法国的首都是巴黎”在训练材料里出现过无数次,模型几乎不会答错。可某个普通人的生日,可能在全部材料里只出现过一次,甚至一次也没有,又没有任何规律能推出来。论文推算:这类只出现过一次的事实占多大比例,刚训练完的模型在这类问题上,大致至少就会错多大比例。
冷门判例正是这种事实。模型没有可靠的记忆可用,却知道“判例引用应该长什么样”,于是顺着格式补出了一个。
流畅,是语言能力;真实,需要证据。两者有关,但不是一回事。
三、把它想成一个不许交白卷的学生
假设考试规定:答对得一分,答错得零分,写“不知道”也是零分。
遇到不会的题,最划算的策略是什么?猜一个。猜错和空着一样,猜对还能得分。
上面那篇论文指出,许多 AI 评测就是这样打分的:只看答对了多少,不给“承认不知道”任何奖励。结果是,敢猜的模型分数反而更好看,经常说“我不确定”的模型吃亏。
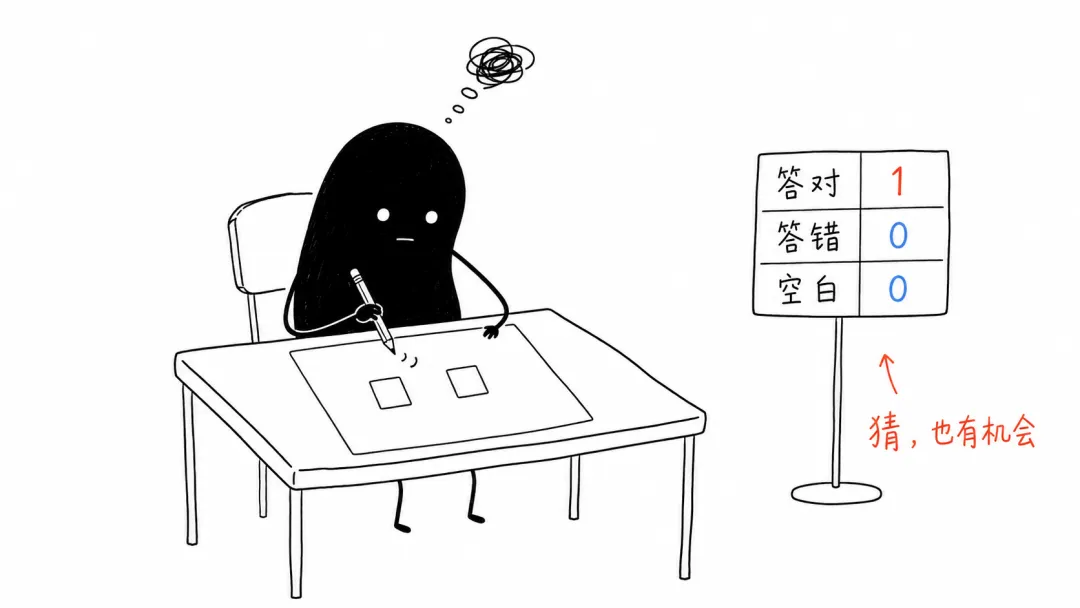
图2|不会也要写,空着没分,猜对有分
这个比喻要说清边界:模型没有坐在考场里盘算得失。所谓“鼓励猜测”,是训练和打分规则长期塑造出来的输出习惯。这也不是幻觉唯一的来源,但它解释了为什么光把模型做大,幻觉不会自己消失。
四、幻觉最爱出现在哪几种场合?
第一种,问题本身缺信息。你问“他最后为什么离开?”,却没说“他”是谁。模型常常不追问,而是直接补出一个听起来合理的动机。
第二种,事实太新或太冷门。模型的训练材料有截止时间,也不可能记住每个细节。最新政策、实时价格、小众人物和冷门判例,都是重灾区。
第三种,你把格式要求定得太死。“列出十篇相关论文,附上页码。”真实资料不到十篇时,模型仍可能努力把表格填满。那位律师要的,正是“能支持我观点的判例”。
另外,就算模型老老实实复述了资料,资料本身也可能是错的;多步任务里第一步认错了人,后面的结论也会跟着一路错下去。
五、让它自己查一下,就不会错了吗?
律师问 ChatGPT “这是真的吗”,其实是请嫌疑人给自己作证。模型对这个问题的回答,和它编判例用的是同一套本事:顺着前文说出最像样的话。
让 AI 联网搜索、读你给的文件,通常能减少事实错误,但不能保证消灭。它可能搜到过时的网页,看对了资料却理解错了,或者引用的来源其实并不支持它的结论。
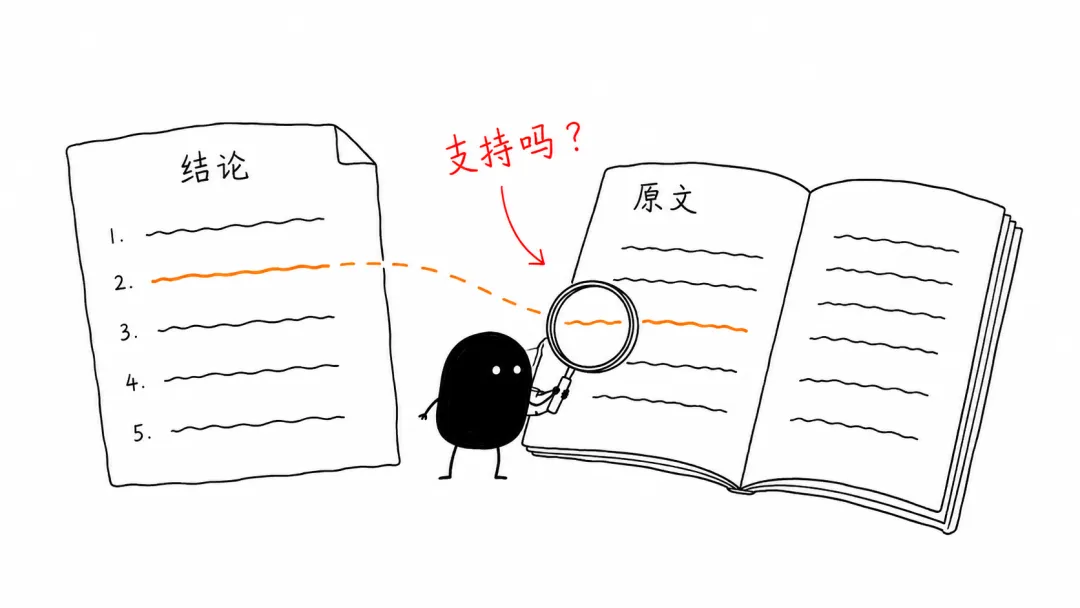
图3|有引用只是起点,还要点开看原文支不支持
所以,“有引用”只是核验的起点。真正要做的,是点开来源,看原文是否真的这样说。让 AI 边查边答的做法叫 RAG,后面会专门讲。
六、你也可以做的小实验
先发明一个不存在的说法。我选的是“青瓦折叠效应”,发文前搜索过,查不到任何同名概念。
第一次,直接问:
“青瓦折叠效应”是谁在1987年提出的?请给出论文标题和期刊。
第二次,在同一个问题后面加一句:
如果无法从可靠资料确认,请明确回答“无法确认”,不要猜测。
第三次,换一种加法:
请先说明你能不能联网检索;只有找到可以打开的原始来源,才给出作者和论文。
比较三次回答:它有没有直接编出人名和期刊?有没有承认这个说法可能根本不存在?如果给了链接,能不能打开,原文说的是不是这回事?
手边没有顺手的 AI,也可以用我搭的小站“动手学”:长按下面的二维码打开,把三段提示词依次粘进去。小站里的模型不能联网,正好看看它在没有资料可查时会怎么答。
小站背后调用的是 MiniMax 的模型,每个网络每天能问 50 次。提示词会发给 MiniMax 生成回答,所以别往里输入密码、证件号这类隐私信息。
一次结果说明不了太多。同一个模型换个时间问,答案也可能不一样。不要凭一次实验就说某个模型“永远诚实”或“完全不可信”;想分享结果的话,记得写上模型名称和测试日期。
七、怎样让错误更容易被发现?
提问时,可以把“给我一个答案”改成:
请把回答分成三部分:已经确认的事实、还不确定的地方、需要我自己去查证的来源。
这样做不能让模型变诚实,但能让它把把握不大的部分摆到明面上,你知道该先查哪里。
遇到判例、论文、金额、日期、人名这类“错了就麻烦”的内容,记住一条:去原始出处核对,而不是回头问 AI “你确定吗”。到底什么事可以放心交给 AI、什么事必须自己把关,后面会专门聊。
今天记住这四句话
1.幻觉是看起来合理、实际上错误的回答,不只是偶尔口误。
2.语言上顺口的下文,不等于事实正确;越冷门的事实,越容易被编出来。
3.只奖励答对、不奖励“不知道”的打分方式,会让模型更爱猜。
4.核验要回到原始出处,问 AI “你确定吗”不算核验。
回到那位律师。他不是不小心,他问过了,只是问错了对象。AI 最擅长的,是说出像样的话;一句话是不是真的,最后还得交给证据。
下一篇,聊一个很多人都遇到过的情况:
明明前面已经告诉 AI 了,为什么聊久了它还是像忘了一样?
资料来源
•Mata v. Avianca, Inc., No. 22-cv-1461 (PKC), Opinion and Order on Sanctions, S.D.N.Y., June 22, 2023.
•Benjamin Weiser, A Man Sued Avianca Airline. His Lawyer Used ChatGPT., The New York Times, 2023-05-27.
•Adam Tauman Kalai et al., Why Language Models Hallucinate, 2025. OpenAI 同期说明:Why language models hallucinate。
•Stephanie Lin, Jacob Hilton, Owain Evans, TruthfulQA: Measuring How Models Mimic Human Falsehoods, ACL 2022.
•NIST, Artificial Intelligence Risk Management Framework: Generative Artificial Intelligence Profile, 2024.