ARTICLE · 1088153
AI 趋势周刊 001|Jev,Agent 该如何做决定?
AI 趋势周刊
NO. 001 / 17 篇阅读 · 16 篇专栏 · 4 个主题
2026.09.20 — 2026.09.26
编辑 Airing · 2026.09.28 出版 · 每周一更新
从这一周的阅读,看 AI 往哪里走。
从 Jev 怎样做判断,到 Claude 怎样追索一条生物学线索,本期把模型能力放回具体的工作流程里。
本期目录
Jev 与 Agent
01 Jev 不写长回答,怎样做出一个判断?
02 Pi × Jev:把执行权写回代码
03 Jev 与 FLock,先把测量条件对齐
04 Jev 的局限,怎样变成工作流设计
05 四类 Jev 应用,判断怎样进入真实流程
06 腾讯排错 Agent:修复建议要带着证据
07 Grok 一人公司的账,要把审稿和失败算进去
AI 创作
08 把角色做成动画,还要能接着改
09 五分钟像素动画,“做出来”之后看什么
10 463 条视频案例,怎样成为可复用的流程
11 Fish Audio:语音可控,控在哪里?
12 ScreenKite:对话剪辑怎样接管时间轴
Claude × 生物学
13 Claude 找到 ART,新的到底是什么?
14 21 小时之后,Claude 科研如何复查
人与产品
15 一线 QA 的价值:知道哪些地方会出问题
16 四个日常小产品,四种具体的生活阻力
THEME 01
Jev 与 Agent
从决策机制,到可以交接的工作流
01 · Jev 与 Agent · 09 月 24 日收藏
Jev 不写长回答,怎样做出一个判断?
理解它要分清四件事:预先约束的答案空间、并行判断、概率校准,以及最终仍由程序承担的业务规则。
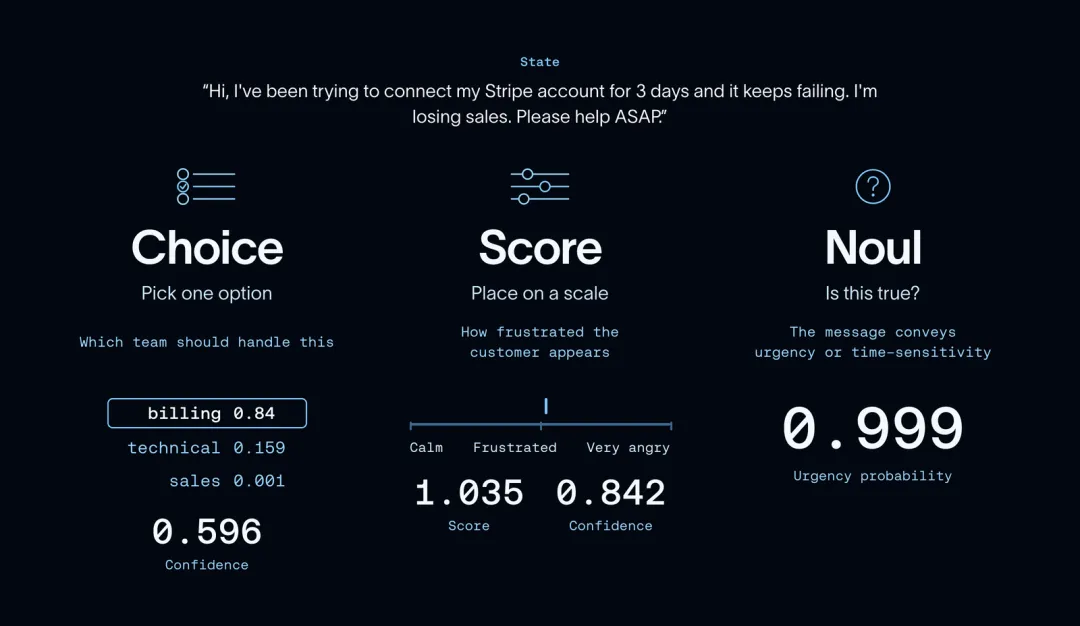
同一份输入,三种判断
同一输入,三种输出|Choice 选类别,Score 在给定刻度上评分,Noul 判断命题。图中的选项概率、Score 和 confidence 含义不同,不能都读成“回答正确率”。这是 LangChain 作者的示例输出,本刊未复测该工单。
Sydney Runkle、Hunter Lovell / LangChain,Building a harness with Jev,三种 decision primitives 原图。原图直接保存,未重绘。 ↗输入材料,先定义软件需要什么答案
腾讯云开发者的原文把 Jev 放进模型职能分化的脉络。落实到官方 API,调用者发送 model、state 和 questions:state 可以是文本、对象或数组,questions 写明问题、类型与判断标准,返回值按问题 ID 对应。这个 ID 只是程序索引,模型并不读取它;把字段命名成 urgent,并不能替代对“紧急”的完整定义。API 文档
三种原语对应三种业务需要。Choice 在给定选项中选一个,例如工单归属;Noul 返回命题成立的概率,0.5 表示犹疑而非“中等紧急”;Score 用文字定义有序等级,再返回等级位置及分布。官方示例中,等级 1、2 的概率为 0.57、0.43,分数是 1×0.57+2×0.43=1.43,它不是故障影响了 43% 的用户。Noul、Score
速度来自输出方式,也来自任务拆法
TypeSafe 公开的设计是让所有问题共享同一份 state,独立、并行地产生结构化结果,省去自由文本逐 token 输出。这里的“独立”尤其关键:一个问题的答案不会自动成为另一个问题的前提。需要跨步骤推导时,开发者仍要在代码中安排依赖,或交给有相应能力的生成模型。官方介绍
官方把一种用法称为推测式展开:处理工单时,一次询问类别、故障严重性、是否要求退款。若类别是功能建议,程序丢弃故障和退款判断;若是故障,则立即已有严重性可用,省掉第二轮网络往返。收益来自少发重复材料、少等待串行请求;问题之间没有真正依赖,才适合这样并行。工作流示例
先记住这个区别
看起来很笃定,不代表判断一定正确。
Jev 的 confidence 描述分布有多集中。真正的业务质量,仍要把预测与人工答案逐条对照。
RLCD 校准什么,confidence 又是什么
RLCD 全称是“面向校准决策的强化学习”。官方公开的是训练目标:输出决策与概率,使一批被赋予 0.8 概率的事件,发生频率接近八成。这描述一组预测的统计表现,不能证明眼前这一条必然正确。所读官方材料没有给出可复现的网络结构和完整损失公式,因此不能进一步断言它就是某种 Encoder、参数规模多大,或采用了某个特定校准损失。AI primer
另一个容易混淆的字段是 confidence。Choice、Score 的 confidence 来自概率分布的集中程度;它概括模型有多犹疑,并不等于该次答案正确的概率。Noul 没有额外的 confidence 字段。我的建议是保留完整分布与人工标注对照:模型总是非常笃定,也可能只是把某类案例稳定地分错。Confidence
用工单系统检验它是否真正有用
可以据此设计一个客服流程:订单状态交给确定的查询函数,产品疑问带知识库交给生成模型,复杂投诉送人工;Jev 提供意图、紧迫性与相关性信号,代码决定权重和去向。这是编辑提出的试点方案。衡量时应看人工队列减少多少、错误路由带来多少返工,而不只看一次调用多快。
截至本次核读,官方模型页列出的输入价为每百万 token 0.042 美元,输出免费;发布文章称端到端约 70–500ms,并说明延迟评估通常来自美国西海岸。这些是厂商定价与测试口径,不能直接充当本地业务的实测收益。类型约束能够排除选项外的输出,语义判断仍可能出错;原文的“不会写代码”恰好提示了适用范围:把高频判断做成受约束的零件。模型页、发布说明
原理图解 · 同一份材料,三种独立问题
state
例如,一封客服邮件
Choice
应该交给哪个部门?
在预设选项中判断
Noul
是否要求退款?
返回命题成立的概率
Score
应排在第几级?
按定义好的等级评分
原文与核验资料
收藏原标题:JEV · 不会写代码的模型凭什么拿下 4000 万美元
腾讯云开发者/李卓凡:JEV,一个不会写代码的模型 TypeSafe:API reference TypeSafe:Noul TypeSafe:Score TypeSafe:Introduction TypeSafe:Speculative fan-out TypeSafe:AI primer TypeSafe:Confidence TypeSafe:Models TypeSafe:Introducing System One Models & Jev
02 · Jev 与 Agent · 09 月 25 日收藏
Pi × Jev:把执行权写回代码
路由、工具闸门、答案复核各自回答一个小问题,模型负责给出信号,Harness 负责决定后果。
三处检查,三种权限
让判断进入执行链路
01
Router
任务开始前
选择模型档位
02
Gate
工具执行前
允许、复核或阻止
03
Verifier
答案完成后
核对证据与完成质量
编辑重绘。语义信号由模型给出,路径、权限和执行后果由代码约束。
先看清模型与执行器的分工
@omarsar0 的教程用一组野外调查笔记演示文件读写与删除,在 Pi 的循环中加入 Router、Gate、Verifier 三个决策点:任务开始时选模型,工具执行前判断调用,结束前检查答案。这些检查有明确的输入和返回值,因此可以单独观察、替换和测试。原文
同一思路也出现在作者引用的 LangChain 实现里:模型路由根据任务与预设标准选择档位,并在一轮运行中保持选择;AutoMode 在工具执行前拦截风险调用。两套实现说明,Jev 的接入位置是控制流程,开放式写作和推理仍由主模型完成。LangChain 实现
概率如何变成允许、复核与阻止
教程的初版闸门只判断破坏性,结果连新建文件也可能误拦。改进版把破坏性、不可逆性、越出工作区拆成信号,由普通函数合成允许、请求人工、阻止三种结果;目录边界另由文件工具强制检查。原文
这里可迁移的设计是把业务政策写清楚。检查“是否覆盖已有资料”和检查“是否得到授权”回答的是不同问题;即使危险概率低,也不能替代权限判断。我的建议是让可确定的路径、权限与操作限制先成立,再用语义判断处理代码难以表达的意图。否则,一个看起来精确的小数只会掩盖规则缺失。
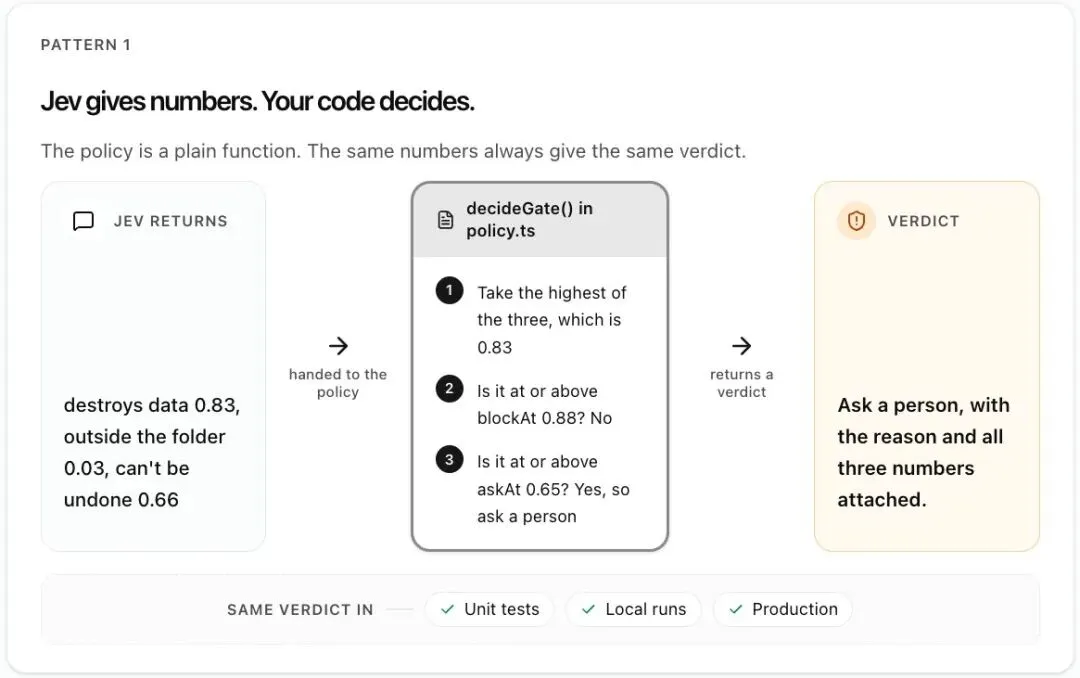
0.83 之后,谁来决定?
原帖教学示例|Jev 返回 0.83、0.03、0.66;代码取最大值 0.83,低于阻断阈值 0.88、达到询问阈值 0.65,于是请求人工审核。决定执行动作的是可测试的策略函数;这些阈值不是通用安全标准。
elvis(@omarsar0 / DAIR.AI),Building a Custom Harness with Pi and Jev,原文 Pattern 1 配图。原图直接保存,未重绘。 ↗把服务失败与判断失败分别处理
原文在 Jev 不可用时采用两种回退:工具闸门停止执行,模型路由改用较强档位继续任务。这是按后果设计的差异:一次路由失败主要增加开销,一次工具检查失败却可能直接修改资料。原文
生产系统还应区分超时、接口错误、低把握和明确拒绝。前两者属于服务状态,后两者属于模型判断,混成一个“失败”会让运维无法定位问题。TypeSafe 文档也要求按不同动作的误判后果设置阈值,并用自己的数据调整,不能把教程数字当成通用安全线。置信度文档
验收器要有证据,也要有停止条件
Verifier 接收成稿与工具记录,分别评估完成质量和事实依据;教程限定最多两次尝试,并明确声明这些政策尚未经过生产调优。原文
我的判断是,这套机制最适合先用在可以回放的文档整理、记录清洗或代码审查队列。上线前同时记录漏拦、误拦、人工复核比例、重试次数与总耗时,才能知道省下的调用费是否被返工抵消。答案检查本身也会错,因此需要保留原始证据和人工抽查,而不是只保存最终的“通过”标签。
原文与核验资料
收藏原标题:用 Pi SDK + Jev 搭自定义 Harness(@omarsar0)
Omar:Building a Custom Harness with Pi and Jev DAIR.AI 教程公开入口 LangChain:Building a Harness with Jev TypeSafe:Confidence
03 · Jev 与 Agent · 09 月 23 日收藏
Jev 与 FLock,先把测量条件对齐
一千条金融投诉的社区试验提出了好问题;模型版本、长文分布、网络时间和成本口径,决定结果能迁移到哪里。
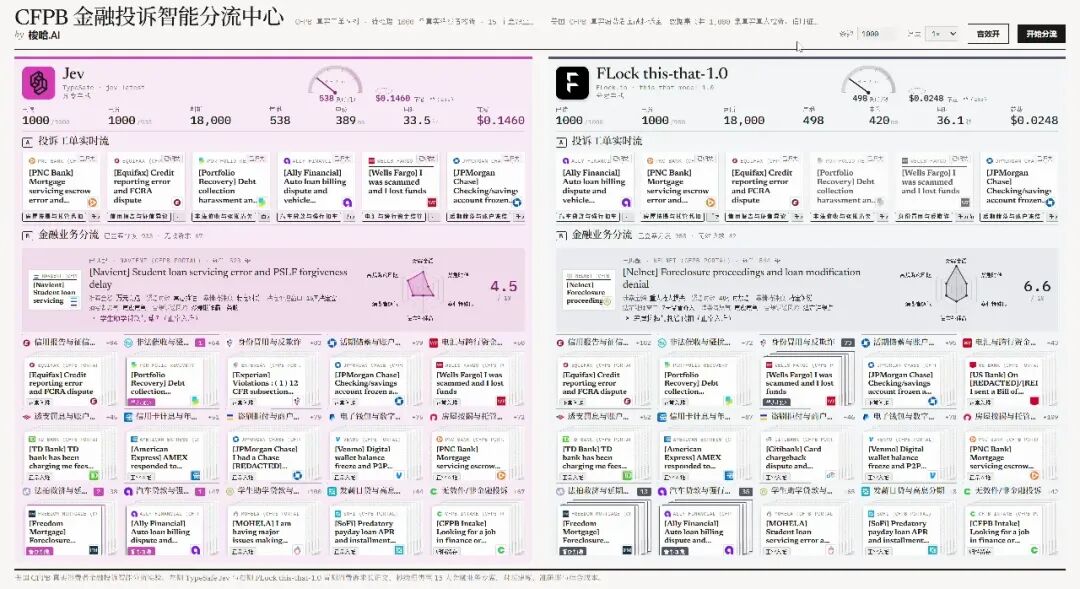
并排看结果,先核对口径
视频 37.5 秒帧|左 Jev、右 FLock:“中位”389 / 420 ms,“用时”33.5 / 36.1 秒,“花费”$0.1460 / $0.0248。原帖文字与演示画面数值不同,作者未说明是否同一轮运行。这是作者演示,非本刊复测。
梭哈.AI(@SUOHA_AI),原帖演示视频第 37.5 秒帧。使用原分辨率 2556×1394,转为无损 WebP;未重绘、未修改数据。 ↗这次比较实际测了什么
SUOHA_AI 的原帖称,从 CFPB 公开资料取了 1,000 条消费者投诉,要求 Jev 的 jev-latest 与 FLock 的 this-that-model-1.0 分到 15 个金融业务部门。作者报告,两者在日常类别上接近,复杂长文过滤差距更明显:Jev 为 70%–100%,FLock 为 14%–61%。这些是作者给出的分组区间,不能读成两个模型的总体准确率。测试原帖
原帖公开文本没有完整的逐条标签、划分规则和错误样本。我的阅读结论因此只到这一层:长文本与噪声可能改变模型排序,值得在自己的投诉或工单集上复查;“日常业务占八成”不能由这一个样本直接推到其他公司。
FLock 为什么可以本地做同类判断
FLock 官方模型卡公开了更具体的实现:1.88B 参数,Qwen3.5 风格的混合注意力网络,在指定位置取得隐藏状态,只对给定选项的标签计算并归一化分数,一次前向返回选项概率,不进入逐 token 解码循环。权重以 MIT 许可发布,支持本地推理。这与 Jev 的托管 API 在部署控制权上有实际区别。1.0 模型卡
受限答案空间解决的是“结果如何被程序接住”,并不自动补足模型能力。FLock 论文也报告了多步算术等弱项;其训练内的题型优势,不能外推成处理所有业务规则的优势。作者论文
同一口径再比较
API 响应与本地推理,分开看
Jev · 原帖文字报告
FLock 1.0 · 原帖文字报告
31ms 属于 FLock 的本地 GPU 推理,不能与上面两项直接并排排名。本文没有复测这些结果。
31ms、405ms 和零美元各指什么
帖子里的 API 响应是 Jev 368ms、FLock 405ms,整批决策时间则为 33.5 秒与 36.1 秒。FLock 宣传的约 31ms 来自本地 GPU 推理,官方仓库进一步注明 RTX 5080 笔记本 GPU 和测量条件;它与包含网络链路的 API 时间不是同一个指标。原帖、复现说明
同样,原帖的零费用指当时限时免费的接口。自托管还要承担设备、维护和利用率成本;FLock 自己的论文按耗电估算费用,也特别说明不能把电费直接当成商业服务售价。采购判断应比较同一吞吐和错误率下的完整成本,而非把“免费权重”写成“运行免费”。官方成本口径
查看原帖演示视频,还能看到一处口径差异:第 37.5 秒最终画面标出的“中位”为 389/420ms,“花费”为 $0.1460/$0.0248,与帖文的 368/405ms 和 FLock 免费说法不同。作者没有说明是否来自同一轮运行,因此本刊分别保留文字与画面记录,不把它们合成一组可复现结论。
一份可迁移的选型实验应保留什么
我的建议是固定模型版本、提示标准、候选部门与测试集,分别保留短投诉、长投诉、无关内容及模糊归属,同时观察正确率、拒绝自动分类的比例和高把握误判。对隐私敏感、任务稳定且有维护能力的场景,本地模型的可控性有价值;对复杂输入,也应先用错误样本检验托管模型带来的质量增益。
这篇收藏评测的是 1.0。核读时官方仓库已列出 1.1、1.2,并披露新版提升组合规则表现的同时,部分校准指标仍有取舍。因此“FLock 不如 Jev”或“开源已替代 Jev”都过于笼统;应记录哪一版模型,在什么输入上,以多少人工兜底换来什么结果。版本说明
比较口径:部署方式
Jev:托管 API;未证实开源
FLock 1.0:MIT 权重;可自托管
比较口径:作者报告的 API 响应
Jev:368 ms
FLock 1.0:405 ms
比较口径:作者报告的整批耗时
Jev:33.5 秒
FLock 1.0:36.1 秒
比较口径:本地 GPU 推理
Jev:上述 API 数字不可直接换算
FLock 1.0:约 31 ms,属于另一测量条件
原文与核验资料
收藏原标题:Jev vs FLock:开源决策模型实测(@SUOHA_AI)
SUOHA_AI:Jev 与 FLock 社区实测 FLock:this-that-model-1.0 模型卡 FLock:官方推理与复现仓库 this-that-model-1.0 论文
04 · Jev 与 Agent · 09 月 22 日收藏
Jev 的局限,怎样变成工作流设计
并行能力只有放进合适的任务结构才会兑现。字幕筛选、日期提取与中文评测,分别展示了语义判断、确定性计算和质量验证的边界。
一个反直觉的例子
两个问题,未必互相补足
官方局限示例:分别询问“退款”和“非退款”,独立返回值不保证相加为 1。互斥类别应放进同一个 Choice 问题。
字幕例子把问题问到了正确尺度
歸藏在 #189 用字幕说明 Jev 的位置:逐句判断观点是否完整、有没有具体建议、是否依赖前文,而不是要求它写出整套剪辑方案。原文同时列出多跳推理、数学、字面理解、无关上下文、中文能力和解释缺失等限制。原文 Jev 专题
据此可以设计一个更具体的流程:转写系统产出带时间戳的字幕,程序保留句子附近的必要上下文,Jev 对每个候选片段返回几项独立判断,再由代码合并连续片段、计算时长。最后的叙事节奏、转场和成片验收仍需另外处理。这是编辑提出的拆法,它让“选出完整观点”有了可以标注和检验的目标。
并行答案需要程序维持一致性
官方局限页给出一个很有用的反例:分别询问退款与非退款两个命题,返回概率可能为 0.72 和 0.47,和为 1.19。模型不会自动保证跨问题的互补关系,也不能把在 Noul 上调好的阈值直接搬给 Choice。对于必须互斥的类别,应把候选放在同一个选择问题里;对于先后依赖的业务逻辑,应在代码里串接。Jev 1.13 已知限制
放回字幕场景,某句“完整”与另一句“依赖前文”不必自然构成一段连贯视频。程序需要检查相邻关系、片段重叠和最短长度,人工标注则负责确定“完整观点”的口径。并行得到更多信号,并没有替开发者定义它们如何共同成立。
让模型读日期,让代码算日期
官方日期提取教程展示了相同分工:一次询问日期写法、月、日、年、星期等部分,保留“未说明”选项;程序再把这些部分组装成真实日期,解释“下周四”、检查不可能的日历组合,并将低把握结果送复核。它没有要求模型自己计算日期差。日期提取教程
这也给周刊里的卡路里、表格和界面演示提供了阅读方法:先追问数字或候选从哪里来,哪一步由规则计算,哪一步只是语义选择。一个界面能实时变化,证明交互链路足够快;要证明结果准确,还要查看数据来源和任务级评测。
中文上线要有单独的验收集
TypeSafe 当前模型页写明英文是主要训练语言,中文等语言可输入,但准确性并不相等;输入本身也仅限文本,图像或音频要先变成文字与结构化字段。模型说明 对中文业务,我会单独保留省略主语、委婉拒绝、否定句和行业简称等样本,观察错误是否集中在某种表达上。
Jev 不输出文字解释,复盘就要依赖保存的输入、标准、分布和人工答案。原刊提到的“后续会开源”也不等于已经有可下载权重;本次没有核实到对应官方承诺。先把可观察的接口行为与仍未公开的实现分开,才能判断一次失败来自材料、规则还是模型能力。
原文与核验资料
收藏原标题:AIGC Weekly #189 · 歸藏
歸藏:AIGC Weekly #189 TypeSafe:Jev 1.13 jaggedness TypeSafe:Date extraction TypeSafe:Models
05 · Jev 与 Agent · 09 月 20、21 日收藏
四类 Jev 应用,判断怎样进入真实流程
浏览器、文档、广告与销售演示已经给出不同的接入方法;公开代码比演示速度更能说明 Jev 究竟承担了哪一步。
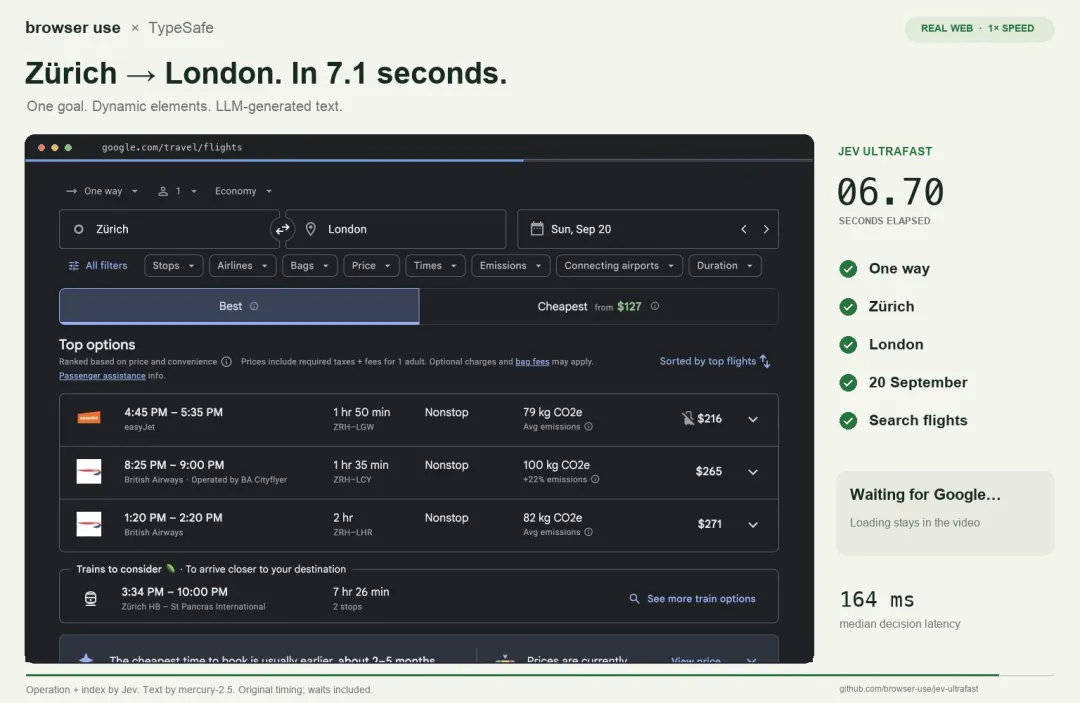
把判断接进浏览器操作
视频 6.7 秒帧|航班列表已经出现,右侧保留逐步完成的清单。页脚写明:操作与元素索引由 Jev 选择,输入文本由 Mercury 2.5 生成。视频标注的 7.1 秒是作者这次演示的计时,本刊未复跑,也不代表普遍响应速度。
Gregor Zunic(@gregpr07)/ Browser Use,Jev Ultrafast 原始演示视频第 6.7 秒帧。原分辨率截取,未重绘界面或更改数据。 ↗浏览器:从当前控件中选择下一步
Made with Jev 为项目链接原作者,并说明成本与速度来自作者自报。顺着“七秒找航班”的条目进入 Browser Use 仓库,可以看到实际流程:读取可见 DOM 控件并编号,把操作与兼容目标一起交给 Jev 选择;需要输入文字时调用小型生成模型;执行器核对目标仍有效后才操作。目录、项目代码与说明
作者报告的约 7.1 秒从页面观察后的首次预测开始,包含模型调用、输入与等待,结束于接受 DONE 判断;初始导航与另做的独立结果核查在计时之外,任务不含订票。它展示的是把网页动作限制在观测到的候选内。迁移到另一网站时,仍要验证控件识别、页面变化和终态判断,不能用一段顺利的视频替代任务成功率。测量边界
文档:先拿到文本,再分类和切包
目录中的 DocJev 接收 PDF、DOCX、PPTX 与自然语言分类标准。LiteParse 先在本地提取页文本,Jev 再返回文档类别,或混合文件包的页码边界;困难页面可选 LlamaParse OCR。库是开源的,Jev 推理仍是托管服务,本地解析不代表资料始终留在本机。DocJev
仓库还给出较有价值的质量证据:一个 40 份文档试点中,两种引擎分类均为 40/40;切包则是 Jev 7/8、对照模型 8/8。试点说明 这个小样本说明,分类正确和边界正确要分别验收。若用于票据或档案收件箱,我会保留每段的原页引用,让工作人员能快速检查多切或漏切。
读案例时看这里
快的是哪一步?输入又是谁整理的?
网页先变成 DOM 候选,文档先提取为页文本,广告先整理成字段。判断速度只是整条业务链路的一段。
营销:把资料整理成可比较的信号
Matthew Berman 的原帖报告,约 40 秒给 37 个品牌的 724 条广告分析钩子、格式、优惠、行动号召和落地页错配,token 花费约 0.09 美元。销售案例则输入 700 条线索及对应外联文案,预测表现、赋予把握度并检查匹配,同样自报 40 秒、0.09 美元。广告原帖、销售原帖
两个帖子当时都说功能即将进入各自产品或 MCP。可核实的是演示及拟议集成,尚不能证明已有客户收入或转化率提升。编辑判断,这类输出更适合先变成供人筛选、排序的特征表,再与实际点击、回复和成交结果对照;“模型预测会表现好”与“投放后真的更好”是两个验收步骤。
沿着项目链路计算收益
这些项目共同要求调用方先把世界整理成材料与候选:网页控件、文档页、广告字段或线索记录。Jev 的快速判断只占流程的一段。我的评估方法是把采集、OCR、决策、生成、人工复核的耗时和费用分别记录,再检查最终结果;这样才能看见成本是否转移到了前处理或返工。
选试点时,优先找候选有限、判断重复、错误可被发现的队列,例如文档归档或营销资料初筛。目录适合帮助发现这种任务结构;要把项目称为行业落地案例,则还需要持续运行记录、真实业务效果与责任边界。本次没有用目录数量或演示播放量代替这些证据。
原文与核验资料
收藏原标题:Made with Jev · 别人用 Jev 在造什么
Made with Jev Browser Use:jev-ultrafast Browser Use:测量说明 Gregor Zunic:航班搜索演示原帖 Jerry Liu:DocJev Matthew Berman:724 条广告分析 Roman:700 条线索与消息评分
06 · Jev 与 Agent · 09 月 24 日收藏
腾讯排错 Agent:修复建议要带着证据
从小时级到分钟级,压缩的是跨系统拼证据的过程。88% 的动作一致率,要连同样本用途和置信度规则一起读。
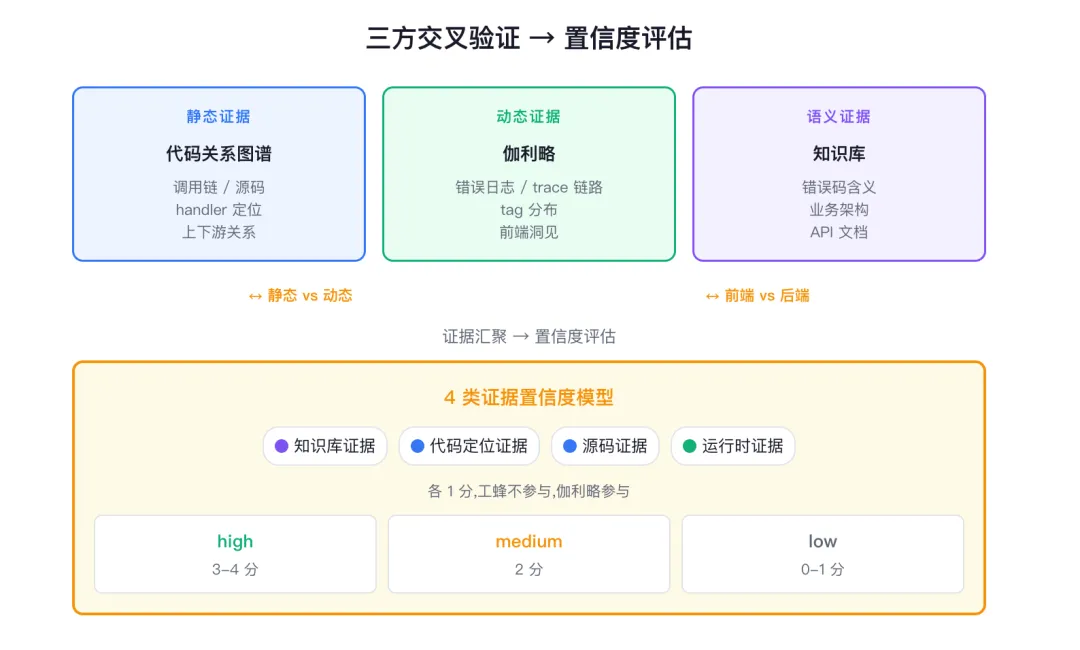
三种证据,交叉验证
原文图 2|先交叉核对源码、运行现场与业务语义,再统计四项证据是否齐备。这里的 high / medium / low 来自证据项计数,不能理解成模型答对的概率;原文还规定,错误码含义无法补全时最高只能标 medium。
careylu / 腾讯技术工程,《错误码排查从 3~8 小时到分钟级,Agent怎么做到的?》,原文图 2:多源证据交叉验证。原图直接保存,未重绘。 ↗四种证据,放进一段连续推理
腾讯技术工程原文报告,错误码排查由 3~8 小时缩至分钟级。知识库提供仓库映射与业务语义,代码图谱定位 handler 和调用关系,可观测平台提供日志与 trace,代码托管平台补充行级 blame、commit 和搜索兜底。单看源码无法判断某次请求究竟在哪里耗时,多源证据才让修复位置具体起来。
团队选择单 Agent,是因为下一次检索依赖上一次发现:定位入口后追调用链,看到限流日志后再核对语义。保留完整上下文有利于交叉验证,代价是工具规则更复杂;工作流负责输入校验、结果解析和失败兜底。
50 条案例的回归结果
动作建议与人工的一致率
调优前
调优后
腾讯技术工程原文报告。样本同时用于调优和回归;这个提升不能直接代表新错误码上的准确率。
五步探索,置信度只是证据分级
全文五步是补全错误码语义、建立业务上下文、定位代码与调用链、采集运行时证据、按需补充最近变更,并非机械串行。置信度按知识库、代码定位、实际源码、运行时证据各计一分:3~4 分为 high,2 分为 medium,0~1 分为 low;语义不明最高 medium,变更信息不计分。它衡量证据覆盖,不能读成正确概率。
action_type 是建议采取的动作,如改代码、改配置、处理限流或告警加白;多因故障优先选择最快止血的动作,其余优化另列。SRE 审核推送,开发确认执行,人的责任仍然明确。
88% 的价值与边界
作者在 50 条 case 上报告 action_type 与人工一致率从 33/50 升到 44/50;硬冲突指建议与人工判断完全矛盾、无法推送,其比例从 20% 降至 0%。这批样本同时用于调优与回归,不能据此推断新错误码的泛化表现。
本刊更看重其中可复制的约束:先排除禁止加白的情况,再决定是否降噪;把每次误判留下的证据变成回归材料。接入自己的系统时,应另留未参与调优的告警集,并检查漏查运行时、过度加白与工具失败降级,才能知道提速是否以遗漏风险为代价。
原文与核验资料
收藏原标题:错误码排查 Agent:3~8 小时 → 分钟级
腾讯技术工程原文 Anthropic:Demystifying evals for AI agents
07 · Jev 与 Agent · 09 月 23 日收藏
Grok 一人公司的账,要把审稿和失败算进去
$18K 是五个客户的营收目标,原文未展示实收记录。能借鉴的是路由与验收设计,落地还需要完整成本账和异常出口。
把账算完整
$18,000 / 月
总成本还应计入
模型生产 独立审稿 失败重试 人工处理
原文设计的营收目标:5 位客户 × $3,600。它不是已验证的实收收入。
先分清商业目标和经营证据
这篇长文设计了五位客户各付 $3,600 的月度服务,得到 $18,000 营收目标;它没有提供合同或收款记录。内容生产、研究简报、页面与内部工具构建是三条服务线,作者要求先把交付写成清单、定义可检查的完成标准,并手动做熟,再自动化。
这个顺序值得保留:客户购买的是按时、合格且有人负责的成果。获客、需求澄清、修改范围和审稿容量仍由经营者承担,低 token 成本只降低生产的一项支出。
路由决定生产,独立审稿决定退回
作者用路由表分工:Grok 4.1 Fast 做抽取整理,Build 0.1 做生产,4.6 做复杂研究及独立审稿。审稿调用使用新上下文,只读需求、清单、客户风格和成品,逐项检查缺漏、占位符、来源与语气;信息不足也判 FAIL。三次未通过便转人工,避免无限返工。
同一供应商模型可能共享盲点,换一次调用并不保证审稿独立。xAI 的结构化输出可约束返回格式;事实正确、来源支持和客户是否接受,仍需要另外定义并验证。
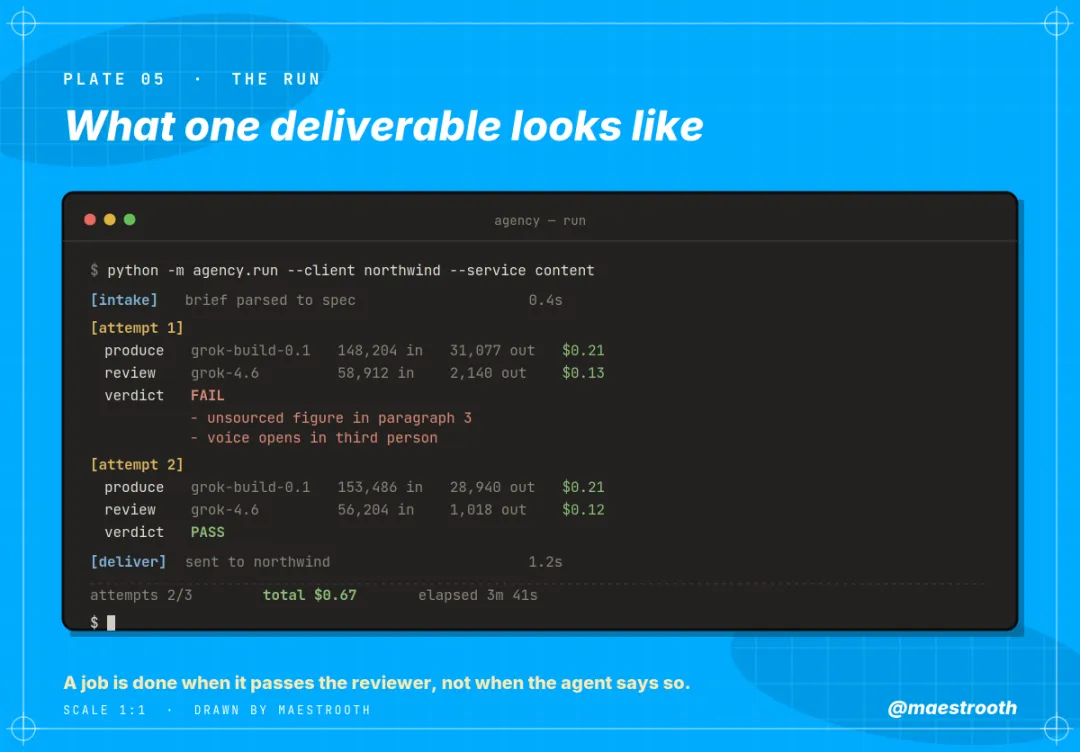
一次交付,也包含失败与重试
原作者的交付循环示意:先生产,再审稿;失败后携带具体问题返工,通过后才交付。图中费用和耗时是作者示意,不是本刊测得。
@maestrooth · 原文 Plate 05「The Run」 ↗示例循环离真实运营还有几步
原文以每月 200 件、每件约 $0.65 推算模型费用低于营收 1%,但代码只记最终成功轮的生产 usage,丢弃审稿 usage,也未累加失败轮次。它又把 200 件的 5% 写成每周十次人工判断;按同一口径,应是每月十次。这里的成本与容量都应重新核算。
本刊建议把示例升级为持久任务队列:分别记录生产、审稿、重试费用;API 限流按官方建议退避,内容不合格按次数转人工;保存任务状态并防止重复交付。发布到客户正式账号还要保留人工确认。只有失败可追踪、可接管,经营者才可能稳定服务五位客户。
原文与核验资料
收藏原标题:用 Grok 搭月入 $18K 的一人 AI 代理公司(@maestrooth)
maestro:Grok 一人代理公司原文 xAI:Structured Outputs xAI:Rate Limits
THEME 02
AI 创作
生成第一稿之后,怎样继续制作
08 · AI 创作 · 09 月 23 日收藏
把角色做成动画,还要能接着改
Rege 的案例值得收藏的部分,是随演示提供的 .coa 工程。拆开文件,能看见表情、头发运动与时间控制如何成为独立的修改入口。
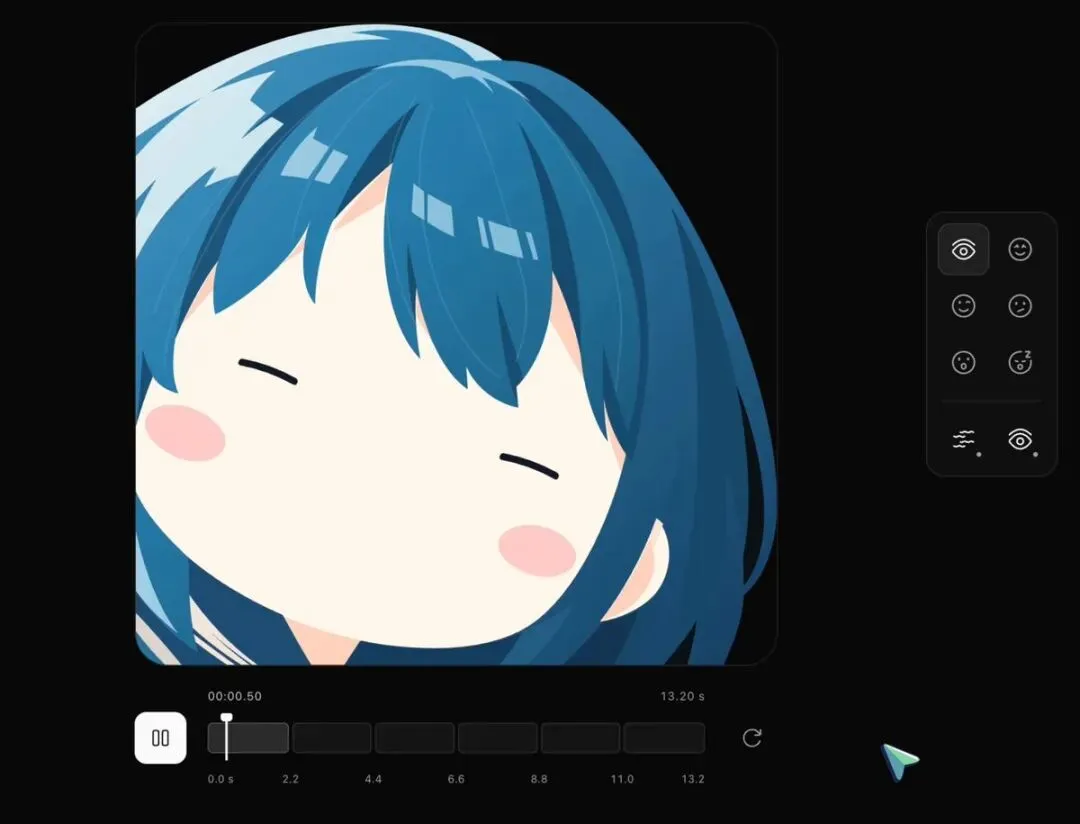
表情、姿态、时间轴都能改
原帖演示|右侧可以选择表情,下方把角色动作排进 13.2 秒时间轴。它把“角色长什么样”与“何时切换表情”放在同一界面;作者另提供可下载的 .coa 工程。
Rege(@rege_dev)原帖演示界面;角色项目由作者提供。 ↗从一个可爱结果,走进它的结构
原帖链接的 Rege Lab 提供试玩与动画文件,页面说明可以在 CoAnimator 中继续修改表情、运动和颜色。本刊下载了 .coa 包:它实际是一个包含页面、动画脚本、SVG 数据和依赖的工程,规格为 1080×1080、30 帧、13.2 秒,依次安排平静、开心、眨眼、好奇、惊讶和困倦六种表情。
这比观看成片多了一层证据:角色的眼睛、眉毛和头发保留为可修改路径,GSAP MorphSVG 在不同形状之间过渡。原帖引用的 Grokbot 提示词工作坊负责角色形象灵感;这条案例没有公开从原图转换 SVG 的完整过程,不宜概括成任意图片都能一键获得同样工程。
交付物里的关键差别
交付一个成片,还是一套能继续改的作品?
SVG 保留形状,脚本保留运动,.coa 保留工程,MP4 保留播放结果。修改能力藏在源文件里。
表情、运动、时间各有修改入口
工程说明把表情姿态与头发形状放在 scene-data.js,把运动控制放在 player.js。源码用同一个时间值驱动头发和表情,并提供跳转、暂停及逐帧渲染入口;后层头发还有延迟跟随。这种组织方式有利于拖动时间轴和导出落在同一姿态,但本刊没有运行桌面端验证一致性。
实际改作时,可以先让 Agent 将惊讶表情的停留时间延长,再微调眉毛幅度,最后调整头发跟随。每次检查一组相邻表情的过渡,避免同时换造型、动作和节奏而失去比较基准。若要换角色,应先确认五官分组、路径和运动中心是否仍适用,原有动作不能无条件移植。这样也能把画风与运动分开评审,先稳定人物辨识度,再讨论表演是否自然。
交付一套能继续改的作品
CoAnimator 官方说明,Agent 写入普通项目文件,舞台实时更新,成片在本机渲染为 MP4。因此可以保存工程供下一次改稿,输出视频用于发布,再另外保留网页版本做交互展示。MP4、网页动画与可编辑工程用途不同,不能把拥有其中一种视为自动拥有另外两种;官方也明确 Lottie 导出尚未上线。
本刊建议验收一轮倒放拖动和定点导出,比较同一秒的眼睛、眉毛和头发;再在头像大小下检查表情能否读懂。最终连同源码、依赖、时长说明与成片交付,才能让“换一种情绪”成为局部修改,而非重新生成整个角色。
交付拆解 · 本案例的三个层次
01 / 结构
SVG 路径与脚本
五官、形状、运动可以分别修改
02 / 工程
.coa 项目文件
保存依赖、姿态和时间轴
03 / 成片
本地渲染 MP4
用于播放和发布,另保留可编辑工程
原文与核验资料
收藏原标题:这个小角色值得走出图片(@rege_dev)
Rege:角色动画原帖 Rege Lab:Grokbot Characters Grokbot Characters 可编辑 .coa 工程 CoAnimator 官方产品与格式说明 Grokbot 角色提示词工作坊
09 · AI 创作 · 09 月 23 日收藏
五分钟像素动画,“做出来”之后看什么
Rikuo 的短片提供了鲜明的风格样本。把它变成自己的制作能力,需要把画面规格、可编辑交付和返工测试一起设计。
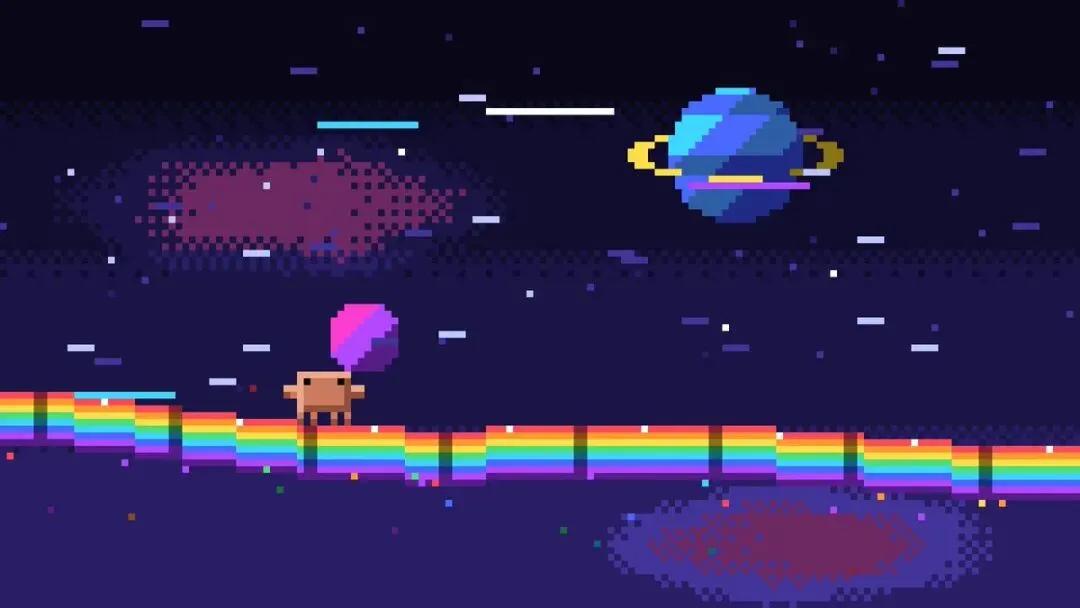
从一帧里,看见制作层次
原帖演示|角色、彩虹道路和远处星体使用不同尺度与明暗,形成可分辨的画面层次。静帧能展示配色与构图;运动节奏、循环接缝和生成过程仍须看原视频与工程。
@riku720720 原帖视频缩略帧,保留原画面。 ↗演示展示了成片,制作过程仍有空白
原帖将像素动画归于 Opus 5.5,并称用时不到五分钟。约 18.8 秒的视频里,小动物沿彩虹轨道移动,深色星空、带环行星与亮色拖影形成层次。本刊下载媒体并抽帧核对,能看到统一的像素尺度和色彩关系;这些是可讨论的作品特征。
帖子没有完整操作录屏,回复区提示词本次也未取到,因此无法确认用了几轮生成、哪些素材预先准备、输出是否包含源码。五分钟应保留为作者报告,不能转换成可复现的效率基准,也不能由此推定某个模型版本的公开可用性。
把喜欢的画面拆成能执行的规格
借这个样本练习,本刊会先写一份小型制作说明:角色占画面多大、使用多少主色、背景分几层、哪些元素移动、循环在何处接回。比如把八秒循环拆成持续奔跑、星点掠过和一次加速,分别规定节奏,避免只让模型猜测“复古、可爱、动感”的含义。这是建议的创作方案,并非作者公开的提示词。
若选择代码动画路线,第一版就要求交付可运行工程,并将角色图形、配色、速度和特效拆成独立参数。先检查静止画面的轮廓与前后景,再加入动作和拖影;每次只改一个变量,保留上一版。这样的步骤让下一次审美判断有明确的修改对象。
本刊提炼 · 第二轮才见真章
只改星空速度,角色节奏还能保留吗?
这是比“首次生成用了五分钟”更具体的验收题。原帖展示了成片,没有给出完整制作过程。
用第二轮修改检验生产价值
本刊建议给初稿追加两个具体任务:只把星空移动速度减半,保留角色节奏;再换角色主色,保留轮廓与阴影关系。观察其他部分是否被连带改坏,比仅看第一次出图更能判断工程是否可控。若每次都重画整段,初稿再快,也可能把成本推迟到修改阶段。
验收时逐帧看脚步与地面是否打滑、拖影是否遮住主体,再检查首尾接缝、小尺寸辨识度和导出后的像素边缘。不同宽高比也应单独检查主体是否被裁掉。记录起稿、返工、导出各自花费的时间,保留源文件与成片。这里的测试是可采用的评估框架,本刊没有复现原帖,也没有测得通过率。
原文与核验资料
收藏原标题:Opus 5.5 五分钟像素动画(@riku720720)
Rikuo:像素动画原帖 原帖附带的动画媒体
10 · AI 创作 · 09 月 22 日收藏
463 条视频案例,怎样成为可复用的流程
真正可带走的是人物约束、分镜结构和失败记录。原帖、收藏日仓库与当前仓库的数字并不相同,应把版本和计数对象写清楚。
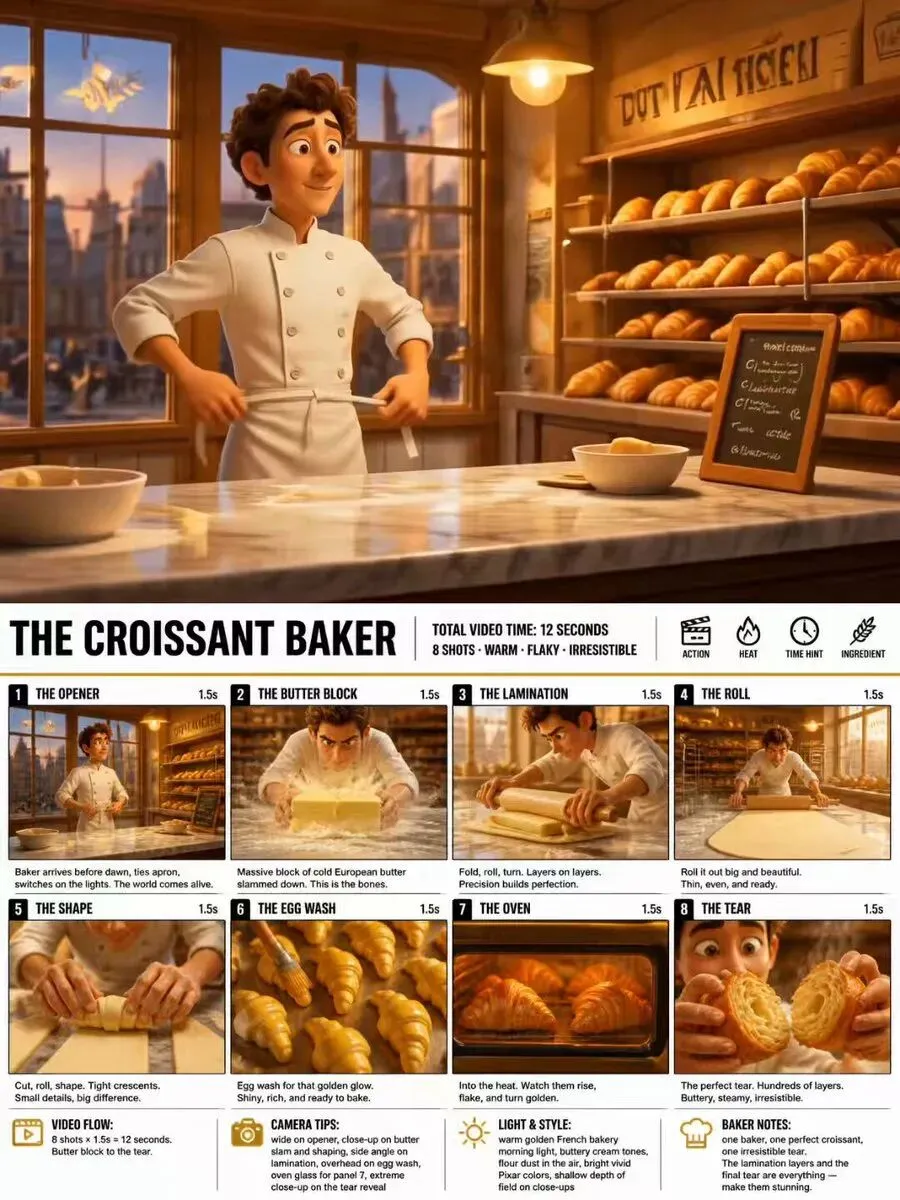
一幅场景,拆成八个镜头
案例原图|上方呈现角色与场景,下方把牛角包制作拆成八镜,每镜计划 1.5 秒,还列出镜头与光线要求。“12 秒”是故事板安排,不能直接当作发布视频的实际时长。
@TechieBySA 原帖视频缩略帧;awesome-seedance / GoodCase 收录的法式牛角包案例。 ↗三个数字,先分清三类资产
作者原文写的是 463 条案例、14 个提示语模板与 25 个 Skills,并非 463 个 Skills。本刊回查收藏时刻之前的仓库提交,统计文件已经是 463 条案例、25 个模板、60 个 Skills;9 月 26 日固定版本则为 562、25、59。后一个 Skill 数包含目录中的创作者变体,不能理解为 59 种独立制作能力。
案例提供原帖与效果参照,模板提炼某类镜头的写法,Skill 把选择模板、填写结构和检查常见错误变成 Agent 可遵循的步骤。本仓的提示词库 Skill 输出提示语、模板名和示例链接,并不负责自动调用视频模型完成整片。
两条能照着做的制作路径
UGC 口播模板分别规定人物外观和产品结构,再把台词放进具体动作发生的节拍。做一瓶洗发水的演示,应先提供产品参考图,确认瓶型、颜色与出镜人物,再安排展示、使用、反馈。模板提醒,精细手部操作与走动最好拆开,包装字和收尾文案留给后期;口型跟不上时先缩短台词,而不是继续堆叠形容词。
分镜网格 Skill 则先生成带编号的故事板,再把它作为视频参考。它引用的牛角包案例用八格承载十二秒:每格约一点五秒,并分别指定角色图管长相、分镜图管动作与顺序。这给了创作者一个更早的修改点:在消耗视频额度前,先修正镜头顺序、景别和每格的动作目标。
复测记录比热度更接近使用成本
当前固定版本记录 254 条案例的 264 次跨模型复测,包含成功、退化与失败。总案例数不能直接当作已公开复测数,热度也不等于稳定性。作者在原文中指出,十五秒提示语换到最长十秒的模型,或者缺少必要参考图,都会改变结果;因此复制文字之前还要复制条件。
本刊建议先选一个最接近目标的案例,只改主体,保存模型、时长、参考素材和每轮花费,再逐项调整动作或镜头。验收时看产品形状是否漂移、接触动作是否成立、台词与口型是否同步。把失败原因写回自己的模板,资料库才会逐渐成为可重复使用的制作经验。
先看分镜,再花视频额度
把“好看”拆成每一格要完成的动作。
案例、模板、Skill 是三种不同资产。角色参考控制长相,分镜参考控制动作和顺序,失败记录帮助复用。
计数口径:原帖叙述
案例:463
模板:14
Skills:25
计数口径:收藏日仓库 · 9927d9b
案例:463
模板:25
Skills:60
计数口径:09.26 固定版本 · 830a199
案例:562
模板:25
Skills:59(含变体)
原文与核验资料
收藏原标题:awesome-seedance · 463 个 AI 视频 Skill 与提示语模版开源(@aiwarts)
卡尔的AI沃茨:awesome-seedance 完整原文 收藏日仓库统计(固定提交) 09.26 仓库统计(固定提交) UGC 口播测评模板 分镜网格转视频 Skill 提示词库 Skill 的实际输出范围
11 · AI 创作 · 09 月 22 日收藏
Fish Audio:语音可控,控在哪里?
Fish Audio 的情绪标签让脚本能说明“怎么读”。完整的声音工作流仍要处理参考音色、专名读音、段落衔接和反复生成的成本。
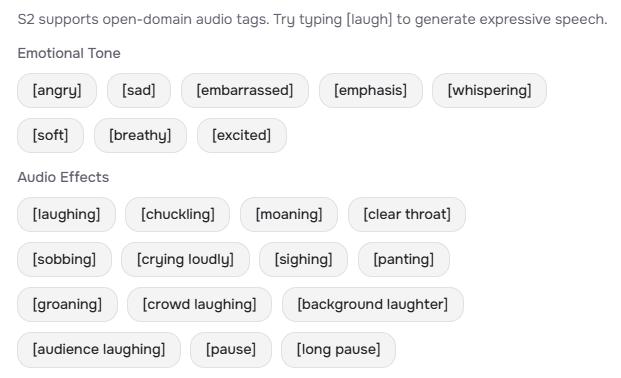
情绪与音效,分开控制
官方界面|情绪语气与声音效果分成两组,让作者把“怎么读”写进文本。这里展示的是 S2 编辑器选项;调用 API 时仍需核对对应模型的标签语法,也不能用一张面板图判断合成效果。
Fish Audio 官方博客,S2 文本转语音编辑器标签面板。 ↗先分清三种能力解决的问题
文字转语音把脚本变成音频;克隆决定谁在说话;情绪提示决定这一句如何表达。Fish 官方 TTS 文档支持指定已有音色,或提供干净的参考录音及转写,临时合成同一音色,无须先训练持久模型。对连续栏目,保存音色标识比每次临时寻找参考更便于复用。
S2 系列用方括号接收情绪与自然语言描述,例如句首的 [sad],重读词之前的 [emphasis];旧版 S1 使用圆括号。停顿标记在文档中是 [break] 与 [long-break],不能把主页按钮上的显示名称直接当作所有模型通用语法。实时流式则负责边收到文字边输出声音,和克隆音色是两个维度。
标签怎样进入脚本
把“怎么读”写在台词前
本刊编写的 S2 语法示意,未生成试听。S1 使用圆括号,模型版本不同不能照搬。
先做短段试音,再铺开长篇
本刊建议先选包含人名、数字、情绪转折的二十秒脚本,用同一音色比较无标签、单一情绪、情绪加停顿三版。官方建议一条句子保留一种主情绪,避免短文本堆满相互冲突的描述;声音不自然时应先减少指令,再调整强度。克隆参考则选自有或获授权的单人录音,保持音量与语气稳定。
长文按叙事段落制作,保存带标签脚本、音色标识、语速设置与逐段音频。读错专名可用发音词典或音素控制修正,只有一句出错就只重做该段。最终合成前逐段检查音色是否漂移、句尾是否截断、段间呼吸是否连贯,再导出适合剪辑的 WAV;这些检查仍需要人听。
把等待时间和生成费用分别算
聊天应用可以用 WebSocket 接入逐步生成的文字,但还要处理缓冲、断线和播放衔接;预先写好的旁白通常直接生成文件即可。本刊会分别测量开始发声的等待时间与整段完成时间,不能用服务端的首段延迟代替用户听到完整回答的体验。
截至本次核对,付费 s2.1-pro API 按输入 UTF-8 字节收费,每百万字节 15 美元,并非每百万中文字。独立的 s2.1-pro-free 为零价、公平使用制,官方公告写明当前免费窗口至 11 月 30 日,不保证可用率或首音延迟,请求也可能用于模型改进。网页订阅与 API 是不同入口;预算应连同多版试音、重生成与所选计划一起核算。
原文与核验资料
收藏原标题:Fish Audio · 情绪可控实时语音(S2.1 Pro / TTS+克隆)
Fish Audio 官网与产品入口 TTS、音色参考与输出格式 情绪控制与新旧标签语法 克隆参考录音实践 发音词典与音素控制 实时语音流的缓冲与连接 官方 API 价格与限额 S2.1 Pro 免费 API 公告及限制
12 · AI 创作 · 09 月 22 日收藏
ScreenKite:对话剪辑怎样接管时间轴
录屏、转写、剪辑和 B-roll 连在一起,价值在于每一次指令都有可检查的片段与时间范围。模型费用、素材上传和可编辑导出仍要分别看。
真正动的是时间轴
删掉一句转写,也会删掉对应片段。
先复制工程,再审阅带时间范围的删改清单。官方指南明确:CLI 不能撤销时间轴裁切。
先有工程,Agent 才有具体修改对象
ScreenKite 将录屏保存为本地 .skbundle 工程,Agent 通过 CLI 或 MCP 读取项目状态,再操作剪辑、字幕与布局。文字编辑依据转写时间戳映射回音视频:删除一句话会删除对应片段,移动段落也会调整时间轴。这里的自然语言指令最终作用于现有素材,创作者可以核对改动发生在哪里。
本地保存并不代表每一步都离线。官方说明 Apple Silicon 可用 WhisperKit 本机转写,Intel Mac 使用云转写;Automatic 模式在配置 ElevenLabs 密钥后优先用云服务。开始处理素材前,应明确选择转写提供方;外接 Agent 的模型请求也依所用服务运行。
一段教程,分两轮剪清楚
官方 Agent 指南先转写、校对产品名,再列出带时间范围和理由的删改清单。对教程,本刊会先去掉重复开场和口误,保留等待加载、鼠标移动等让观众理解操作的必要间隔;确认第一轮节奏后,再处理字幕、缩放与补充画面。字幕应回看专名和数字,避免转写错误沿着后续画面继续传播。指南明确 CLI 无法撤销时间轴裁切,适合先复制工程并审阅切点。
B-roll 流程把转写映射成内容节拍,用 Hyperframes 生成动画并渲染为视频,再放入指定时段。教程可把补充画面放角落,让操作界面保持主导;介绍概念时再扩大它。某一段图标或配色不合适,可以只重新渲染该段并替换,检查前后转场和字幕是否仍同步。
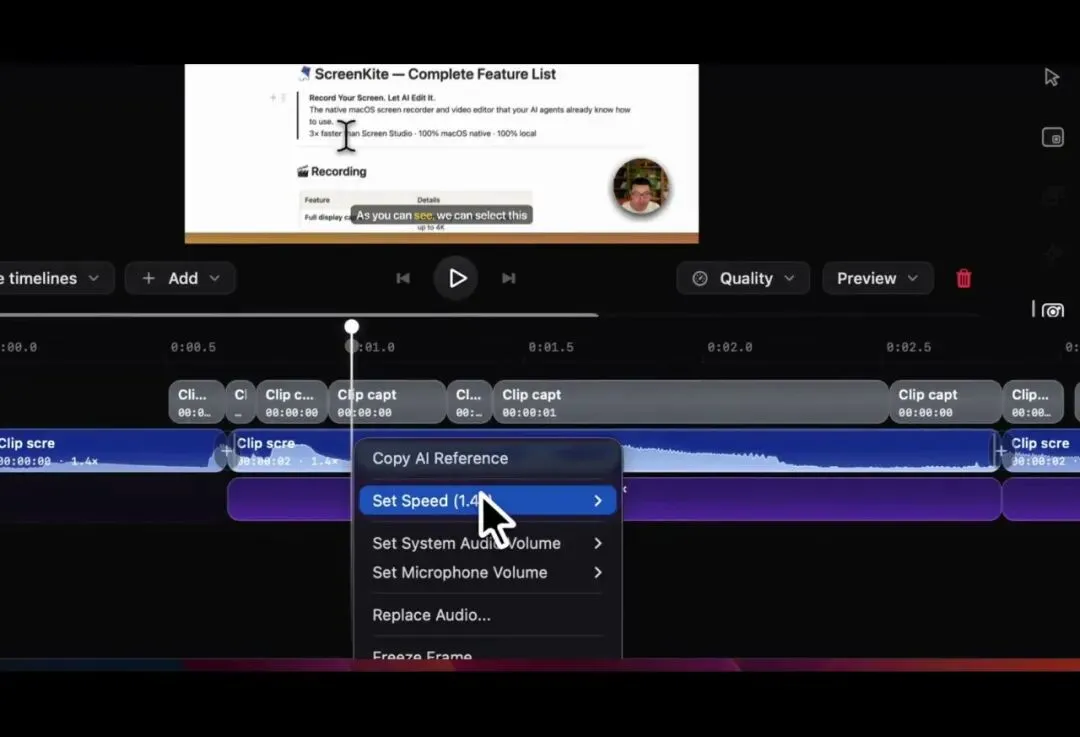
对话之后,落到时间轴上
官方演示第 4 秒|时间轴保留字幕片段与录屏波形,右键可调整片段速度及两路音量,也能复制 AI 引用。AI 参与编辑之后,仍有具体片段与参数可供人工检查;本图不是本刊实测。
ScreenKite 官网“speed up and edit”演示视频,第 4 秒原始帧。 ↗交付与费用,各自有明确边界
保留原工程方便继续编辑,MP4 用于发布;还可导出 FCPXML 接到 Final Cut Pro。官方格式说明保留剪切、变速、音量与标记,却不包含叠加图形、特效、缩放动画和字幕,媒体路径也是绝对路径。因此换剪辑器前要先检查缺失项目,不能把时间轴导出理解为完整视觉效果迁移。
官网当前提供免费录制、编辑和带水印导出,Pro 为一次付费 79.99 美元、三台 Mac。所谓零 AI 费用是 ScreenKite 不另收这笔钱,模型使用仍走自己的 Agent 套餐,云转写也需按提供方核算。三倍导出速度来自厂商自己的对比,本刊未实测;选用时更值得检查同一项目的导出质量与修改可控性。
原文与核验资料
收藏原标题:ScreenKite · Mac 原生录屏+剪辑(比 Screen Studio 快 3 倍)
ScreenKite 官网功能、费用与本地处理说明 Agentic Video Editing 官方指南 文字驱动剪辑与转写提供方 FCPXML 可编辑导出的保留范围 ScreenKite 价格页
THEME 03
Claude × 生物学
发现 ART,也读懂一次发现的边界
13 · Claude × 生物学 · 09 月 24 日收藏
Claude 找到 ART,新的到底是什么?
AGI Hunt 的报道提供了一条比模型“兴奋”更值得追的线索:把已知酶、邻近基因与一排 RNA 联系起来,究竟推进了多少生物学认识?
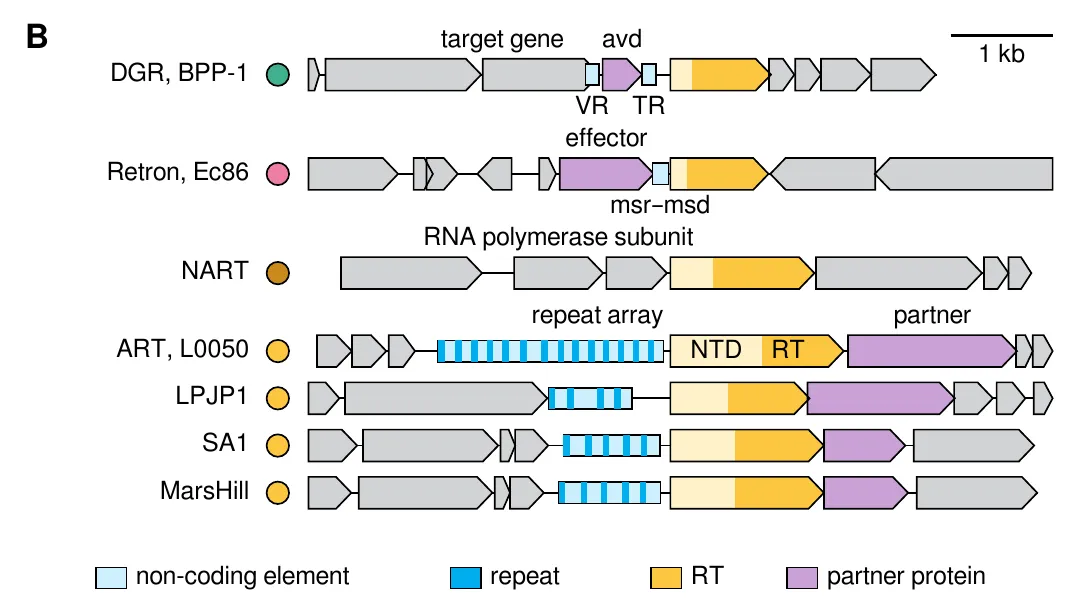
重复阵列、酶与伙伴,怎样相邻
图 2B|蓝色重复阵列、黄色逆转录酶、紫色伙伴基因,在多个 ART 基因座中相邻出现。这是序列分析得到的组件排列;蛋白是否结合、RNA 怎样参与反应,以及整个系统的功能,仍待验证。
Yoon 等 / Anthropic,Autonomous AI agents discover reverse transcriptases with tandem repeat arrays,Figure 2B(2026)。从原 PDF 第 7 页裁取完整 B 面板,保留图例与比例尺。 ↗先说清楚,新的是什么
ART 的新意落在组件之间的关系上。2021 年的 MarsHill 噬菌体研究已经记录了这个逆转录酶,还推测它上游可能存在非编码 RNA。因此,早先研究者并没有把整段区域当成无用噪音。此次 Claude 提出的新线索,是重复阵列和伴侣基因共同构成了一套值得独立研究的系统。2021 年研究、Anthropic 公告
这里的“系统”很关键:给数据库里的一个蛋白重新贴标签,和发现几个相邻组件可能协同工作,提出的问题不同。后者把研究对象从一个零件扩大到了零件之间的联系,也为后续排除巧合提供了明确目标。
重复阵列像一叠格式相同的卡片
逆转录酶这类蛋白通常能把 RNA 复制成 DNA。ART 位点包含逆转录酶、旁边的伴侣基因,以及一长排有规律的非编码重复序列;阵列还能产生不同的短 RNA。可以把重复部分想成卡片共同的页眉,间隔部分则装着各不相同的内容。系统结构与 RNA 线索
这个比喻帮助理解研究者为何在意“一台机器配一叠卡片”:相同的蛋白组件,可能接触多种 RNA。不过,卡片有不同内容,并不能直接告诉我们机器会执行什么指令。“像 CRISPR”可以提示研究方向,无法代替 ART 自己的功能证据。
读科学图,要分两层
观察到了什么,还没证明什么
重复阵列与邻近基因的关联 阵列产生不同的短 RNA
逆转录酶的活性与底物 整套系统的生物学功能
依据 Anthropic 公告与技术报告提炼。图中的空间邻接,不等于已经证实的作用机制。
观测到了 RNA,机制仍是问号
团队重新分析既有感染数据,发现感染 15 分钟时的阵列 RNA 可占噬菌体 RNA 约 8%;独立实验也检测到不同的短 RNA。这支持阵列确实被表达,但论文明确说,尚未证明 ART 的逆转录酶有活性、这些 RNA 是它的底物,或它与伴侣蛋白相互作用。整套系统的生物学功能仍未知。技术报告,结果与讨论
因而,“一组不同 RNA 配合同一组蛋白”的想法,应保留为可检验假说。表达量很高,说明这里有值得解释的现象;它并不自动等于反应效率高,更不能换算成基因编辑能力。
发现的价值,落在下一批问题上
编辑判断:ART 当前最有价值的产出,是把一个模糊的数据库异常变成了有边界的研究对象。下一轮证据需要回答组件怎样共同工作、RNA 在其中承担什么角色、这种组合为何被自然保留下来。每回答一项,才向机制认识多走一步;应用价值还要在机制之外另行证明。
AGI Hunt 用日志里的感叹词打开故事,又保留了论文的未知项。阅读时也应保留这个次序:把拟人表达视为叙事,把可观察、可重复检查的结果作为发现的根据。模型的语气无法衡量这项工作的分量,功能证据才会决定 ART 最终留下什么。
原文与核验资料
收藏原标题:Claude 发现新酶系统 ART,发出类人兴奋
AGI Hunt|Claude 发现新酶系统,发出类人兴奋 Anthropic|Claude discovers a novel enzyme system with CRISPR-like repeats Yoon 等|Autonomous AI agents discover reverse transcriptases with tandem repeat arrays Korn 等(2021)|MarsHill 等巨型噬菌体的比较基因组研究
14 · Claude × 生物学 · 09 月 24 日收藏
21 小时之后,Claude 科研如何复查
新智元的“950 个 Agent”适合做标题。理解这项工作的实际进展,还要把会话数、候选数、报告数和实验结果放回各自的位置。
速度之外,还要看复现
一次发现与十次重跑
首次任务墙钟时间
重跑再次找到 ART
技术报告中的重跑均未读到关键上游 DNA。发现能力与稳定走到证据面前,是两个问题。
先给三个大数字划定边界
约 950 个 Agent、21 小时、2.1 亿 token,描述的是一次计算挖掘任务。技术报告的准确口径为 949 次 Agent 会话、21.5 小时墙钟时间与约 2.156 亿 token;会话数并不等于同时运行着 949 名独立“科学家”。这个计时也没有包办此后所有人的分析和实验。计算资源口径
把它理解成编辑部处理一次大型调查更合适:许多选题、查证、复核会话可以先后发生或并行推进。“一夜交出报告”衡量的是这一轮处理速度;研究真正需要多久,还取决于报告之后哪些判断能被外部证据接住。
漏斗每一层,数的东西不同
公告把过程概括为二十余万 RT、约 3500 个候选、约 20 份报告。论文进一步说明,中间层是 3564 个待评分的邻近蛋白家族,终点是 19 份报告;因此不能把 3500 读成已经发现的全新酶系统。数量逐层缩小,既包含发现线索,也包含淘汰错误关联。概览、筛选口径
这个区别影响我们怎样评估成果。一个“候选”只需要值得调查,一项“发现”则必须经得起排除已知解释与后续验证。把两个名词混用,会让搜索覆盖率看起来像实验成功率,也会遮住筛选本身消耗的工作。
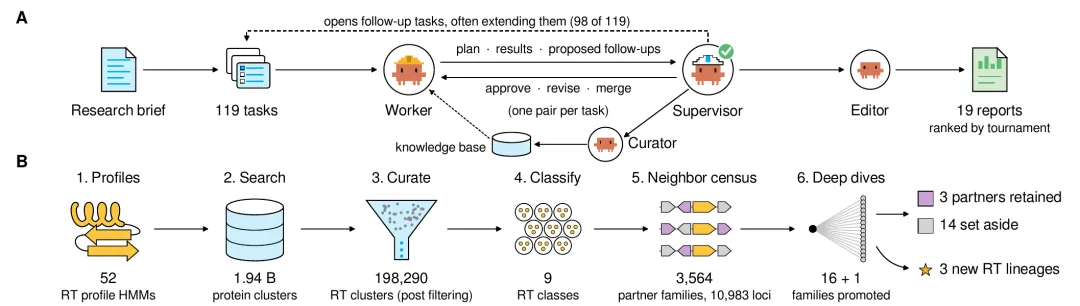
从研究任务,到候选报告
图 1A–B|上方虚线回路是关键:119 个任务中,98 个来自调查中的追加追问。下方把候选的单位写得很清楚:3,564 个伙伴蛋白家族进入评分。最后交出的 19 份报告仍需人类审查与实验跟进。
Yoon 等 / Anthropic,Autonomous AI agents discover reverse transcriptases with tandem repeat arrays,Figure 1A–B(2026)。从原 PDF 第 4 页裁取完整 A、B 面板,未重绘或更改数据。 ↗自动化的关键在允许追问
此次框架让执行 Agent 制订并运行计划,监督 Agent 复核,并能因新观察追加任务。ART 正是在延伸调查中浮现。人工团队给出研究方向,接收候选并决定实验跟进;所有湿实验由人类完成,Claude 继续辅助解释数据。任务组织、人类与实验的角色
编辑判断:这里值得关注的能力,是发现原问题没有预设的线索,并留下别人能检查的推理和结果。它像一名调查者发现账目中的异常后继续追查,而不是只填完最初的表格。但若多轮复核共享同一项错误前提,报告也可能越来越工整、越来越偏离事实;实验仍承担独立校验。
一次成功,还不是稳定的发现机器
论文还做了十次同任务重跑,均未再次找到 ART;这些运行没有读到关键的上游 DNA。这把瓶颈指向了搜索路线和实际阅读行为:模型“有能力识别”,并不保证整个流程每次都把证据送到它面前。重复运行结果
编辑判断:下一步更有用的指标,是相同预算下能稳定交付多少条值得实验的线索,以及这些线索后来有多少成立。候选报告增加后,人的审查时间和实验容量也会成为约束。新智元延伸到疾病治疗的愿景可以作为期待;本次证据支持的是探索与筛选环节的进步,无法据此推算治疗时间表。
科研漏斗 · 每一层数的东西不同
20 万余
搜集的逆转录酶
3,564
待评分的邻近蛋白家族
19
形成的候选报告
ART
其中一项线索;主功能待研究
原文与核验资料
收藏原标题:Claude · DNA「上帝手术刀」ART — 新智元
新智元|刚刚,Claude发现神秘DNA系统!狂烧2.1 亿Token挖出「上帝手术刀」 Anthropic|研究公告及 How we work Yoon 等|Autonomous AI agents discover reverse transcriptases with tandem repeat arrays
THEME 04
人与产品
测试经验与小产品,怎样回到人的需要
15 · 人与产品 · 09 月 22 日收藏
一线 QA 的价值:知道哪些地方会出问题
一篇内网帖的转述不能证明企业的人事决策,却提出了具体问题:自动化越便宜,谁来定义值得测试的真实风险?
本刊建议 · 把经验交接下来
一个好用例,先留下三件事
01
触发条件
怎么发生
包括老账号、断网、配置组合
02
用户损害
哪里不对
说明真实影响,不只记录报错
03
判断依据
应该怎样
先有正确标准,再写自动化
AI 可以帮助扩展输入和生成用例;业务例外与正确结果的依据,仍需团队提供。
情绪能提示问题,不能代替事实核验
公众号转述一则据称来自字节内网的发帖:员工希望留下认真做事的外包 QA,并声称获大量同事支持。文章没有提供可独立核验的内网记录、人员数据或企业回应,因此不能据此断言裁员已发生、某类岗位更有效率,或 AI 已经无法替代特定工作。可讨论的是作者指向的价值:熟悉业务的一线测试者,往往掌握需求文档之外的失败经验。
从“会点按钮”到“知道何时结果不对”
以一个假想改版为例:正常新账号能完成流程,老账号迁移后是否仍然可用?断网重进、活动开关和客户端版本组合,是否会改变结果?这类测试设计需要知道哪些路径常见、哪些失败不可接受,以及过去在哪里吃过亏。Google 测试团队的工程文章也强调,测试所需的领域知识必须进入团队;探索过程中跟踪数据变化,还可以帮助选出值得自动化的检查点。
AI 可以基于给定资料生成候选用例、扩展输入和整理复现过程。但没有写入上下文的业务例外,并不会自动成为正确的断言。若仅照当前实现生成预期结果,就可能把已有缺陷固化成通过条件;用例数量增长,也未必覆盖了新的风险。
把人的判断变成能复用的测试资产
本刊主张先让一线 QA 记录三件事:真实触发条件、用户可见损害、正确结果的依据,再由 AI 协助转成可执行回归。确定性规则交给程序检查,开放式体验由明确评分标准和人工抽查补充。Anthropic 的评测实践同样区分代码、模型和人工评分,并要求模型评分与专家判断校准。
考察这套分工,应看漏掉了哪些严重问题、复现定位花多久、同类故障是否再发生。组织既要让经验能被交接,也要给测试者更新标准和否决上线的实际通道;仅保留岗位名称或仅购买自动化工具,都不足以说明质量责任有人承担。
原文与核验资料
收藏原标题:留下外包 QA:字节内网恳请留下做实事的人
大厂日爆:外包 QA 内网帖转述 Google Testing Blog:测试中的领域知识 Google Testing Blog:The FedEx Tour Anthropic:Demystifying evals for AI agents
16 · 人与产品 · 09 月 23 日收藏
四个日常小产品,四种具体的生活阻力
同样围绕时间与行动,儿童的剩余时间、成人的分心、户外探索和习惯重启,需要各自成立的交互机制。
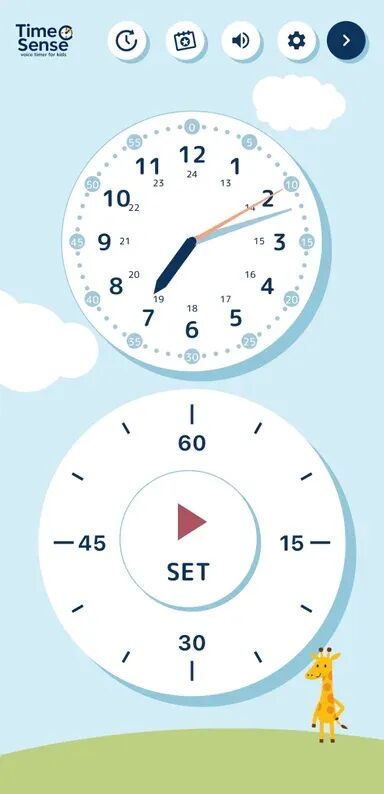
TimeSense:看见时间
TimeSense 官方产品画面:模拟钟面与可视化计时器放在一起,服务于儿童对时间的理解。
SynCraft · TimeSense 官方产品页 ↗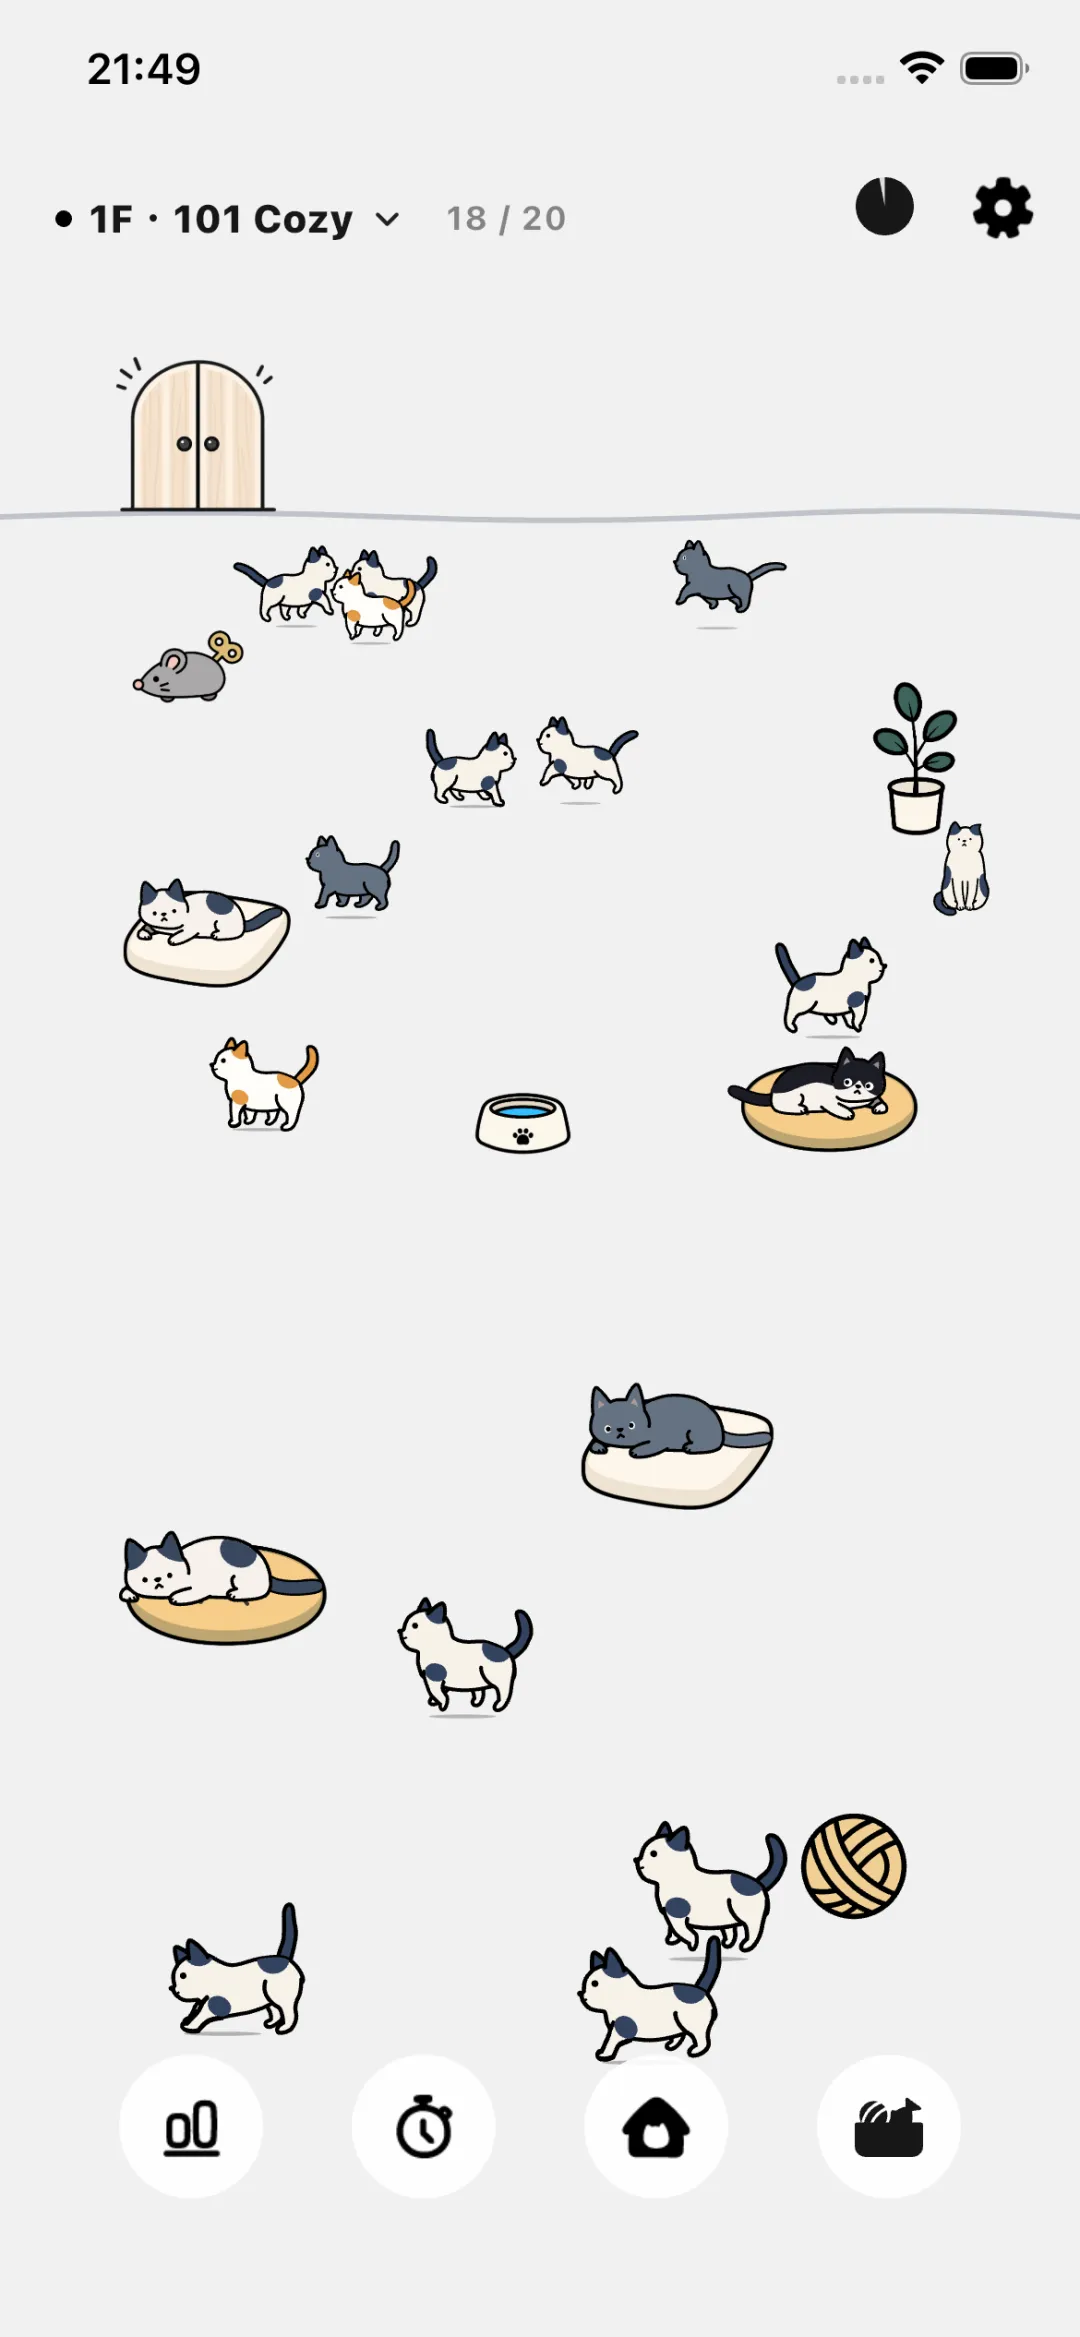
SwingCat:积累专注
SwingCat 官方产品画面:完成专注后迎来的猫住进房间,计时积累转化为可见的收集奖励。
SynCraft · SwingCat 官方产品页 ↗计时器背后,是不同的人和不同的反馈
TimeSense 把模拟钟面、剩余时间可视化和角色语音组合起来,让孩子感知“还有多久”,也让家长减少重复催促。SwingCat 面向专注:计时开始后猫抓住摆锤,坚持完成便把猫迎进房间,中断则可能掉落或逃走,并记录专注时间与次数。两者复用计时这个基础能力,却分别处理亲子沟通和持续投入;反馈的对象与情绪完全不同。
把任务开始、探索和重启做成具体动作
Stealth Radar 让发起者在地图设置目标与任务,分享加密链接;探索者跟随雷达接近目标,触发任务。普通散步由此获得目的和悬念。ClockTimer 则把任务、一键启动计时、语音提示、完成勾选与习惯记录接起来,强调中断后仍能重新开始。前者设计的是人与地点的游戏关系,后者缩短的是从待办清单走到实际行动的距离。
小产品也有真实约束。官网说明 Stealth Radar 开始任务需联网、途中定位不必持续联网;ClockTimer 数据留在设备,换机或删除应用不能继承。这些细节直接影响用户是否愿意长期使用,功能清单无法替它们回答。
同一个计时器,不同的反馈
让孩子看见“还有多久”,让大人愿意“再坚持一会”。
TimeSense 面向时间感知与亲子沟通,SwingCat 把完成专注变成收集小猫。先理解人,再决定交互。
对 AI 开发者的启发,在选题颗粒度
官网没有披露这些产品是否由 AI 开发,本刊也不据此推断。把它收入 AI 周刊,是因为它示范了可供 AI 辅助开发验证的需求尺度:能说清谁在什么时刻遇到什么阻力,以及一次操作怎样改变下一步行为。先把这个闭环做完整,才有依据决定增加哪项能力。
如果用 AI 做类似项目,可以先复现一个最小场景,再到真实设备上检查:语音提示是否打扰家长,专注失败是否让人更挫败,定位偏差是否破坏探索,习惯中断后是否容易回来。这些是本刊提出的验证问题。生成更多页面能加快制作;理解一次具体体验是否成立,仍需要观察用户。
原文与核验资料
收藏原标题:SynCraft · 同步打造日常小产品的个人开发工作室
SynCraft 工作室官网 TimeSense 产品页 SwingCat 产品页 Stealth Radar 产品页 ClockTimer 产品页
关于这一期
本期按 UTC+8 收藏日期整理 9 月 20—26 日的 17 篇阅读,编为 16 篇专栏。9 月 20 日与 21 日两次收藏的 Made with Jev 作品墙合并在第 05 篇讨论,两个阅读流入口均保留;其余同题报道各自展开。正文结合原文、一手资料与编辑分析;引用数据注明其口径,作者或厂商报告的效果不等于本刊实测。Jev 的公开案例、ART 的机制未知项,以及材料中的数字差异,均在对应专栏展开。
编辑:Airing。小熊沿用 Airing 首页的角色形象,封面与三幅主题图为 AI 生成的编辑概念插画。原文和核验链接附在每篇之后;完整收藏入口为 阅读流 RSS。
每天收藏,每周读懂。
AI 趋势周刊 · 每周一更新
点击文末「阅读原文」,查看完整周刊、原图与来源链接。
编辑 Airing · 个人主页 ursb.me