ARTICLE · 1088487
AI 工程师的第一项核心能力:构建和部署 AI 应用
为什么你的 AI 应用"能跑",却迟迟不敢上生产?构建与部署 AI 应用:吴恩达拆出的 6 项子能力,逐条讲透会调 API、会搭 RAG 只是入门:AI 应用工程师和 demo 拼接匠的分水岭在哪从选模型到上生产:AI 应用落地的 6 个子能力自查清单吴恩达点名:区分优秀 AI 系统构建者的,不是模型,是这一个循环
同一个 prompt,跑两次,结果不一样。
这件事,传统软件工程师是很难接受的。你调一个函数,add(2, 3) 永远返回 5;可你调一次 LLM,它这次答得漂亮,下次就自信满满地胡说八道。
AI 应用和传统软件最本质的区别,就藏在这句话里:输出不可预测。
2026 年 8 月 21 日,吴恩达在《The Batch》第 367 期,展开了 AI 工程技能地图的第一项——Building and Deploying AI Applications(构建与部署 AI 应用)。这一篇的浏览量冲到 179 万,转发过万,他把这项能力拆成了 6 个子能力,还点名了其中最难、也最值钱的一项。
这篇就把这 6 项,逐条拆开讲清楚。
先理解一个前提:AI 系统为什么要"边造边看"
吴恩达在文中把这件事的底层逻辑讲得很透:
因为你事先不知道 LLM 会输出什么,也不知道一个监督学习算法会做出什么预测,所以构建 AI 系统是一个比传统软件更依赖迭代的过程——你很难提前把整个流程规划死。
传统软件是"瀑布友好"的:需求定清楚,架构画好,然后按图施工。AI 软件不是。熟练的 AI 工程师做的是一件更"手艺人"的事:
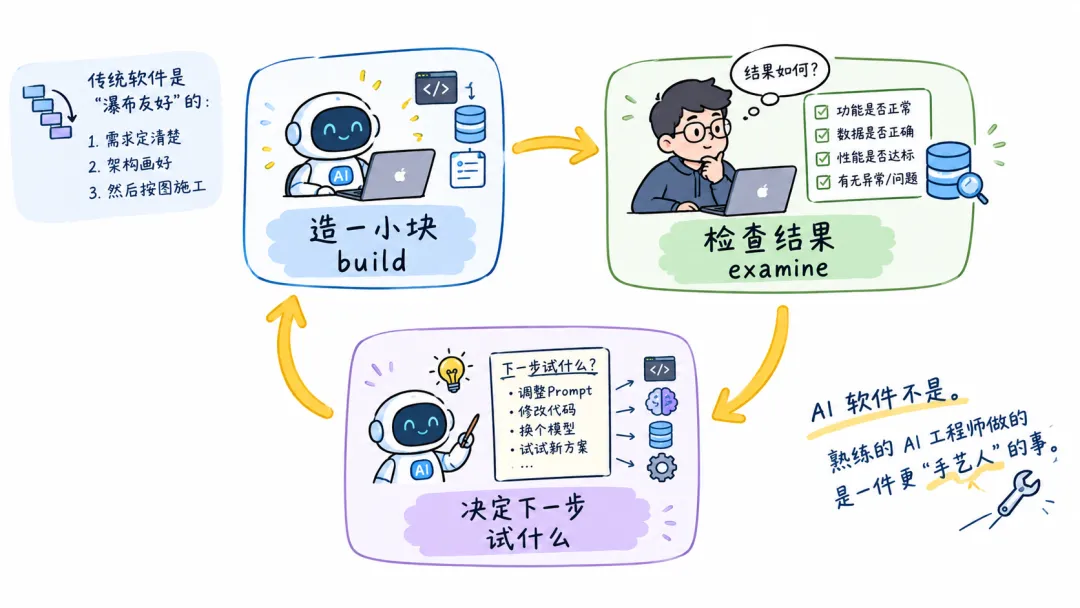
这个循环里,一连串动作强烈受中间结果影响。吴恩达说,能够娴熟地判断"下一步该做什么",你才能在不可靠的 AI 组件之上,搭出可靠的软件系统。
可靠不是来自组件本身,而是来自你驾驭不确定性的能力。
而要驾驭不确定性,需要下面这 6 项子能力。它们覆盖从选模型到上生产的完整链路:
子能力 1:LLM 基础 —— 懂到什么程度才算够?
地基第一项,是理解 LLM 如何对输入分词(tokenize)、如何生成输出。
但"懂 LLM"不是一句空话,吴恩达给了一个非常具体的判断标准——你能不能回答下面这一串问题:
• 什么时候可以依赖模型,什么时候它可能失效? • 什么时候该用多模态模型? • 上下文窗口(context window)里,该放什么、该舍什么,怎么权衡? • 缓存命中(cache hits)、知识截止日期(knowledge cutoff)、推理努力级别(reasoning effort)、采样参数(sampling parameters),分别怎么影响结果? • 什么时候该用工具调用(tool calling)这类特殊能力?
把这些问题想清楚,你才能帮团队选对模型或模型组合,并在必要时用更专业的手段兜底——比如微调(fine-tuning) 或自托管(self-hosting)。
"懂 LLM"的分界线,不是能不能背出 transformer 结构,而是能不能在一堆真实约束下,判断该用哪个模型、怎么用。
子能力 2:用数据 Grounding 模型 —— RAG 早就不是"向量搜索"那么简单
LLM 需要好的输入上下文,才能产出有用的结果。这一点大家都有共识,但很多人对"怎么给上下文"的理解,还停在 2023 年。
吴恩达明确点破:基于向量搜索的 RAG,只是给模型补上下文的"早期尝试",如今这套技术手段已经大幅扩展了。
真正的决策,是分层的:
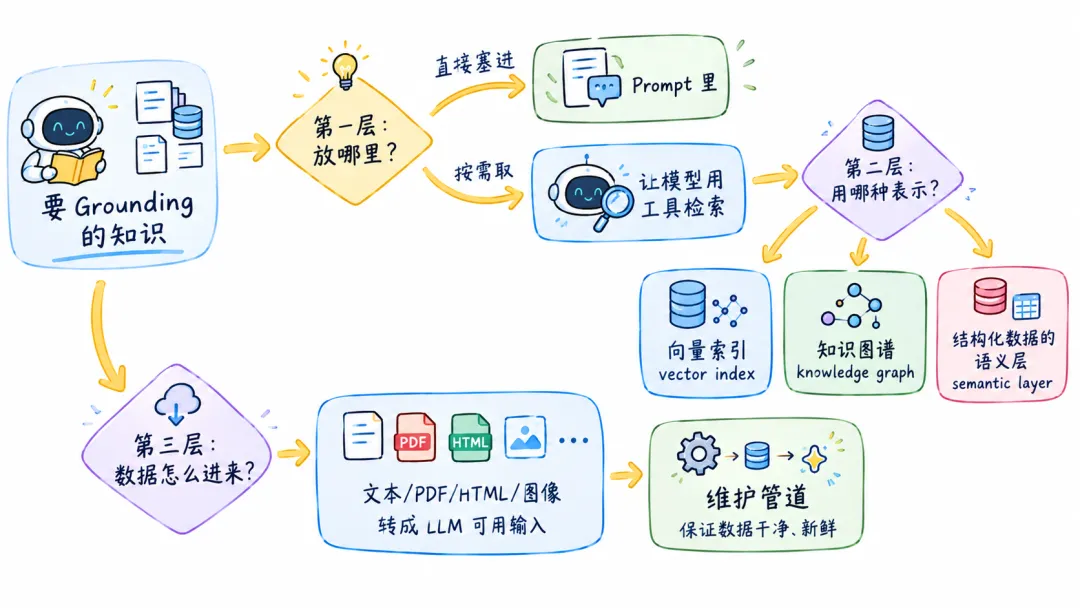
这张图想说明的是:Grounding 不是一道"要不要用 RAG"的单选题,而是一连串工程决策。
• 第一层:哪些内容直接放进 prompt,哪些让模型通过工具按需检索? • 第二层:按数据形态和查询方式选表示——向量索引、知识图谱,还是架在结构化数据(比如客户记录)之上的语义层? • 第三层:把文本、PDF、HTML、图像转成模型能用的输入,并且维护好数据管道,保证数据干净、新鲜。
问题不在"你有没有 RAG",而在"你有没有为这份数据选对获取知识的组合"。
当你理解了这一整套"取数据的菜单",你才谈得上给 LLM 真正相关的上下文。
子能力 3:构建智能体系统 —— 工作流,还是 Agent 框架?
智能体系统(agentic systems)有两个极端:
• 一端是工作流(workflow):你预先定义好一串 LLM 调用的顺序,按部就班地执行。 • 另一端是 Agent 框架(agent harness):你把决策权交给模型,让它自己决定下一步做什么。
中间地带,全是架构决策:哪些步骤串起来、哪些可以并行、什么时候用代码、什么时候用 LLM。你还得设计故障回退机制,保证某一步出错时,整个系统不会崩掉。
在设计"智能体循环(agent loop)"时,吴恩达列了一串关键选择:
• 模型能调用哪些工具?(包括 MCP、CLI、沙箱执行环境) • 用什么样的记忆架构(memory architecture)? • 长会话里,怎么管理上下文? • 什么时候需要多智能体编排(multi-agent orchestration),而不是单智能体硬扛?
而要从"能跑的原型"变成"可靠、安全、可上生产"的智能体,你还得处理一批更硬的问题:护栏(guardrails)、对抗性输入(adversarial inputs)、数据外泄(data exfiltration) 等风险,并建立起治理机制。
前沿方向同样值得盯:语音智能体、计算机使用智能体(computer-use agents)、生成式 UI(generative UI)。吴恩达特别提醒,agentic 技术演进极快,你要主动去了解和自己应用领域相关的前沿手段。
单智能体能跑通 demo,多智能体+护栏+治理才能跑通生产。中间隔着的,全是架构决策。
子能力 4:评估驱动开发 —— 吴恩达点名的"最重要特质"
这是全文分量最重的一节。吴恩达在这里下了一句很重的判断:
在我的经验里,区分"极擅长构建 AI 系统的人"和"普通人"的最重要特质,就是你能否驱动一个有纪律的评估 / 错误分析循环(evals / error analysis loop) 来推动开发。
为什么是它?因为 AI 系统的开发是迭代的,而迭代要有方向。评估循环,就是那个让你"把精力反复聚焦到更可能出成果的方向上"的指南针。没有它,你的每一次修改都是碰运气。
吴恩达也坦白:这是一项很难掌握的技能,因为正确的方法因项目而异,甚至因同一个项目的不同阶段而异。"会评估"绝不是"跑个基准测试"那么简单,它是一项深层技术能力。
他把它拆成了一个可操作的循环:
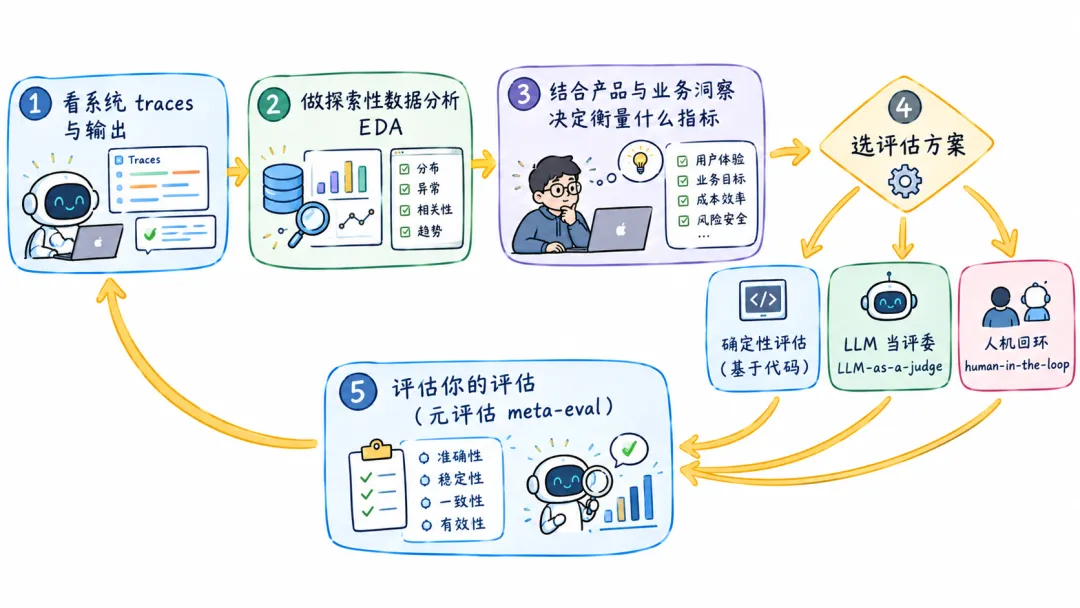
这五步,每一步都有讲究:
1. 看 traces 和输出:先把系统的真实行为摸清楚,而不是靠想象。 2. 做探索性数据分析(EDA):从大量输出里,找出错误的模式和分布。 3. 结合产品和业务洞察,决定衡量什么:指标不是技术上能测什么,而是业务上该关心什么。 4. 理解评估方案的"菜单":什么时候用确定性(基于代码)的评估,什么时候用 LLM 当评委,什么时候必须让人参与进来。 5. 评估你的评估(meta-evaluation):这是题眼——评估方法本身也会失效,你得持续迭代它。
"评估你的评估"——这句话,是这一整节的灵魂。 有了这套循环,进展才是系统化的,而不是随机的。
这也是为什么很多人做 AI 应用会卡在"demo 能跑、生产不敢上":他们从来没建立起这个循环,效果既不可度量,也不可复现。evals 是 AI 应用工程师和 demo 拼接匠之间,那道真正的分水岭。
子能力 5:生产环境运营 —— 和传统软件差在哪?
AI 软件的运维,和传统软件有三个根本不同:不可预测、有成本、有延迟。这三点,彻底改变了运营方式。
吴恩达列出了几件必须做的事:
• 构建可观测性(observability)机制:搞清楚系统在真实使用中到底表现如何。 • 跟踪性能、检测漂移(drift):模型的表现会随数据分布变化而衰减。 • 快速响应模型故障和安全事件:比如对抗性提示注入(adversarial prompt injection)。 • 回归测试和 CI/CD:比传统软件需要更多的统计评估,测试投入要按出错风险来校准——高风险的地方多测,低风险的地方少测。 • 优化成本和延迟:这是一套组合拳——模型选择优化、蒸馏(distillation)、微调、以及简化智能体工作流。当你的应用拥有大量用户时,这一点尤其关键。
传统软件运维盯的是"服务挂没挂",AI 系统运维还要盯"模型飘没飘"——它的正确率,是会随时间悄悄衰减的。
子能力 6:机器学习基础 —— 都 2026 年了,还要不要学 ML?
要学,而且要学到一定深度。这是吴恩达给很多"只想调 API"的工程师泼的一盆冷水。
他的理由有两层:
第一层,LLM 本身就是 ML 的产物。 现代 LLM 是用机器学习技术(包括监督学习和强化学习)构建出来的。吴恩达说,他认识的每一位擅长用 LLM 构建应用的工程师,都对机器学习和深度学习有一定深度的理解。
第二层,很多应用仍然直接需要 ML。 无论是用别人训练好的模型,还是自己训练模型,你都得了解主流的机器学习 / 深度学习模型,理解它们在准确率、训练速度、推理速度之间的权衡,并懂得如何构建训练和评估这些模型所需的数据。
而更深远的价值,在于思维框架:
机器学习里的偏差 / 方差(bias/variance)、错误分析(error analysis)、数据工程(data engineering) 这些概念——它们本来就是用来应对"输出不确定的系统"的核心思维框架——在 AI 系统开发的各种决策中,依然至关重要。
换句话说,ML 基础给你的不是几个算法,而是一整套"和不确定性打交道"的思考方式。这恰恰是 AI 工程最需要的底层能力。
收尾:这是一个有相当技术深度的领域
吴恩达在这一篇的结尾,说了一句很实在的话:
要精通构建和部署 AI 系统,需要学很多东西。这是一个技术深度相当大的领域。但你学到的每一点,都会让你在 AI 工程上变得更强,构建出更令人兴奋的应用。
把这 6 项子能力串起来看,其实是一条完整的链路:
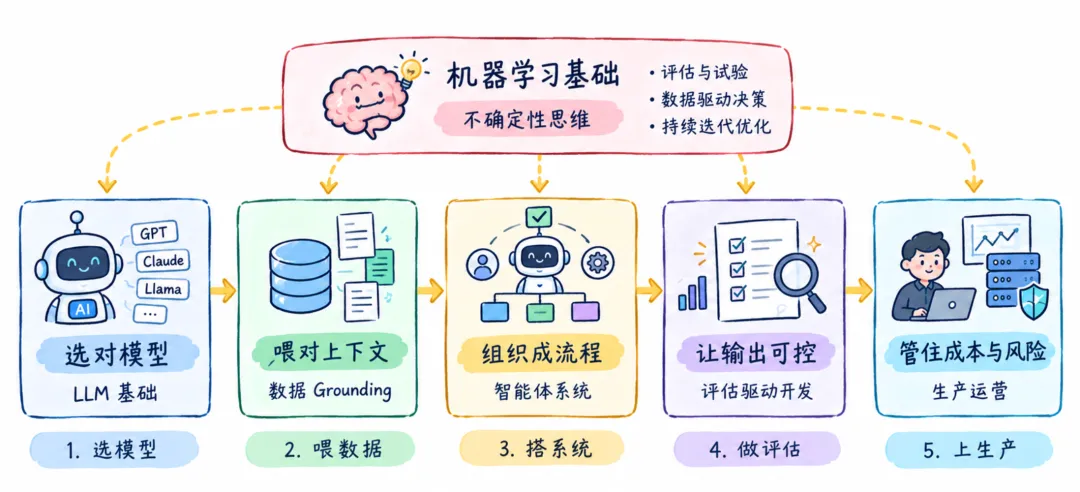
从选模型,到喂数据,到搭系统,到做评估,到上生产——而 ML 基础作为一种思维方式,贯穿始终。这条链路上任何一环薄弱,你的 AI 应用都会卡在"能跑"和"可靠"之间的那道鸿沟里。
下一篇,我们继续聊聊 AI 工程师的第二项核心能力:软件工程基础。当 AI 能够生成代码,甚至独立完成开发任务时,AI 工程师为什么仍然需要软件工程基础?
参考来源:Andrew Ng《AI Engineering Skills Map: Building and Deploying AI Applications》。本文为基于原文的深度技术解读。
觉得有收获?请 点赞、转发 和 关注 ,让更多工程师看到这篇文章~