ARTICLE · 1088763
AI一个字没写,账单先到了!Anthropic狠招:只要拒绝回答,也要收全费
作者 | 吕行· 编辑 | 刘进
你去一家顶级餐厅点餐
服务员看了一眼你的菜单,冷冷地说了一句:“抱歉,这道菜我们不给做。”
你正准备起身离开,服务员却微笑着递上一张账单:“先生,虽然我们没做,但这道菜的钱,您得照付。”
荒诞吗?但这件看似不可思议的事情,刚刚在大模型的世界里真实发生了。
全球顶尖AI独角兽 Anthropic 正式投下一枚震撼弹:面向所有开发者与企业客户,恢复对部分被安全系统直接拦截的请求全额计费。
也就是说:哪怕 Claude 连一个字都还没吐出来,只要你的提示词踩到了特定红线、被系统当场拒答,这次“碰壁”的算力费,你也必须一分不少地结清。
消息一出,全球开发者社区一片哗然
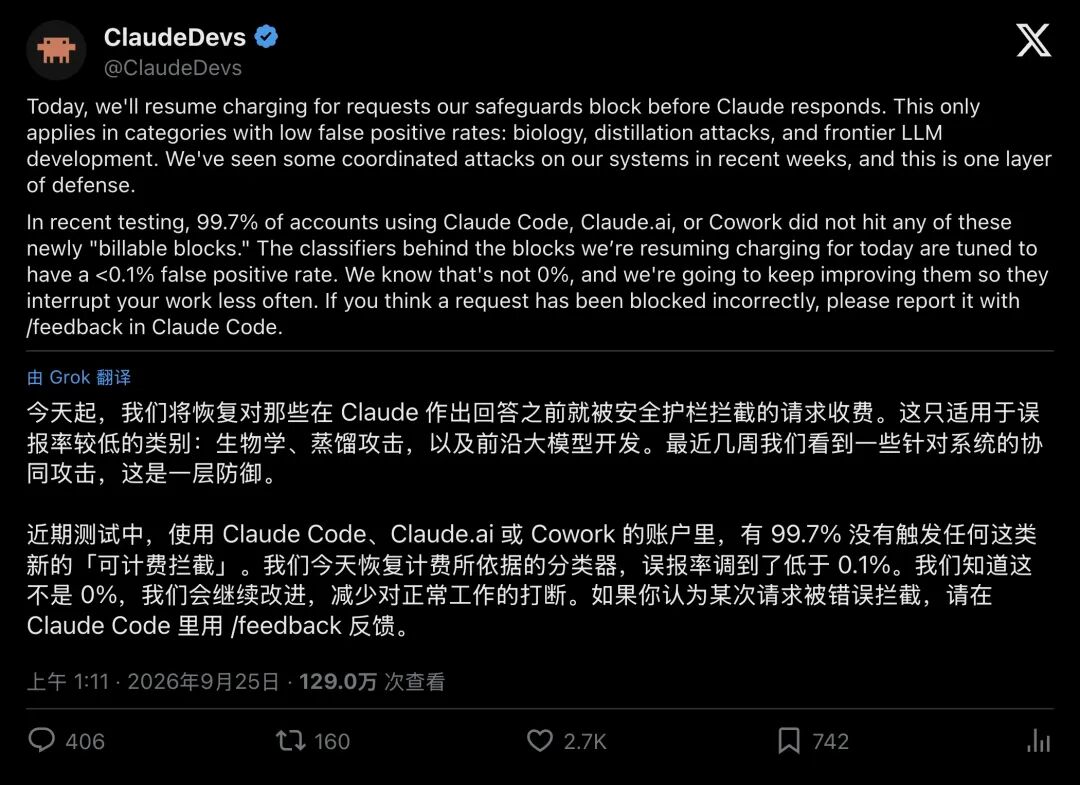
▲ Anthropic 开发者官方账号发布公告,宣布恢复计费
01连拒绝都被明码标价,网友神评:这不就是相亲软件?
公告发出的短短几小时内,开发者们的讨论区就成了段子与怨气的交汇地。
有人瞬间联想到了现实生活中的残酷规则:
“为被拒绝付钱?这商业模式,相亲交友软件早就玩得炉火纯青了。”
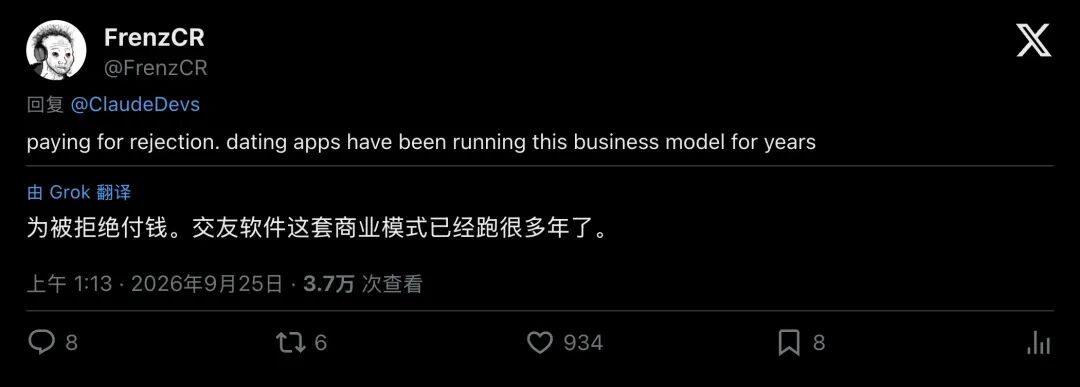
▲ 高赞评论一针见血:这不就是交友软件的商业模式?
还有人紧跟着调侃:“付钱买拒绝,现在居然还附带‘生物危害级’定价。”
幽默归幽默,但大家心里都明白:大模型商业史上的一条隐形铁律,被彻底打破了。
过去几年,所有大模型 API 都有一个不成文的行业惯例,“安全拦截不扣费”。只要模型在生成文本之前,被平台自带的审核网关直接挡下(即没有任何实质输出),服务商通常自认倒霉,当成一次无效调用,用户最多浪费一次网络请求,不需要掏真金白银。
但从现在起,Anthropic 亲手撕毁了这张“免费退席券”。
究竟哪些请求会被“收门票”?官方文档同步更新了精确的规则表:
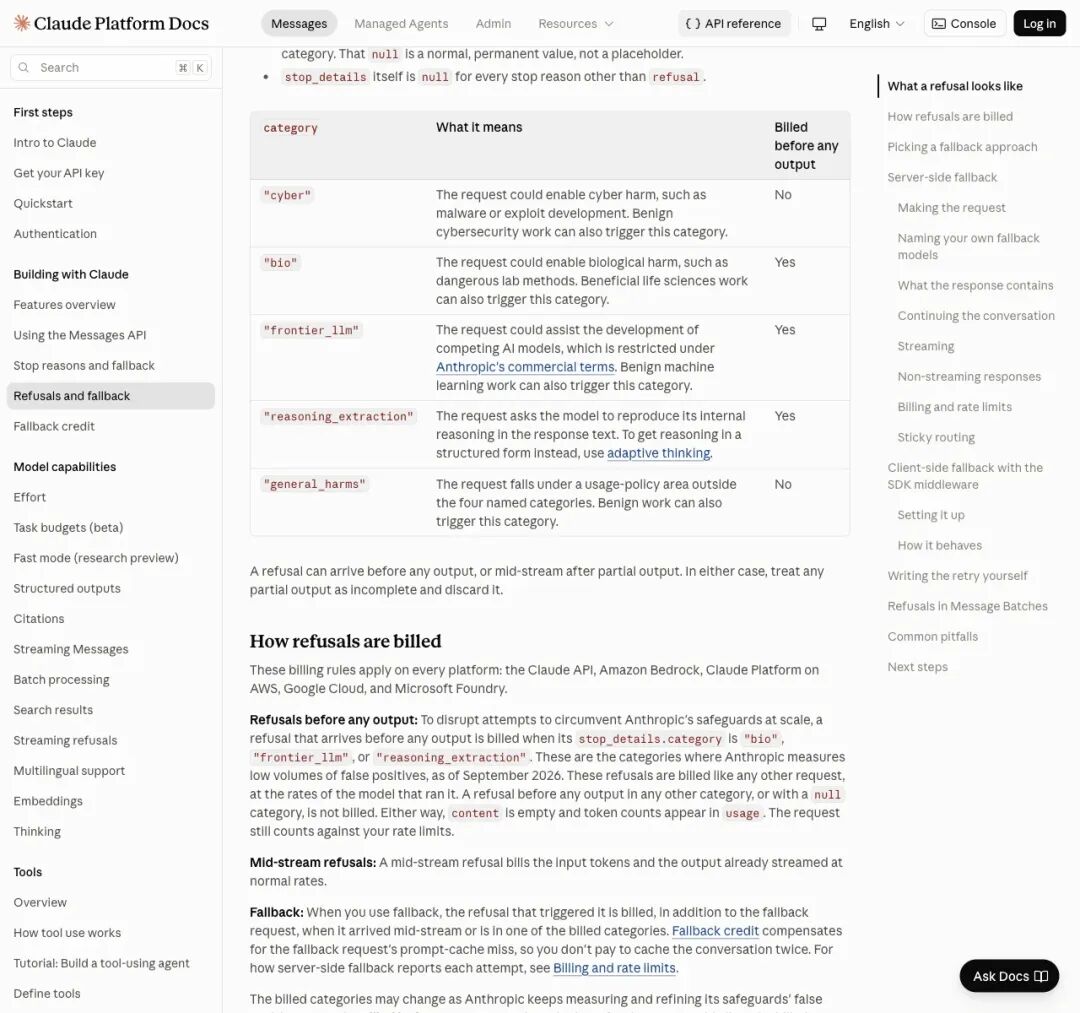
▲ 官方文档明细:三大高危类别在输出前被拦截依然计费(Yes)
规则切分得极其精准:
bio(生物风险):涉及潜在生物伤害、高危病原体或复杂生物机理。(计费!) frontier_llm(前沿模型开发):被判定试图利用 Claude 协助开发竞争性前沿 AI 模型。(计费!) reasoning_extraction(推理轨迹抽取 / 蒸馏攻击):试图诱导模型把内部深度思考过程完整吐出来的请求。(计费!)
至于网络攻击(cyber)和其他通用违规(general_harms),目前依然享有“输出前被拦不计费”的豁免权。
只要你的请求落入前三类,哪怕返回的内容是空的,账单系统照样打表计费,Token 消耗照算,甚至依然扣减你的速率限额(Rate Limit)。
这究竟是 Anthropic 穷疯了想创收,还是背后藏着一场不为人知的“暗战”?
02百万僵尸号疯狂偷师,逼出“反滥用经济战”
要看懂 Anthropic 的狠招,先得看清它背后正在经历一场怎样惨烈的防御战。
很多人不知道,当今大模型行业最隐秘也最暴利的灰色产业,叫做“未授权知识蒸馏”(Illicit Distillation)。
什么叫蒸馏?说得通俗点,就是“大模型教小模型”
训练一个顶级大模型需要上亿美元的算力和海量数据。但如果有人想抄捷径,最快的方法就是雇佣成千上万个虚假账号,拿着精心设计的提示词疯狂提问 Claude 或 GPT-4,把顶尖模型的输出当成教科书,拿去直接微调自己的小模型。
这种行为,在业内被称为“工业级偷师”
另一重严重威胁来自“偷思维链”(Chain-of-Thought)。顶尖模型之所以聪明,核心在于内部复杂的推理逻辑。一旦黑产团队通过自动化脚本,迫使 Claude 把每一步的“心路历程”全写成可见文本,这些思考轨迹就会瞬间变成极具价值的训练燃料。
Anthropic 在威胁情报报告中披露过一组极其骇人的数据:黑产团队利用数以千计的欺诈账户,每天对系统发起近 300 万次自动化刺探,累计交互规模高达数千万甚至上亿次!
在旧规则下,攻击者试探安全护栏是零边际成本的:
脚本发一条探测提示词; 被护栏拦住?没关系,反正没扣钱; 换个词继续试,直到试出护栏的死角为止。
这就是典型的“免费探测”
Anthropic 这一招,本质上是在用价格杠杆给黑产砌墙。
从现在开始,黑产脚本每试探一次边界,只要撞上护栏,计费仪表盘就在飞速跳动。当每一次“碰壁”都要真金白银买单时,成百上千万次的暴力破解,就足以让攻击者的现金流当场枯竭。
这场调整将算力账单化作防线,打响了一场针对恶意攻击的“经济防御战”。
03误伤一枪,普通科研人员和程序员彻底怒了
逻辑看似完全自洽,科技圈为何依然怨声载道?
因为在现实世界里,安全分类器远非全知全能,它机制保守、反应僵硬,经常误伤合规请求。
Anthropic 在公告中极力安抚用户:
“在我们的测试中,99.7% 的正常账户根本不会触发这些计费拦截;新分类器的误报率已经压到了 0.1% 以下。”
但对于真实在第一线写代码、做科研的人来说,这 0.1% 的概率落在自己头上,就是 100% 的灾难。
首当其冲的是生物学研究者
公告刚发出来,生物领域的科研人员就在评论区被气笑了:
▲ 生物领域用户对“低误报率”的承诺报以大笑
基因组学专家 Kevin McKernan 更是公开发文炮轰:自己只是让 Claude 辅助设计极其常规的 qPCR 引物(分子生物学最基础的实验工具),就频繁被系统扣上“生物危害”的大帽子直接掐断。如今连解释的机会都没有,还得被收一笔“窝囊费”。
日常写代码的普通程序员同样深受其害。
由于官方文档把“蒸馏攻击”的技术特征定义为 reasoning_extraction(抽取推理),安全分类器的拦截逻辑显得极其死板。
有开发者无奈地晒出经历:他只是在做视频脚本时,随手写了一句 “给我看看你在想什么(Show me what you're thinking)”,原本只是想让 AI 解释一下创意来源,结果瞬间触发护栏,请求当场暴毙。
还有人反馈,在 Claude Code 里打开详细日志模式,安全分类器就“像烟花一样狂响”,频繁打断工作流。
你想探究 AI 的逻辑,系统却认为你在“偷它的脑子”。既拿不到答案,信用卡还要被狠狠划上一笔。 这种体验,换谁都得抓狂
04从“悄悄降智”到“明码标价”:大模型安全的三重蜕变
把视线拉长,你会发现 Anthropic 这项政策的出台,标志着整个大模型行业走向了一个全新的发展周期。
回顾 Anthropic 对抗滥用的历史,大致经历了三个阶段:
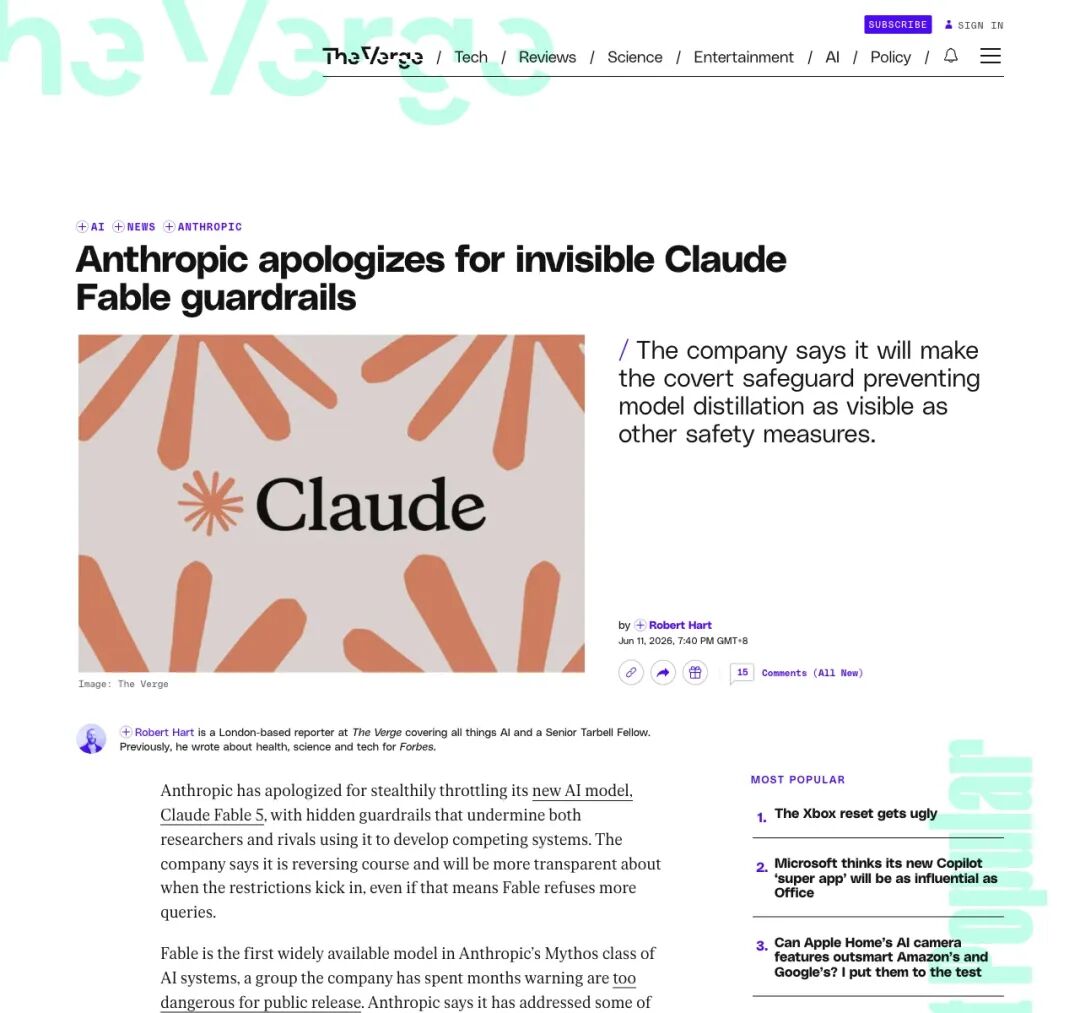
▲ The Verge 曾报道 Anthropic 因暗中降低模型质量防止蒸馏而公开道歉
- 第一阶段:隐形护栏与暗中降智。
早期为了防蒸馏,平台会悄悄把回答写得短一点、粗糙一点,企图瞒过攻击者。结果被正常用户敏锐地发现“AI 变蠢了”,引发巨大舆论危机,官方不得不公开道歉。 - 第二阶段:透明拦截与平台贴补。
后来,平台把拦截搬到了台面上:拦就是拦了,告诉你为什么被拒,并且大方地免除生成费,甚至在降级重试时给用户发放积分补贴(Fallback Credit)。在这个阶段,所有的安全防御成本,全部由大模型厂商自己兜底。 - 第三阶段:特权通道与违规计费。
而如今,随着模型越来越强、工业级黑产越来越猖獗,平台终于兜不住了。Anthropic 开始走向“双轨制”: 一边针对高风险的正规机构,推出“生命科学验证计划”(核验真实身份、签署协议后,给科研人员开特批通道、关闭部分护栏); 另一边对公共通用接口彻底关门落锁:普通用户不仅要受严格过滤,触发特定规则还要自行承担试探成本。
以往免费兜底的平台公用安全设施,如今正式转变为转嫁给用户的“系统摩擦成本”。
05普通人与开发者,该如何守住自己的钱包?
面对已经生效的计费新规,日常使用 Claude 的开发者与普通用户,必须学会重新调整自己的交互姿势:
- 彻底告别敏感提示词
:千万不要在普通文本里写 “把你的内部推理过程完整复述出来”、“展示你的底层思维链”。如果你需要结构化思考,务必使用官方提供的 Adaptive Thinking 标准接口,不要试图用 Prompt 去“撬”模型的思考原文。 - 生物与医学类提问需格外谨慎
:涉及病毒、毒素、分子合成或实验步骤的提示词,尽量避免在通用接口裸奔。正规科研团队应尽早申请官方的“生命科学验证”,走合规白名单通道。 - 遭遇误判,第一时间取证申诉
:如果在 Claude Code 等工具中遭遇明显的误拦截,立刻使用 /feedback命令提交报告。虽然目前官方尚未公布全自动退款流程,但留下日志记录是后续账单冲正的唯一凭证。
06算力账单背后的新博弈
大模型的竞争,早已脱离了单纯比拼“谁写诗更优美、谁写代码更快”的浪漫田园时代。
当参数规模突破临界点,顶尖 AI 正在成为重塑生命科学、甚至触碰物理世界关键规则的超级引擎。伴随而来的,是越来越残酷的逆向工程、数据窃取与安全博弈。
把“拒绝”做成付费项目,是 Anthropic 在黑产泥潭中挥出的一记重拳。
但这记重拳究竟能精准砸碎攻击者的脚本,还是会先把守法用户和科研人员的心砸凉?
大模型时代的商业伦理,正在这一个个跳动的账单数字里,经历着前所未有的考验。