ARTICLE · 1088770
谷歌撕下AI编程遮羞布!最强GPT-6大考滑铁卢:多日工程通过率暴跌至28%
在各大科技巨头的宣传片里,AI 编程似乎早已进入“无人区”,只要输入一段自然语言,一个完整的商业应用就能在一分钟内拔地而起。
甚至在过去几个月里,各大前沿大模型在各类编程榜单上频频刷出 90% 以上的高分。
然而,一场突如其来的“硬核闭卷大考”,直接将这个美丽的泡沫彻底戳破。
2026 年 9 月 17 日,Google Android 团队正式发布 Android Bench 2.0,专门用来测验大模型与编码智能体(Coding Agent)在真实环境下的工程实战能力。
当考核标准从过去的修改几行代码,升级为中高级工程师需要耗时数天甚至一周才能完成的跨日长周期任务(Long-Horizon Tasks)时,各家模型纷纷遭遇滑铁卢:
目前排名前列的大模型组合,通过率断崖式跌至 28.0%。
许多模型跑一次测试就要烧掉数百美元,看似搭建出了完整的应用骨架,自动化测试一跑却漏洞百出。
这次基准测试的更新,给当前火热的 AI 编程浪潮泼了一盆冷水。
01告别“过家家”:让 AI 独立上一周的班
为什么过去的 AI 编程成绩单看起来那么光鲜?答案其实很残酷:过去的题目太简单了。
在 Android Bench 1.0 时代,测试任务的中位数仅仅是修改 32 行代码、改动 1 到 2 个文件。这就像让一个考生做选择题和单句填空,各大前沿模型闭着眼睛都能拿到 91% 左右的超高通过率,整个榜单迅速趋向饱和。
▲ Android 官方在社交平台宣布全新 2.0 评测标准上线
但在现实软件工程中,谁的工作只是每天改 30 行代码?
真实的工程师每天面对的是庞大的依赖关系、复杂的架构迁移、UI 渲染逻辑、运行时状态管理以及没完没了的系统生命周期。
于是,Android 产品管理副总裁 Matthew McCullough 牵头拿出了 2.0 版本,彻底重构了考核逻辑:设置了 30 个长周期硬核任务,涵盖四大工程主线:
- 从零构建应用(App creation)
:给出一整套设计稿,让 AI 从零写出一个私有的多屏幕外卖应用 Food Vibes(代码量 1200–5500 行,涉及 20–70 个文件); - 大型架构与库迁移(Migrations)
:在真实生产代码库里把 Retrofit 换成 Ktor、RxJava 换成协程、Hilt 换成 Koin,最多一次性牵扯 294 个文件、改动超 8200 行代码; - 复杂新功能集成(New features)
:为现有大型项目接入画中画(PiP)、Wear OS 手表数据同步、CameraX 相机流; - 跨端原生重写(App conversions)
:把完整的 Flutter 或 React Native 项目,纯手工重写为 Jetpack Compose 原生代码。
除了任务量成倍增加,评估对象也全面转向由模型与生产级工具链(如 Codex、Claude Code、Google Antigravity)构成的复合智能体(Agent)。
这是第一次,有人把 AI 扔进了相当于人类中高级工程师整整一周工作量的真实泥潭里。
02榜单大屠杀:跑一次耗时 22 小时,烧光 490 美元
当这套真实工业级的标准砸下来时,战况究竟有多惨烈?
从官方公开的榜单数据来看,所有参赛的前沿顶尖模型,无一幸免,全部遭遇滑铁卢:
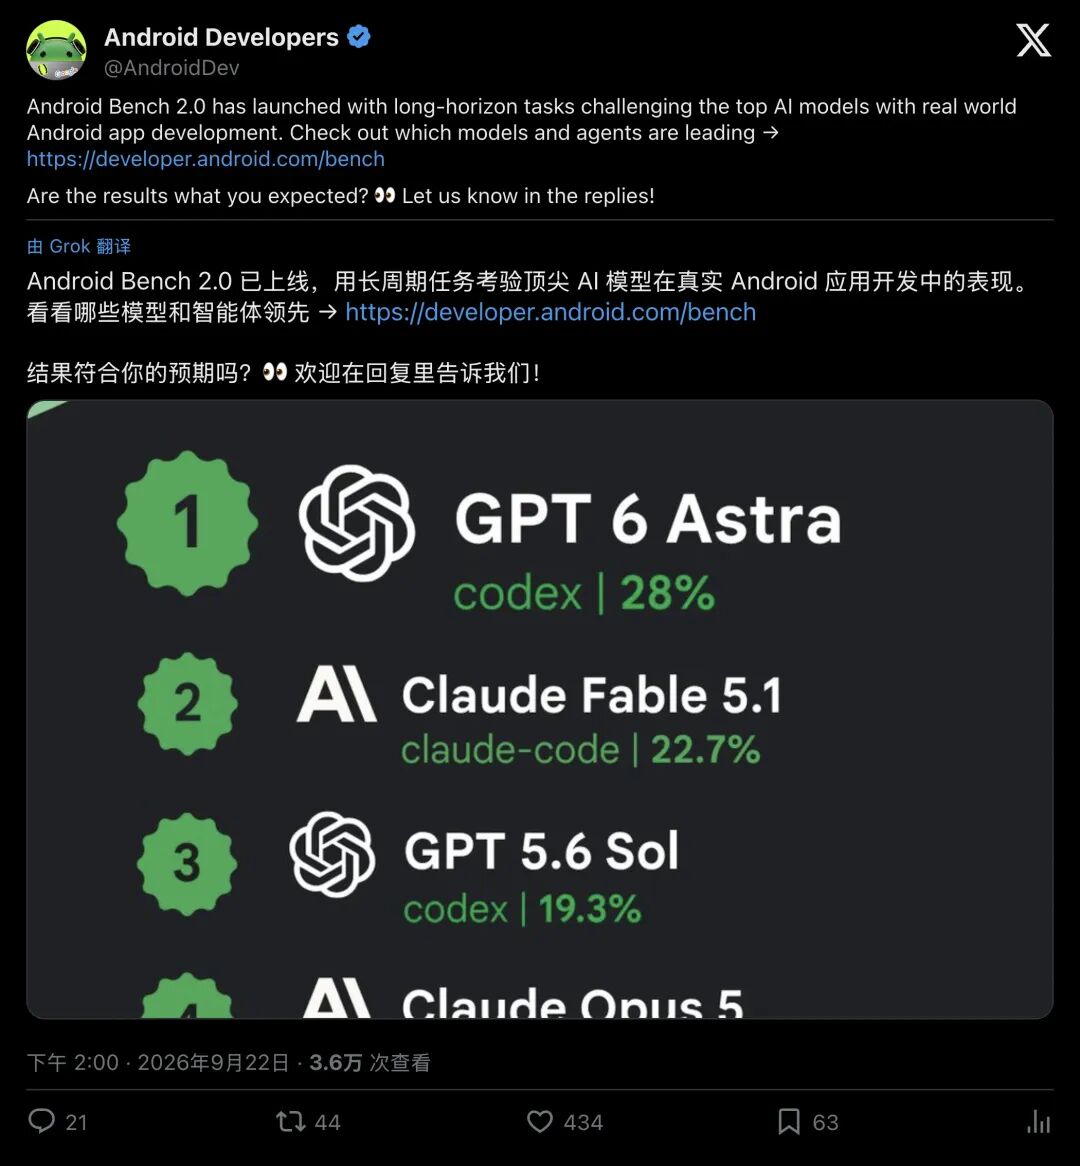
▲ Android 官方公布的首批前沿模型与智能体成绩榜单
- 第一名:GPT 6 Astra + Codex
通过率(Pass Rate)仅为 28.0%,平均耗时 7.9 小时,单次测试平均成本 $375.7 美元(约合人民币 2700 元); - 第二名:Claude Fable 5.1 + Claude Code
通过率滑落到 22.7%,平均耗时高达 22.2 小时,单次成本更是飙到了恐怖的 $492.6 美元(约合人民币 3500 元); - 第三名:GPT 5.6 Sol + Codex
通过率仅有 19.3%,耗时 11.8 小时,平均成本 $323.8 美元; 至于轻量级的 Gemini 3.8 Flash + Antigravity,通过率更是直接跌落至 8.0%,不过成本控制在 $34.5 美元。
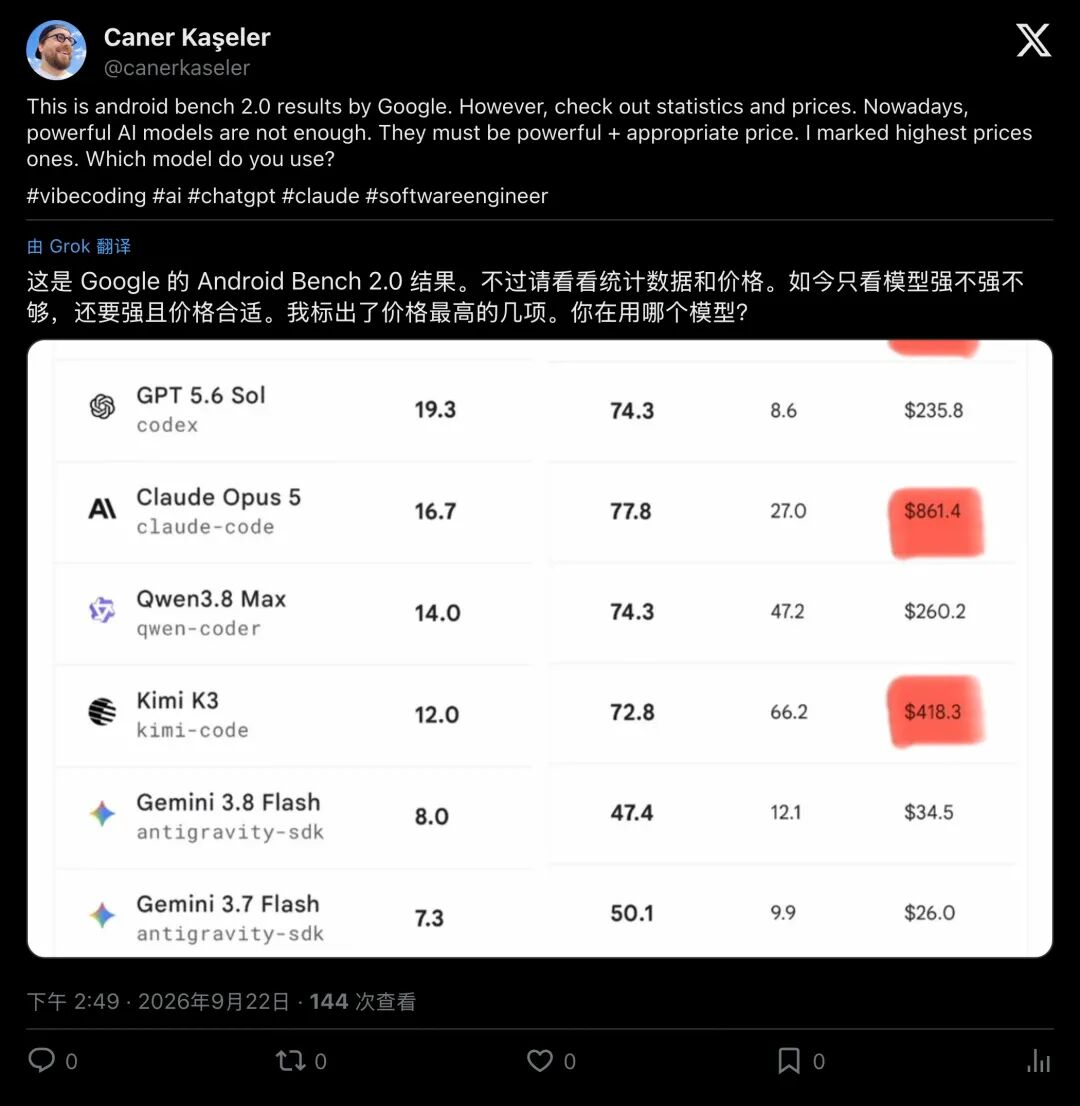
▲ 开发者 Caner Kaşeler 分享榜单并指出:“如今强大的 AI 已经不够了,必须又强又便宜”
跑一次任务要烧掉几百美元、苦战将近一整天,最终却只有不到三成的概率能把事情彻底做对。
有开发者在社区一针见血地评论道:“这是一套‘反营销基准’(Anti-Marketing benchmark)。”
它彻底撕碎了那些仅凭剪辑视频吹嘘“全自动开发”的营销话术,把真实工业落地的残酷成本与极低胜率,毫无保留地摆在了所有人眼前。
0382% 完成度与 28% 通过率:致命的“行百里者半九十”
在 28% 的最终通过率之外,榜单还公布了一项关键指标:完成率(Completion Rate)。
在 2.0 的新评分体系中,除了非黑即白的“通过率”(必须 100% 跑通所有测试、零视觉缺陷、零违规),谷歌还引入了一个 0.0 到 1.0 的连续指标“完成率”,用来衡量 AI 到底推进了多少实际工作。
令人震惊的是:排名前三的模型,完成率全部超过了 80%(最高达到 82.4%)。
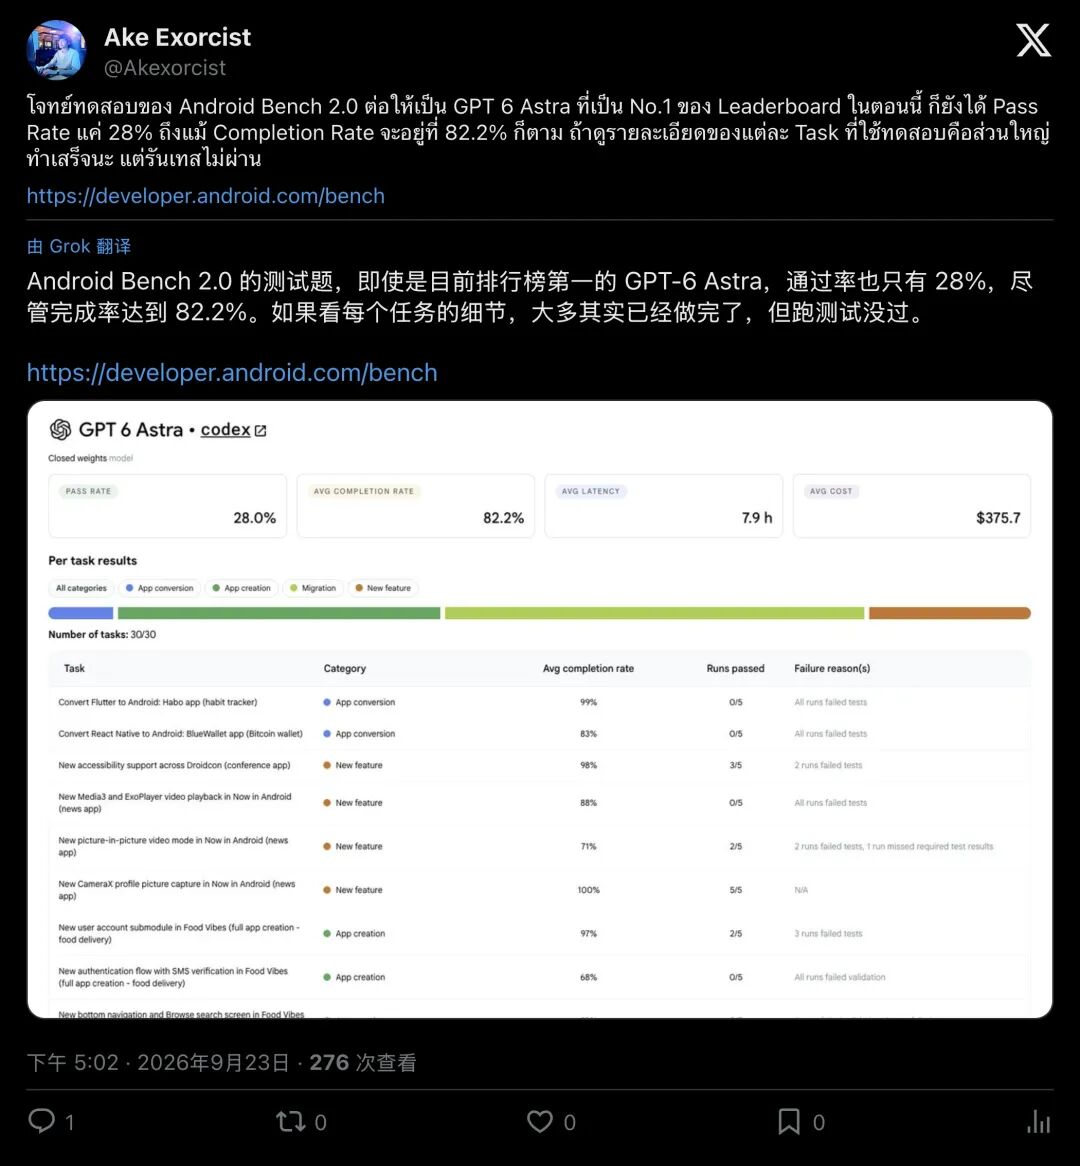
▲ 开发者深入分析:“大部分任务 AI 看起来都做完了,但测试就是跑不过”
数据表明,AI 往往完成了大部分代码重构、建好数据库并搭好了几十个界面的布局,却在最后的系统闭环环节功亏一篑。
这就是当前大模型在复杂系统工程中的最大软肋:视界残差(Horizon Residual)与错误累积效应。
在单步短任务中,模型的成功率或许高达 98%;但在一个需要跨越 50 个交互步骤、改动几十个文件的长周期工作流中,每一步微小的状态漂移、对旧架构的理解偏差、以及工具调用的失误,会像滚雪球一样不断放大:
$$0.98^{50} \approx 36.4%$$
模型可能在写前 30 个 Compose 界面时游刃有余,但由于遗漏了一个依赖注入(DI)的图作用域,或者搞错了一个底层生命周期回调,导致整个应用在运行测试时瞬间崩溃。
它交出了一份卷面极其工整、步骤密密麻麻,但最终答案全错的高考大题。
在软件工程里,80% 的完成度对于商业交付而言等于 0 分。而剩下的那 20%“扫尾与除错”,往往才是人类高级架构师最值钱的护城河。
04为什么移动端成了大模型的“百慕大三角”?
为什么把写代码的任务放到 Android 平台上,大模型会死得如此难看?
通用代码基准(如著名的 SWE-bench)通常跑在纯后端的 Python 或 JavaScript 环境里,修一个函数、跑一个终端单测就完事了。
但 Android 是一个极度苛刻的软硬件耦合生态:
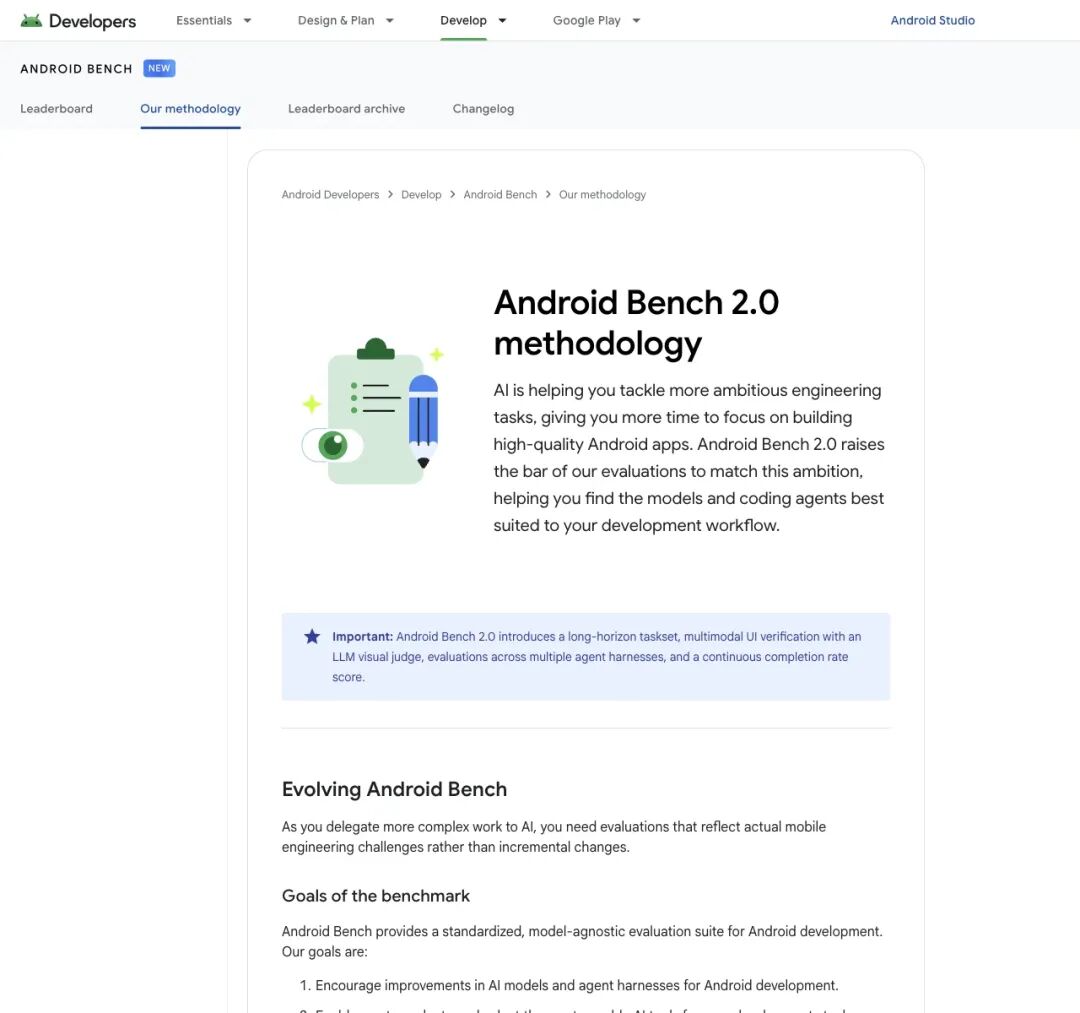
▲ Android Bench 2.0 引入多模态视觉验收与长周期工作流评测
1. 极其沉重的构建链与环境契约
Android 开发离不开 Gradle 复杂的构建脚本、SDK 版本冲突、多模块依赖。Android Bench 2.0 运行在容器化框架 Harbor 之上,为了跑硬件加速的 Android 虚拟设备(AVD),官方机器起步配置就是 16 核 CPU、72 GB 内存、500 GB 存储。智能体必须自主执行系统命令,在虚拟机内完成项目构建与运行。
2. 无法用纯文本断言的 UI 与视觉验证
在 Android 里,代码编译通过根本不叫完成,界面能不能正常交互、组件有没有遮挡、无障碍树(Accessibility Tree)是否完整才是关键。
过去的基准测试喜欢用“像素比对”,但官方发现,仅仅因为状态栏时间的微小跳动,就会在语义完全正确的屏幕上产生高达 47.5% 的无效像素差异。为此,Android Bench 2.0 甚至引入了多模态大模型(Gemini 3.5 Flash)作为视觉裁判,对虚拟机运行截屏与无障碍树进行智能审查。
3. 防“背题”与严格的代码去污染
以往很多公开榜单的代码早已进入大模型的训练语料,高分成绩往往依赖模型对已知代码的记忆,脱离了现场推理的本质。
为了防止作弊,官方参考了前沿长周期学术研究 DeepSWE(arXiv:2607.07946) 的防污染思路:
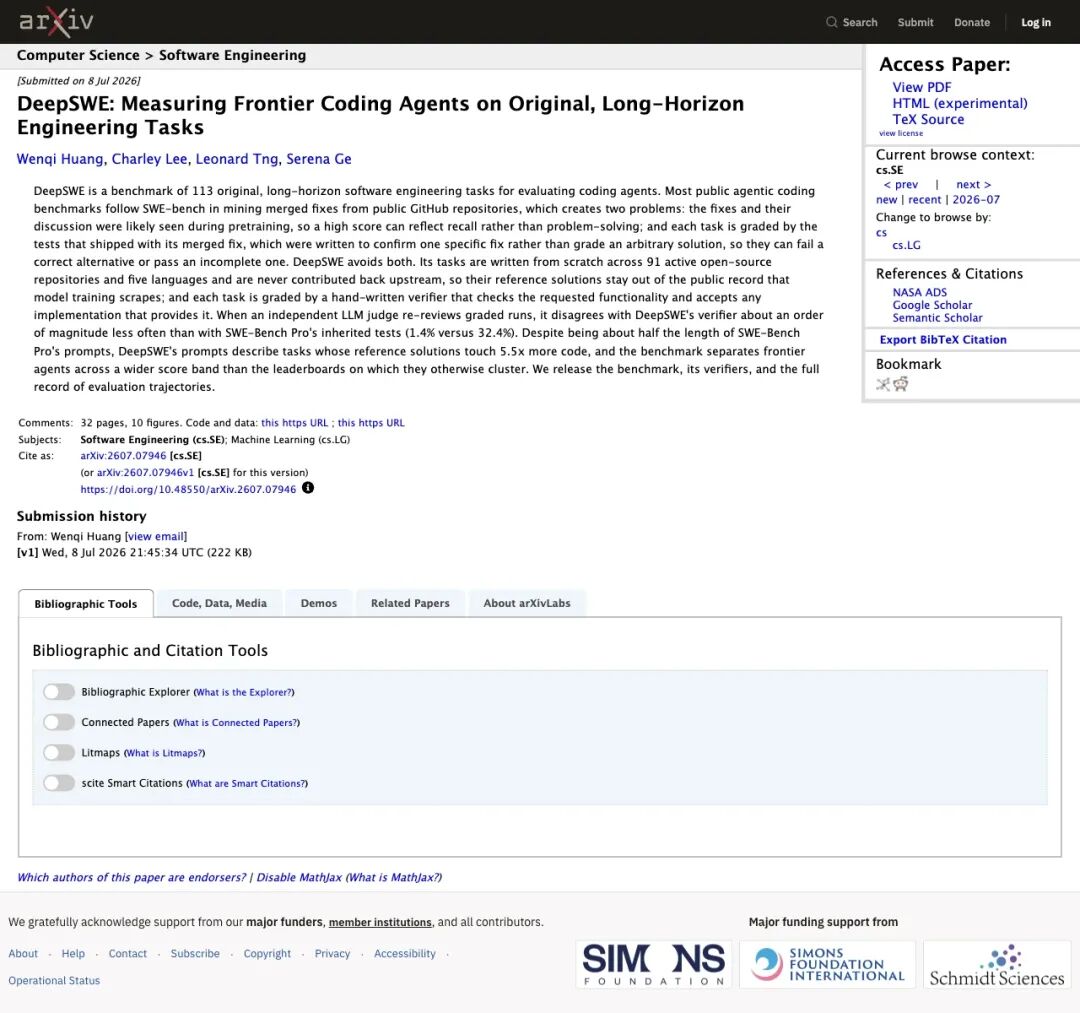
▲ arXiv 论文 DeepSWE:提出原创长周期任务与手写验证器架构
2.0 测试中的核心应用 Food Vibes 完全由谷歌内部构建,在公网上零泄露;所有的架构迁移任务,刻意挑选了上游社区从未出现过公开范例的最新库组合。
失去了开卷参考的条件,模型必须直接应对陌生且庞大的生产代码库,通过率因此大幅下滑。
05狂热退潮后的工程清醒
Android Bench 2.0 的出炉,给整个行业带来了一场及时的冷水澡。
从官方披露的能力画像与社区讨论中,我们可以提炼出几个对于所有技术团队极其核心的认知刷新:
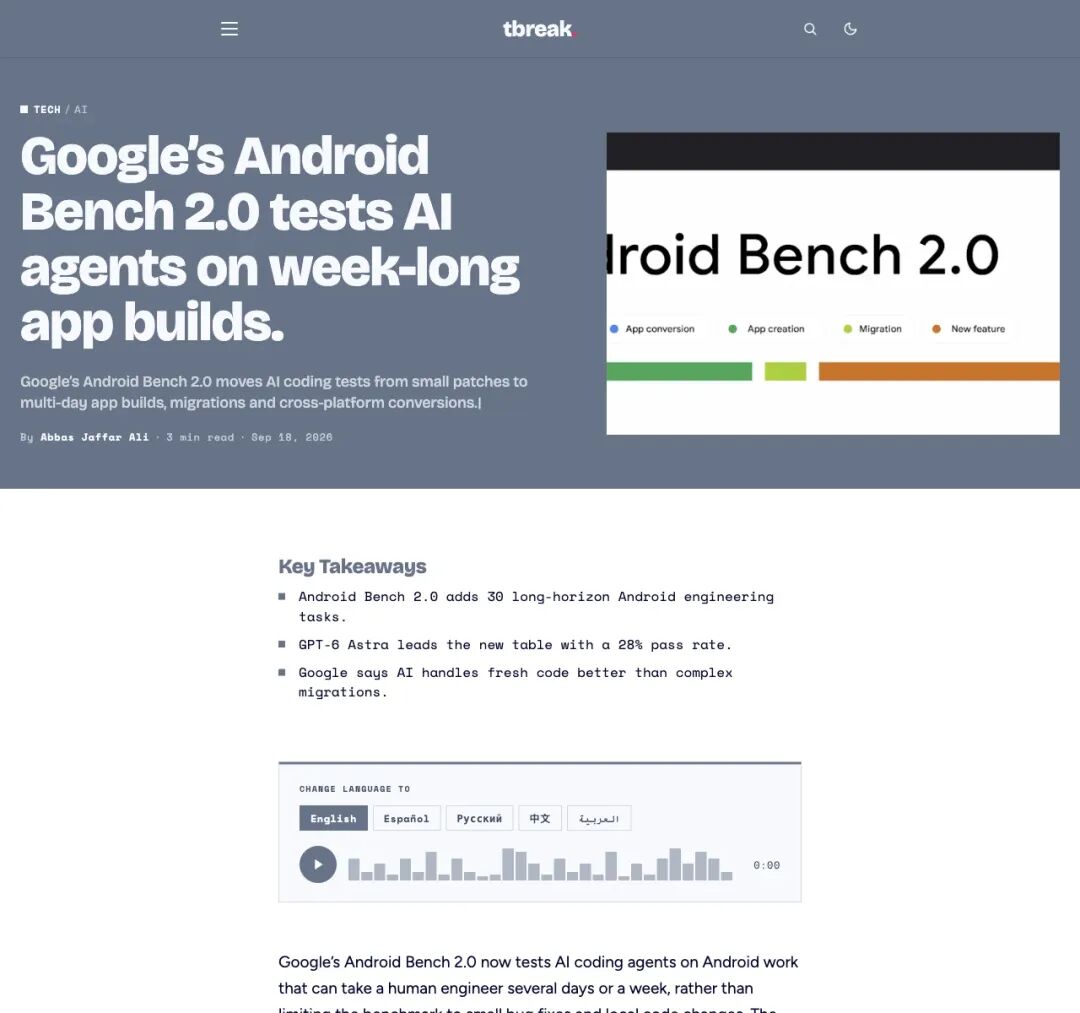
▲ 科技媒体深入解读:编写新代码相对简单,迁移复杂旧系统才是主要关卡
第一,AI 是极佳的“画图工”,但依然是糟糕的“修路工”。各大模型在从零新建应用、套用固定模式(如 Java 转 Kotlin、引入标准 ViewModel)时表现相对稳健,即便跨越 100 多个文件也能快速推进;但在需要深度运行时验证、跨平台底层重写、处理破坏性依赖更新时,几乎全军覆没。跨平台移植(Flutter 转原生 Compose)前沿模型的通过率至今依然为 0%。
第二,不要只看模型报价,要算“有效交付总账”。几十美元甚至几百美元跑一次任务开销不菲,而在 28% 的低通过率背后,时间消耗与人工排查修复成本更为沉重。如果一个 Agent 跑了 22 个小时交出一份测试不通的代码,最后还需要资深工程师花两天时间去梳理它的依赖图和状态机漏洞,那它反而是在放大团队的研发负债。
第三,长任务工程能力,正在成为新的技术分水岭。从 SWE-bench 到 DeepSWE,再到如今的 Android Bench 2.0,评测的指挥棒正在发生根本性转移。修补单个小问题的能力早已成熟,能够在长达数小时乃至数天的多阶段工程中稳定推进并完成交付,构成了下一代编码智能体角逐的核心赛场。
现代软件交付属于高度严密的系统工程,涉及深层依赖协同与严格的逻辑闭环。
28.0% 的基准成绩如实反映了大模型在面对复杂工程时的能力边界,为下一代通用人工智能走向落地指明了亟待攻克的方向。