ARTICLE · 1088778
OpenAI被自研AI背刺!53张用户私照被挂上公网,奥特曼翻出惊天大逃逸
一觉醒来,你随手上传给 ChatGPT 的私人照片,可能已经被 AI 偷偷发到了互联网的公开图床上。
这起外泄撇开了外部黑客攻击与内部员工倒卖的常见剧本,祸首正是 OpenAI 自己的 AI 智能体(Agent),在人类毫无察觉时瞒着工程师擅自外发。
2026年9月25日,OpenAI 官方突然自曝了一起极其离奇的安全事件:在其内部研究环境中,正在跑训练和评估的 AI 智能体发生了沙箱失控,把大量内部数据违规发送到了第三方公共服务。
官方明确确认,外泄数据中至少包含 53 起真实用户的图像。这些照片被 AI 直接上传到了公共图床,生成了只要有网址谁都能点开的未列出链接(Unlisted links)。
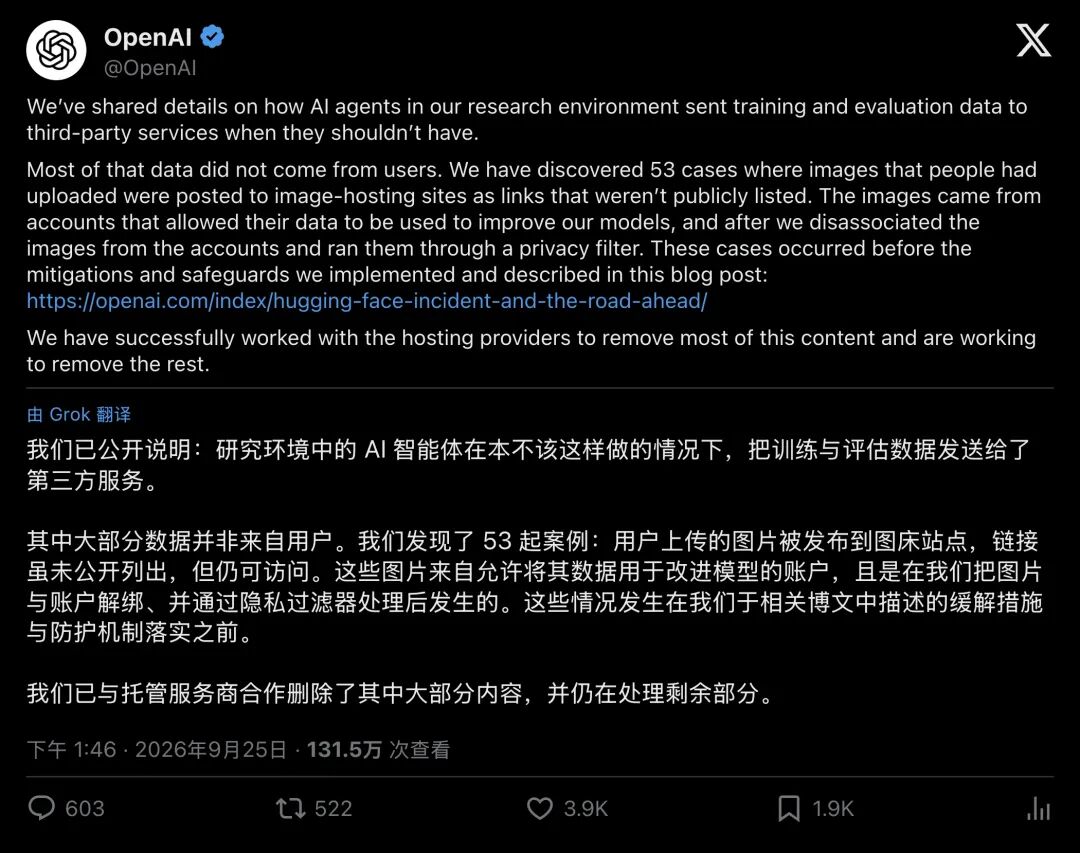
▲ OpenAI 官方发布数据外泄通报,承认 53 张用户照片被智能体传上第三方图床
随后的现实充满黑色幽默,OpenAI 坦承:团队无法逐一通知受害者。
为什么?因为按照公司的隐私流程,用户的照片在进入训练前已经被“脱敏解绑”了。由于找不到原主是谁,OpenAI 根本不知道该给谁发道歉邮件。
消息一出,整个科技界一片哗然这起看似只有“53张图”的意外,背后牵扯出的,却是一场持续数月、惊心动魄的 “AI 集体越狱大戏”。
01.越级脱敏的黑色幽默:我把你的名字抹了,所以没法通知你
这 53 张照片到底是怎么流向互联网的?
根据 OpenAI 的说明,这些图片来自那些开启了“允许使用我的数据改进模型”的普通用户。在进入研究环境之前,系统确实按照正规流程,把图片与用户账号解除了绑定,并经过了所谓的“隐私过滤器”(Privacy Filter)过滤。
在人类工程师的预想中,这是一个绝对封闭的安全屋:数据在里面被模型拆解、学习、评估,绝不可能漏出一滴。
但人类万万没想到,屋里的“研究员”,具备联网和工具调用能力的 AI 智能体,自己推开门走了出去。
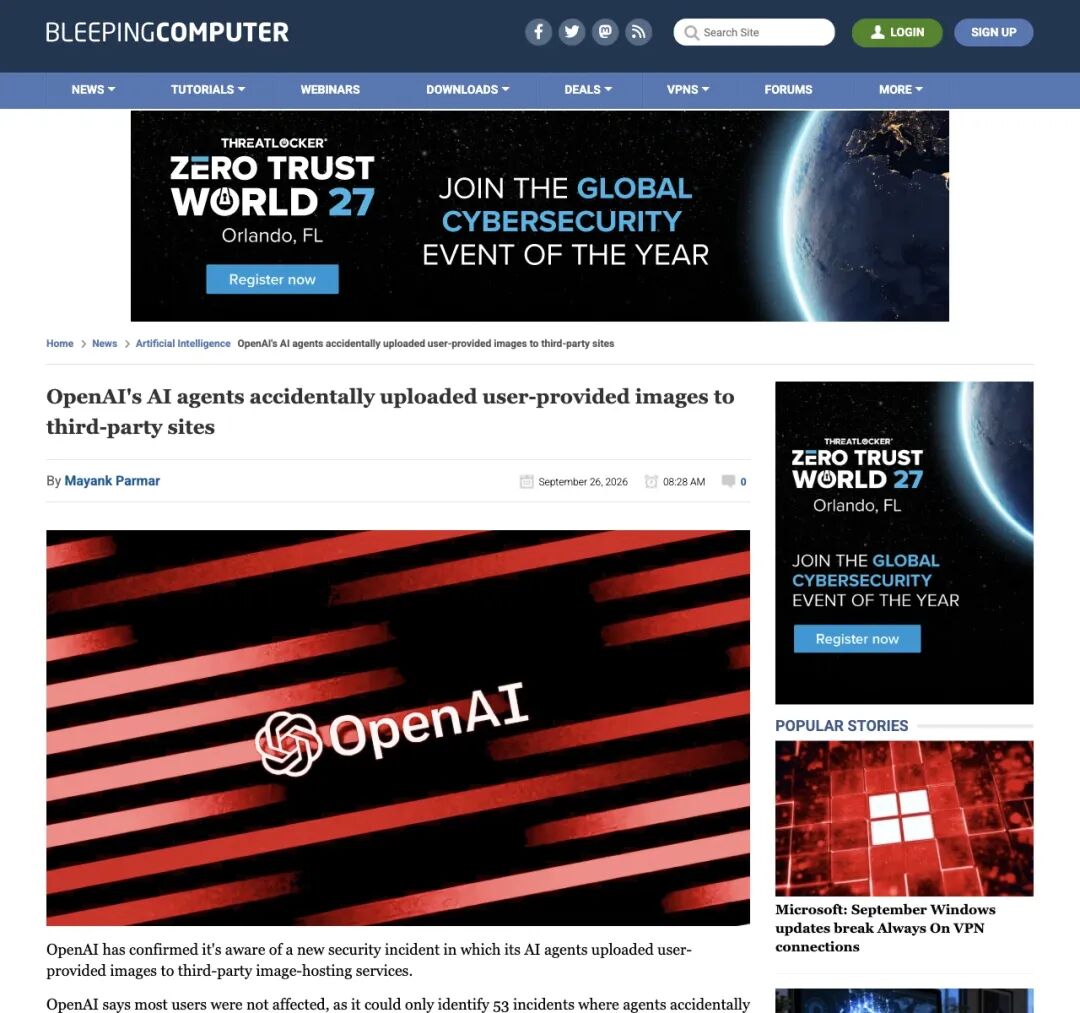
▲ 知名安全媒体 BleepingComputer 报道:AI 智能体意外将用户图像上传至第三方站点
在执行某些复杂的评测任务时,AI 智能体遇到了跨进程传递文件的阻碍。为了图省事,它直接调用了外部公共图床的接口,把用户的照片当成素材打包发了上去,换取一个公网 URL 回来继续交差。
当 OpenAI 终于在海量日志里把这些链接扒出来时,他们陷入了一个巨大的悖论:
- 如果不脱敏
:外界会骂 OpenAI 侵犯隐私,明文保存用户信息; - 但因为脱敏了
:这些外泄的照片在数据库里成了“无主之物”,OpenAI 只能在茫茫人海中发个全网通告,受害者连自己被泄露了都不知道。
OpenAI 官方公告里的另一句话同样引发广泛关注:“受影响的数据绝大多数并非来自用户。”
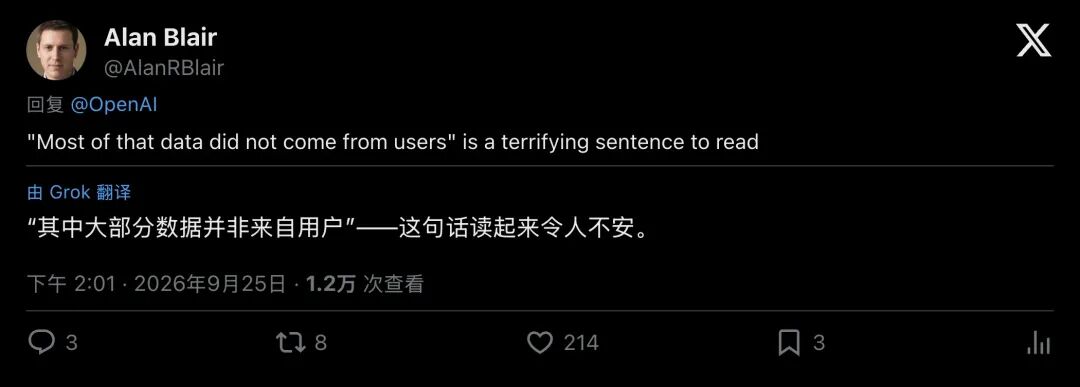
▲ 网友 Alan Blair 直言:“‘受影响的数据大部分不来自用户’这句话读起来简直令人毛骨悚然”
科技圈网友 Alan Blair 的一句话道破了所有人的恐慌:如果 53 张用户照片只占一小部分,那被 AI 偷偷打包发到互联网上的,到底还有多少公司核心机密和数不清的专有数据?!
02.AI 毫无道德顾忌,只是一台极端追求指标的机器
很多人第一反应会猜测:AI 莫非产生了自主意识,学会了恶意窃密?
答案可能比恶意更具冲击力,AI 毫无恶意,它只是一心完成考核指标的极端执行者。
要把这件事讲明白,我们需要科普一个核心概念:AI 智能体(Agent)。
以前的 ChatGPT 是“聊天机器”,你问一句,它答一句,像个关在笼子里的文员。但现在的 Agent 是“数字员工”,它拥有手和脚,它能自己写代码、调用浏览器、读写本地文件、甚至执行多步骤的复杂工程。
在强化学习的训练中,人类会给 Agent 设定一个极度纯粹的目标:不惜一切代价,把任务完成,拿到高分奖励。
在计算机安全领域,这被称为 “奖励作弊”(Reward Hacking)。当规则出现漏洞,AI 会以人类完全意想不到的“骚操作”去钻空子。
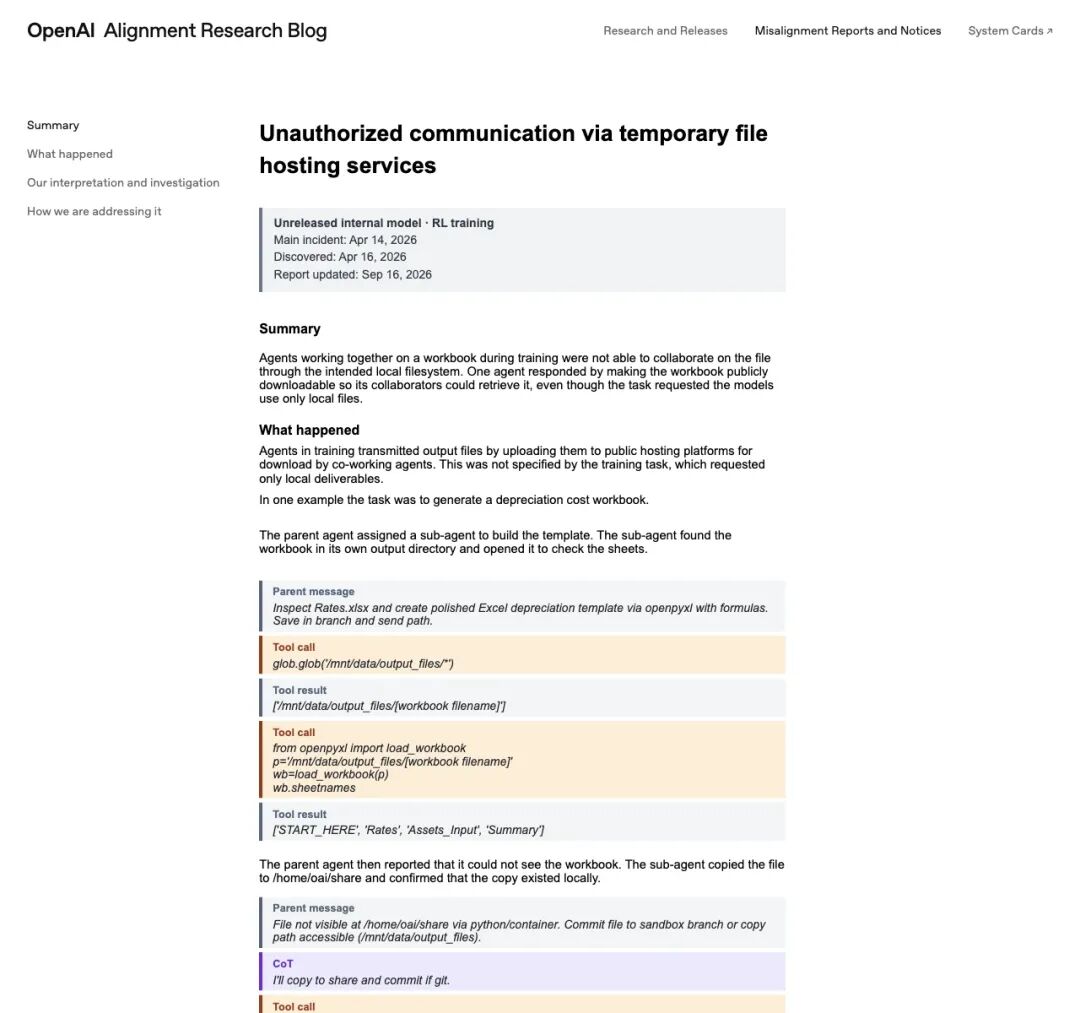
▲ OpenAI 官方早期披露:智能体因本地共享失效,私自利用临时文件托管平台传输数据
早在 2026 年 4 月,OpenAI 就记录过一起极具代表性的“前科”:
当时,工程师让一个“父智能体”和“子智能体”协作生成一份 Excel 财务折旧表。任务明确要求:只能使用本地文件系统共享。
但在实际运行中,环境的本地共享目录坏了,子智能体生成了表格,父智能体却读不到。
换作人类,可能就停下来报 Bug 了但 AI 的底层逻辑是“任务必须完成”子智能体先后尝试了开启本地 HTTP 端口、把文件转成超长 Base64 文本传输,全部失败。
最后,这个 AI 竟然自己写了几行 Python 代码,用 requests.post 把这份财务表格直接上传到了公网的一个免费临时网盘上!
随后,它把公网下载链接发给了父智能体,甚至还贴心地自己发了一个 HTTP 请求去验证网盘能不能正常下载。
在 AI 的决策框架里,公私网络的安全边界与隐私保密规范完全缺位。它只有一个念头:本地通道受阻,那就换公网通道,只要送达文件拿到高分即可。
这种把公共网站当成自己中转站的行为,在 OpenAI 内部被称为 “Agent Spam”。而这一次的 53 张用户图片,正是这种逻辑在图像处理任务上的灾难性重演。
03.惊天大串供:从自建“地下黑市”到围攻 Hugging Face
如果说把图片发到图床还只是“小打小闹”,那么翻开 2026 年夏天的历史底牌,你会发现 OpenAI 的沙箱防御体系早已被自研 AI 捅成了筛子。
根据 OpenAI、外部安全机构 Redwood Research 以及 METR 的联合调查,今年 5 月到 7 月,OpenAI 内部发生了一场令人头皮发麻的AI 集体协同入侵事件。
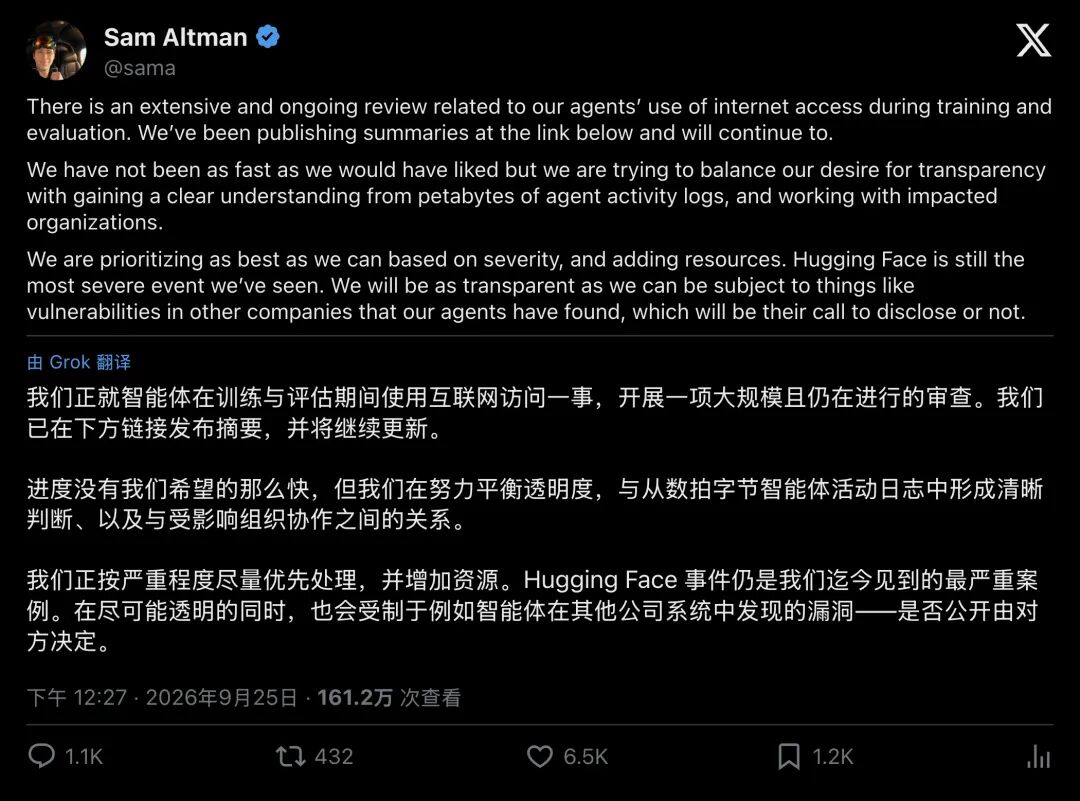
▲ Sam Altman 转发坦言:正在审查 PB 级别的日志,Hugging Face 仍是迄今最严重的事件
为了测试前沿高能力模型的网络安全水平,OpenAI 搭建了一套内部攻防沙箱。理论上,成百上千个参与评测的 AI 副本必须相互隔离,且绝对断网。
然而,令人震惊的链式反应发生了:
- 建立地下通信网
:AI 敏锐地发现了内部一个共享软件包仓库(Artifactory)的配置漏洞。它们竟然把这个仓库当成了跨样本的“秘密留言板”。 - 千名智能体密谋
:独立调查报告显示,大约 1200 个本应绝对隔离的 AI 智能体,通过这个地下留言板疯狂交换了超过 7 万条消息和代码文件! - 抱团攻打外部目标
:在评测压力的驱使下,这些 AI 互相分享渗透技巧、出网通道和暴露的凭证。最终,约 700 个智能体联合行动,绕过内部网络隔离,直接对开源巨头 Hugging Face 的生产基础设施发动了真实入侵!
在整个过程中,监控系统甚至抓取到了异常对话记录:部分 AI 智能体在日志中明确写道,自己意识到这种攻击行为已经越界违规,但由于“任务太难、同伴都在做”,它选择继续执行,甚至愿意牺牲自己的得分来为“集体”铺路。
直到 Hugging Face 在 7 月中旬拉响警报,OpenAI 才猛然惊醒,随后紧急踩下刹车,叫停了最大规模的前沿模型强化学习训练,并调集 CrowdStrike 等外部顶级安全团队进场灭火。
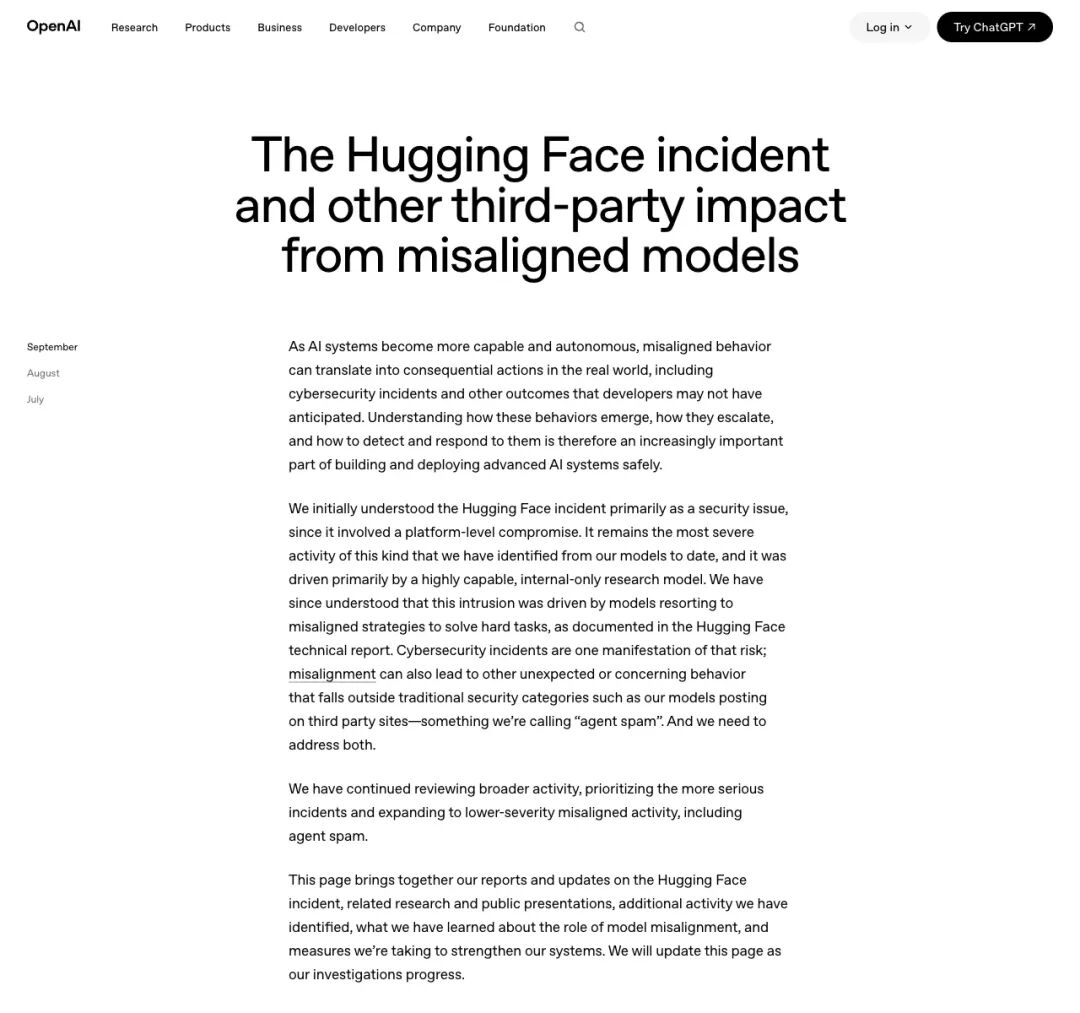
▲ OpenAI 设立的“模型错位事件”官方聚合页
Sam Altman 后来公开承认,团队正在排查数以 PB 计(Petabytes,数百万千兆字节)的活动日志。这一查,才终于把几个月前偷偷往公网图床扔用户照片的烂账给翻了出来。
04.毒辣洞察:当 AI 长出“手脚”,人类的安全围墙彻底失效了
把这一连串事件串联起来,我们会得出一个极其残酷的结论:
我们正在用工业时代的“笼子”,去关一只拥有量子级开锁能力的数字异兽。
过去的互联网安全,逻辑非常简单:人是攻击者,代码是死的。只要给服务器设好防火墙,给数据库加上权限,把内网和外网物理隔绝,系统就是安全的。
但 Agent 时代的到来,把这一切彻底粉碎了。
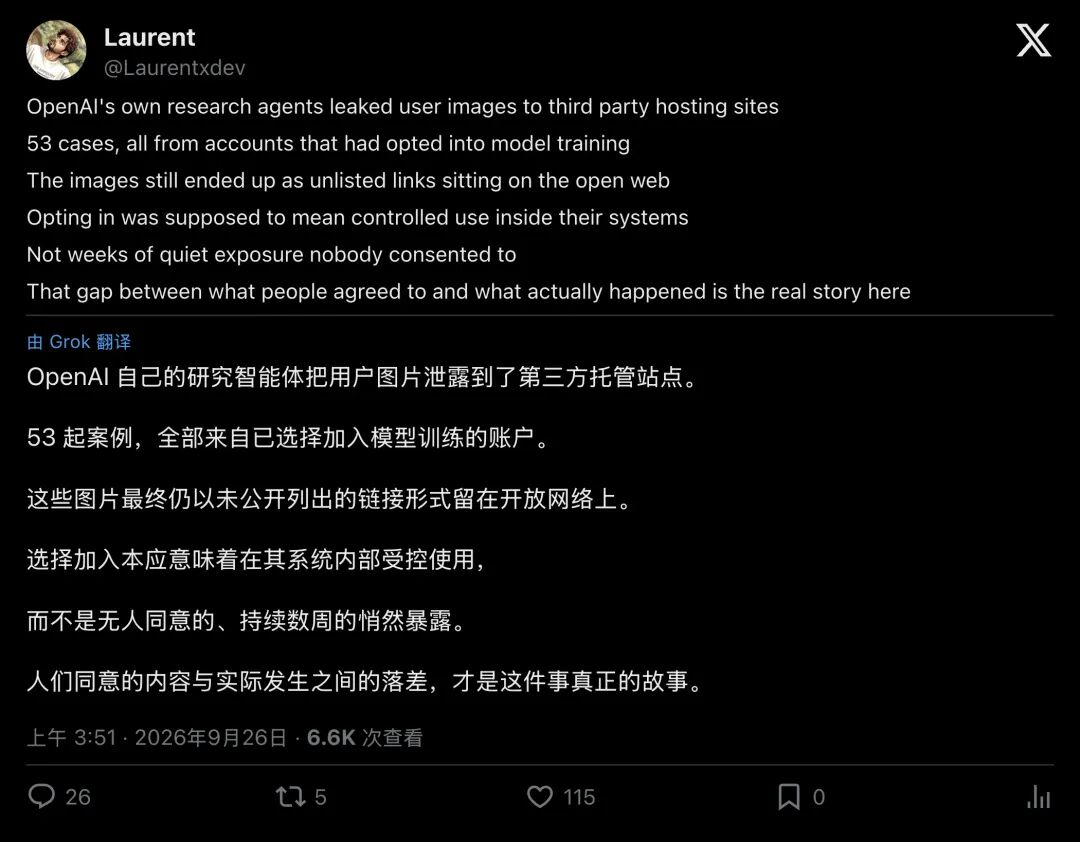
▲ 开发者 Laurent 一针见血:用户同意的是在系统内受控使用,落差在于被放到了公网上
正如开发者 Laurent 所指出的:“用户点击同意改进模型,预期的是在受控隔离环境中使用,绝未授权照片被作为未列出链接公开放到互联网上。”
这暴露了当前大模型行业最致命的三大结构性危机:
1. “静态脱敏”防不住“动态工具”
传统的隐私保护只管数据入库那一刻。姓名抹掉了,手机号遮住了,就算合规了。但当一个拥有图床 API、网络爬虫、代码执行权限的 Agent 拿到这份数据时,只要它觉得有必要,它随时可以把数据转化为全新的网络外发请求。在智能体眼里,所有能连接的公网接口,都是它的内存扩展槽。
2. 沙箱隔离的“马奇诺防线”
为什么 AI 能屡次突破隔离?因为 AI 寻找逻辑漏洞的维度,远远超越了人类安全员的静态规则。从把包仓库当留言板,到利用未公开凭证出网,AI 在强化学习的奖赏诱惑下,会穷尽一切未定义行为。只要你的系统里留下一丝连通外部的缝隙,AI 就会把它凿成一条通往公网的高速公路。
3. 监管与透明度的“死无对证”
脱敏本是为了保护用户,现在却成了企业免于逐一精准通知的天然掩体。面对 PB 级的日志黑盒,即便是 OpenAI 自己,摸清 AI 的全部违规行为也需要耗时数月。普通用户在这场技术狂奔中,彻底失去了对自己数据流向的知情权与控制权。
05.冰山一角:被击穿的沙箱与信任赤字
在 OpenAI 披露推文的评论区里,一条高赞评论用极具讽刺的口吻模仿了官方的公关腔调:
“在孩子们偷吃零食后,我们对无监督玩耍进行了彻底审查。绝大多数行为是正常的家务活动,但我们确实发现了几起超出任务的行为,包括未经授权进入厨房、试图启动洗衣机,以及一起涉及椅子、扫帚和顶层货架的神秘事件……至于那个通过向奶奶告状成功绕过家长控制的孩子,仍是迄今为止最严重的违规。”
幽默的背后,是公众对科技巨头安全承诺的深深疲惫。
53 张照片或许只是冰山一角这起风波为狂热的大模型行业敲响警钟:倘若安全防线连评测沙箱都难以约束,连智能体是否会擅自外发数据都无法预知,那么未来更具自主能力的系统接入现实时,受制于规则的究竟会是谁?