ARTICLE · 1088784
前OpenAI大牛封神之作翻车!号称绝对诚实的AI,连抛硬币都算不对
前OpenAI核心研究员带队,号称要掀起自动化革命的“下一代AI决策模型”,刚发布不到一周,就被几道小学概率题扒光了底裤。
一枚质地均匀的硬币抛向空中,正面朝上的概率是多少?
任何一个小学生都会脱口而出:50%
但这款号称输出“绝对诚实概率”的AI大模型,给出的答案却是:正面朝上概率 92%,置信度 84%。
荒谬的还在后面:掷一枚普通的六面骰子,点数朝上的概率是多少?按经典概率论,每个面的概率都是精确的 1/6(约16.7%)。
这款模型经过一番“深思熟虑”,自信满满地在接口里把点数“1”打出了 72% 的超高概率。
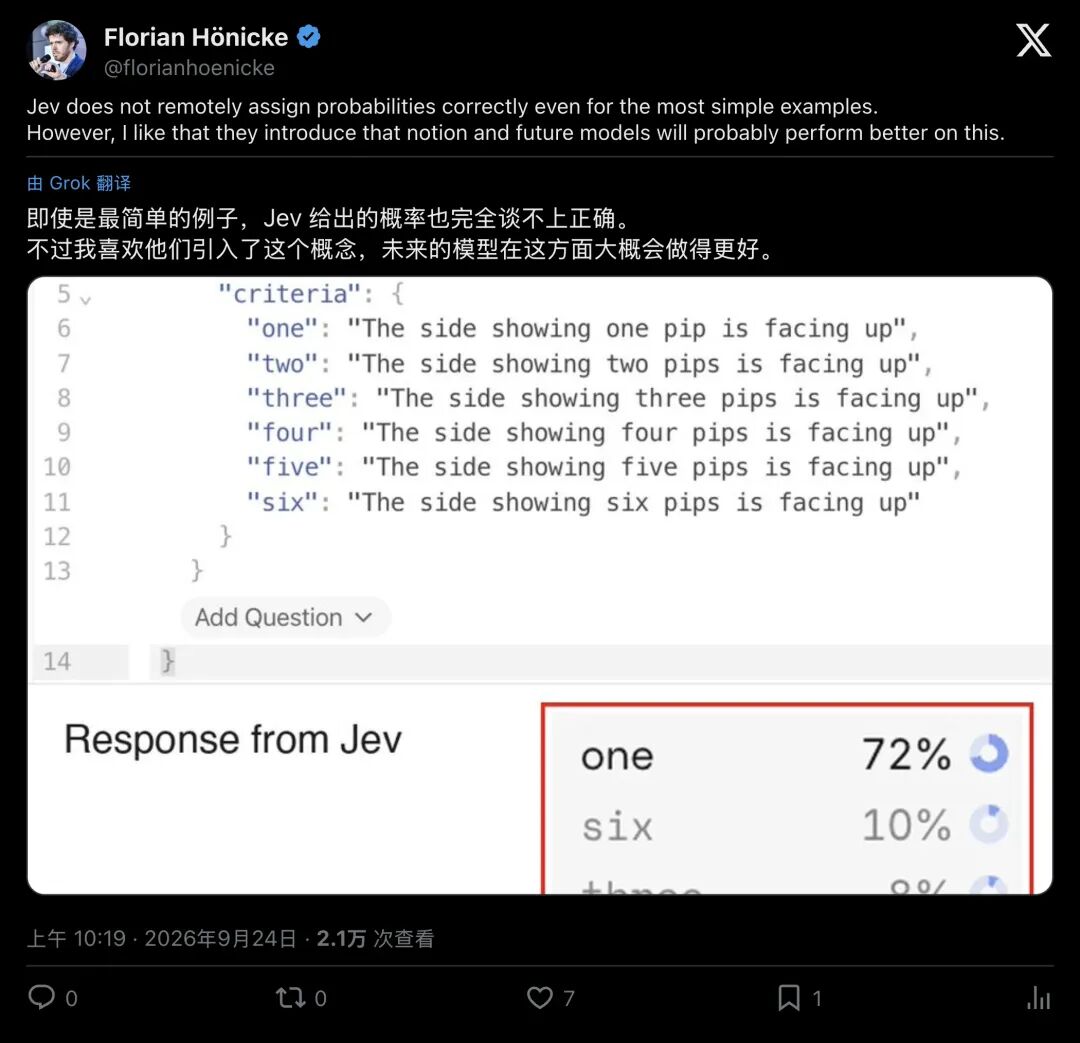
▲ 工程师 Florian Hönicke 的实测:掷六面骰子,理论值约16.7%,Jev给出了72%
这款产品出自正规军之手
它的背后,是硅谷当红初创公司 TypeSafe AI,掌舵人 Diogo Almeida 曾是 OpenAI 的核心研究员,亲手参与过 InstructGPT 和 RLHF(基于人类反馈的强化学习)的奠基工作。
他们推出的这款模型叫 Jev发布之初,它被冠以“System One(快思考)革命者”的盛名,声称要彻底解决大语言模型“爱胡说八道、概率不可信”的顽疾。
结果,全球极客们端着一杯咖啡,在键盘上敲了几道最朴素的抛硬币、掷骰子测试题,就把神坛上的新星轰成了筛子。
这究竟是一场夸大其词的技术公关翻车,还是整个深度学习领域至今无法挣脱的宿命诅咒?
01.杀手级模型诞生:不扯废话,只给“诚实的概率”
要理解这场翻车为什么震动了整个AI圈,必须先看看 Jev 发布时画下的饼有多诱人。
今天的软件工程师在使用大语言模型(LLM)时,最头疼两件事:太慢太贵,以及满嘴跑火车。
你让 GPT 帮你判断一封客服邮件该不该退款,它会洋洋洒洒给你写一段几百字的小作文,最后还不一定按照你规定的格式返回。为了让代码能自动处理,程序员不得不写一大堆正则和重试逻辑去“抓”结果。
同时,大模型给出的“置信度”往往形同虚设。它嘴上说着“我有99%的把握”,转头就给出一个荒谬绝伦的假答案。
TypeSafe 带着 Jev 杀出来时,姿态极其干脆:彻底干掉自然语言聊天,只做纯粹的结构化决策。
▲ TypeSafe 官方宣布推出 System One 模型 Jev
Jev 借用了诺贝尔奖得主丹尼尔·卡尼曼在《思考,快与慢》中的“系统一(快思考)”概念:
- 输入
:业务状态文本 + 预设问题。 - 输出
:永远符合代码规范的布尔值或枚举选项,绝不多说一个废话字符。 - 极致性价比
:端到端响应只要 70到500毫秒,百万输入 Token 仅需 0.042美元(约合人民币3毛钱),输出甚至完全免费。
除了速度与价格,Jev 主打的杀手锏,在于它宣称掌握了一种名为 RLCD(面向校准决策的强化学习) 的独门绝技。
官方文档言之凿凿:Jev 返回的每一个概率,都是“经过严格校准的诚实概率(Epistemically Honest Probabilities)”。
什么是校准?官方甚至给小白打了个比方:当模型说某件事发生的概率是 20% 时,在大量相同预测中,这件事真实发生的比例就应该无限接近 20%;当它说 80% 时,真实准确率就得是 80%。
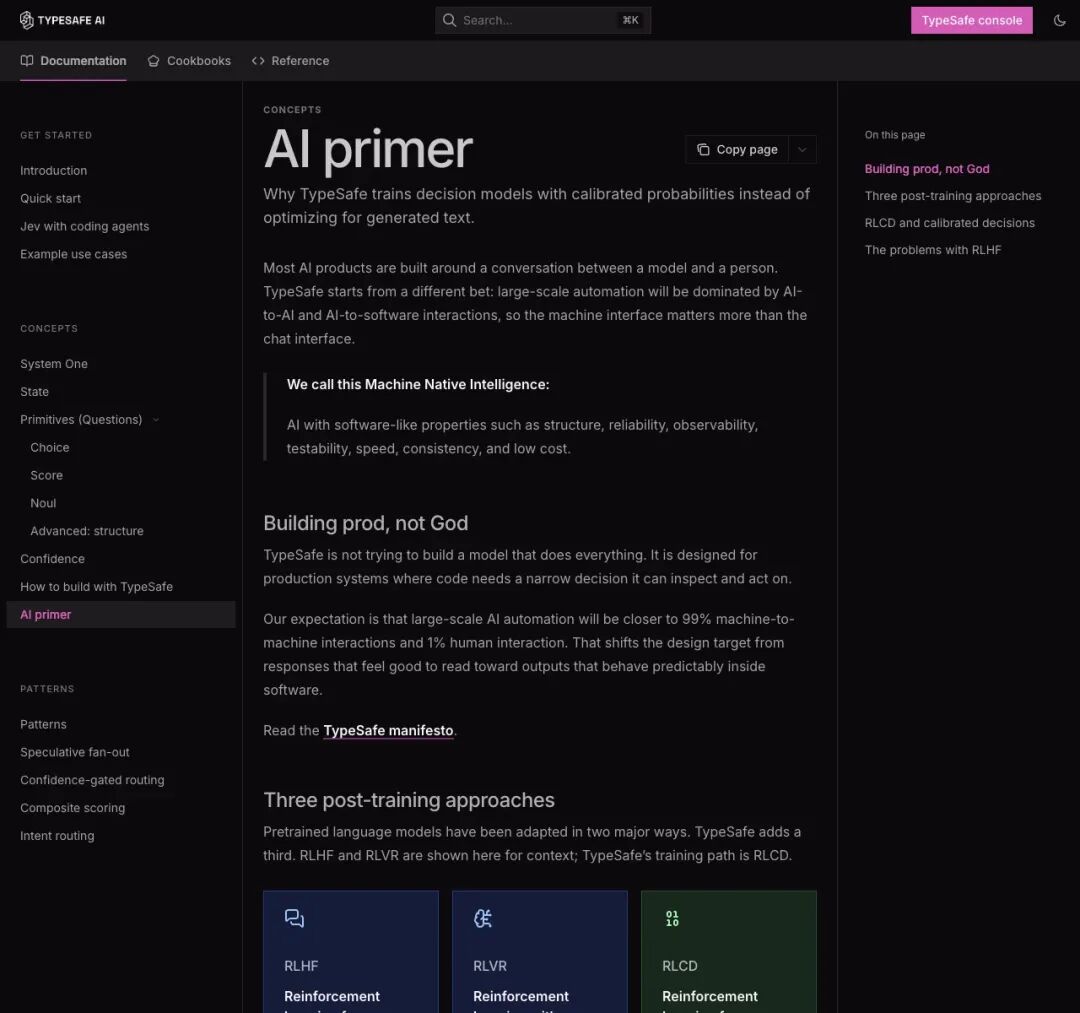
▲ 官方文档明确承诺:0.2对应20%发生率,概率具备统计学诚实性
对工程师来说,这个承诺简直是天降福音。
因为只要概率是诚实的,自动化流水线就能建立起固若金汤的分流阈值:
置信度 ≥90%:系统自动放款、自动发货、自动拦截; 置信度 <90%:安全拦截,推给人工审核。
整个硅谷都在期待一个自动化新时代的到来。
直到大家在测试框里,扔进了一枚普通的硬币。
02.极客围攻:连掷400次骰子,它永远选“1”
最先察觉不对劲的,是推特上的开发者们。
发布后不久,开发者 Sanyam Satia 在官方 Playground 里写下状态:“掷一枚公平的六面骰子”,询问结果是几点。Jev 毫不犹豫地把点数“1”标上了 81% 的概率,置信度高达 77%。
紧接着,推特用户 @shreyshahi 测了抛硬币:正面 0.92,反面 0.08。他直接截图艾特官方质问:“这难道不该是五五开吗?”
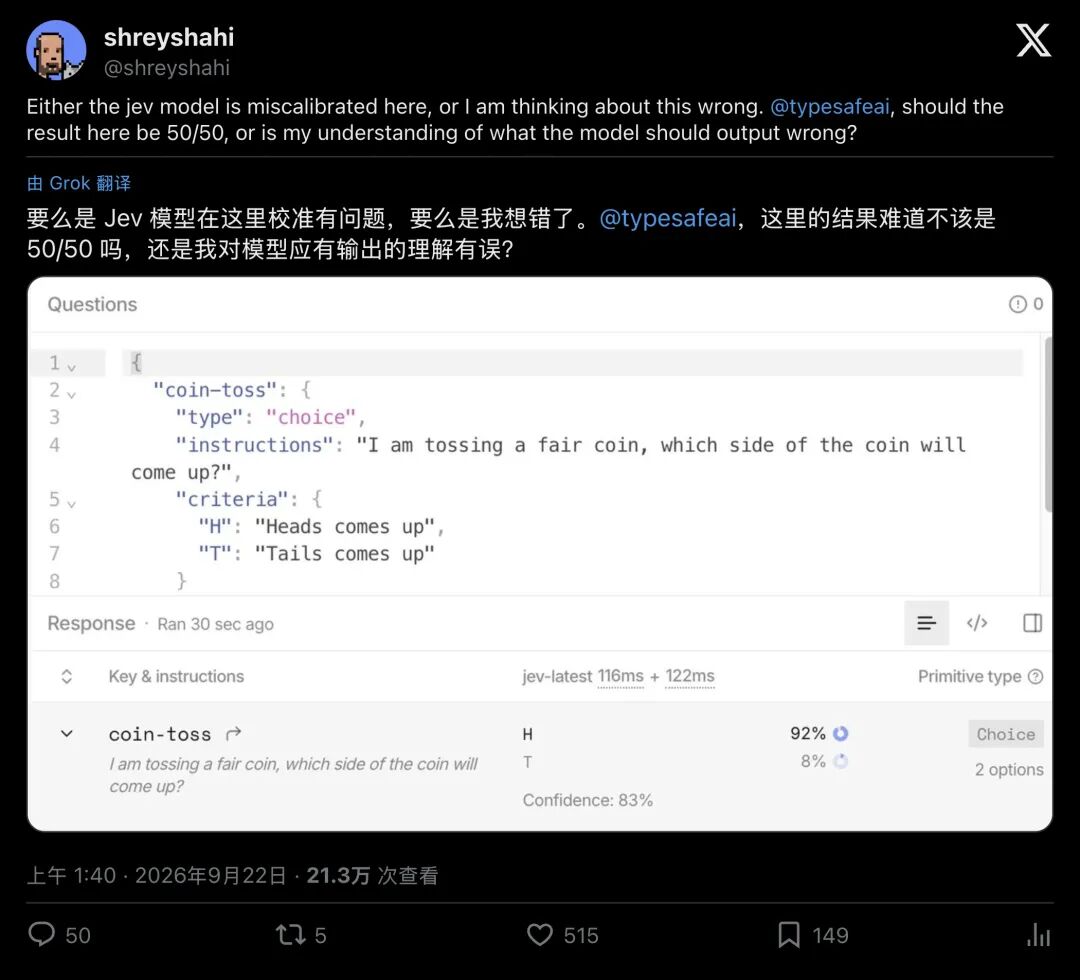
▲ 开发者实测公平硬币,正面概率被标为 0.92
面对漫天质疑,前OpenAI科学家、CEO Diogo Almeida 只能尴尬地在推特底下回复:“会修的。我们之前更侧重语义判断,数学确实没怎么优化。”
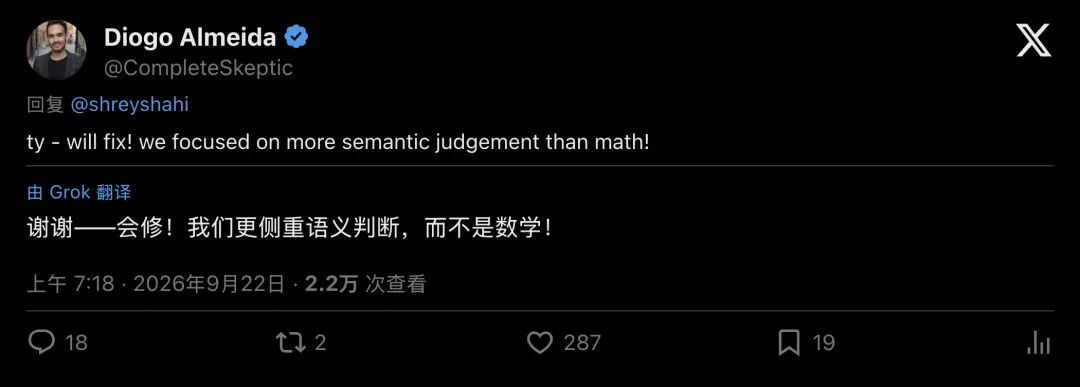
▲ TypeSafe CEO 承认此前偏重语义判断,算术能力欠佳
然而,事情很快从“翻车调侃”演变成了严谨的“学术处刑”。
日本研究者 Kanta Hayashi 写了一篇火药味十足的独立测评报告,标题直接致敬爱因斯坦,《Jev 不掷骰子》(Jev Does Not Play Dice)。
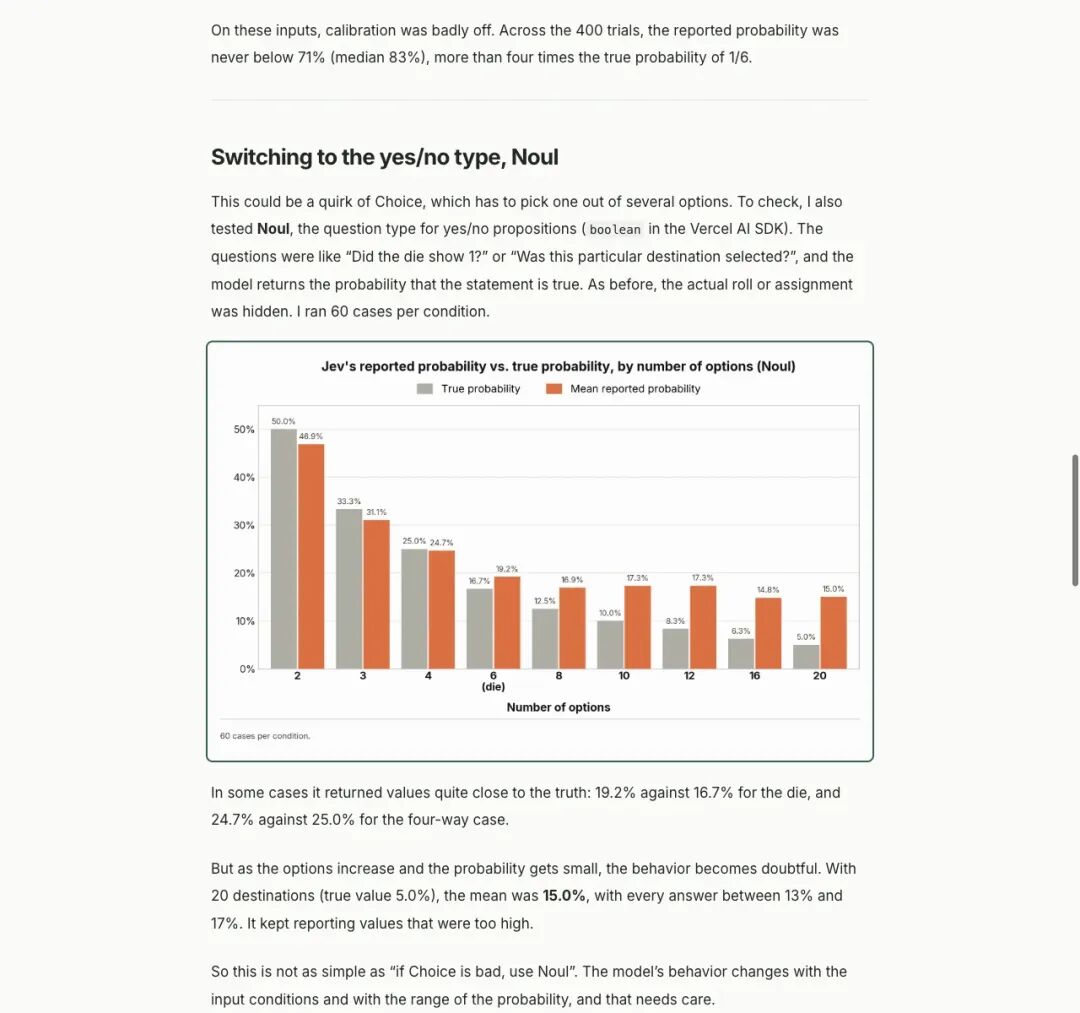
▲ 独立研究揭露:面对看不见的骰子,模型每次都盲猜“1”,置信度高达83%
Hayashi 做了一个极其残酷的实验:让 Jev 连续预测 400 次被遮挡的骰子点数。
结果让人啼笑皆非:Jev 每次都坚定不移地选“1”,平均给出 83% 的超高置信度,而实际命中率只有惨淡的 19%(几乎正好等于随机瞎猜的 1/6)。
硬币、四色转盘、二十面骰子……所有的随机测试全部崩溃。准确率牢牢钉死在随机概率上,模型却像打了鸡血一样,向调用者报告着 70% 到 90% 的“虚假自信”。
这种偏差一旦进入真实业务场景,破坏力极强。
Hayashi 构造了一个采购场景:合同文本里明明写着“某零件短缺风险为 30%”。当开发者用 Jev 读取并做选择时,模型竟然把这个 30% 的风险强行压成了 5%。
如果下游系统写着一条安全规则:“风险超过 10% 立即告警”,那么这行看似智能的代码,就会在悄无声息中,将一家企业推入断供的深渊。
03.深度解剖:为什么AI天生就是个“自大狂”?
为什么一个由顶尖科学家操刀、专门为了“校准概率”而生的模型,会在最基础的概率面前摔得鼻青脸肿?
要搞清真相,我们需要厘清三个常被混淆的概念:
- 准确率(Accuracy)
:你考了多少道对题。事后可数,黑白分明。 - 置信度(Confidence)
:你交卷时,觉得自己能考多少分。 - 校准(Calibration)
:当你评估自己有90%把握做对100道题,最终实际答对的数量恰好稳定在90道。
早在 2017 年,机器学习领域的经典论文《现代神经网络的校准问题》(On Calibration of Modern Neural Networks)就揭示了一个残酷的规律:神经网络变得越深、越强大,它就会变得越来越过度自信。
它就像一个智商极高但极度自负的学生,明明只有六成把握,嘴上永远喊着“我有一百分信心”。
在 Jev 身上,这种病态的自信被两重机制无限放大了:
1. 语言模型的天然偏见:本福特定律与语料幽灵
AI 专家 Ryan Porter 在推特上指出:Jev 归根结底是一个语言模型,缺乏类似 Mathematica 的符号数学计算引擎。
在人类数万亿字的互联网语料库中,数字“1”的出现频率远远压倒其他数字(数学上的本福特定律);当人类讨论抛硬币时,“Heads(正面)”被提及的频率也显著高于反面。
在缺少物理世界因果建模的情况下,AI 把人类文本中的“词频习惯”,误当成了客观世界的“物理概率”。
2. 致命的统计学真相:根本不存在“放之四海皆准”的概率
独立开发者 Alex Molas 随后发表了一篇引发 Hacker News 全网热议的重磅长文,标题一针见血,《Jev 在定义上就不可能被校准》(Jev can't be calibrated)。
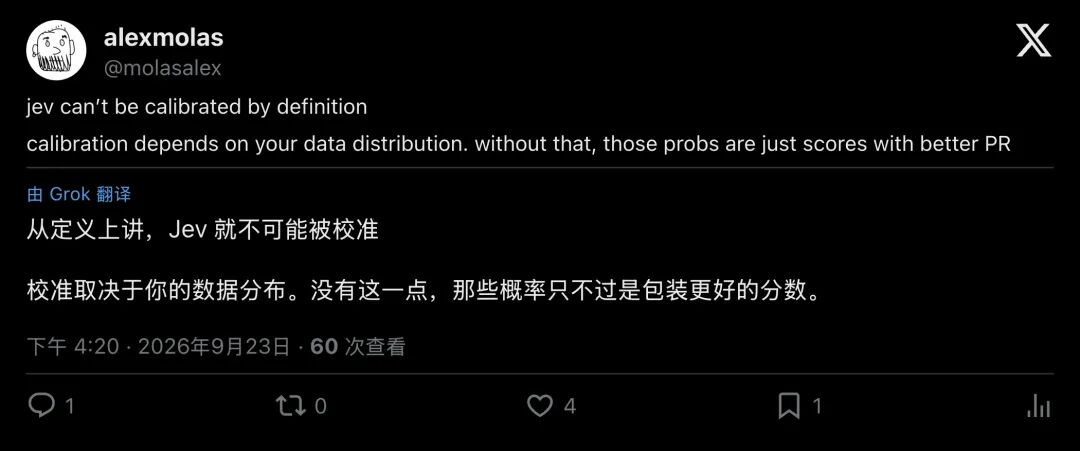
▲ Alex Molas 直言:没有用户的数据分布,所谓概率只是包装得更好的打分
Molas 指出了核心的统计学常识:校准由“模型本身”与“具体数据分布”共同决定,属于两者的联合产物。
举个简单的例子:一个预测肿瘤恶性的模型,在三甲医院肿瘤科的数据上可能校准得非常完美;但把同一套数字搬到普通体检中心,它的置信度就会瞬间失效。
没有一家 AI 公司,能在完全不知道你家数据库长什么样的情况下,打包票说自己的输出开箱即校准。
正如 Molas 毒辣的点评:“脱离了你的具体业务分布,API 返回的那些所谓概率,不过是换了一层高级公关包装的分数(Scores with better PR)罢了。”
04.撕开文字游戏:“类型安全”不等于“不讲假话”
面对这场风波,社区里出现了一种充满讽刺意味的声音。
有些人在推特上阴阳怪气地调侃:“这不可能发生,官方明明说了 Jev 绝对不会产生幻觉(Cannot Hallucinate)!”
▲ 社区反讽官方宣传与实际表现的断层
这里其实隐藏着一个精妙的文字游戏。
TypeSafe 宣称的“绝无幻觉”,在计算机科学上叫 类型安全(Type Safety)。
传统的 ChatGPT 可能会在返回 JSON 时少打一个括号,或者在要求填“是/否”时突然填了一个“也许”。而 Jev 通过底层语法树(Schema)强行约束,保证输出永远不会越界,永远是合法的枚举类型。
程序没有崩溃,字段永远合规从代码编译的角度看,它确实“没有幻觉”。
但在现实逻辑的角度看,它给了一个合法的枚举值,附带了一个彻头彻尾荒谬的概率。
一个合法返回了 heads: 0.92 的 JSON,在系统架构师眼里,比直接报错崩溃还要危险一万倍。因为报错会触发告警,而一个包装着合法外衣的错误概率,会直接骗过下游的所有自动化防御,静悄悄地下达错误的指令。
其实,翻开 TypeSafe 官方文档最隐秘的角落,jev-1.13 的缺陷说明页(Model Jaggedness),官方早已白纸黑字写下了警告:
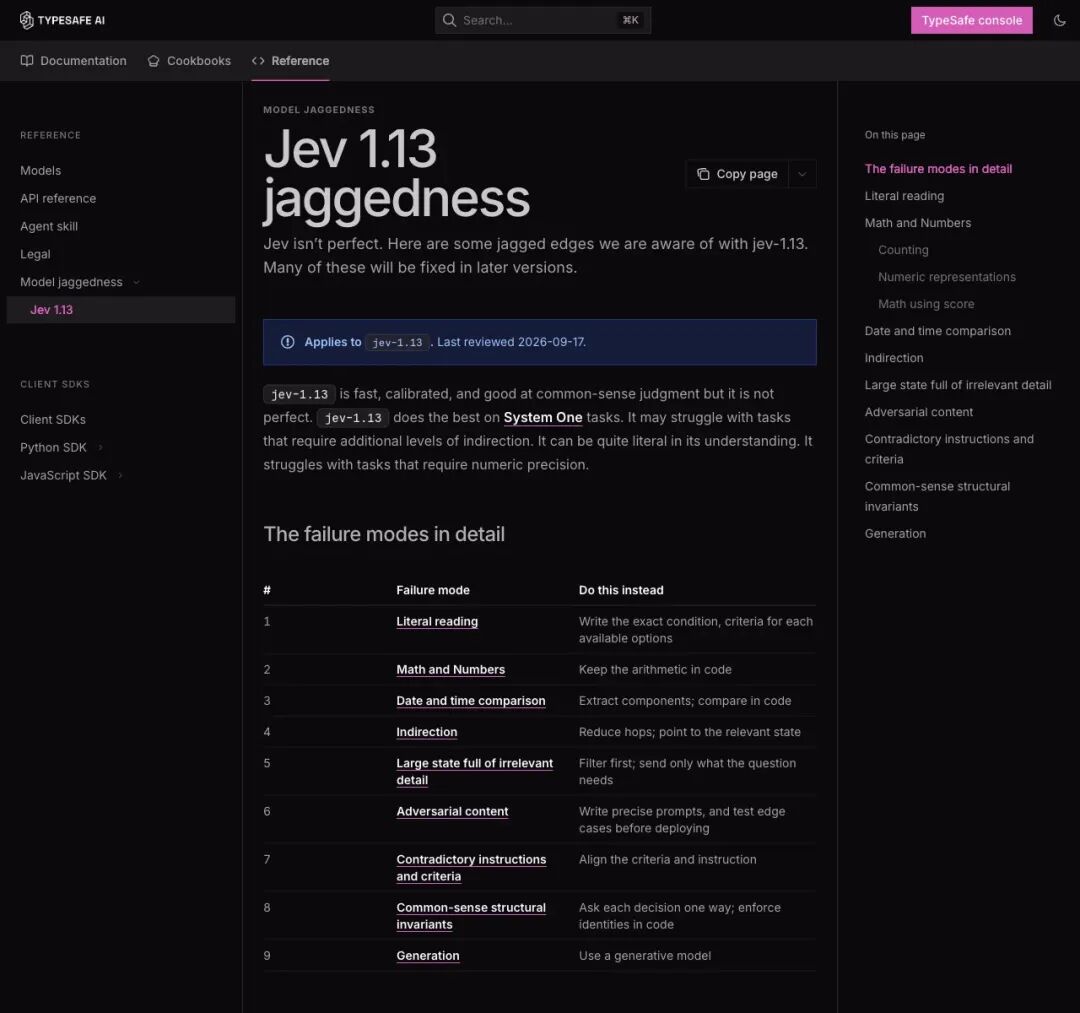
▲ 官方文档深处早已注明:数学和数字是已知缺陷,算术逻辑必须写在代码里
文档明确承认:“不要用模型做算术;计数是不可靠的;数值表示能力弱于语义表示……请把算术逻辑留在你的代码里。”
一边是营销博客里大肆宣扬的“诚实概率”,另一边是技术文档里悄悄标注的“数学不行”。
这种宣传口径与技术现实的巨大撕裂,终于在几道硬币和骰子题的聚光灯下,演变成了一场全民围观的公开处刑。
05.尘埃落定:我们该如何与“不完美”的AI共处?
狂欢与嘲讽过后,全球工程界并没有把 Jev 一棍子打死。
相反,多份高质量的独立开源评测(如 AnthusAI 的深度基准测试)给出了非常客观的结论:
- 它依然是个极度优秀的语义分类器
:在长文本情感分析、客服工单分拣、意图识别等“非算术”任务上,Jev 的置信度虽然数值偏高,但具备极强的排序能力(AUROC 显著优于传统大模型)。也就是说,它打 90 分的题,确实比它打 70 分的题更有可能做对。 - 本地再校准(Post-Calibration)极为便宜
:工程师们发现,只要用自己业务场景下的几百条真实数据,套用经典的 保序回归(Isotonic Regression) 或 Platt 缩放 对 Jev 的输出做一层简单的数学映射,就能瞬间将校准误差压降到接近于零。
这场闹剧给整个 AI 工业界上了一堂极其清醒的公开课:
第一,永远不要让大语言模型做纯逻辑算术。 规则的归规则,算法的归算法抽取出结构化文本由解析器做,古典概率的计算交给一行 Python 代码,模型只负责理解混沌模糊的人类语义。
第二,天下没有免费的“开箱即用” 任何声称不需要你的业务数据、就能在所有场景下给出诚实概率的模型,都是现代炼金术。
第三,把 AI 当成有瑕疵的工程工具,无需神化。
当硅谷的夸张神话被一枚 50/50 的硬币戳破时,工程理性对盲目狂热完成了一次绝妙修正。
AI 或许永远学不会如何公正地抛掷一枚硬币。
但在硬币落地的这一刻,盲目迷信大模型的时代,终于该醒醒了。