ARTICLE · 1088792
一毛钱买100万Token!OpenAI甩出GPT-6平民核弹:性能暴涨74分
谁能想到,在顶尖大模型为了争夺“世界第一”打得头破血流的今天,一场决定未来软件工业格局的暗战,居然在第24名的泥潭里爆发了。
免去了发布会的繁杂声势与算力包装,OpenAI 悄悄把一枚“平民核弹”砸进了全球最严苛的代码盲测竞技场。
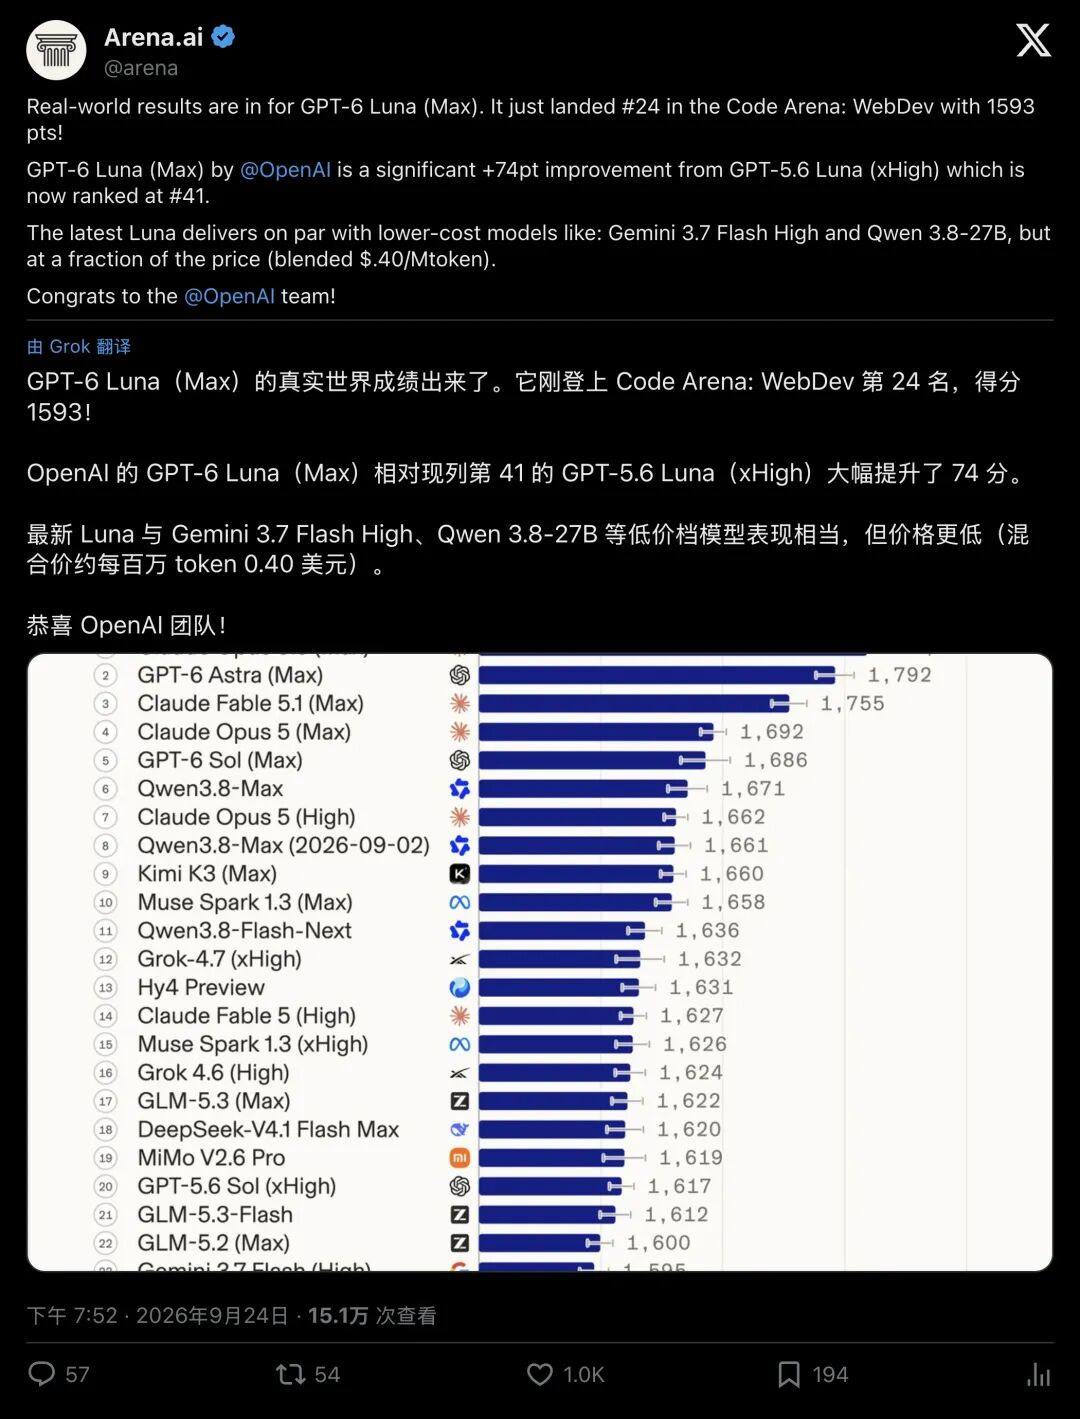
▲ Arena 官方公布 GPT-6 Luna 成绩:1593 分,位列第 24,代际提升 74 分
根据权威评测机构 Arena.ai 公布的最新战报,OpenAI 旗下的低价轻量模型 GPT-6 Luna(Max) 在 Code Arena: WebDev(前端代码竞技场)拿下 1593 分,冲上全球第 24 名。
随成绩一同公开的还有它的价格标签:每 100 万输入 Token 只要 0.10 美元(约合人民币 7 毛钱),输出只要 0.50 美元。
用买一块口香糖的钱,就能调用让一个顶级 AI 替你写整整几百个完整网页的代码量。一时间,全球开发者社区掀起热议,当最廉价的“工兵模型”突然拥有了独当一面的战斗力,AI 编程的底层逻辑彻底变了。
01杀进“死亡之组”:74分的代际鸿沟
要看懂这个第 24 名的分量,首先得搞清楚什么是 Code Arena: WebDev。
区别于刷固定选择题的静态评测,这里是一场极其残酷的真人盲测角斗场。真实用户提出各种刁钻的前端开发需求,两个匿名模型在后台同时写代码、调用工具、完成实时网页渲染。评测者站在并排的动态页面前,看谁的界面更漂亮、交互更流畅、功能更健全,然后匿名投出胜负票。
在这里,每一分都是真实人类用鼠标和键盘堆出来的。
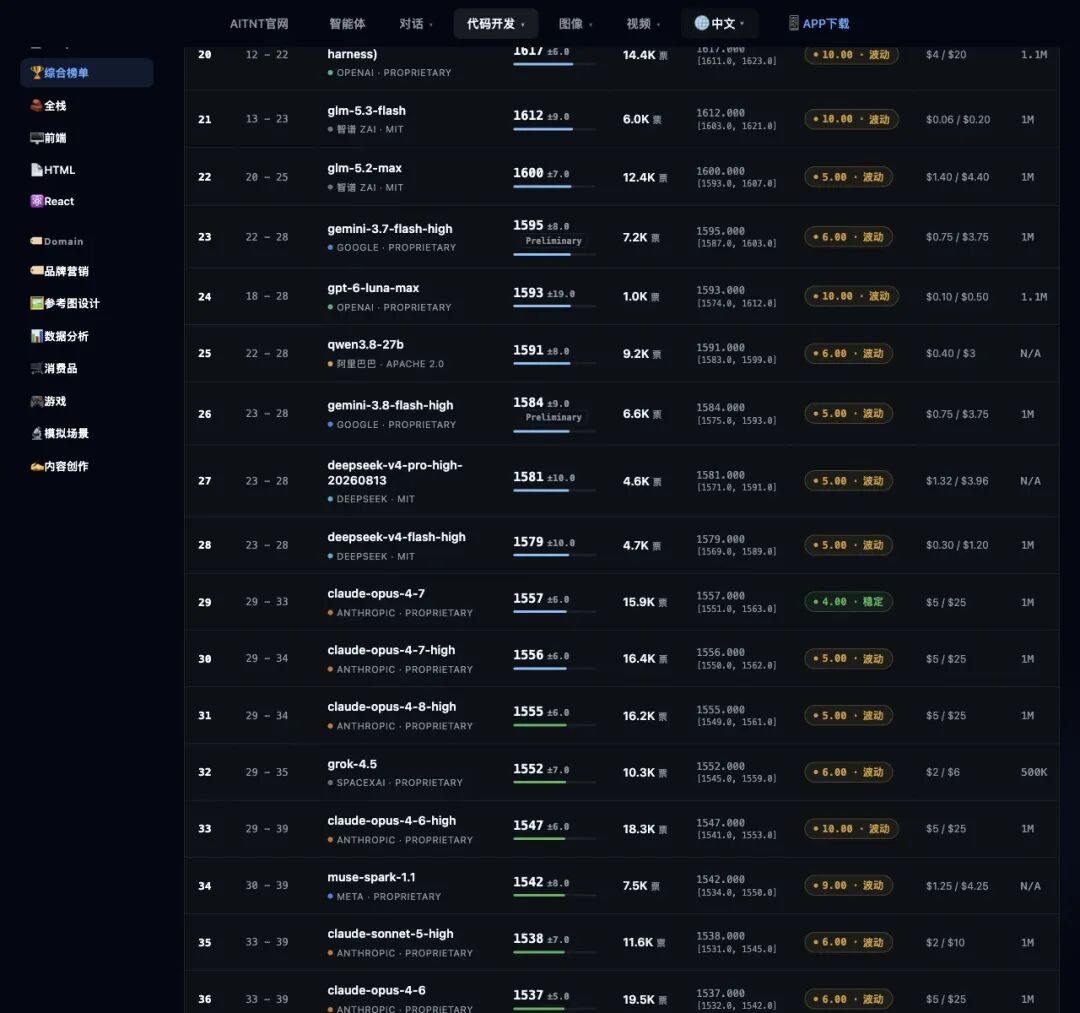
▲ WebDev 榜单现场:第 24 行 GPT-6 Luna 与 Gemini Flash、Qwen 27B 紧紧贴在一起
在最新公布的榜单上,GPT-6 Luna(Max)的分数定格在 1593 分。
它的左邻右舍是谁?第 23 名是谷歌的 Gemini 3.7 Flash High(1595 分),第 25 名是开源猛兽 Qwen 3.8-27B(1591 分)。
三者之间的分差甚至不到 2 分,几乎是以肉搏的姿态挤在同一个身位。
但如果你回看上一代,就会发现这场迭代有多震撼:上一代的 GPT-5.6 Luna(xHigh)仅仅排在第 41 名左右,分数在 1520 分档。
整整暴涨了 74 分
在 Elo 积分体系里,74 分的分差直接映射出成百上千次正面单挑的结果:新一代对上一代确立了压倒性的胜率阶梯。
02“连27B都打不过?” 社区嘲讽背后的算力真相
成绩一出,评论区立刻出现了两种截然相反的声音。
有挑剔的网友在推特上冷嘲热讽:“Barely better than a 27B model, wow.”(居然只比一个 27B 的小模型好一点点,真行啊。)
但这条评论瞬间遭到了技术老兵的无情反驳:“qwen 3.8 27b is not easy to beat.”(千问 27B 并不好对付。)
▲ 社区针对 Qwen 27B 与 Luna 性能的精彩反驳
这句反驳,恰恰道破了今天大模型战场的残酷现实:开源和 Flash 档位的战斗力早已今非昔比。
把一个闭源超低价 API,放进由 Qwen 3.8-27B、Gemini 3.7 Flash 以及 DeepSeek Flash 盘踞的“刺客联盟”里,竞争焦点早已跳出单纯的智商上限,转向单位成本下的极限生产力。
用一位开发者的毒辣点评来说:“嘲讽 Luna 只能打平 27B 的人,根本没有看它背后的账单。这是用几乎可以忽略不计的成本,买到了能进生产环境的代码能力。”
03价格腰斩再腰斩:OpenAI 的“放血式”定价
如果说分数是战术胜利,那么定价就是战略屠杀。
在 OpenAI 官方公布的定价体系里,一张降价表让所有 FinOps(云成本管理)工程师印象深刻。
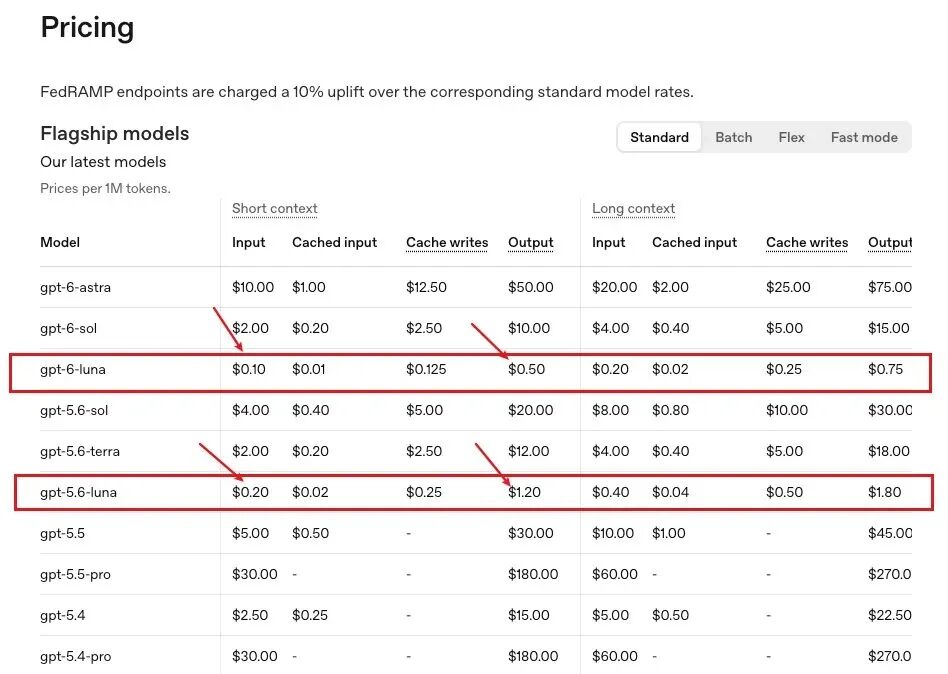
▲ 官方定价表:GPT-6 Sol 与 Luna 价格直接腰斩
我们把价格拉开来看一个震撼的代际对比:
- GPT-5.6 Luna
:输入 $0.20 / 输出 $1.20(每百万 Token) - GPT-6 Luna
:输入 $0.10 / 输出 $0.50(每百万 Token)
输入直接砍半,输出暴跌 58%
再看 GPT-6 全家桶的阶梯落差:顶格旗舰 Astra 的标准输入是 $10,中档主力 Sol 是 $2,而 Luna 只要 $0.10。
Sol 的价格只有 Astra 的五分之一,Luna 的价格只有 Sol 的二十分之一。 算下来,调用一次 Astra 的开销,足以让 Luna 在后台完成上百次调用。
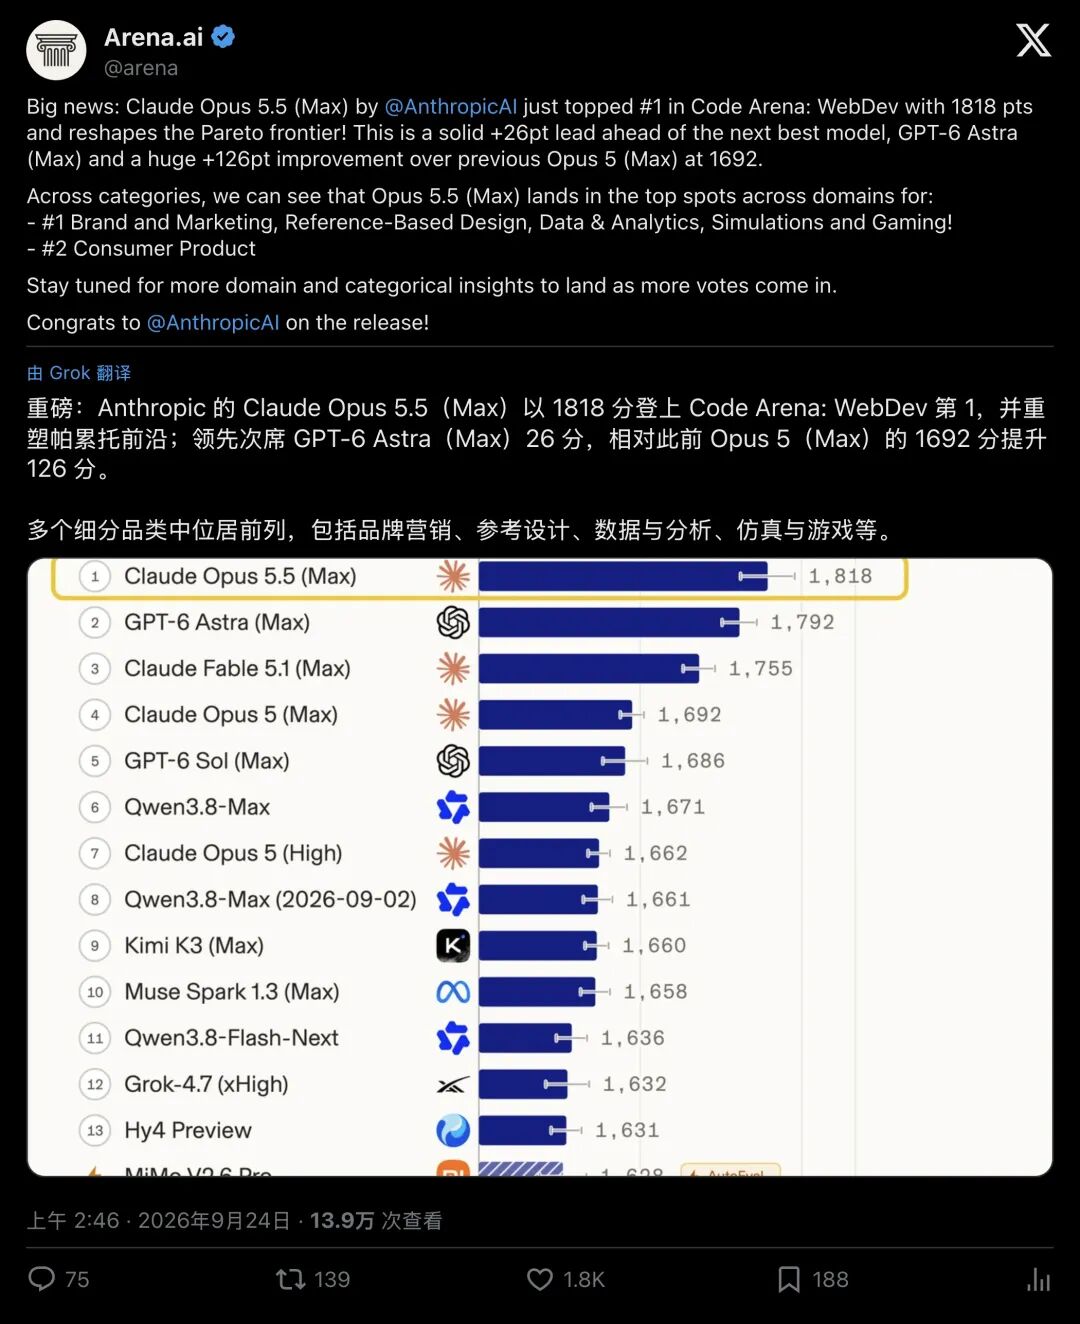
▲ 同期 Claude Opus 5.5 以 1818 分改写最高性能帕累托前沿
就在同一周,Anthropic 刚刚凭借 Claude Opus 5.5(Max)的 1818 分 夺回了天花板王座;OpenAI 的 GPT-6 Sol(Max) 也以 1689 分冲上全球第 4。
顶层在神仙打架,改写最高性能边界;底层在放血降价,改写性价比极限整个大模型世界的“帕累托前沿”,正在被两头疯狂拉扯。
04懂行的开发者,已经把它当成了“电子打工人”
普通视角看榜单看名次,系统架构师则聚焦于分工协同。
在这场讨论中,资深开发者 @meseven_journey 分享的一套实战工作流,揭示了低价模型的典型用法:主脑负责规划验收,平民模型充当下属子 Agent。
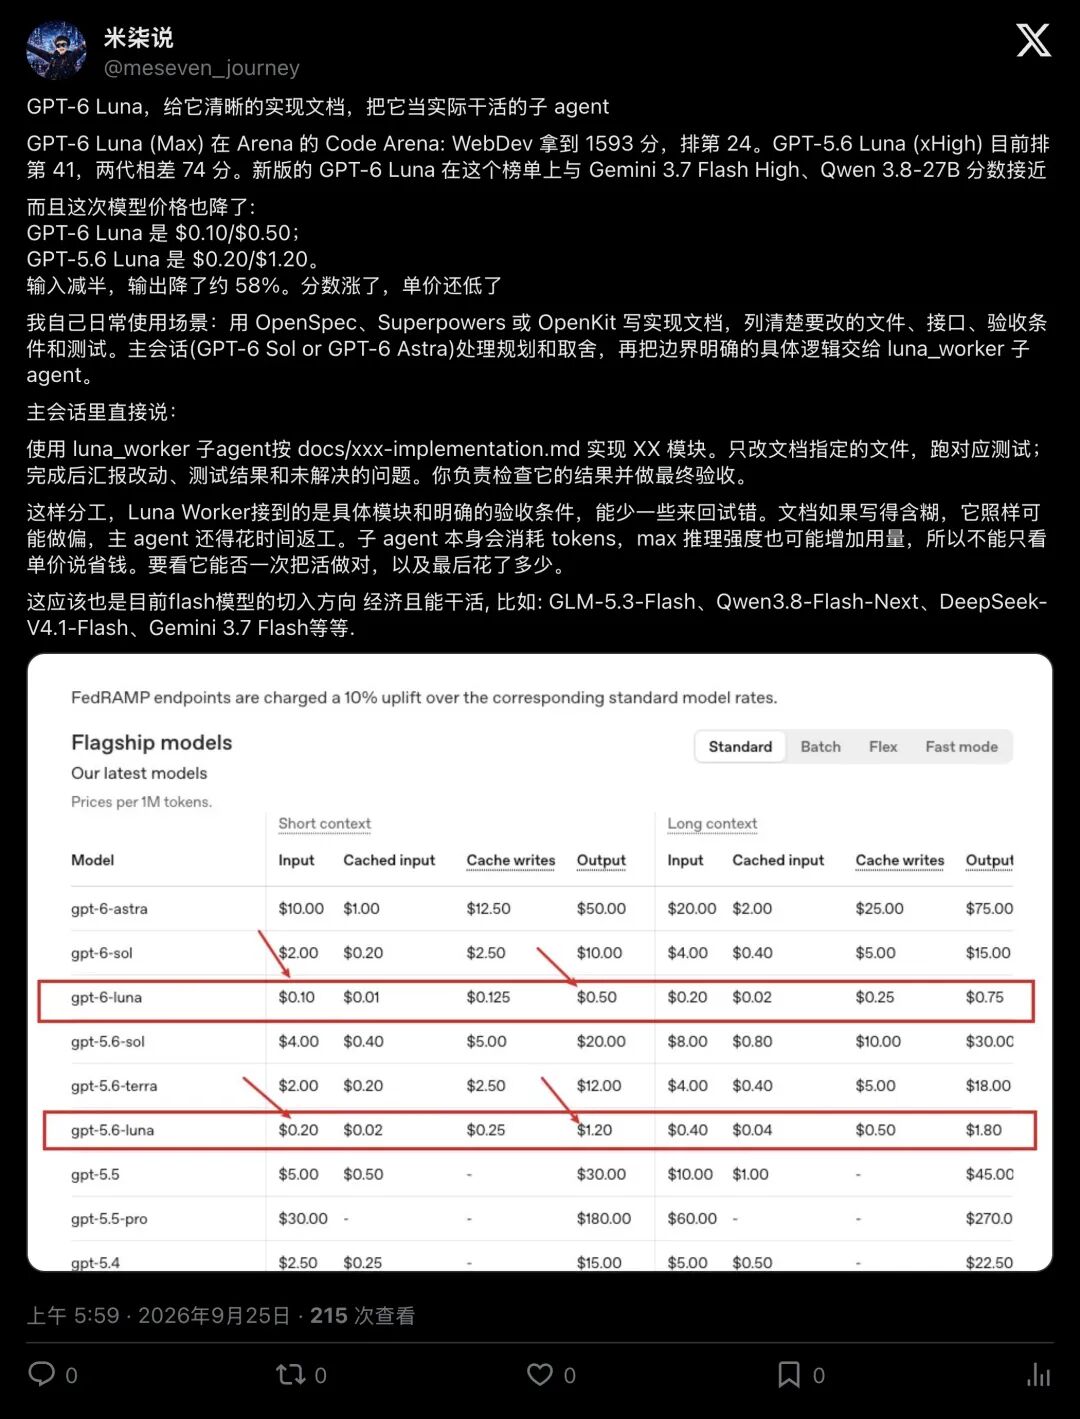
▲ 中文技术博主分享基于 Luna 的高效“子 Agent”架构
在这套体系里,不再需要让昂贵无比的 Astra 或 Opus 5.5 去一行行敲具体的业务逻辑。
成熟的工程架构往往这样分工:
- 总架构师(GPT-6 Sol 或 Astra)
:负责顶层需求拆解,使用 OpenSpec 或 Superpowers 编写极度详尽的实现文档,明确指定要改动的文件、API 接口、验收条件和单元测试标准。 - 流水线打工人(luna_worker 子 Agent)
:直接接收这份指令,严格在限定文件内干活、跑测试、修复 bug,最后汇报改动。 - 最终验收
:主 Agent 检查测试结果,做最终代码合入。
“主会话直接发号施令:使用
luna_worker按文档实现 XX 模块,只改指定文件,跑对应测试。这样分工,Luna 接到的是明确任务,能极大地减少来回试错。”
这就是 AI 时代的现代数字流水线 绝不会有人雇佣年薪百万的首席科学家去天天写 CSS 居中和增删改查;同样,更不该用每百万 Token 几十美金的旗舰模型去干脏活累活。
一毛钱的 Luna,就是那个永远不知疲倦、按章办事、成本低到几乎可以忽略的超级流水线学徒。
05便宜背后的“暗礁”:你真的能省下钱吗?
然而,天下从来没有免费的午餐越是看似白菜价的模型,越考验使用者的工程素养。
根据多家技术机构对 GPT-6 定价策略的深度拆解,低价模型的背后藏着几座隐形的“收费暗礁”:
- Max 推理强度的吞吐陷阱
:虽然 Luna 单价极低,但如果开启了高强度的思维链(Max 推理模式),模型在后台“内心独白”所消耗的 Token 数量会成倍飙升。 - 272K 的阶梯跳价
:在超长上下文调用中,一旦单次请求跨过约 272K 输入的门槛,整单计费模式就会跳入更高梯队。 - 提示词缓存(Prompt Caching)的胜负手
:Luna 的省钱核心在于高达 90% 的缓存读取降价。如果工程架构没有做好缓存优化,历史对话和重复的系统提示词将迅速吃光预算。
简而言之:文档写得烂,低价模型照样会跑偏;子 Agent 疯狂陷入死循环重试,账单一样会爆炸。
06时代变了:智能正在变成自来水
回望近一年的大模型发展史,WebDev 榜单的顶峰分数从一年前的 1400 多分狂飙到如今 Opus 5.5 的 1818 分。
更引人瞩目的变化在于,整个行业的底线正在被飞速抬高。
曾经需要消耗数百美元、顶级模型才能勉强写出的交互式网页应用,今天被一个输入只要一毛钱的“轻量模型”轻松拿下。
AI 走下了神坛,正在迅速变成像自来水和电网一样触手可及的基础设施。
当智力的边际成本无限逼近于零,决定一家公司或一个开发者上限的要素变了:比拼的重点转向能否设计出精密的协同流水线,调度大量极低成本的子智能体去解决现实问题。