ARTICLE · 1089644
Jev:在软件内部嵌入AI决策
1. 它是什么?
Jev 面向软件中的一类特定场景:应用已经拿到信息,但需要一次判断才能继续执行。它需要选择分类、评估相关性,或是把内容映射到指定量表上。
TypeSafe AI 的模型接收这些信息与一组带类型约束的问题,返回可直接被代码使用的结果。开发者预先定义所有可选决策,模型评估当前场景,再由应用决定后续执行动作。这就是 Jev 的核心思想。TypeSafe 介绍文档
一次请求包含两大组成部分。状态(State)存放待评估素材:文本、记录或结构化对象。问题(Questions)指定模型需要做出的判断。返回结果会保留问题标识,方便程序读取每一项答案。
接口提供三种问题类型:
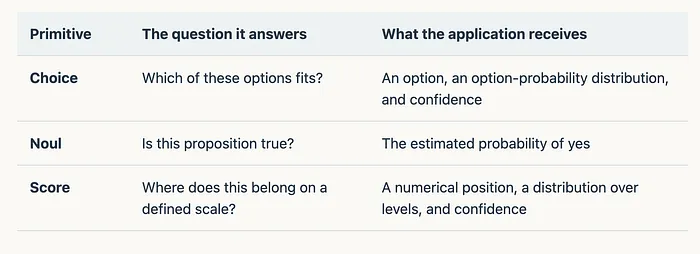
这些基础原语可在同一次请求中组合使用。它们描述不同类型的判断,因此选择合适的类型至关重要。是/否概率和严重程度量表上的分值,即便都用小数表达,代表的也是完全不同的物理量。问题类型文档
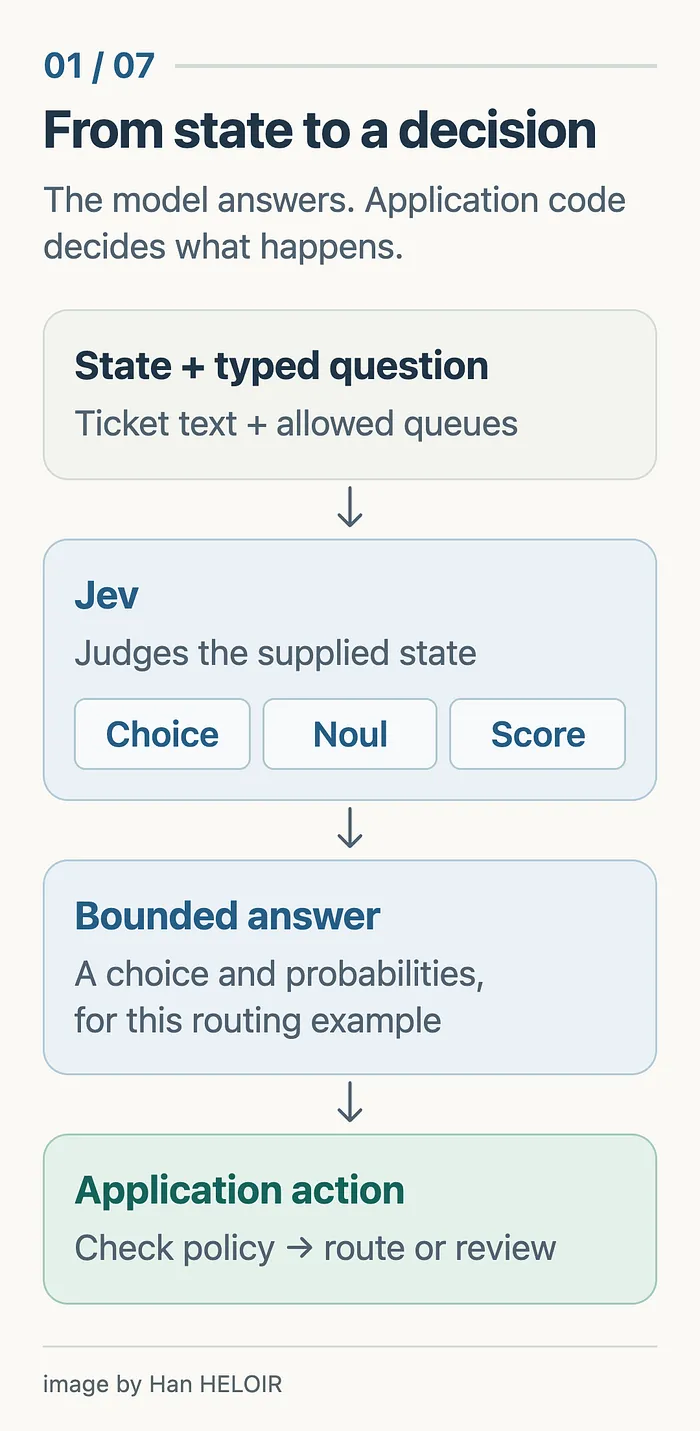
图1. 应用定义决策空间,并负责执行后续动作。
TypeSafe 将其称为系统一号模型(System One model),借鉴“快速直觉判断”的概念。其训练方法命名为校准决策强化学习(Reinforcement Learning for Calibrated Decisions,RLCD)。这些命名体现产品目标:输出具备有效不确定性信息的可用决策,不代表每一条回答都绝对正确。System One
截至2026年9月20日,文档记载模型版本为 jev-1.13.0。输入为文本,也支持 JSON 这类结构化形式传入。它不是开放式文本生成器。如果应用需要生成新的解释文本、文章或代码补丁,需要由其他组件完成。模型参考文档
这一点需要尽早理解。Jev 给开发者提供了在程序内部提出小型判断问题的能力。但程序质量,依然取决于提问内容、输入信息,以及如何使用返回结果。
2. 它好在哪里?
对于需要大量受限判断的应用,Jev 有三大优势:目标明确的接口、并行问题评估,以及延迟与成本大幅降低的可能性。
该接口将答案空间显式定义。Choice(选择)问题会列出全部备选选项。代码可以读取返回的概率分布,基于选中分支执行业务逻辑,无需从一大段解释文本里提取目标部门或分类。
这个优势需要客观对比。通用大模型同样可以输出受 Schema 约束的结果。TypeSafe 自研的对比适配器就支持原生结构化输出。因此有意义的对比对象,是配置完善、能输出同等概率信息的结构化LLM调用。官方LLM适配器
Jev 的第二个优势在于应用的提问方式。当多个独立判断基于同一组状态数据时,可一次性批量评估。只有后续问题确实依赖前面答案时,才需要发起第二次请求。开发者要识别这类依赖关系,而不是把每一次判断都做成串行对话步骤。问题组合文档
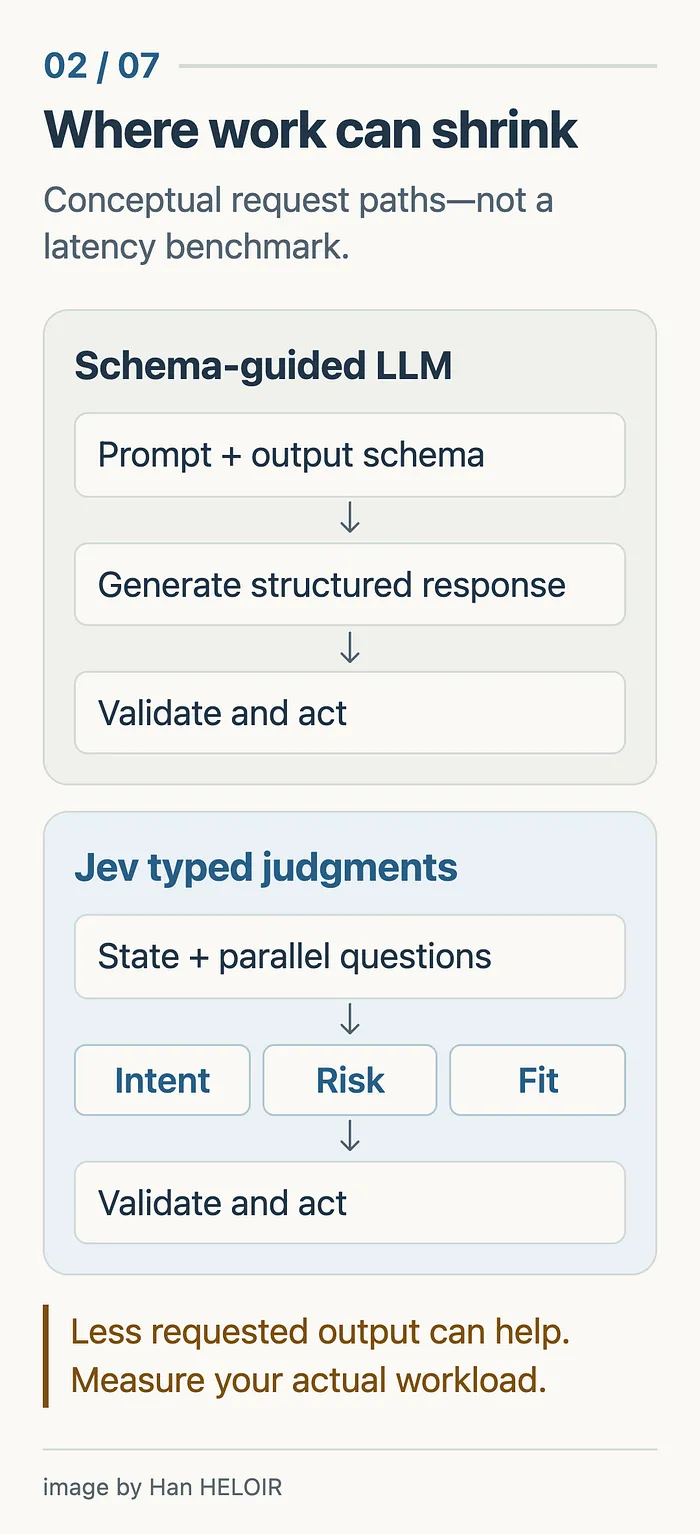
图2. 接口与输出工作量概念对比图,并非Jev私有架构还原。
批量请求也改变了调用成本模型。TypeSafe 的并行问题示例,在单次请求内对同一份文档执行13项判断,并与13次独立请求做对比。该案例展示重复发送共享状态带来的开销。文档标注的延迟对比是串行调用的总和;如果并发执行独立调用,Jev 的时间优势会缩小。核心结论:在评估加速收益前,要先分析自身请求模式。并行问题实验
官方宣传该工作流评估结果速度提升193.6倍,成本降低444.6倍。公司说明,该数值处于真实场景预期收益的上限区间。同时也说明,这些工作流案例来自其能力团队;生成概率的LLM包装器本身会带来额外开销;测量环境基本位于其西海岸服务节点。以上是特定条件下的测试结果。发布成果与说明
评估指标的解读同样需要谨慎。参考基准答案由高思考模式下的 GPT-6 Astra 和 Claude Fable 5.1 结果取平均得到;假设工作流代码本身无错误。模型结果与该基准的一致性具备参考价值,但不能直接等同于业务流程的错误率。评估方法文档
当前输入定价为 每百万token 0.042美元,输出token免费。按该费率,假设单次请求平均输入2000token,一百万次请求的输入费用为84美元。这是基于假设请求大小的算术估算,不是实际部署账单。定价文档
当业务判断调用量巨大,单次调用成本会持续累积时,Jev值得测试。对比评估必须包含同一任务下的准确率、延迟,以及模型拒绝、失败或出错时所需的兜底逻辑开销。只有整套工作流满足业务要求,更低的推理价格才有价值。
3. 它解决什么问题?
很多应用决策的可选答案范围很小,但输入文本千变万化。
可执行动作本身往往很普通:分配工单队列、保留段落、标记条目、设置审核优先级。难点在于理解自然语言,以此匹配正确动作。即便动作列表有限,文本解读也不是简单查表。
这给应用设计带来棘手难题:确定性代码需要明确判断条件,但自然语言输入可以通过转述、隐含信息、上下文缺失、多条诉求混杂等方式表达条件。开发者需要一个判断结果,作为普通程序逻辑的输入。
Jev 就是用来解决这个环节。当应用已经明确需要做哪类判断,Jev 的作用最清晰。开发者传入相关状态,定义备选选项或评分标准,让模型完成评估。如果指令只是笼统的“处理这个案例”,会让大量业务逻辑处于未定义状态。
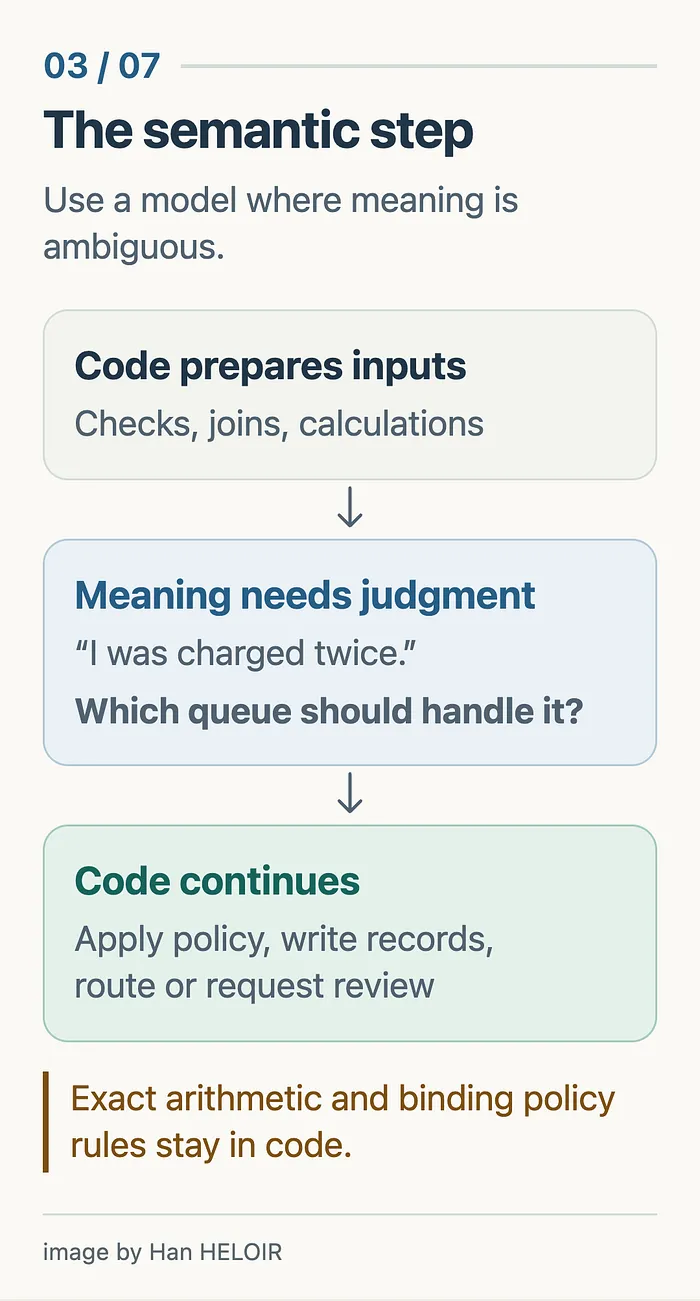
图3. 模型负责工作流内的语义判断,其余职责仍显式由应用承担。
这种职责划分便于维护。业务规则变更时,团队可以修改代码里的规则;分类边界变更时,更新分类定义,重新评估受影响样本。两类修改的验证方式完全不同。
同时故障定位更简单。最终动作出错,原因可能是输入缺失、问题描述不清、模型判断错误或是应用逻辑bug。清晰的职责边界,方便开发者定位问题;仅凭返回结果,无法定位全部故障根源。
部分计算仍应交给确定性代码。TypeSafe文档写明模型短板:算术运算、日期对比、长链式间接推理。文档同时提醒,无关状态信息会降低准确率,对抗性内容会误导输出。这些都是实操层面的注意事项,需要精心准备输入,把确定性运算保留在代码层。Jev 1.13局限性
其核心价值,是给传统应用提供一套可复用的语义判断能力。团队不必把整个工作流全权交给模型,就可以利用它的语言理解能力。
4. 为什么选它?
是否选择Jev,首先看任务形态。
如果已有字段可以直接给出答案,直接使用字段。如果决策可以由确定规则推导,实现规则即可。如果已有训练好的分类器稳定处理该任务,保留它作为基准。如果需要生成文本或深度长推理,则评估合适的生成式模型。
当应用需要受限语义判断、能够提供相关上下文,并且高频、快速执行这类判断可以带来收益时,Jev才值得考虑。在团队还在迭代问题和标签描述阶段,这套通用决策接口尤其好用。但它能否优于现有方案,需要实测验证。
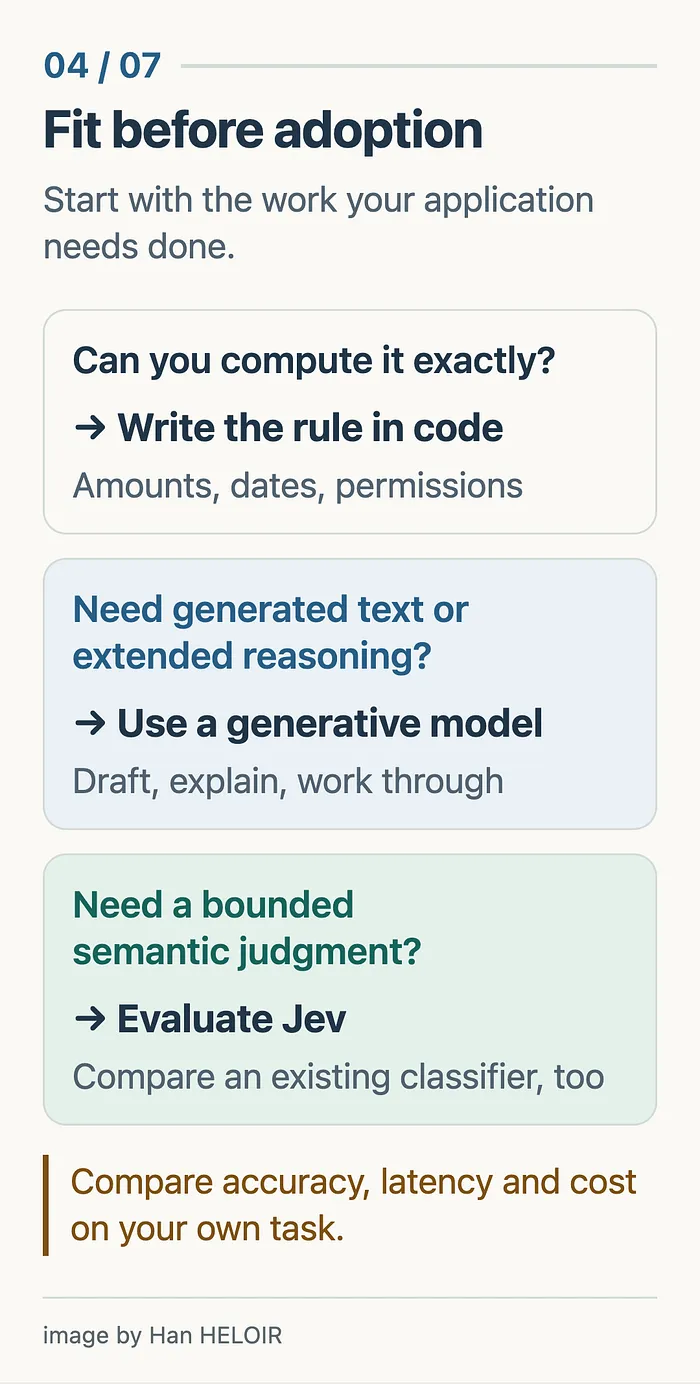
图4. 通过任务适配范围缩小候选方案,评估结果决定Jev是否适合接入应用。
置信度信息有助于评估,前提是理解它的含义。Choice与Score返回的confidence字段,是对返回概率分布特征的汇总值;它由分布计算得出,不是独立的“答案正确概率观测值”。查阅的文档没有披露其精确计算公式。不能把confidence = 0.9理解为“90%概率答案正确”,这超出文档承诺的能力范围。置信度语义
校准(Calibration):预测概率是否在全量样本上匹配真实正确率。筛选(Selection):分数能否区分可自动通过的决策和需要人工复核的决策。一个分数可以很好完成筛选,但数值本身不一定是校准后的真实概率。二者是不同的评估维度。校准相关论文,选择性分类论文
早期测试结论有适用范围,不能一概而论。JourdanLabs 在 Banking77 数据集上测得预期校准误差0.0936,CLINC150数据集为0.0204,采用十箱分桶方式对选中选项概率进行测量。该指标衡量预测概率和真实正确率之间的整体偏差。不同结果来自不同意图分类数据集,不能定位单一根因,也不能代表所有Jev使用场景。ASSAY-001报告
TypeSafe 也提供一组小规模观测数据。在一份使用 Jev 1.12 的示例工程中,置信度≥0.9的30条行业分类样本中27条正确;另外30条低置信样本中仅12条正确。这说明在精选样本上,置信度能有效区分好坏,但不能证明置信度数值本身等于新数据上的真实正确率。置信度分类示例
对应用来说,实操评估问题很直白:自动放行的决策里,错误占多少比例?符合条件的案例中,自动化覆盖比例是多少?
在标注数据集上设计问题与策略;用验证集选定阈值;冻结策略后,在完全未接触的测试集上测量错误率与覆盖率。评估集要包含难分类样本,保证相关记录在数据集切分时不被打散,结果必须附带样本量。少量成功案例不足以证明低错误率。
评估结果必须同步记录模型版本、问题措辞、选项定义与输入预处理逻辑。修改以上任意一项,都需要重新验证。文档中的模型别名可能发生变更,因此下文示例固定指定版本。版本指南
至此,“为什么选择Jev”就有清晰答案:因为它满足你应用中某一项特定决策的要求,且有针对该场景的实测数据支撑。
5. 最后,示例代码
下面场景均为假设案例。Python代码片段演示文档中的接口;本文并未真实调用Jev API。示例刻意将阈值作为策略参数,不直接写死生产可用值。
通用环境要求 Python 3.10 或更高版本,typesafe-sdk==0.7.0。安装SDK包,并通过环境变量配置自己的TYPESAFE_API_KEY。版本很关键:SDK 在0.6.0版本将Score的判定条件改为有序序列。快速入门,SDK更新日志
from typesafe_sdk import Choice, Noul, Score, TypeSafeClient
MODEL = "jev-1.13.0"
def ask(state, questions):
    with TypeSafeClient() as client:
        response = client.system_one(
            model=MODEL, state=state, questions=questions
        )
    return response.answers
from typesafe_sdk import Choice, Noul, Score, TypeSafeClient
MODEL = "jev-1.13.0"
def ask(state, questions):
    with TypeSafeClient() as client:
        response = client.system_one(
            model=MODEL, state=state, questions=questions
        )
    return response.answers
代码片段只聚焦决策逻辑。生产环境集成还需要处理请求失败、记录结果、实现应用兜底逻辑。
使用 Choice 路由客服工单
假设客户留言:“支付页面超时,重试之后,我看到两笔扣款。”
消息同时提到技术故障与账单问题。路由策略要确定哪一项诉求决定工单归属。本例假设支付纠纷优先级更高,技术原因后续再排查。
指令需要显式说明这一点。清晰的分类描述,帮助模型做出应用真正需要的判断。
def classify_ticket(message):
    return ask(message, {
        "queue": Choice(
            instructions=(
                "选择当前请求对应的负责队列。"
                "扣款纠纷优先级高于其背后的技术原因。"
            ),
            criteria={
                "billing": "扣款争议、发票或金额相关问题。",
                "technical": "产品故障,且不存在扣款纠纷。",
                "account": "登录或账号访问问题。",
                "other": "归属不明确,或不属于以上类别。",
            },
        )
    })["queue"]
def choose_queue(answer, min_confidence):
    if answer.choice == "other" or answer.confidence < min_confidence:
        return "manual_review"
    return answer.choice
Choice 返回选中标签、各备选选项概率,以及独立的置信度统计值。示例策略用置信度决定是否自动放行;团队也可以基于选中项概率设计策略。两种方案孰优孰劣,都需要实测自动处理的错误率与覆盖率来判定。Choice参考文档
在本假设策略下,工单归属账单队列。这是案例标注规则,不是模型真实返回结果。即便模型给出高置信度的账单分类,也不能证明客户确实被重复扣款,或是应该退款。这类结论需要交易记录与授权信息。
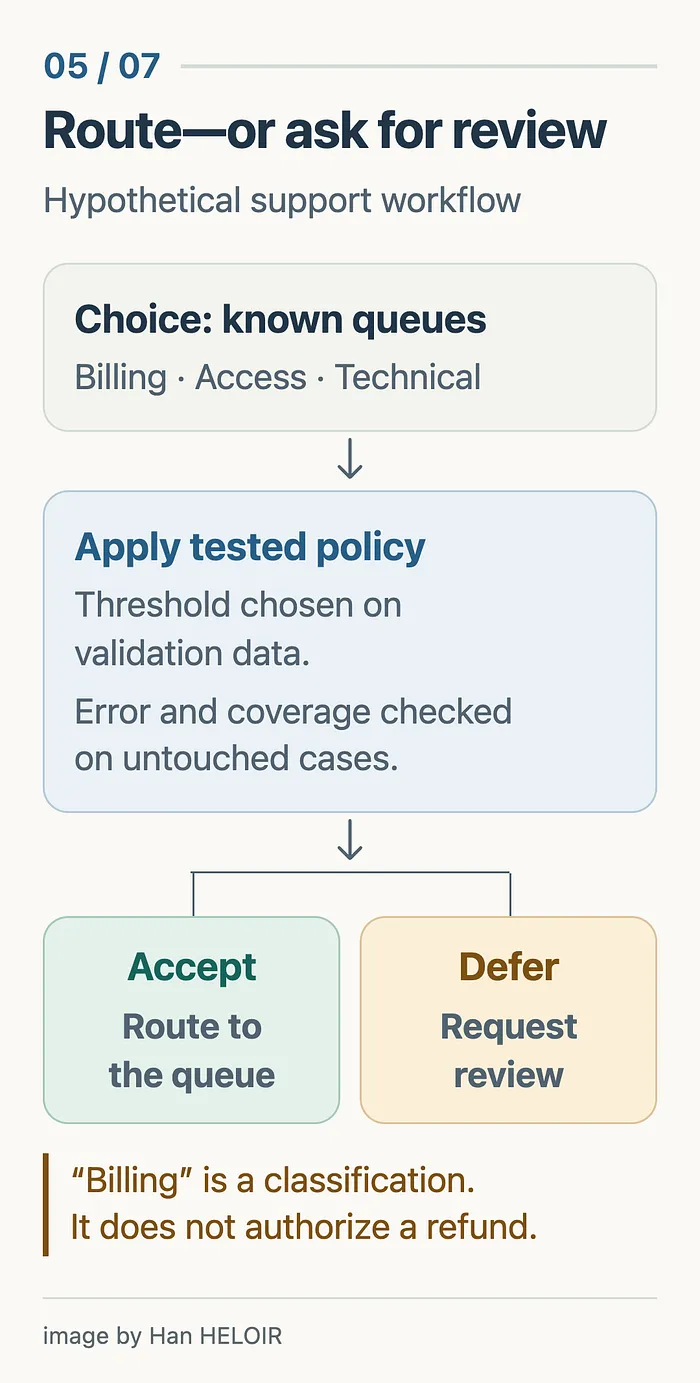
图5. 分类给出候选归属;由应用控制是否采纳,以及后续执行动作。
评估该路由模块时,按照工单应归属队列做标注。重点检查账单诉求与技术诉求并存的歧义案例。统计自动路由工单里的错误数量,记录需要人工复核的工单占比。上线后也要抽样检查自动放行工单:仅复核人工队列,会漏掉高置信度的错误判断。
other类别让分类体系更贴合真实场景,给模型一个“无法归类”的合法输出。但这不代表陌生输入一定会命中该类别。
使用 Noul 过滤检索段落
检索系统会召回多条包含用户关键词的段落,下一步需要判断:每一段是否含有能回答用户真实问题的信息。
假设用户产品提问:“关闭账号后,我还能下载发票吗?”其中一段讲账号正常状态下下载发票,一段描述账号注销后的文档访问,第三段讲解账单地址修改。文字存在重叠,但有效信息完全不同。
针对每一条候选段落提出窄范围相关性判断。本例把所有候选放入共享状态,每条问题单独评估一段文本。
def judge_passages(question, passages):
    state = {"user_question": question, "passages": passages}
    questions = {
        f"passage_{i}": Noul(
            instructions=(
                f"判断passages[{i}]是否包含有助于回答user_question的信息,"
                "包括推翻用户问题假设的证据。仅评估当前段落。"
            )
        )
        for i in range(len(passages))
    }
    return ask(state, questions)
def keep_passages(passages, answers, min_relevance):
    return [
        passage for i, passage in enumerate(passages)
        if answers[f"passage_{i}"].noul >= min_relevance
    ]
Noul 值代表命题成立的预估概率。针对这个问题,低值代表模型倾向段落无关。它不是相关性强弱分值;没有confidence字段,不代表返回结果不含不确定性信息。Noul参考文档
“推翻用户假设的证据”这一点很关键。如果资料说明该功能不可用,同样属于高相关。过滤策略不能只保留支持用户预期答案的段落。
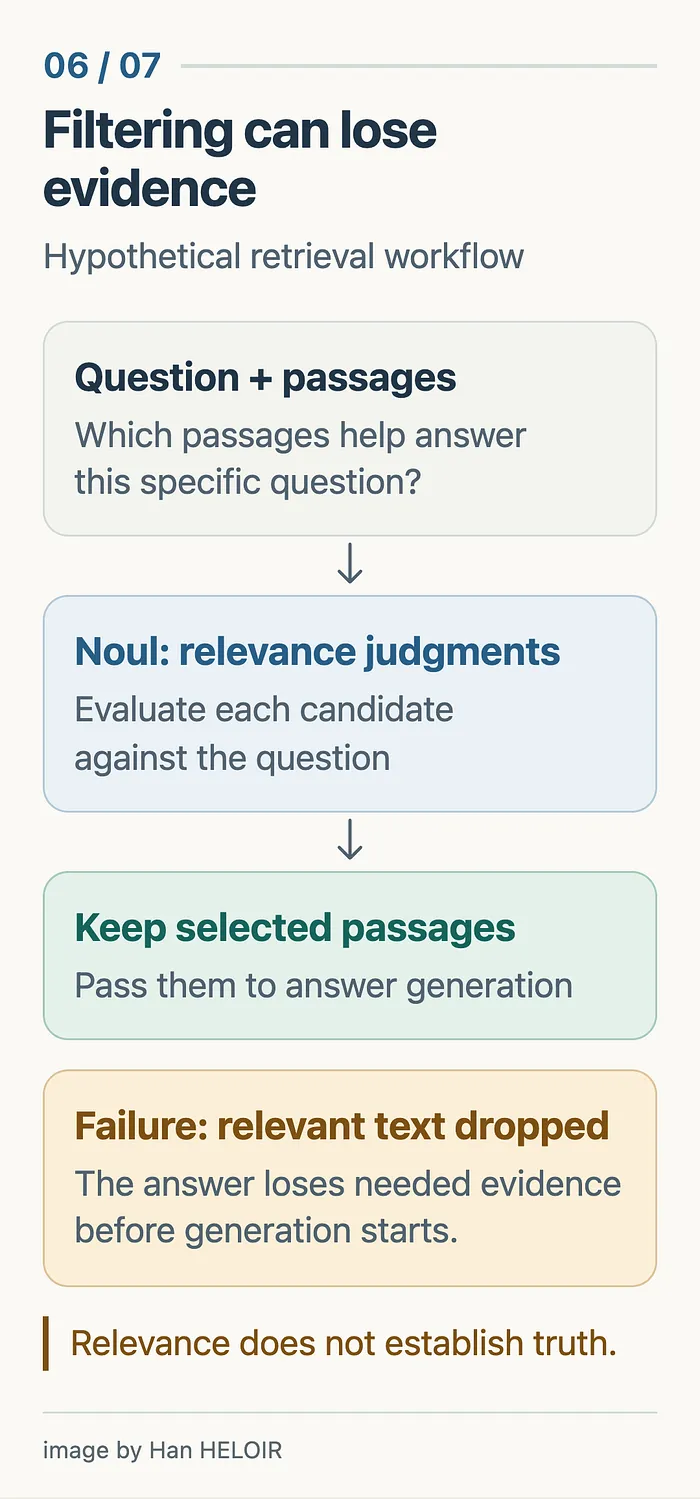
图6. 相关性过滤可以精简上下文,也可能删掉正确回答必需的证据。
这只是检索链路中的一环。相关性不等于内容真实、信息不过时,也不代表可以抵御提示注入。TypeSafe 的RAG示例工程会对段落做多维度提问,同时判断相关性与冲突信息,说明这些问题需要分开处理。RAG段落示例
要从两个维度评估过滤效果:统计被误保留的无关内容,同时统计被误丢弃的有效内容。再评估最终生成答案:精简上下文只有在保留回答所需信息的前提下才有价值。
候选段落数量很大时,共享状态方案会传入过多无关信息。必要时拆分任务,按小组执行查询-段落评估。批量收益需要权衡输入体积与干扰信息。若无任何段落通过过滤,应用要预设兜底方案,例如扩大检索范围或明确返回证据不足。
使用 Score 给审核队列设置优先级
最后,假设客服团队需要评估消息表达的紧急程度,同时保留合同约定截止时间。
模型负责解读文本语义;应用负责计算服务截止时间。如果把二者合并成一句指令“判断紧急程度”,将无法分清是哪条规则决定优先级。
先定义语义评分标准:
def judge_urgency(message):
    return ask(message, {
        "urgency": Score(
            instructions="发件人的求助紧急程度如何?",
            criteria=[
                "常规请求,无时间压力。",
                "有时间限制,但仍可继续开展相关工作。",
                "请求立即协助,核心业务已阻塞。",
            ],
        )
    })["urgency"]
def review_priority(answer, deadline_breached, min_confidence, urgent_score):
    if deadline_breached:
        return "priority_review"
    if answer.confidence < min_confidence:
        return "manual_triage"
    if answer.score >= urgent_score:
        return "priority_review"
    return "standard_review"
截止时间对比逻辑放在代码其他位置。上述策略中,一旦截止时间已过期,无论模型解读结果如何,都升级为优先审核。置信度和紧急度阈值,需要针对工单队列选定并验证,函数内不提供默认值。
Score 是各等级上概率加权后的位置。举个例子,假设等级0、1、2的概率分布是0.1、0.7、0.2,则分值为 `0 × 0.1
1 × 0.7 2 × 0.2 = 1.1`。这只是演示计算,并非真实Jev返回值。该分值不是距离需要帮助还有1.1小时,也不是110%紧急概率。Score参考文档 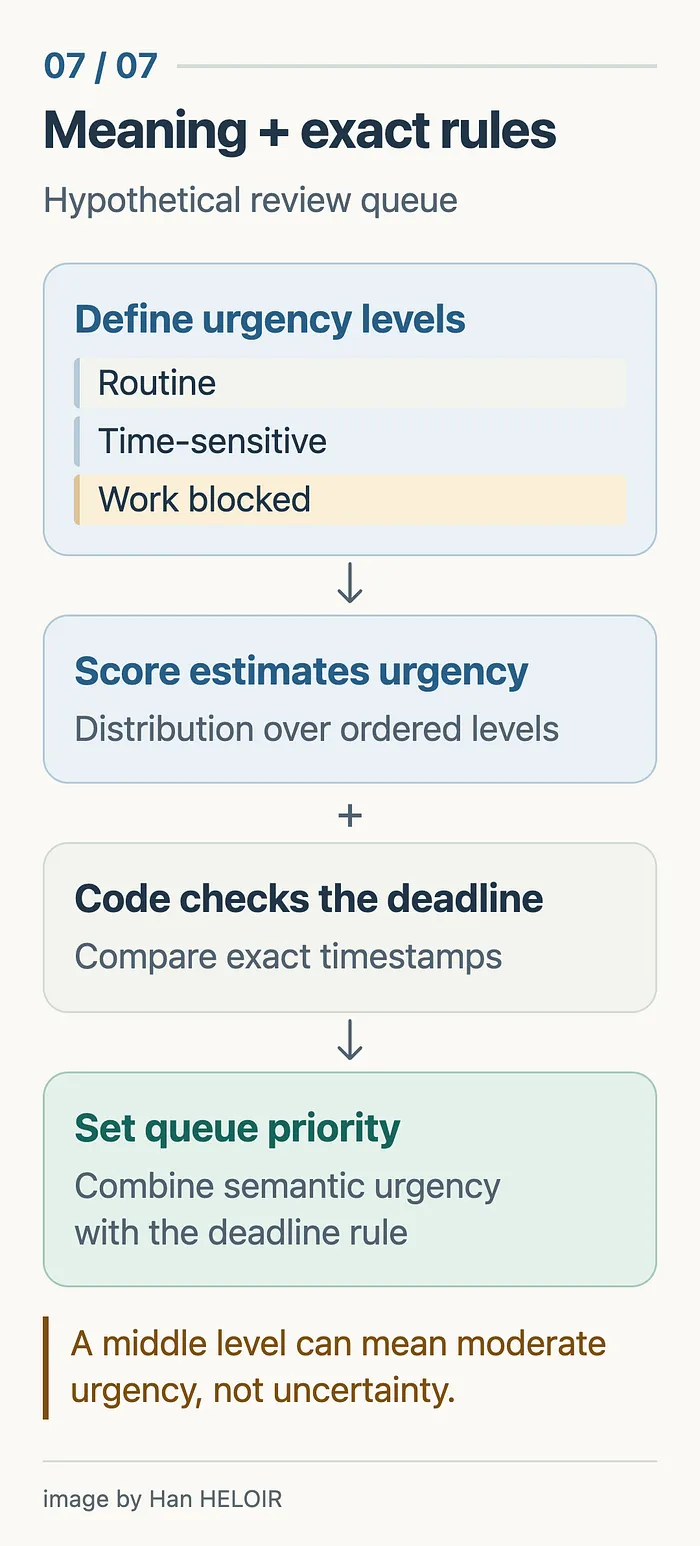
图7. 评分标准定义判断依据;显式策略将判断结果转化为队列处理行为。
均值会丢失分布细节。概率集中在中间等级,与概率分散在两极,完全可以算出相同平均分。当这种分布差异会改变后续动作时,需要查看完整概率分布。落在中间等级,不自动等同于不确定。
评估重点是最终优先级决策。检查哪些真正紧急的工单被归入普通审核,哪些普通工单抢占优先队列。测试案例要包含简短消息、含蓄描述业务阻塞的场景,而不只用情绪激烈的文本。如果评分标准偏向情绪化表达,会导致业务优先级排序失真。
纵观所有示例,Jev的作用始终明确:确定工单归属、评估段落相关性、评估文本描述状态。每一个问题含义清晰,在代码里有明确后续动作。这正是模型发挥价值的地方——一次处理一项有用的决策,同时保证外层应用能妥善处理全链路逻辑。
-------------------------------------------------------------
希望这篇文章能为您带来一些帮助。如果有任何疑问或建议,请在评论区留言,我们将尽力回答!
欢迎后台私信加入组织共同交流。
让我们一起探索并推动前沿技术发展!🚀💻
祝好运!😊✍️