ARTICLE · 1092960
Xvisor 源码分析(五):设备虚拟化 — 区域、模拟器与 MMIO 陷出
上一篇讲中断虚拟化时反复出现一个函数:vmm_devemu_emulate_irq。PL011 模拟器收到 Host 侧输入的字节后调用它向 Guest 断言电平,虚拟定时器到期后调用它的孪生版本注入 PPI,VGIC 则把自己注册成它背后的 irqchip。当时把这个函数当作黑盒带过,本篇把它拆开。设备虚拟化要回答的问题可以浓缩成一句话:Guest 眼里的那台“整机”是怎么拼出来的,拼出来之后,Guest 的一次设备访问在 xvisor 内部要走多远。
这个问题在中断虚拟化里已经出现过一次归属冲突,设备侧的版本更彻底。物理 SoC 上的 UART 控制器只有一组寄存器,两个 Guest 同时访问就会互相踩踏;可是每个 Guest 的软件又都默认自己独占一组完整的设备。模拟是最直接的答案:Guest 访问的“设备”只是一段软件,寄存器读写的语义由 xvisor 里的回调函数给出。麻烦在于模拟必须精确,Linux 的驱动初始化时会逐个探测 UARTDR、UARTFR、UARTMIS 等寄存器,任何一处语义偏差都会让驱动判定设备不存在,Guest 就在启动早期卡死。
本文代码取自 xvisor master 分支,涉及 core/vmm_guest_aspace.c、core/vmm_devemu.c、arch/arm/cpu/arm64/cpu_vcpu_excep.c 与 cpu_vcpu_emulate.c、cpu_interrupts.c,以及 emulators/serial/pl011.c 和 tests/arm64/virt-v8/virt-v8-guest.dts 配置样例。全部函数名与结构体均以真实源码为准。
1. 区域:Guest 地址空间的账本
xvisor 不维护一张“这个 Guest 有哪些设备”的清单,它维护的是一份更底层的账:Guest 物理地址空间里每一段地址的性质。这份账的单位是区域,struct vmm_region。每个区域记录 Guest 物理起点、大小、一组标志位,以及指向 Guest 设备树节点的引用。区域从哪来?答案藏在一个容易被忽略的事实里:xvisor 的每个 Guest 有一份独立的设备树,Guest 配置本身就是设备树的形态,地址空间的划分写在这份设备树的 aspace 节点下。
以仓库自带的 arm64 测试 Guest 为例,aspace 下的每个子节点描述一个区域,三行属性决定其性质。manifest_type 说明区域怎么落地,取值 real、virtual 或 alias;address_type 区分 memory 与 io;device_type 说明这段地址里住的是什么,ram 与 rom 的各种变体之外,其余一律视为设备:
/* tests/arm64/virt-v8/virt-v8-guest.dts */
aspace {
    guest_irq_count = <1024>;

    uart0 {                                  /* 软件模拟的串口 */
        manifest_type = "virtual";
        address_type = "memory";
        guest_physical_addr = <0x09000000>;
        physical_size = <0x1000>;
        device_type = "serial";
        compatible = "primecell,arm,pl011";
        fifo_size = <1024>;
        interrupts = <33>;
    };

    gic_cpu {                                /* 直通给 VGIC 的 CPU 接口 */
        manifest_type = "real";
        address_type = "memory";
        guest_physical_addr = <0x08010000>;
        host_physical_addr = <0x00000000>;  /* 由 VGIC 模拟器改写 */
        physical_size = <0x1000>;
        device_type = "pic";
        compatible = "arm,vgic,cpu";
    };

    MEM0: mem0 {                             /* 分配给 Guest 的内存 */
        manifest_type = "real";
        address_type = "memory";
        guest_physical_addr = <0x40000000>;
        physical_size = <0x00000000>;       /* 创建 Guest 时覆盖 */
        align_order = <21>;
        device_type = "alloced_ram";
    };
};
同一段 0x1000 大小的地址,uart0 与 gic_cpu 的身份完全不同:前者是 virtual,Stage 2 页表里根本没有对应的映射,Guest 每次访问都会陷出到 EL2;后者是 real,配置里写了 host_physical_addr,会在 Stage 2 里映射到真实的物理地址。也就是说,区域的 manifest_type 从一开始就决定了这个设备的实现路线,模拟还是直通,不是运行时选择,而是配置时声明。
region_add 在构建时把这些字符串翻译成标志位,然后按地址范围插入两棵红黑树之一:address_type 为 io 的进 reg_iotree,其余进 reg_memtree,树键就是 Guest 物理地址。插入前有一段严格的重叠检查,新区间的终点若落在任何既有区间之内,整个区域添加失败并返回 VMM_EINVALID。这份账本由此保持了两个重要性质:任意时刻任意 Guest 物理地址至多命中一个区域,以及查找就是一次对数复杂度的树下行。后面会看到,MMIO 陷出的第一站就是查这两棵树。
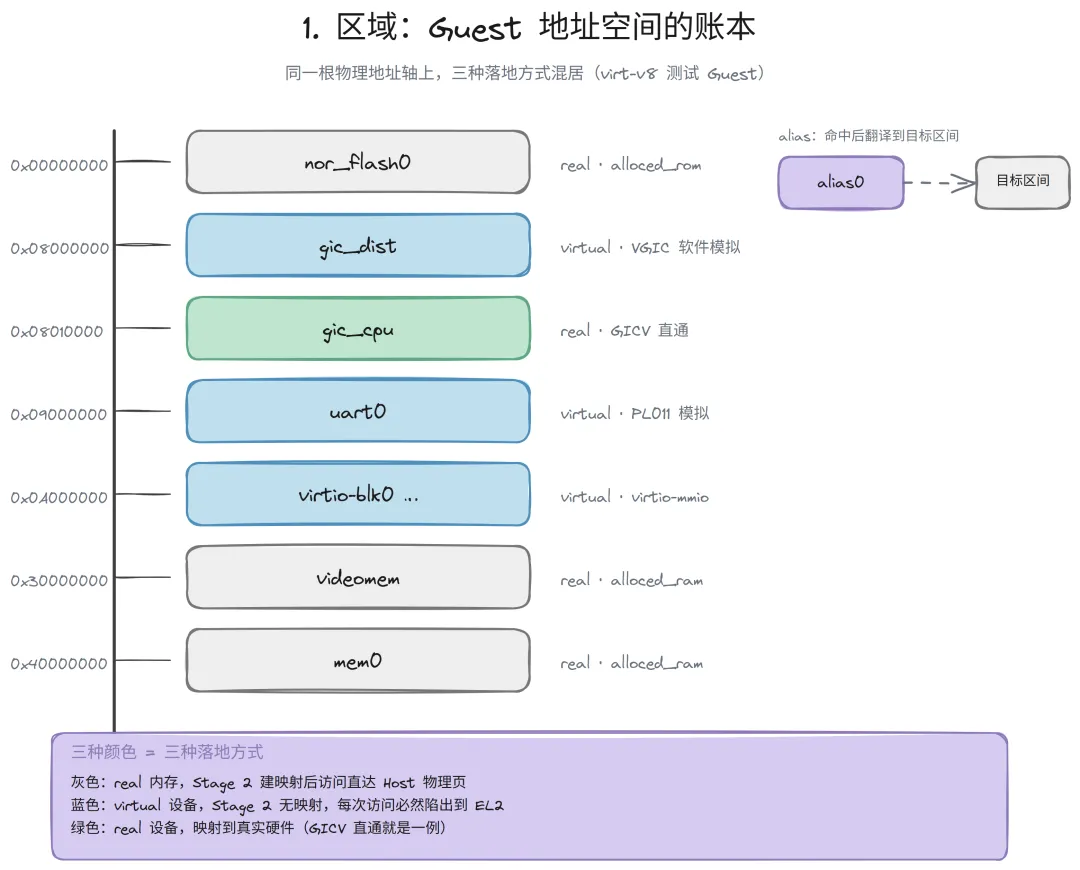
这张图的重点不是地址数值本身,而是同一根 Guest 物理地址轴上三种着色的分区方式:灰色是 real 的内存,Stage 2 直接映射;蓝色是 virtual 的设备,访问必然陷出;绿色是 real 的设备,映射到真实硬件。同一个 Guest 里三种混居,xvisor 对每一区间的处理策略完全由颜色决定。图中还有一段虚线标出的 alias 区域,它不自己持有内容,只把地址翻译到另一个区间去,查找命中 alias 时会再做一轮跳转。
2. 模拟器:一个模块一份注册表
区域解决了“哪里有设备”,没有回答“设备的行为由谁实现”。答案是一批可加载的模拟器模块。emulators 目录下的 pl011.c、pl031.c、sp805.c、virtio_mmio.c,每个文件都是一个独立的 xvisor 模块,模块初始化函数只做一件事,把一个 struct vmm_emulator 挂进全局链表。这个结构体的核心是三样东西:名字、一张设备树匹配表、一组读写回调:
/* emulators/serial/pl011.c */
staticstruct vmm_devtree_nodeid pl011_emuid_table[] = {
    { .type = "serial",
      .compatible = "primecell,arm,pl011",
      .data = &pl011_configs[0] },       /* 外设 ID cell,供 UARTDR 0xFE0 读出 */
    { .type = "serial",
      .compatible = "primecell,luminary,pl011",
      .data = &pl011_configs[8] },
    { /* end of list */ },
};

staticstruct vmm_emulator pl011_emulator = {
    .name = "pl011",
    .match_table = pl011_emuid_table,
    .endian = VMM_DEVEMU_LITTLE_ENDIAN,
    .probe = pl011_emulator_probe,
    .read8 = pl011_emulator_read8,       /* 8/16/32 位各自一档回调 */
    .write8 = pl011_emulator_write8,
    .read16 = pl011_emulator_read16,
    .write16 = pl011_emulator_write16,
    .read32 = pl011_emulator_read32,
    .write32 = pl011_emulator_write32,
    .reset = pl011_emulator_reset,
    .remove = pl011_emulator_remove,
};

static int __init pl011_emulator_init(void)
{
    return vmm_devemu_register_emulator(&pl011_emulator);
}
匹配表的字段与 Guest 设备树节点一一对应:type 对 device_type,compatible 对 compatible。值得注意 data 字段挂的那组外设 ID。ARM 的 Primecell 外设规范要求 0xFE0 到 0xFFC 处存放厂商识别码,Linux 的 AMBA 驱动初始化时会读出来核对,对不上就拒绝继续。模拟器把 ID 塞进匹配表而非硬编码在读写函数里,是因为 pl011 有多个衍生版本,ID 各不相同,同一份模拟逻辑要服务多个匹配项。
回调按访问宽度分档,1、2、4、8 字节各有一对读写函数。如果模拟器作者觉得分档太啰嗦,框架还提供了另一条路:只实现 read_simple 与 write_simple 两个按宽度参数分发的函数,然后用 VMM_DECLARE_EMULATOR_SIMPLE 宏生成全套分档回调,生成出的 write8 会把高位掩掉再调 write_simple。pl011 没走这条路,它老老实实写了六档,因为串口寄存器在 1 字节与 4 字节访问下的行为确实一致,直接共用一个内部实现更直白。
3. probe:把模拟器绑到区域上
注册表是全局的,区域是每个 Guest 一份的,两者在区域创建时挂钩。region_add 在把区域插进红黑树之前,对每个设备类型的区域调用 vmm_devemu_probe_region,后者进入框架里最核心的一个函数 devemu_probe_edev。这个函数拿着区域的设备树节点,遍历全局模拟器链表,用每个模拟器的匹配表去试:
/* core/vmm_devemu.c,节选 */
static struct vmm_emudev *devemu_probe_edev(struct vmm_guest *guest,
                        struct vmm_devtree_node *node,
                        struct vmm_region *reg,
                        struct vmm_emudev *parent)
{
    list_for_each_entry(emu, &dectrl.emu_list, head) {
        match = vmm_devtree_match_node(emu->match_table, node);
        if (!match)
            continue;                    /* 匹配表对不上,换下一个 */

        edev = vmm_zalloc(sizeof(struct vmm_emudev));
        edev->node = node;               /* 记住设备树节点 */
        edev->reg = reg;                 /* 记住所属区域 */
        edev->emu = emu;                 /* 记住命中的模拟器 */
        edev->parent = parent;           /* 总线类设备的父节点 */
        INIT_LIST_HEAD(&edev->child_list);

        if (emu->probe(guest, edev, match))   /* 失败即释放返回 */
            ...
        if (emu->reset(edev))                /* probe 成功立刻复位 */
            ...

        if (reg)
            reg->devemu_priv = edev;     /* 区域到模拟器的指针在这里接上 */
    }
    ...
    /* 递归 probe 子节点,挂在当前 edev 的 child_list 上 */
    vmm_devtree_for_each_child(child, edev->node) {
        edevc = devemu_probe_edev(guest, child, NULL, edev);
        list_add_tail(&edevc->head, &edev->child_list);
    }
    return edev;
}
整个 Guest 的设备装配在 vmm_guest_aspace_init 里完成:取出 aspace 节点,先调 vmm_devemu_init_context 分配 Guest 中断号空间,再对 aspace 的每个子节点执行 region_add。region_add 内部的次序值得留意:内存区域先向 Host 申请物理页,设备区域随后 probe 模拟器,然后才把区域插树。任何一步失败都有对应的回滚,回滚路径里连 Host 内存都会归还。Guest 创建成功之后,全部区域就位,每个设备区域都带着一个 devemu_priv 指针,指向它命中的那个 vmm_emudev 实例。
vmm_emudev 里最容易被忽略的是 child_list 与 parent。probe 是递归的:命中一个模拟器之后,框架会继续遍历该设备树节点的子节点,把子设备也 probe 出来,挂成父子关系。这个设计服务于总线类设备。virtio-mmio 的设备树节点下面会有 virtio 子节点,父设备负责 MMIO 传输层的寄存器,子设备负责具体的前端设备语义,Guest 的 notify 写到父设备的寄存器,动作由子设备的回调完成。如果某个设备不希望子节点被 probe,在设备树里写上 no_child_probe 属性即可跳过。
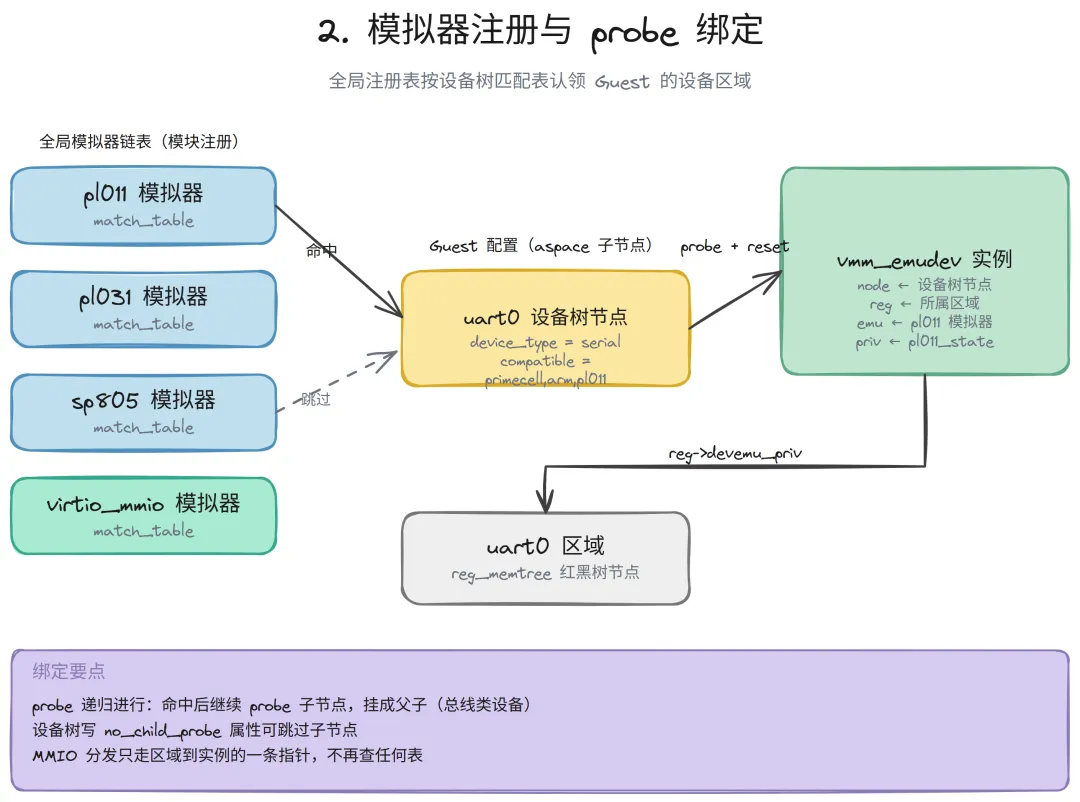
这张图的重点不是 probe 的调用顺序,而是三类对象各自的持有关系:全局链表持有所有注册过的模拟器,区域的 devemu_priv 指向命中的 vmm_emudev 实例,实例内部再通过 emu 指针回到模拟器本体、通过 node 指针回到设备树。MMIO 陷出后的每一次分发,走的都是区域到实例这一条指针,全程不需要再查任何表。
4. 陷出:硬件先把路铺好
账本与模拟器都就位了,剩下的问题是触发时机。Guest 的一条 ldr 指令访问 uart0 的 UARTFR,地址 0x09000000。这个地址在 Stage 2 页表里没有映射,硬件触发 Data Abort,异常级别从 EL1 切到 EL2,xvisor 的异常向量入口开始工作。这条路上一篇走了一遍,本篇关注其中属于设备模拟的部分:两个寄存器与一次分流。
第一个寄存器是 FAR_EL2,它保存出错时的虚拟地址,也就是 Guest 自己的虚拟地址。问题在于设备模拟需要的是 Guest 物理地址,而虚拟地址到物理地址的翻译权在 Guest 手里:Guest 的 Stage 1 页表是 Guest 操作系统自己维护的,xvisor 若在软件里走一遍这张表,既要处理各级描述符格式,又要处理大页小页的粒度差异。硬件为此提供了第二个寄存器 HPFAR_EL2,Stage 2 缺页时,翻译硬件会顺着 Guest 的 Stage 1 页表走到头,把得到的中间物理地址写进 HPFAR,失败原因写进 ESR_EL2。xvisor 只需要把两个寄存器拼起来:
/* arch/arm/cpu/arm64/cpu_interrupts.c,节选 */
fipa = (mrs(hpfar_el2) & HPFAR_FIPA_MASK) >> HPFAR_FIPA_SHIFT;
fipa = fipa << HPFAR_FIPA_PAGE_SHIFT;    /* 高位:出错页的 IPA */
fipa = fipa | (mrs(far_el2) & HPFAR_FIPA_PAGE_MASK);  /* 低 12 位:页内偏移 */
HPFAR 只精确到页,页内偏移取自 FAR 的低 12 位,两者拼接才是完整的 Guest 物理地址。接下来是分流,cpu_vcpu_data_abort 按故障状态码 FSC 分三路处理,这三路覆盖了设备模拟的全部入口:
/* arch/arm/cpu/arm64/cpu_vcpu_excep.c,节选 */
int cpu_vcpu_data_abort(struct vmm_vcpu *vcpu, arch_regs_t *regs,
                        u32 il, u32 iss, physical_addr_t fipa)
{
    switch (iss & ISS_ABORT_FSC_MASK) {
    case FSC_TRANS_FAULT_LEVEL1:
    case FSC_TRANS_FAULT_LEVEL2:
    case FSC_TRANS_FAULT_LEVEL3:
        return cpu_vcpu_stage2_map(vcpu, regs, fipa);  /* 翻译缺页 */

    case FSC_ACCESS_FAULT_LEVEL1:
    case FSC_ACCESS_FAULT_LEVEL2:
    case FSC_ACCESS_FAULT_LEVEL3:
        if (!(iss & ISS_ABORT_ISV_MASK)) {
            /* 综合征无效,走完整指令解码 */
            ...
            return emulate_arm_inst(vcpu, regs, inst);
        }
        if (iss & ISS_ABORT_WNR_MASK)
            return cpu_vcpu_emulate_store(vcpu, regs, il, iss, fipa);
        else
            return cpu_vcpu_emulate_load(vcpu, regs, il, iss, fipa);
    };
    return VMM_EFAIL;
}
翻译缺页与访问错误是两种不同的故障。翻译缺页意味着 Stage 2 里连页表项都没有,最常见的原因是内存区域还没建立映射:xvisor 对 Guest 内存采取惰性映射,region_add 时只记账不建页,第一次访问到才由 cpu_vcpu_stage2_map 查账本、生成 Stage 2 映射,属于内存虚拟化的范畴。访问错误则不同,页表项存在但权限不允许,virtual 区域的设备页正是以这种方式配置的:页表项存在,权限为不可访问,于是每次访问都稳定地陷出。MMIO 模拟走的是第二类。
5. 指令模拟:从综合征到寄存器
陷出之后 xvisor 必须替 Guest 完成那条访存指令:把数据取回来写进 Guest 的通用寄存器,或者把寄存器的值写出去,然后把 PC 前移一条指令。要做到这一点,就得知道那条指令访问的宽度和目标寄存器编号。ARM 的设计者预料到了这个需求,在 ESR_EL2 的综合征 ISS 里预埋了访存指令的关键字段,前提是 ISS_ABORT_ISV 位为 1。cpu_vcpu_emulate_load 把这些字段拆出来用:
/* arch/arm/cpu/arm64/cpu_vcpu_emulate.c,节选 */
sas = (iss & ISS_ABORT_SAS_MASK) >> ISS_ABORT_SAS_SHIFT;  /* 访问尺寸 */
sse = (iss & ISS_ABORT_SSE_MASK) >> ISS_ABORT_SSE_SHIFT; /* 是否符号扩展 */
srt = (iss & ISS_ABORT_SRT_MASK) >> ISS_ABORT_SRT_SHIFT; /* 目标寄存器 */

switch (sas) {
case 0:                                  /* 1 字节 */
    rc = vmm_devemu_emulate_read(vcpu, ipa, &data8,
                                 sizeof(data8), data_endian);
    if (!rc)
        cpu_vcpu_reg64_write(vcpu, regs, srt,
            sse ? arm_sign_extend(data8, 8, 32) : data8);
    break;
case 2:                                  /* 4 字节 */
    rc = vmm_devemu_emulate_read(vcpu, ipa, &data32,
                                 sizeof(data32), data_endian);
    if (!rc)
        cpu_vcpu_reg64_write(vcpu, regs, srt, data32);
    break;
};

if (!rc) {
    regs->pc += (il) ? 4 : 2;            /* PC 前移,Thumb 指令 2 字节 */
}
load 与 store 是镜像的一对,store 从 SRT 寄存器取值调 vmm_devemu_emulate_write。符号扩展位 SSE 只对 load 有意义,对应 ldrsb 这类指令。这里的细节密度远超表面:Guest 若运行 AArch32 状态,条件指令可能因为条件不满足而陷出,此时指令实际上不该执行,xvisor 用 cpu_vcpu_condition_check 按 Guest 的 CPSR 标志位重新评估条件,不满足就直接跳过;Thumb 状态下条件信息藏在 ITSTATE 里,模拟完一条指令还要手工推进 ITSTATE,因为真实硬件只在指令实际执行时推进它。
ISV 为 0 的场合同样真实存在。ARM 架构规定,某些不确定的访存指令无法生成有效综合征,比如带写入副作用的非特权访问,或者某些系统指令的内存访问。这时 xvisor 只能自己把出错的那条指令读出来解码:先借助 AT 指令把 Guest PC 翻译成物理地址,从 Guest 内存里读出 32 位指令字,交给 emulate_arm_inst 或 emulate_thumb_inst 做完整的软件解码。这是一条笨路但必须存在的路,兜住综合征覆盖不到的角落。
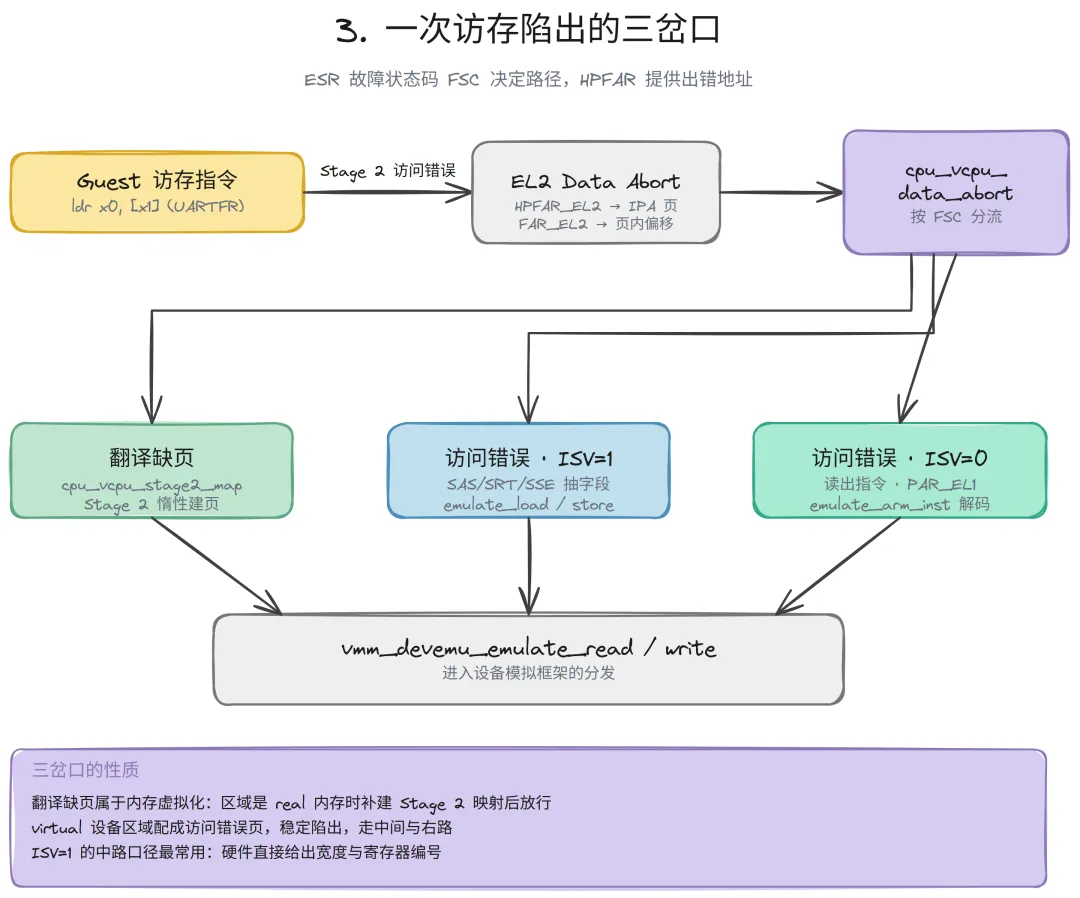
这张图的重点不是异常处理的完整流程,而是一次访存陷出后的三岔口:左边是翻译缺页,归宿是 Stage 2 建页,与设备无关;中间是访问错误且综合征有效,直接从 ISS 抽字段完成一次替身访存;右边是综合征无效的兜底路径,读出指令自己解码。三条路最终都汇到底部的 vmm_devemu_emulate_read 或 write,区别只在到达的方式。
6. 分发:查账本,调回调
vmm_devemu_emulate_read 拿着 Guest 物理地址进入分发。第一步查账本,vmm_guest_find_region 在 memtree 里按地址下行,要求命中区域同时带有 VIRTUAL 与 MEMORY 标志,找不到直接失败。第二步换算偏移,模拟器回调拿到的 offset 是区域内的相对偏移,Guest 物理地址减去区域起点。第三步按访问宽度选回调,同时处理字节序:
/* core/vmm_devemu.c,节选 */
int vmm_devemu_emulate_read(struct vmm_vcpu *vcpu,
                            physical_addr_t gphys_addr, ...)
{
    reg = vmm_guest_find_region(vcpu->guest, gphys_addr,
                    VMM_REGION_VIRTUAL | VMM_REGION_MEMORY, FALSE);
    if (!reg) {
        rc = VMM_ENOTAVAIL;
        goto skip;
    }

    rc = devemu_doread(reg->devemu_priv,   /* 区域绑定的模拟器实例 */
                       gphys_addr - reg->gphys_addr,  /* 换算区域偏移 */
                       dst, dst_len, dst_endian);
skip:
    if (rc) {
        vmm_printf("%s: vcpu=%s gphys=0x%"PRIPADDR" failed\n", ...);
        vmm_manager_vcpu_halt(vcpu);       /* 模拟失败,VCPU 停机 */
    }
    return rc;
}
这条路径上没有重试,也没有异常注入,两次变形之后数据直接落到模拟器的状态字段上。整条链路的代价由三段构成:一次树查找、一次宽度选择、一次回调,全部是纯内存操作,代价的可预期性正是这种简单结构的价值。
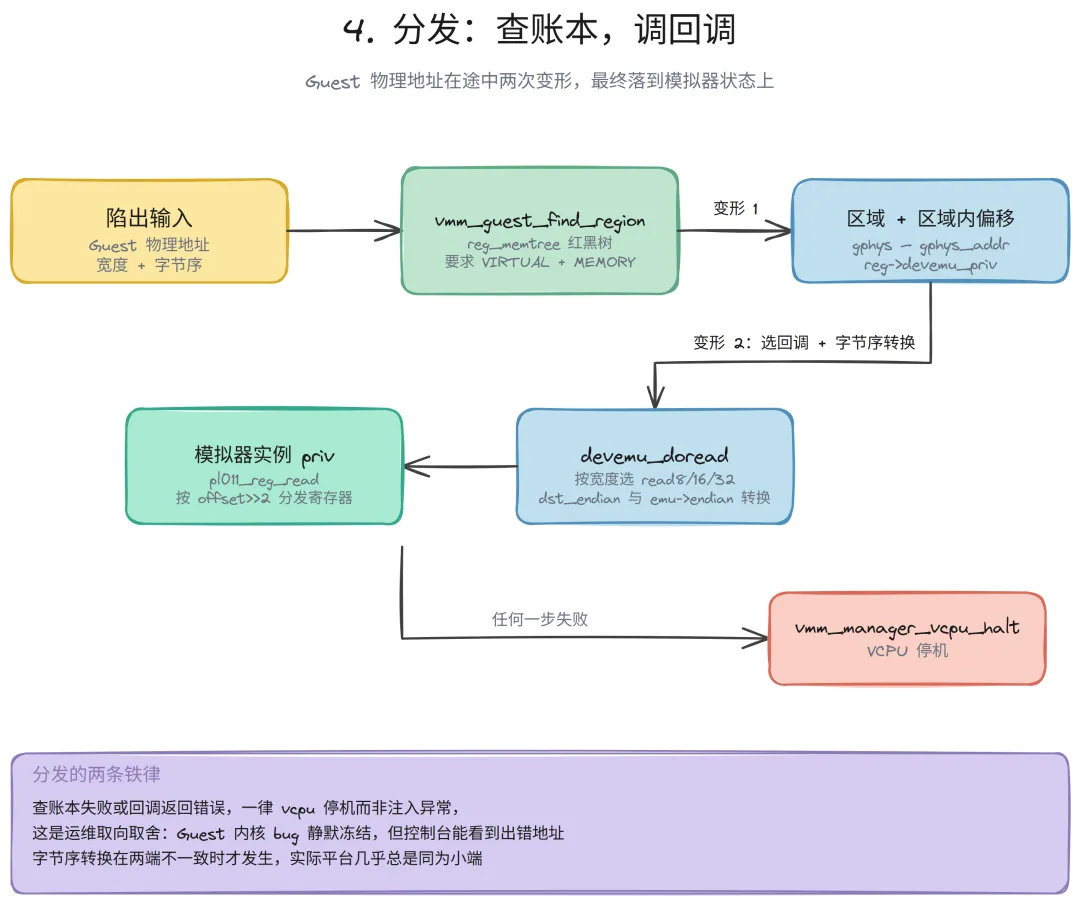
这张图的重点不是回调的签名,而是数据在分发途中两次变形的过程:Guest 物理地址先在查账本一步变成区域加区域内偏移,宽度与字节序再在 doread 一步选定回调与转换策略,最后落到模拟器实例的 priv 状态上。右下角单独标出的失败分支直通 vcpu 停机,那是整条分发路径上唯一的不归点。
字节序的来源有两端。一端是 Guest:A64 状态看 SCTLR_EL1 的 EE 位,A32 状态看 CPSR 的 BE 位,决定陷出时按什么字节序解释数据。另一端是模拟器:vmm_emulator 的 endian 字段声明自己内部状态的字节序。devemu_doread 在两者不一致时做一次转换。这套机制让一个大端 Guest 访问小端模拟器成为可能,代价是每次访问多几次字节交换,实际平台上两端几乎总是同为小端,交换路径形同虚设。
最值得留意的是失败分支的 vmm_manager_vcpu_halt。模拟器返回错误意味着 Guest 访问了一个配置声明存在、但没有任何模拟器能接住的地址,或者模拟器内部状态机不认这个寄存器偏移。xvisor 对此的处理不是注入异常让 Guest 的异常处理程序善后,而是直接把这个 VCPU 停机。理由写在了代码注释与设计取舍里:Guest 陷入未定义行为的访存循环时,注入异常只会让 Guest 反复重试,停机至少能让管理员从控制台日志里看到出错的地址与模拟器名字。这是一个偏运维取向的取舍,代价是 Guest 内核的一个 bug 可能演变成整个 Guest 静默冻结。
7. 实例:PL011 的一次收发
框架的机制讲完了,用一个具体的设备把链路串起来。pl011 的 probe 从设备树读取中断号与 FIFO 深度,创建一个 vserial 虚拟串口后端,把设备状态挂进 edev 的 priv。之后的一切交互都发生在读写回调里。Guest 驱动初始化时读 0xFE0 处的外设 ID 核对身份,读 UARTFR 查询发送 FIFO 是否有空位,这些纯查询操作只碰 pl011_state 里的一组字段,不产生任何副作用。真正的链路从两个方向各自展开。
发送方向,Guest 向 UARTDR 写一个字节。pl011_reg_write 的 case 0 分支记录发送中断电平,然后调用 vmm_vserial_receive 把字节交给后端,后端根据 Guest 配置决定去向:接到 xvisor 控制台,就立刻显示在宿主终端上。接收方向由 Host 侧输入触发,vserial 后端回调 pl011_vserial_send,字节进 rd_fifo,FIFO 水位达到读触发阈值后置起接收中断电平,最后走到上一篇文章的主角:
/* emulators/serial/pl011.c,节选 */
static void pl011_set_irq(struct pl011_state *s, u32 level, u32 enabled)
{
    if (level & enabled)
        vmm_devemu_emulate_irq(s->guest, s->irq, 1);  /* 断言 */
    else
        vmm_devemu_emulate_irq(s->guest, s->irq, 0);  /* 撤销 */
}

/* core/include/vmm_devemu.h */
#define vmm_devemu_emulate_irq(guest, irq, level) \
        __vmm_devemu_emulate_irq(guest, irq, -1, level)
vmm_devemu_emulate_irq 是设备模拟框架与中断虚拟化的交接点。Guest 创建时 vmm_devemu_init_context 按 guest_irq_count 建好中断号数组,每个中断号下挂一条 irqchip 链表。VGIC 初始化时把自己注册到全部中断号上,于是 pl011 的每一次电平断言都会落到 vgic 的 handle 回调,再经过电平翻转转成 LR 排队、GICV 直通交付,这条链路上一篇已经完整走过。设备模拟框架不感知 vgic 的存在,它只管把电平变化广播给注册者,有没有人听、怎么听,是中断子系统的事。
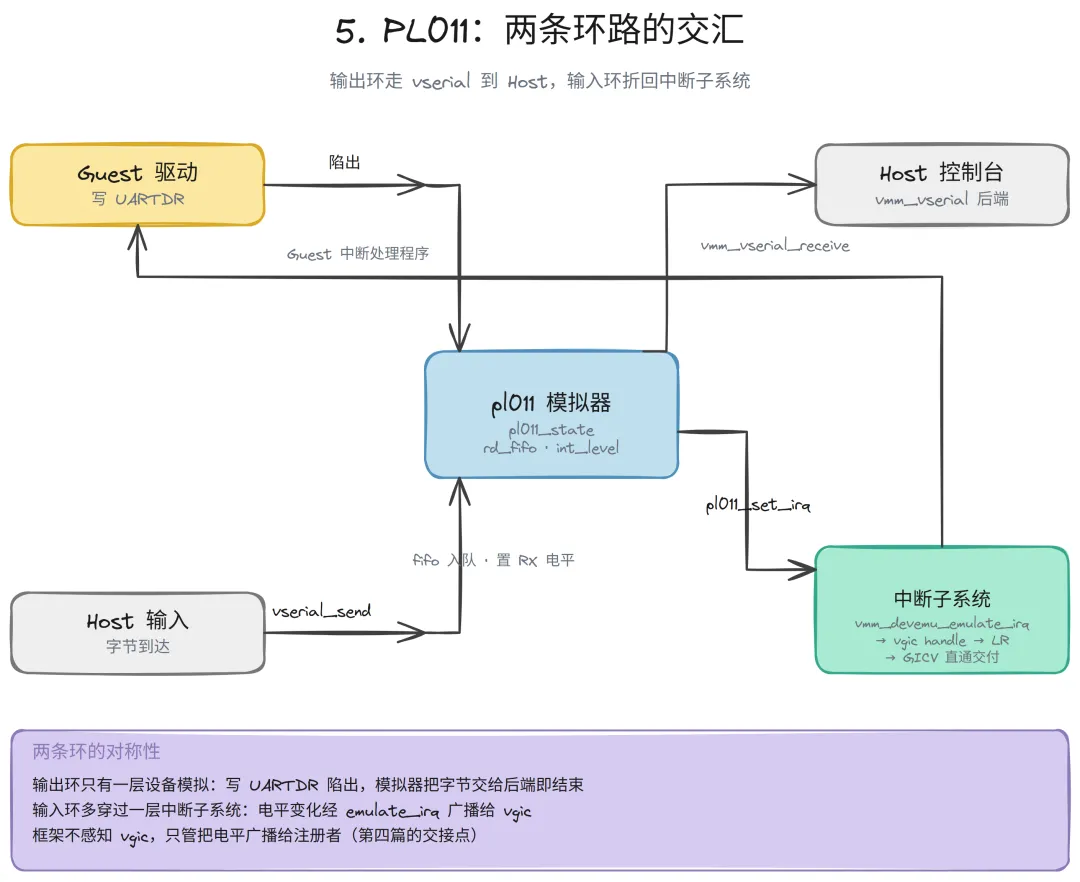
这张图的重点不是串口寄存器的语义,而是左右两条环路的对称性:左环是输出,Guest 写 UARTDR 陷出后经模拟器进 vserial 到 Host;右环是输入,Host 的字节经 vserial 回到模拟器置起电平,再经第四篇的注入链路回到 Guest 的中断处理程序。两条环在 pl011 模拟器处交汇,左右各自穿过一层设备模拟框架,右环额外多穿过一层中断子系统。
8. 加速:virtio 换一条路
逐次模拟的代价在第 5、6 节已经看得很清楚:Guest 每一次设备访问都要付出一次完整陷出、一次指令解码、一次树查找、一次回调。串口每秒几个字节无所谓,块设备与网卡每秒数万个描述符就是灾难。virtio 的思路是不模拟真硬件,让 Guest 的驱动从设计之初就知道对面是虚拟机,双方约定一套只为虚拟化优化的寄存器布局与数据格式。xvisor 在 emulators/virtio 实现了 virtio-mmio 传输层,测试 Guest 的设备树里可以找到它的区域:
/* tests/arm64/virt-v8/virt-v8-guest.dts */
DISK0: virtio-blk0 {
    manifest_type = "virtual";
    address_type = "memory";
    device_type = "virtio";
    compatible = "virtio,mmio";
    virtio_type = <2>;                   /* 2 = 块设备 */
    guest_physical_addr = <0x0A001000>;
    physical_size = <0x1000>;
    blkdev = "";                          /* 创建 Guest 时指定后端 */
    interrupts = <49>;
};
从框架的角度看 virtio_mmio 与 pl011 没有区别:同样是 virtual 区域,同样靠 compatible 匹配 probe,寄存器读写同样走陷出。区别在寄存器的语义密度。virtio-mmio 的队列配置寄存器让 Guest 一次写入就能告知 vring 的地址与深度,QUEUE_NOTIFY 寄存器的一次写入代表一批请求的提交,模拟器在 Host 侧批量搬运。数据面走 Guest 内存里的 vring 环,控制面才是寄存器,陷出次数与数据量从此解耦。前端设备语义由 core/vio 下的 vmm_virtio 框架承接,网络、块、控制台各有实现,virtio_type 为 2 就挂块设备后端,为 3 挂控制台后端。半虚拟化没有绕过设备模拟框架,只是把每次陷出的信息含量放大了几个数量级。
9. 直通:另一种答案
模拟与半虚拟化之外还有第三条路:把真实设备直接映射给 Guest。区域配置里 manifest_type 为 real 且 device_type 为设备的区域,会在 Stage 2 里建立起 Guest 物理地址到 host_physical_addr 的映射,此后 Guest 的访问直达硬件,零陷出。第四篇末尾出现的 gic_cpu 区域就是现成的例子,它的 host_physical_addr 在配置里写的是 0,注释说明这个值会被 VGIC 模拟器自动改写。改写的动作发生在 vgic 探测出 GICV 物理地址之后:
/* core/vmm_guest_aspace.c */
int vmm_guest_overwrite_real_device_mapping(struct vmm_guest *guest,
                        struct vmm_region *reg,
                        physical_addr_t gphys_addr,
                        physical_addr_t hphys_addr)
{
    if (!(reg->flags & VMM_REGION_REAL) ||
        !(reg->flags & VMM_REGION_ISDEVICE))
        return VMM_EINVALID;          /* 只允许改写真实设备区域 */

    map = mapping_find(guest, reg, NULL, gphys_addr);
    if (!map)
        return VMM_EINVALID;

    map->hphys_addr = hphys_addr;     /* 改指向 GICV 的物理地址 */
    return VMM_OK;
}
函数有明确的边界:只接受 real 加 ISDEVICE 的区域,内存区域与虚拟设备区域都不许改。gic_cpu 区域由此指向 GIC 的虚拟 CPU 接口,Guest 的 IAR 与 EOIR 读写全部由硬件完成,这是第四篇零陷出交付的物理基础。直通的取舍也在这里显形:设备的控制权整体交给了 Guest,Host 不再能审计或介入任何访问,两个 Guest 也不能共享同一个直通设备。所以 xvisor 的世界里直通是精确制导的工具,用在中断控制器 CPU 接口这种必须零开销的位置,而不是给设备虚拟化兜底的通用方案。
10. 回到那台整机
现在可以完整回答开篇的问题了。Guest 眼里的整机由三层东西拼成:aspace 账本划定地址空间的每一个区间并给出实现路线;模拟器模块按设备树匹配表认领各个 virtual 区域,用读写回调定义设备行为;中断子系统接住模拟器广播的电平变化,把事件送回 Guest。三层各自独立注册、各自可以缺失,virtio 或直通任何一个不存在,其余部分照常运转。
生命周期的收尾同样在账本上。vmm_guest_aspace_reset 遍历两棵树里全部 ISDEVICE 区域,对每个区域递归调用 reset 回调,父子设备一起归位;Guest 销毁时 devemu_remove_edev 自底向上拆掉整棵设备树,连同 Host 内存一起归还。设备模拟框架由此成为 xvisor 里生命周期管理最完整的子系统之一,毕竟它是唯一一个从 Guest 创建前一直工作到 Guest 销毁后的模块。
设备虚拟化也是这个系列的汇合点:时间虚拟化的 vtimer 靠它注入 PPI,中断虚拟化的 VGIC 靠它注册 irqchip 与改写直通映射,调度器管着的每个 vcpu 在访存陷出时都要经过它的分发。