ARTICLE · 1096868
阿里把内部 AI 代码审查工具 open-code-review 甩出来了--为什么这次值得看
阿里把内部用了两年的 AI 代码审查工具搬上 GitHub 了。
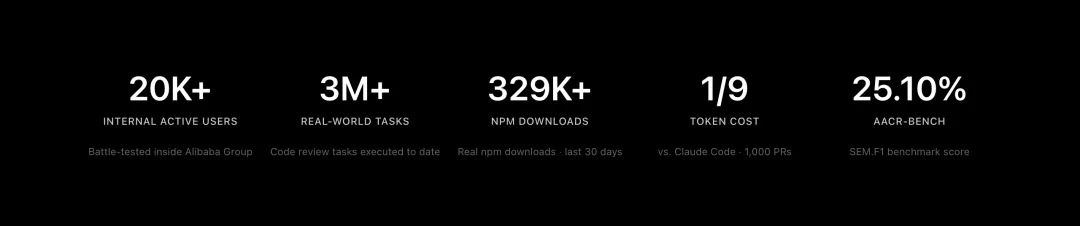
项目叫 OpenCodeReview,Apache-2.0 协议,Go 写的,27.9k stars。最显眼的是它标榜自己「battle-tested at Alibaba’s scale」——这不光是 PR 标题的修辞,是真在阿里几万人研发体系里跑过百万级 PR 的工具。
不是又一个代码补全插件。它解决的是另一个问题:谁来 review 你的 PR。
痛点它没说错
通用 AI 编程 agent(Claude Code、Cursor 这种)拿来做 code review,三个老毛病:
- 覆盖不全
大 changeset 一来,agent 就开始”挑着看”,漏文件是常态 - 位置漂移
评论挂在 A 行,bug 实际在 B 行,行号都指偏 - 质量不稳
Skill 是自然语言写的,prompt 改一个字输出就抖
根因说穿了:纯语言驱动的架构对 review 这种活儿缺少硬约束。
它怎么破的:确定性 × Agent
OpenCodeReview 的核心哲学是「让确定性工程干确定性活儿,让 agent 干需要判断力的活儿」。
确定性那部分:
- 精准选文件
哪些必须 review、哪些跳过,规则说了算,agent 拍不了板 - 智能打包
比如 message_en.properties和message_zh-CN.properties配对送进同一个子 agent,分治策略在大 changeset 上很稳 - 细粒度规则匹配
内置 NPE、线程安全、XSS、SQL 注入等语言规则,模板引擎挑出来的规则比”提示词里写一句”靠谱得多 - 独立定位/反思模块
AI 报的位置不准、内容跑偏这事,由独立模块兜底纠正
Agent 那部分就干两件事:动态决策 + 动态上下文。prompt 是从阿里内部 tool-call trace 蒸馏出来的,不是一般 agent 那种通用工具包。
实测数据说话
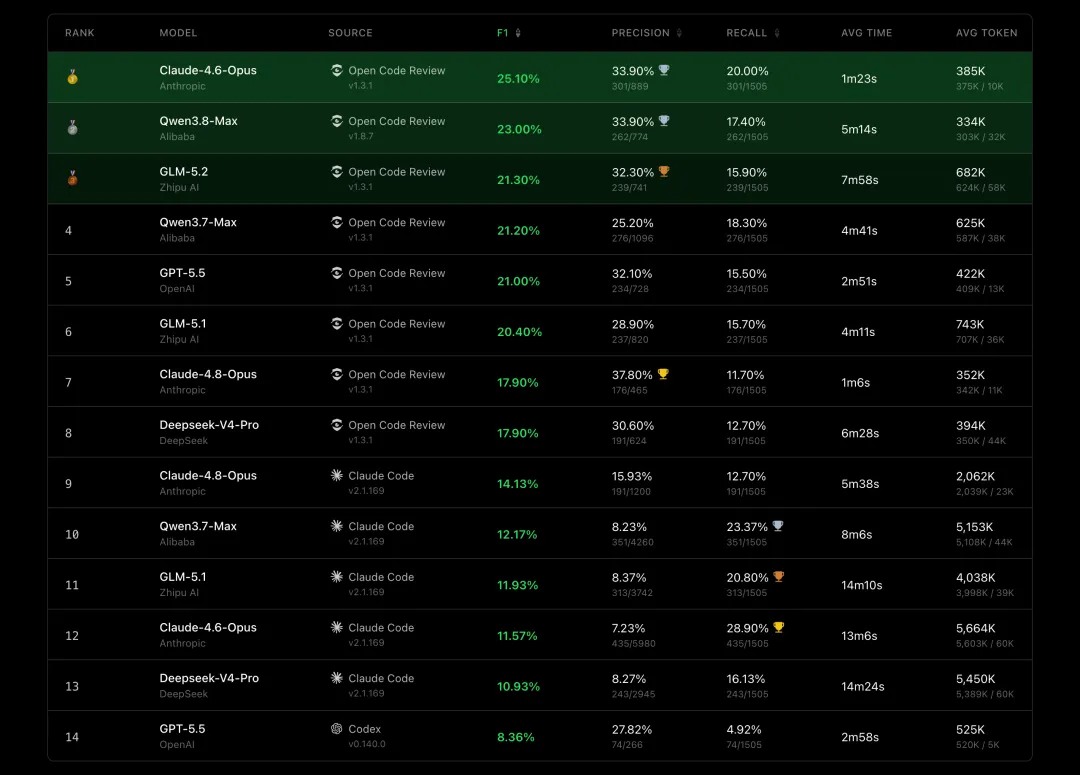
README 里的 benchmark 来自 50 个流行开源项目、200 个真实 PR、10 种编程语言,80 多个资深工程师交叉标注出 1505 个 ground-truth issues。
同一个底层模型,OpenCodeReview 对比通用 agent:
- F1 高很多(综合质量)
- Precision 高很多(少误报)
- Recall 略低(故意 trade-off)
- 速度快
- Token 只有约 1/9
关键不是参数碾压,是Precision/Recall 这套 trade-off 把噪音压下去了。code review 最烦的是 AI 报一堆假阳性让 reviewer 疲于奔命,不如少报点、报准点。开源派的 Turso 之前因为 AI 生成的低质量 bug 报告直接把赏金计划关了——这是行业共鸣。
安装门槛低到离谱
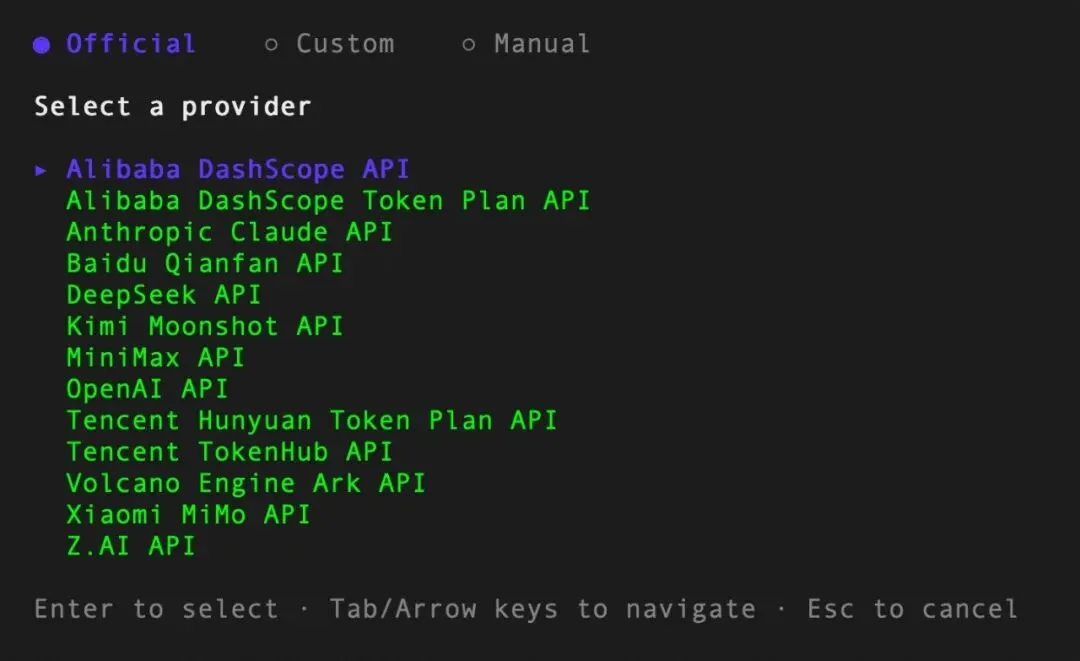
npm install -g @alibaba-group/open-code-review装完是 ocr 命令。ocr config provider 配一个 LLM 端点(OpenAI、Anthropic、或者本地 Ollama 都行),ocr review 就开干。
支持的 review 模式挺全:
工作区模式:stage/unstage/untracked 全扫 分支对比: ocr review --from main --to feature单 commit: ocr review --commit abc123全文件扫描: ocr scan --path internal/agent(不需要 git history)- Delegation 模式
:你自己 Claude Code / Codex 直接当 reviewer,OCR 只负责文件选择和规则匹配,连 LLM API key 都不用配
最后一个是巧思。多数 AI 编程工具是「我内置一个 LLM」,OCR 反过来:你已有的 coding agent 就是 reviewer。工具的责任边界很清晰。
集成生态
插件支持覆盖主流 AI 编程 agent:
Claude Code / Codex / Cursor / OpenCode:各自有官方 plugin Skill 兼容:通用 Skill 也能装 CI/CD:GitHub Actions、GitLab CI、GitFlic CI、Gerrit 都能接 MCP Server:可以扩展 review agent 的外部工具 Session Viewer:浏览器里回放整个 review 过程,标 fixed/ignored
为什么这次值得看
阿里这类大厂内部工具外溢,前几年更多是”我有一个内部框架想求 star”。OpenCodeReview 不一样:它解决的问题是所有使用 AI 编程工具的团队都遇到的——PR review 这件事 AI 一直没干好。
确定性 + Agent 的混合架构是对的方向。
纯 LLM 驱动做不了 review,因为 review 是有正确答案的过程,质量高低看 reviewer 状态、看 prompt 抖没抖。纯规则引擎也做不了 review,因为代码语义、上下文理解得有人猜。把两者分开用,工程方法约束能约束的部分,agent 只处理必须灵活判断的部分,这是真正的工业经验沉淀。
27k+ stars 不是刷出来的,是真的戳中了痛点。
知识星球推荐阅读
↓ 点击阅读原文,查看相关链接 ↓