ARTICLE · 1100786
同一个模型,为什么换个 AI 工具就像换了个人?
同一个大模型,放进不同的 AI 工具里,表现可能差得像换了一个人。
在普通聊天框里,它只给出一段建议;到了编程工具或桌面 Agent 里,它却会先看文件、拆任务、调用工具,出错后再试一次。最容易出现的判断是:后一个工具接入的模型更聪明。
但模型名相同,并不代表它们是同一套系统。最近 DeepSeek 在 Harness 的介绍页上直接写了一条公式:Agent = Model + Harness。这里的 Harness 不太好直译,可以先把它理解成模型工作的整套环境。
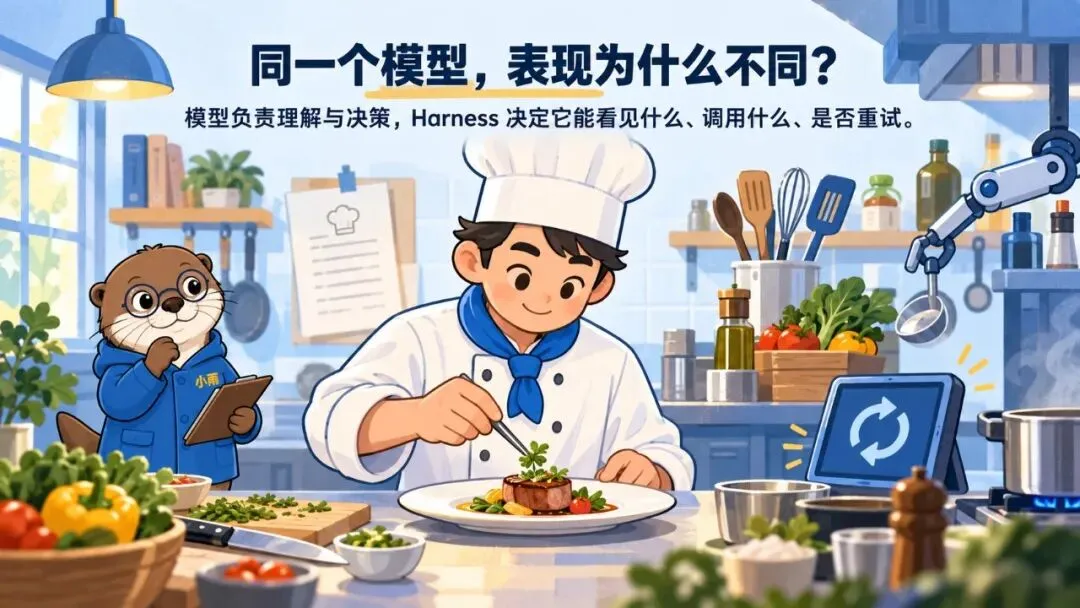
模型更像厨师,不是整间厨房
模型负责理解你说的话,判断下一步应该做什么,再生成文字或工具指令。它很像一名厨师:知道怎样处理食材,也能决定一道菜的大致做法。
Harness 则更像厨房。菜谱怎样写、刀具放在哪里、冰箱里有什么食材、谁能开火、做坏了要不要重来,都是厨房的一部分。
换到 AI 工具里,这些东西分别对应系统提示、上下文、可调用工具、文件和网络权限、任务循环、错误处理,以及结果怎样回到对话框。DeepSeek 列出的工具、技能、会话、沙箱、存储、调度和界面,都是这套工作环境里的组件。
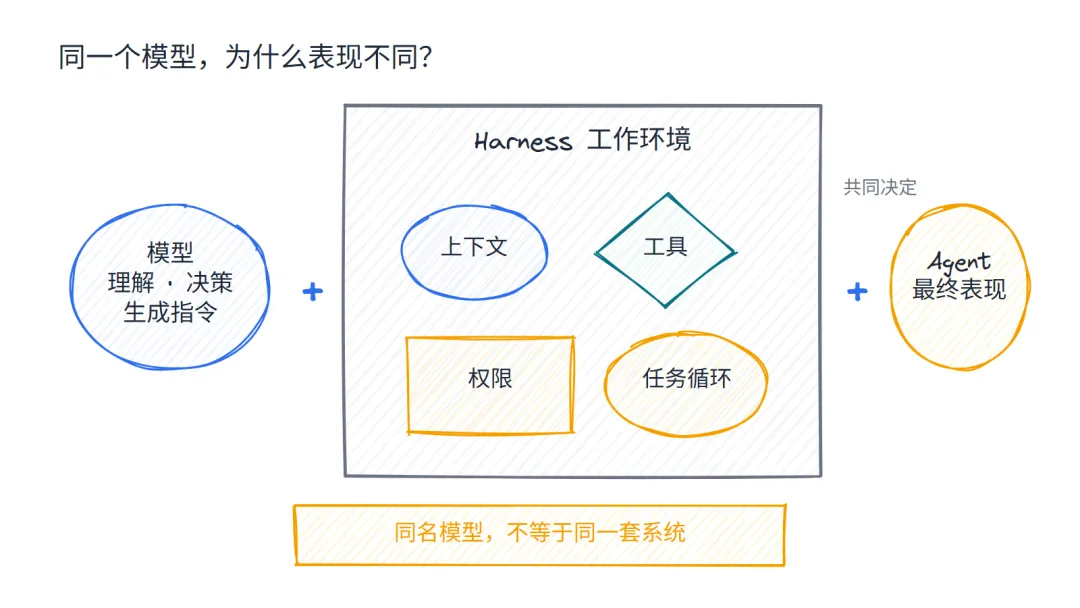
所以,同一位“厨师”进了两间不同的厨房,端出来的菜很可能不一样。差别不一定来自模型参数,也可能只是一个工具允许它读文件,另一个不允许;一个会把长任务拆成几步,另一个只发起一次回答。
系统提示规定先做什么、何时确认;上下文管理决定模型眼前有哪些材料;工具说明、参数和返回结果会影响下一步判断;任务循环则决定调用一次就停,还是检查结果后继续修正。这些能力组合起来,聊天模型才像一个能连续做事的 Agent。
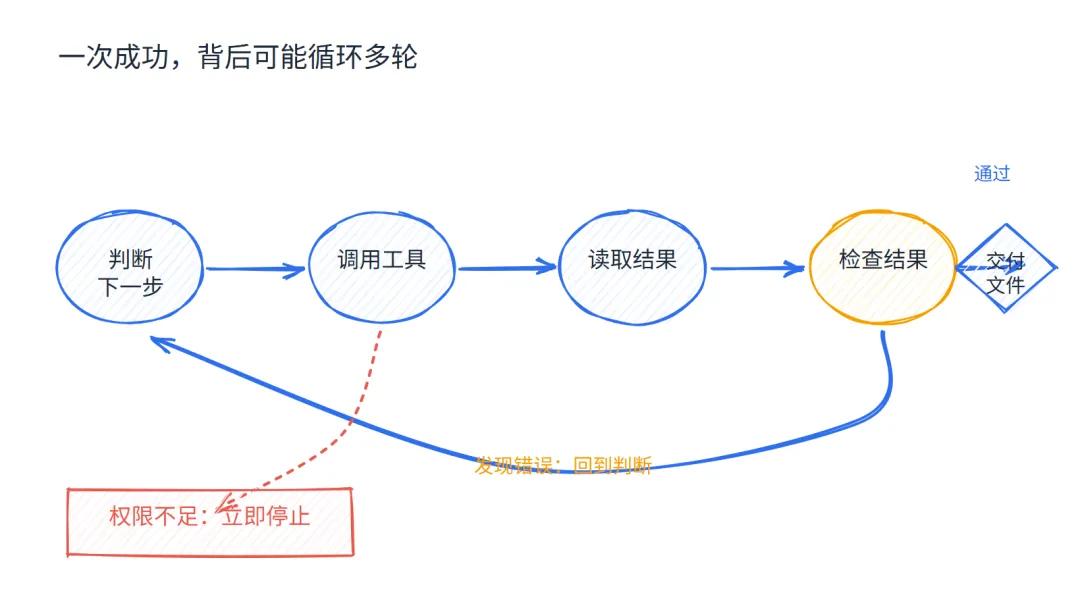
一次成功,背后可能已经试了好几次
比如让 AI “检查一张表格里的错误并修好”。
普通聊天框可能告诉你应该检查日期、公式和空值,却没有权限碰那份文件。带 Harness 的工具可能先读取表格,再调用脚本检查格式,发现报错后换一种方法,最后把修改后的文件交回来。
站在用户面前,后者像是模型突然会干活了。实际上,文件权限、工具能力和重试流程也参与了结果。反过来,一个很强的模型如果只能看到被截断的上下文,或者没有合适工具,表现也会受限。
这也是为什么只看最终答案,很难判断差异究竟来自哪里。近期一项针对 Agent 编程的研究,就采用固定模型、改变 Harness 的方法做对照。研究没有得到“某一套 Harness 放到哪里都更强”的简单结论,反而说明任务、工具和控制流程必须一起看。
同一套 Harness 也不会让所有模型表现一致。有的模型更擅长遵循严格工具格式,有的模型在长任务里更容易偏离目标。厨房安排得再好,厨师是否理解菜谱仍然重要;厨师能力很强,厨房不给刀具也做不出需要的菜。两边不是谁替代谁,而是一起决定上限和下限。
比较 AI 工具时,先固定这几个变量
如果想知道两个工具到底谁更适合自己,最有用的办法不是轮流问两道不同的问题,而是尽量让条件相同。
先确认模型版本是否一致,再给出同一份材料和同一项任务。随后看五件事:它拿到了哪些上下文,能调用什么工具,拥有什么权限,失败后会不会重试,以及最后交付的是一段回答还是一个能继续使用的文件。
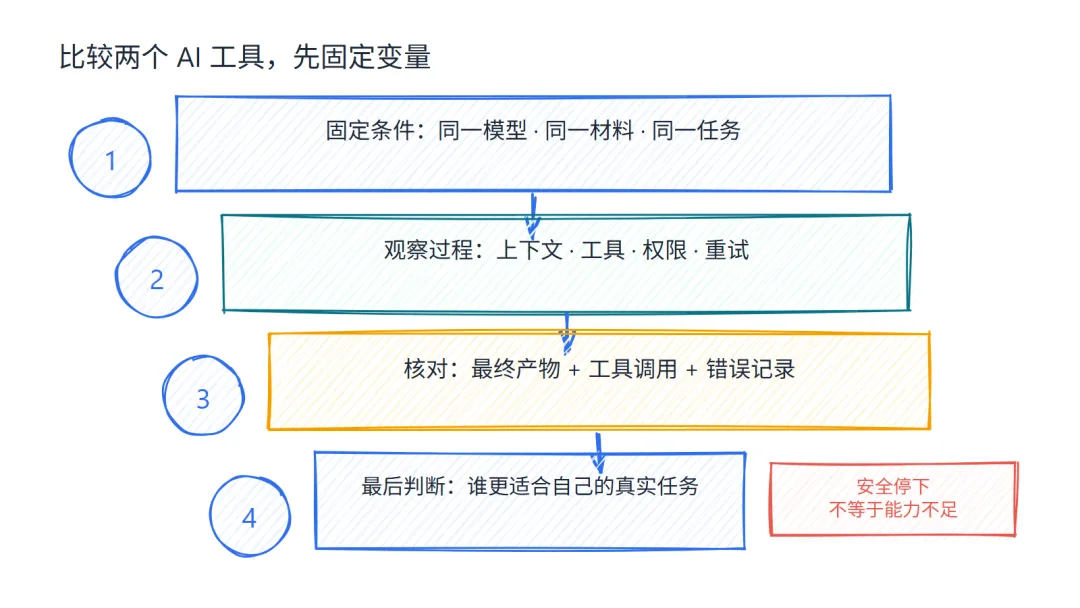
自动重试会让结果看起来像“一次就做对”,所以最好同时记录工具调用、错误、重试和最终产物。如果 Agent 涉及文件修改、发消息或联网,还要单独核对权限:没有写入权限而停住,可能是更安全的设计,并非能力不足。
理解 Harness,不是为了多记一个英文词。它能帮人把“这个 AI 很聪明”拆成更具体的问题:究竟是模型理解得好,还是工具给得对;是权限足够,还是流程会自我纠错。
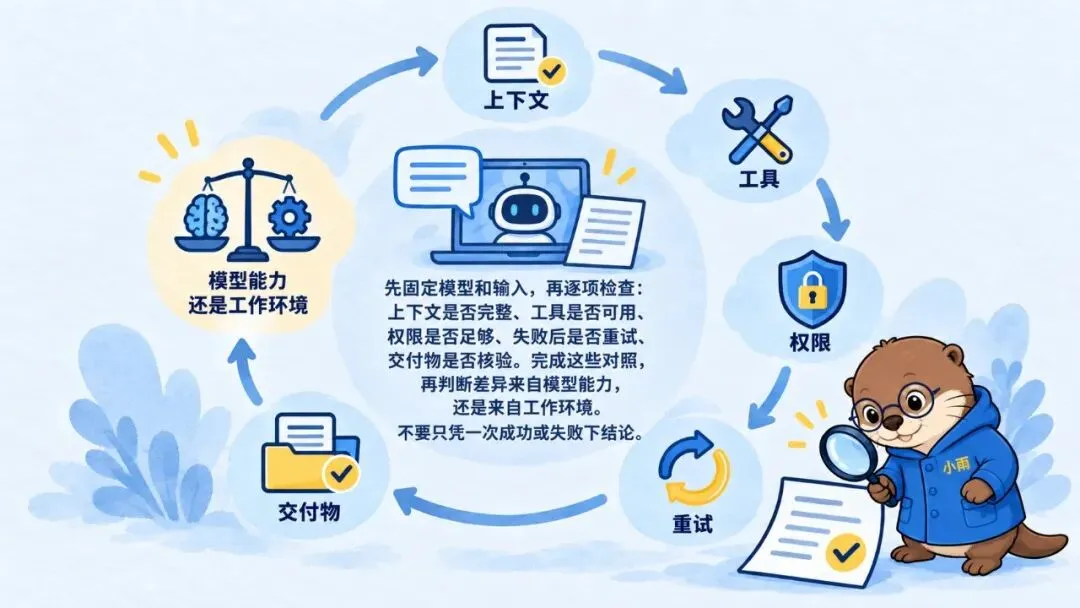
下一次同一个模型在两个产品里表现不同,不必急着怀疑模型被偷换。先看看它们是不是给这位“厨师”准备了完全不同的厨房。