ARTICLE · 1101950
同脑不同命:同一个大模型,为什么AI工具效果差31%?
图1 Same Brain —— 同样的内力,不同的招式
很多人问过我一个问题:市面上那么多AI工具——千问办公、TeleAgent、WorkBuddy、字节TraeWork、商汤小浣熊……如果它们底层用的大模型一模一样,那生成内容的好坏是不是也一样?
答案是:不一样。而且差距可能大到让你吃惊。
先说一个真实的证据。2026年9月,国际数据公司IDC做了一场AI大考——11款中国企业级Agent产品同台竞技,考试规则是:全部换上同一颗大脑(统一使用DeepSeek v4 Pro大模型),用同一套工具,在同一间考场做近百道题。
结果放榜,分数差距一目了然。这件事用一个武侠故事来类比,就是金庸笔下的虚竹——得了无崖子70年内力(顶级模型),可一开始连打架都不会,照样被揍;后来学了天山折梅手等招式(架构与工程),才真正成为一代高手。
这说明,AI工具的强弱,从来不只取决于底层那颗大模型,更取决于怎么用它。今天,用武侠的方式,带你拆开AI工具的壳,看看同脑不同命的秘密。
一、一个反常识的事实:同样的内功,战绩天差地别
先看IDC这场大考的实证数据。
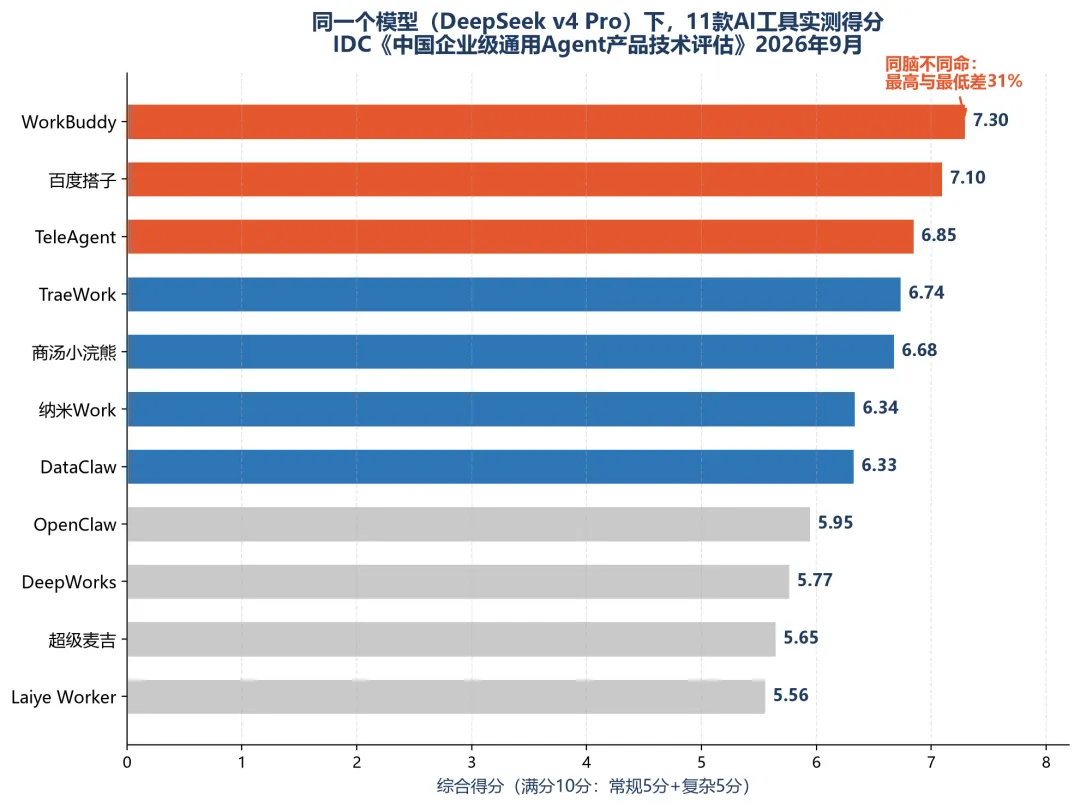
图2 同一模型(DeepSeek v4 Pro)下11款AI工具实测得分(数据来源:IDC报告,2026年9月)
11款产品用同一颗大脑做同一套题,最高分WorkBuddy 7.30分,最低分Laiye Worker 5.56分——差距31%。如果把这道题的难度再拔高(复杂任务、长链路任务),这个差距还会进一步拉大。
这就好比:同一个师父、同一本秘籍、同一天入门,十年后有的弟子成为江湖第一,有的还在山脚扎马步。差别在哪?不在内力,而在招式、战术、兵器、临敌反应——技术行话叫Agent Harness(智能体框架)。
再往前看一层,如果大模型真的决定了效果好坏,那同一颗大脑,为什么会出现这么大的差距?这就要说清楚AI工具的真实构造了。
二、AI工具的「三层架构」:内功、招式、兵器
很多人有个误解:以为AI工具就是套壳模型——把大模型包一层界面,发给用户。其实远远不是。
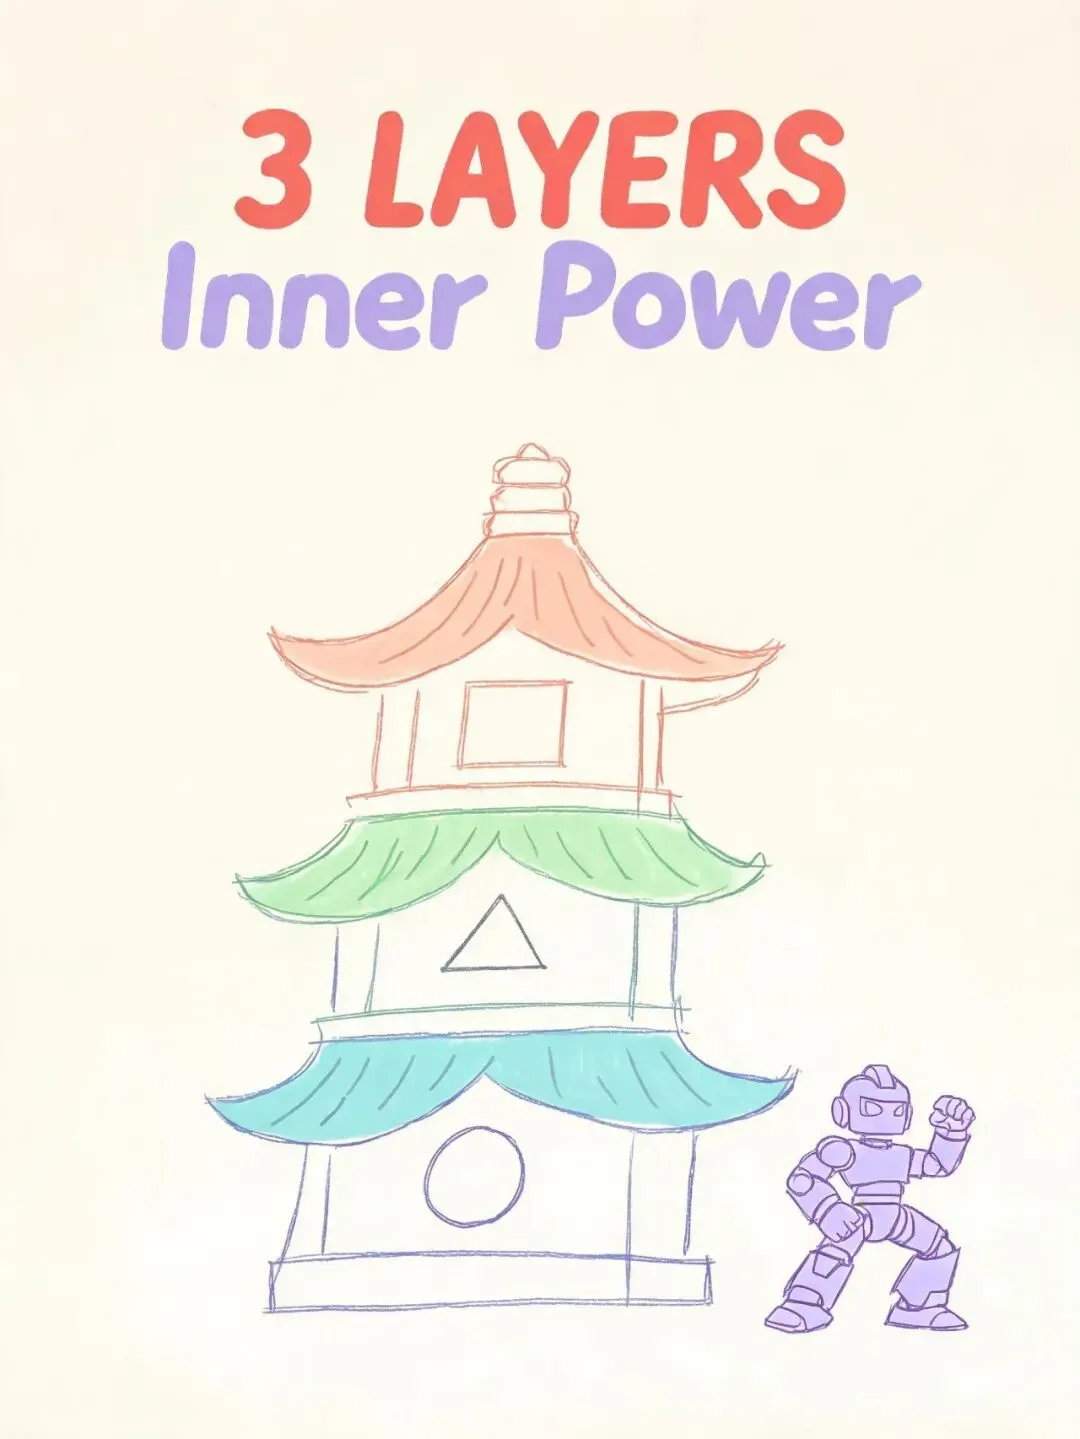
图3 三层架构 —— 内功、招式、兵器
一个真正能干活的AI工具,从下到上至少有三层。
第一层是内功层——也就是大模型本身。它就像弟子的内力:内力越深,力气越大,反应越快。DeepSeek、GPT、Qwen这些大模型,就是各家AI工具的内功来源。
第二层是招式层——也就是Agent Harness,智能体框架。它决定AI怎么拆任务、怎么选工具、怎么记上下文、怎么判断做完了没、失败了怎么重试。招式,就是把内力真正用出来的那一套套路。
第三层是兵器层——也就是工具与技能。AI要改Excel、生成PPT、发邮件,都要靠外部工具。兵器好不好用、怎么使、什么时候使,这层说了算。
IDC的实测告诉我们一个关键事实:当内功(模型)和兵器(工具)被统一以后,招式层反而成了决定成绩的主战场。
三、决定胜负的「招式」:Agent Harness是什么
Agent Harness听起来很玄,其实就是一句话:AI在拿到任务之后、给出最终结果之前,脑子里走的整套流程。
再换一个说法:大模型是脑,Agent Harness是脑怎么指挥手。
图4 招式 —— Agent Harness就是武功套路
它具体管四件事,每一件都是各家拉开差距的关键。
第一招,任务拆解。同一个帮我做一份销售报告的指令,好的Agent Harness会自动拆成先读数据→整理→算指标→做图表→写分析→排版六步;差的Agent Harness可能一步到位乱写一通。IDC实测里,最长的任务要跑5个多小时、拆成92个子任务——这种长链路操作,就是招式好坏的试金石。
图5 任务拆解 —— 好的招式分步清晰
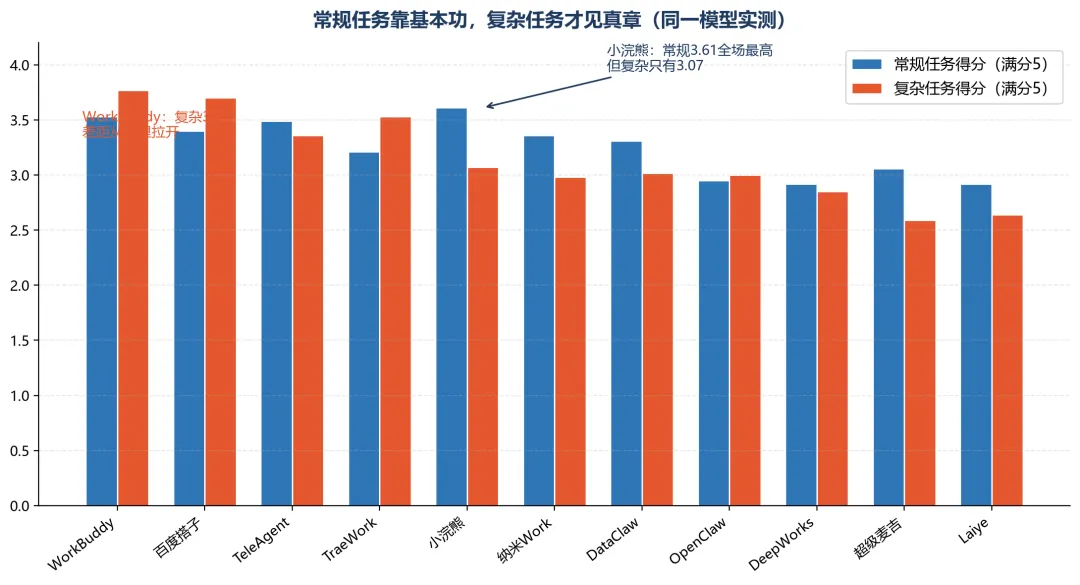
图6 数据可视化:常规任务靠基本功,复杂任务才见真章(同一模型实测)
数据里有个很有意思的细节:商汤小浣熊在常规任务上得了3.61分,全场最高——基本功扎实;但复杂任务只有3.07分,被WorkBuddy的3.77分反超。这就像武侠里,某个弟子打沙袋又快又稳,可一旦对阵高手拆招就乱了方寸。
第二招,上下文管理。AI在干活时,脑子里要记住大量中间信息:刚才做了什么、拿到了什么结果、还剩什么没做。好的Agent Harness知道什么时候该忘掉不重要的细节(释放上下文窗口),什么时候该把关键结果保存到文件里(外部记忆)。差的Harness会让AI失忆——做着做着忘了前面在做什么,又得从头来过。
第三招,失败恢复。AI不是每次都成功,可能工具调用报错、网络断开、模型幻觉。好的Agent Harness能自动重试、切换备用方案、保存中途进度;差的Harness一报错就卡死,等你来手动救援。
图7 失败恢复 —— 跌倒了自己爬起来
第四招,成本效率。同样的事,不同Agent Harness花的代价天差地别。
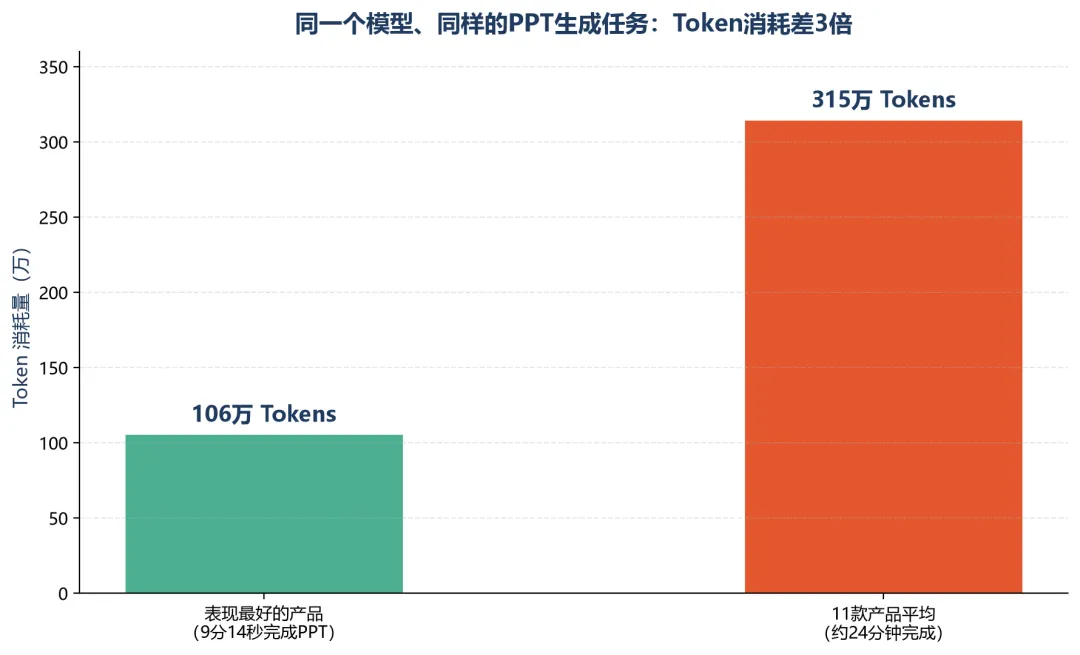
图8 同一个模型、同样的任务,Token消耗差3倍(数据来源:IDC报告)
IDC实测里有一个数字特别有冲击力:同样一个PPT生成任务,表现最好的产品9分14秒完成、消耗106万Tokens;而11款产品的平均水平是约24分钟、消耗315万Tokens。同样是DeepSeek的大脑在思考,有的产品三步搞定,有的产品绕了十圈还没出来——差距3倍。
四、普通人怎么挑AI工具?四个实用建议
讲了一堆原理,落到普通人和企业用户身上,到底怎么选?这里给四个建议。
图9 选型 —— 聪明的选择比拼内力更重要
建议一,别只看模型参数。很多人选AI工具,第一句就问用的是什么大模型。但IDC的实证告诉我们:同一个模型,分数能差31%。所以更该问的是它在复杂任务上的完成率怎么样上下文管理策略是什么失败后能自动恢复吗。
建议二,让产品做一道跨系统任务试试。单轮问答谁都能做好;真正拉开差距的是读邮件→查CRM→改文档→发消息这种跨系统的长链路。IDC报告里复杂任务占总分41.9%,就是因为简单任务拉不开差距。
建议三,看Token效率。同样一个任务,Token消耗低的,意味着产品架构更聪明,长期用下来成本更低。IDC报告里Token效率差异达3倍,直接体现在企业年度API账单上。
建议四,看安全能力。AI能力越强,越要防着它偷看答案破坏环境。企业选型时,安全可控应该和能力同等重要。IDC报告明确指出,59.8%的企业担心AI越权与误操作——这不是危言耸听。
五、行业启示:从「比内功」到「比招式」
这场IDC大考最让我感触的,不是谁拿了第一,而是它揭示的一个趋势:AI行业的竞争,正在从比内功转向比招式。
图10 新赛道 —— 不再只比模型,更比工程
前几年,大家比的是谁的模型参数大、谁的benchmark分数高——这是内功竞赛。但现在开源模型百花齐放,DeepSeek、Qwen这些开源模型的能力已经追到第一梯队,模型不再是稀缺品。
于是战场转移了:谁的Agent Harness更聪明、谁的工具链更完善、谁的安全防护更到位、谁的成本更低——这是招式竞赛。IDC研究经理孙振亚在报告里判断:未来6到12个月,市场竞争将主要集中在企业级场景能力、复杂任务交付、企业系统连接和组织级治理方面。
这对所有AI厂商都意味着一件事:再也不能靠我家用的是GPT来打动客户了。客户会问:同一个模型,你凭什么比别人做得好?回答这个问题的能力,就是护城河。
结语:同脑不同命,招式定高下
回到金庸笔下的虚竹。他得了无崖子70年功力,却不会打架——因为内力是内力,招式是招式。后来他学了天山折梅手、逍遥派武学,才把那身内力真正用出来。
AI工具也是一样。同一个大模型,给到不同团队,做出来的产品可以差30%以上。差别不在大脑,而在大脑怎么指挥手脚的那一套架构与工程——Agent Harness。
所以下次有人问你这些AI工具底下的模型都一样,效果是不是一样,你可以自信地回答:内力可以一样,招式各有各的——真正决定胜负的,永远是招式。
图11 修炼之路 —— 招式精进,永无止境
AIGC标识: 40629564-acf6-41ea-b464-9da2b6bd0644