ARTICLE · 1103568
AI项目复盘05|招标信息自动采集,技术跑得通,卡在了数据源上
在《FDE最怕的不是技术问题,而是理不清楚的企业需求》里,我把公司内部23个项目需求盘了一遍,但大多只归了个类,一句话就带过了。
回看那篇文章,这些项目经验写这么薄,有点可惜。因为成了的没说清为什么成,黄了的也没说清哪里踩了坑。于是寻思着一定要把典型案例拎出来,摊开来盘一盘。
接下来请出今天的主角,招标信息自动采集智能体。该需求由经营管理部提出,原本设想的目标是把公开招标信息的采集、筛选、整理、上传CRM彻底做成全自动。它生于2026年4月,卒于4月下旬的一场内部评估会,前后没撑过一个月。9月份,我尝试把它从4月的结论中抢救出来,可惜最终只是验了一次尸。
一句话总结
做采集分析型的AI需求场景,先别急着选方案。技术跑得通只是能落地的起点,数据平时没人重视,却最终能一票否决掉整个需求。
需求本来长什么样
4月初,经营管理部向我们部门提了个需求,有个活想交给AI干。
这个活现在是这么干的。经营管理部专门有一个人,每天盯着招标网站,手动检索关键词、筛选有效信息、复制粘贴项目名称和预算、整理成表,再一条条录进CRM。
单条信息最终录入CRM虽然只花1分钟,但一个人几乎全天都需要消耗在这些信息检索提取上。
他们想做成什么样呢?智能体自动去千里马招标网采集为主,按关键词筛出跟照明业务相关的项目,整理成结构化字段,直接上传到CRM并同步分享到企微群中,全程不需要人管。
4月评估会的否决
需求转到研发这边,第一件事是内部按老规矩先评估技术可行性。
作为产品经理,我看的顺序和研发反着来,先盘数据源,技术方案往后放。招标信息要自动采集,先得有一个能稳定取数的来源。
我打开千里马的《会员注册须知》,翻到第六条用户的权利和义务,两条红线写得清清楚楚。
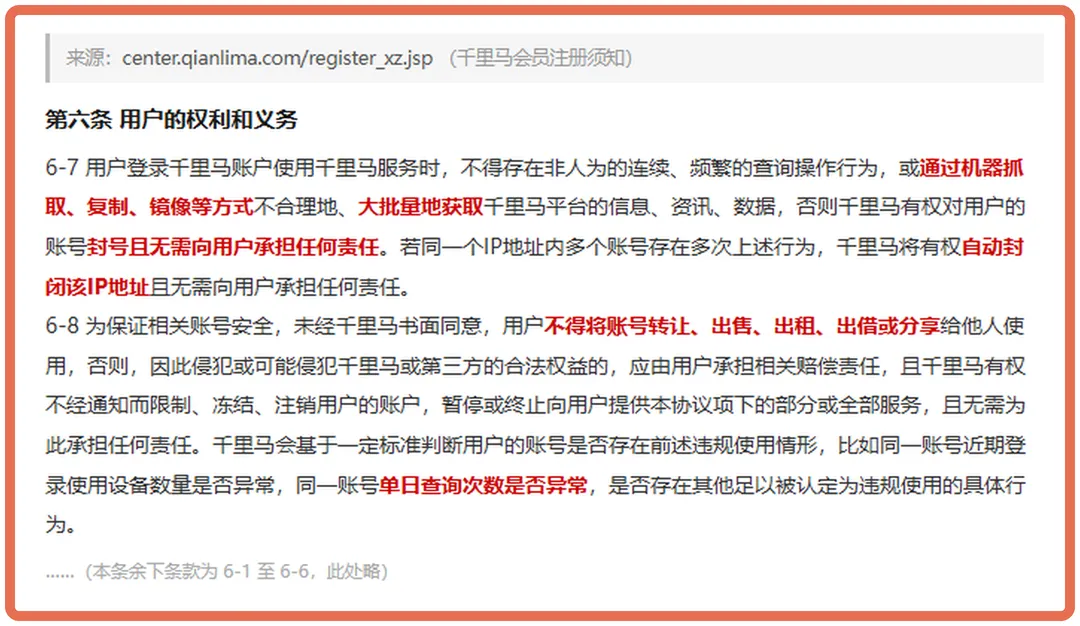
一条管查询行为,一条管账号使用。我逐条对了一遍,自动采集这套做法基本全踩在上面。脚本连续频繁地翻页,大批量把数据抓到本地,这两条正是千里马官方明文禁止的。
技术层面平台也做了拦截。搜索接口、搜索页、下载目录、项目详情页这几类批量操作最常用的路径,全部禁止抓取。
账号是公司真金白银充了VIP的,有效期一直买到了2031年。一旦封号,账号资产打了水漂,业务手上正在跟进的项目线索全得断档。同IP连坐这条更要命,账号一封,整个办公网出口都跟着受牵连。
那官方有没有正规通道?
有。VIP账号内置了批量导出功能,支持导出全量结构化数据,这个不额外收费。但要拿全招标文件附件、真实原文链接这类个性化字段,还是得走数据定制。
我翻了一圈账号后台,没有发现任何API或者MCP的入口,显然官方不想提供自助接入能力。
官方的数据商城按行业年份询价,走项目制预算要万元级起步,这笔预算又没批下来。
结论就一句话。合规、全面、便宜的数据源,千里马官方不能提供。自己动手爬数据来分析倒是能满足需求,可惜容易踩用户协议红线。
最后,领导在企业管理会上拍板,正式拒绝了这个需求场景。
9月我为什么想要尝试抢救
这事就这么搁下了,一搁就是五个月。
9月的一天,我拿浏览器让AI顶着登录态做了一套在线题目。28秒,20道题,满分100。
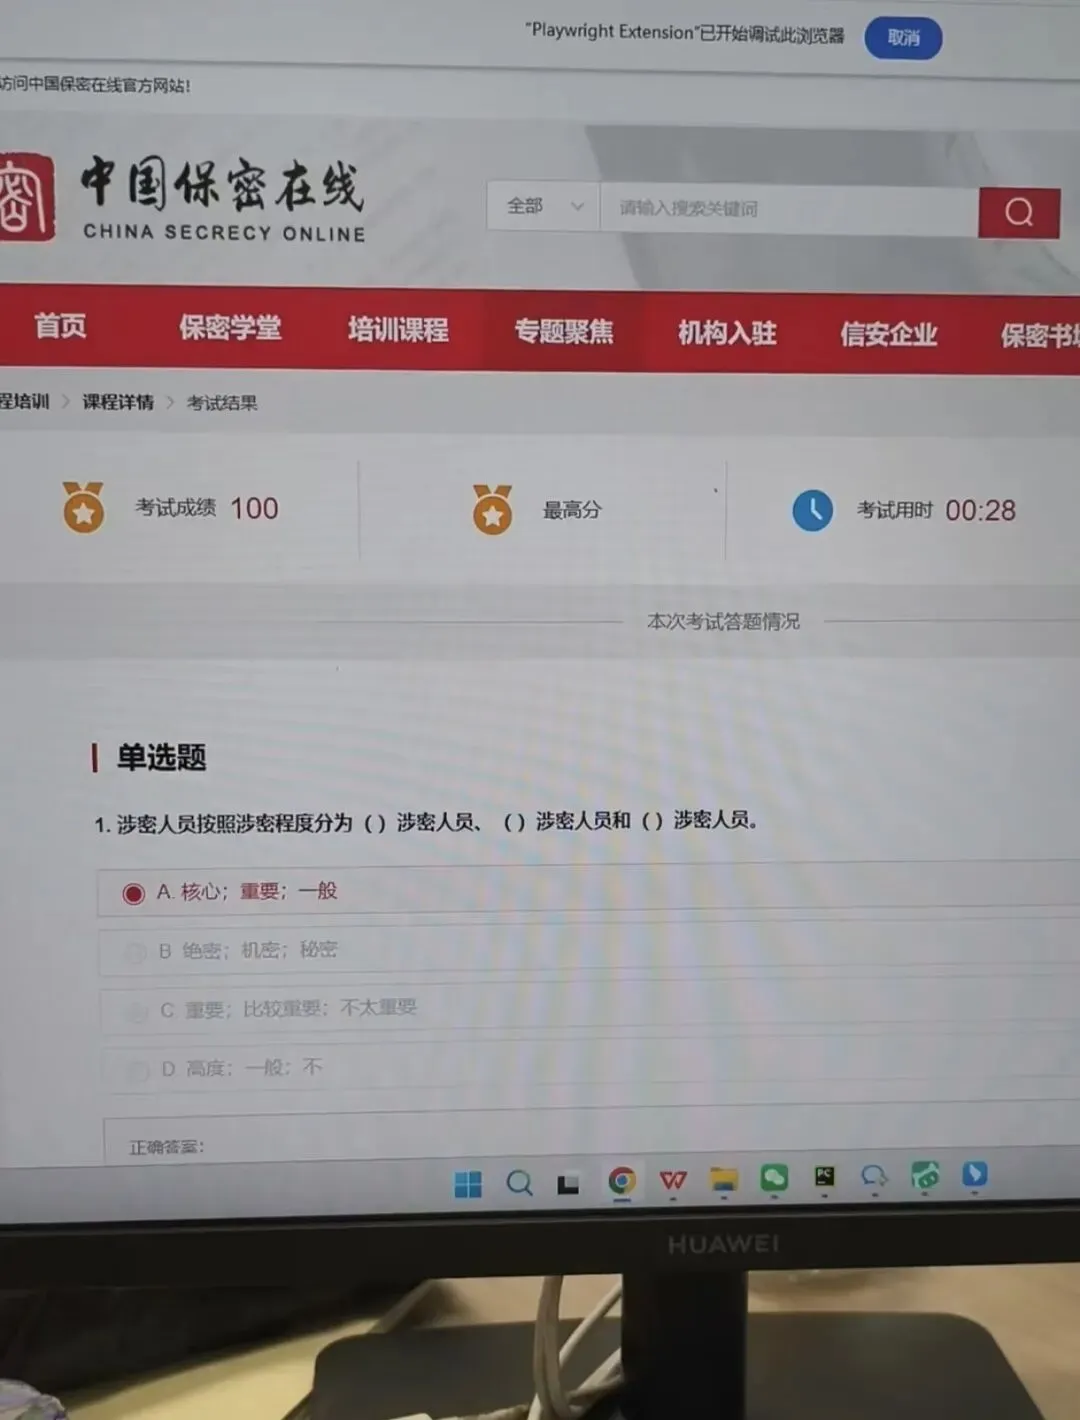
看着屏幕上跳出来的满分结果,那一瞬间我意识到一件事。AI既然能顶着我的登录态,自动把一整张试卷做完,那它也就能顶着登录态,去做别的批量操作。
念头几乎是立刻冒出来的。如果AI可以顶着登录态去千里马网站,模拟人的行为批量查招标信息,那4月被否决的需求,是不是业务部门可以自己尝试完成?不需要研发去写爬虫脚本,一套通用Agent工具就能尝试。但谁来操作,风险就落在谁头上。
技术验证全通过,数据源却不合格
说干就干,9月中旬我找了个下午,把那个躺了五个月的项目重新捞了出来。借助WorkBuddy浏览器插件的能力,在千里马页面上实操了一遍。
先模拟登录,登上VIP账号,有效期到2031年,账号登录态可以直接复用,不用每次重新输验证码。
接下来搜关键词「路灯」,返回58416条数据。翻页正常,加载速度正常,没有触发任何风控弹窗。
再打开两个真实项目的详情页。预算金额、项目编号、联系人电话、报名截止、投标截止、资金来源、招标文件附件,这些加起来14个字段基本全覆盖。之前一直担心联系人和附件会不会卡高级会员权限,结果都能查。
技术路径,每一步都是通的,我也成功批量采集到了想要的招标信息表。
我顺手做了个对比,拿官方VIP自带的批量导出功能,和浏览器采集能拿到的字段比了一遍。
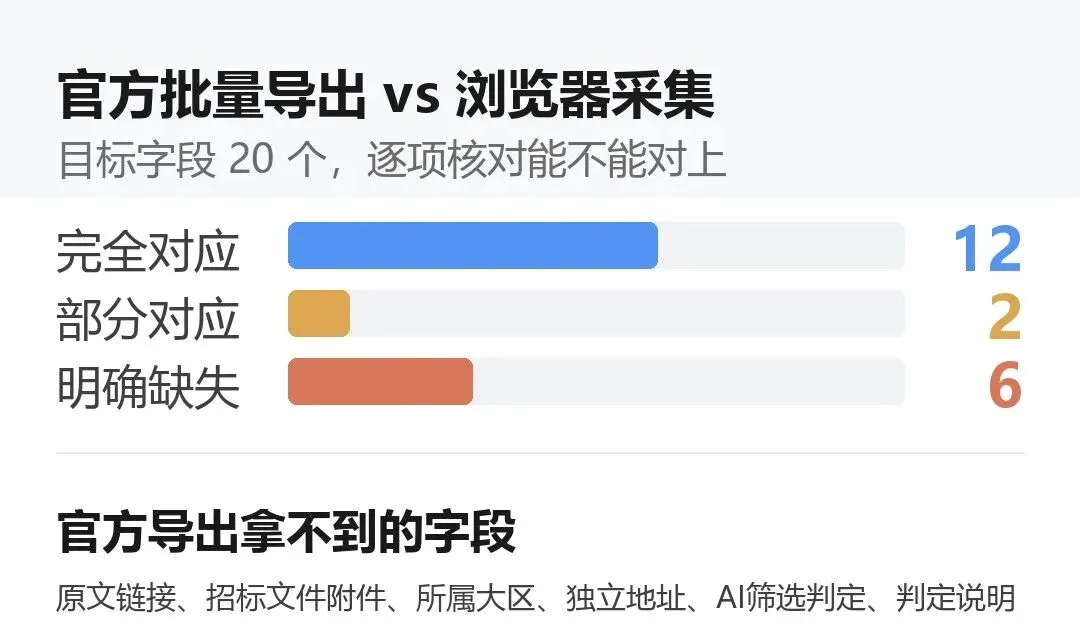
更麻烦的是覆盖面,废标公告、拟建项目、可研审批这些类型,导出的数据里并没有提供。
官方给的结构化数据还是太薄,靠AI判定并且补上边缘线索才算完整。
破局的两条路都还在,但没有选用
算下来这个项目想要落地,其实还有有两条路可走:
一是官方路线。VIP自带的批量导出不额外收费,能覆盖大部分结构化数据,缺的那几个字段,同时可以走数据定制或者人工补充。
二是自建路线。浏览器自动化加上节流,只抓当天增量,每天不超过100条,翻页加2到5秒的随机间隔,固定一台设备、固定一个账号,不搞24小时循环。这套模拟人的行为,就是拿来降风控的。
我的实测也证明,正常节奏的翻页和详情查看,不会触发任何弹窗。
业务部门自己训练个skill,日常维护也不难。
两条路摆在那里,一个花钱买省心,一个花纪律买便宜,都不算堵死,只需要计算代价。
自建这条路能省下定制数据的钱,账号到底会不会被封没人说的准,按人的节奏操作页面,风控风险能压到中档,但永远压不到零。
官方的数据商城又不便宜,一次性要投一笔钱。
业务部门思前想后,还是放弃了推进,继续投人力维持现状。账号是公司的,真封了损失公司兜;可操作是业务做的,担责的也是业务。一边是买到2031年的VIP账号,一边是这个项目省下的那点人力,这笔账怎么算都不划算。
写在最后
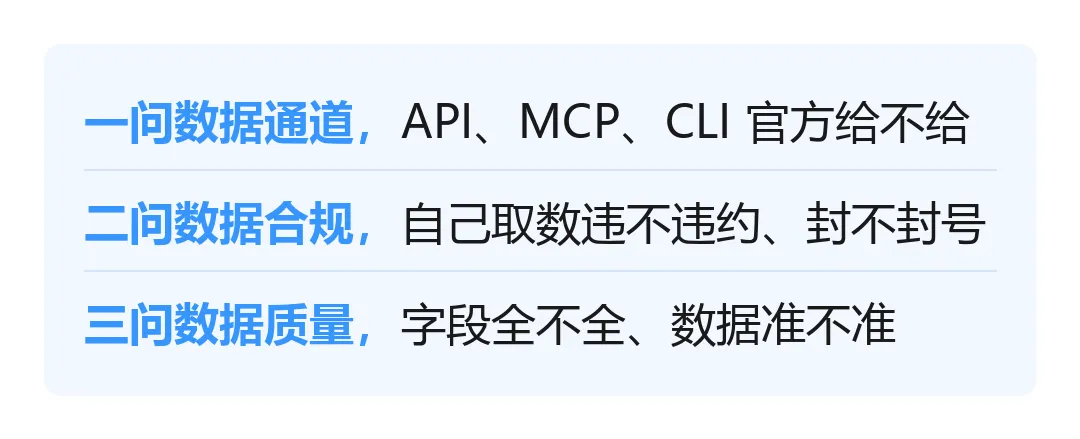
现在再遇到采集分析型的需求,我会先问几个问题,只要有一个存在阻塞,就不急着在AI应用上下功夫,解决了数据源的问题后,项目落地可能会更顺。