ARTICLE · 1104331
AI的记忆下沉了:百万Token装进设备里
最近有条消息,我盯了很久。
据公开报道,2026年9月,有国产大模型团队开源了一款端侧模型,原生支持100万Token的超长上下文,而且是用全国产算力训练的。
把这两个词放一起看,才是重点:端侧 + 百万上下文。
端侧,意思是模型跑在你手里的设备上,不一定要连云端。百万Token上下文,意思是它能一口气"记住"极长的一段内容——大概相当于好几本厚书,或者你们团队一整年攒下的资料。
以前这两件事很难同时成立。端侧设备算力和空间都紧张,能记住的东西有限;想记住得多,就得连上云端的大机器。
现在有人说,这两件事能在同一台设备上凑齐了。这句话背后藏着的,是AI的记忆正在从云端,慢慢落进你自己的设备里。
本期导读
一条消息,两个词:为什么"端侧"要配"百万上下文" 我的判断:真正被搬动的不是参数,是记忆的位置 记忆在云端待着,到底卡在哪 一张表:记忆放云端 vs 放设备 一步步推下来,最先变的是哪一段 一个少有人提的角度:记忆的定义权 如果你手上有设备,今天可以做一件事
一条消息,两个词:为什么"端侧"要配"百万上下文"
先说清"上下文"是什么。
你可以把它想成AI的工作台面。你丢给它的东西、你们这几轮对话的内容,都摊在这个台面上,它一边看一边答。台面越大,它能同时摆开的材料越多。
过去这个台面大多在云端,因为台面越大,占用的算力和存储越贵。所以你会遇到那种情况:聊到一半,它"忘了"前面说过什么;或者你传一份长文档,它只读了个开头。
而"端侧",是把模型连同这个台面,一起搬到设备本地。
端侧 + 大台面,凑在一起,指向的其实是一件事——让AI记住的东西,不再必须经过云端那一段路。
💡 我的判断:这条消息里最值钱的不是"100万Token"这个数字,而是"端侧"两个字。能记住多少是能力问题,记忆放在谁那里,是关系问题。数字会年年被刷新,位置一旦挪动,就很少挪回去了。
记忆在云端待着,到底卡在哪
很多人以为云端是个又大又省事的地方,记忆放那儿没什么不好。我曾经也这么想,直到有一次帮人整理一份上百页的资料,才意识到问题。
记忆在云端,卡的主要是两段路。
第一段是上传。要把一份长材料记进云端,得先把它传上去。材料越大,传得越慢、越费流量,隐私上你心里也越打个问号——这份东西现在躺在别人的机器里。
第二段是调用。每次它要"想起"这段记忆,相关的内容就得在云和设备之间来回跑一趟。用得越频繁,这条路上的车流越密。
这两段路,构成了云端记忆的隐性成本:你不只是在为"记住"付钱,还在为"搬运记忆"反复付钱。
端侧的意义,恰恰是把这两段路直接抹掉一大半。记忆就在本地,用的时候不用上传、不用来回跑。
一张表:记忆放云端 vs 放设备
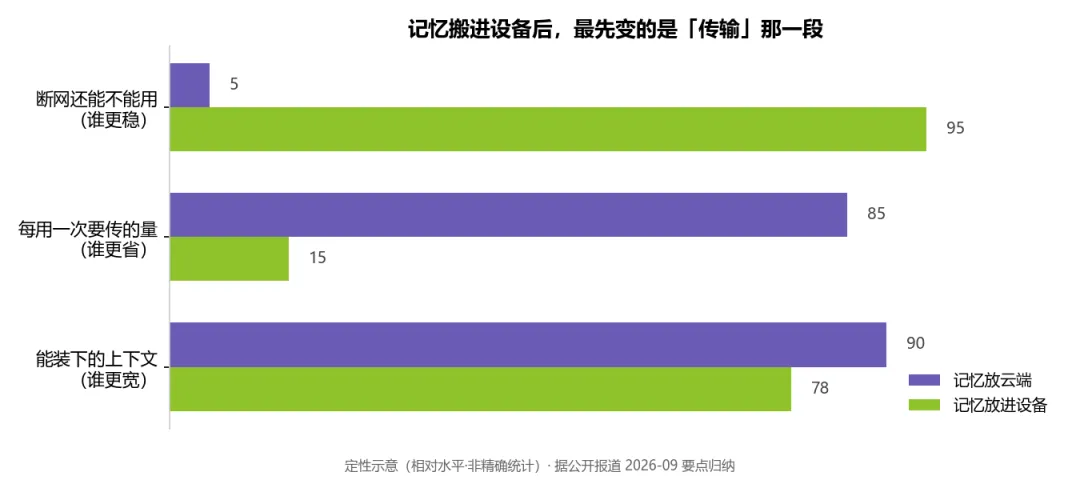
这张表不是要证明端侧全面胜出——云端在台面大小上依然有优势。它想说的是:两种记忆方式,擅长的事不一样。 把私密、高频、离线的活交给本地,把超大、偶发的活交给云端,这才是划算的分工。
一步步推下来,最先变的是哪一段
我们顺着推一遍,看记忆下沉到底会先改变什么。
第一步,记忆能放进设备,说明端侧芯片的容量和带宽跨过了一道线。这不是某一项技术突变,是存储、带宽、模型压缩几件事凑到一起,终于够放下一张够大的台面。
第二步,台面够大之后,最贵的动作就从"算"变成了"搬"。模型算得快不快,大多在设备出厂时就定了;真正天天消耗你时间的,是材料在云和设备之间来回跑。记忆一旦就地,这一段消耗就掉了。
第三步,省下来的这一段,会先体现在"敢用它处理私密和长材料"上。以前不敢传上去的东西,现在可以留在本地让AI看;以前嫌来回太慢的长材料,现在能一口气喂进去。
第四步,于是AI帮你的方式,会从"问一句答一句",往"陪你把一摊事从头过到尾"挪。因为它记得住全程,你不用每次重新交代背景。
⚠️ 提醒:这里有个容易踩的坑——"能记住100万Token",不等于它"记得对、用得准"。台面大只是给足了空间,能不能在长材料里找准那一条,还得看它的检索和判断。别把"记得住"当成"靠得住"。
一个少有人提的角度:记忆的定义权
大部分解读停在这里:端侧模型变强了,本地AI更好用了。
我想再往前推一层,说说记忆跟着谁走这件事。
记忆放在云端,你用的是别人的台面。你用过的材料、你的偏好、你们的对话历史,都沉淀在别人的系统里。换一家服务,这些记忆大多带不走——你等于从零重新认识一个AI。
记忆落进设备本地之后,这些沉淀开始堆在你自己的机器上。它是你的资产,跟着设备走,不跟着某家公司走。
这意味着两件事。一是隐私的账变简单了:私密材料不上传,就等于没有那个"传上去之后会怎样"的悬念。二是选择的账也变了:你的记忆不再是被某一家锁住的人质,换模型的时候,你带走的不只是设备,还有那些年攒下的上下文。
换个说法——记忆放在谁那里,决定了谁是主语。 记忆在云端,AI是主语,你提供素材;记忆在本地,你才是主语,AI只是调用工具。
💡 我的判断:技术圈爱聊参数,但决定你长期处境的,是这些"关系"层面的变化。端侧大上下文真正动摇的,是记忆的归属——这件事不会上热搜,却会一年一年地改变你和AI的关系。
如果你手上有设备,今天可以做一件事
不用等端侧大模型普及,这个思路现在就能用上。
先把自己的材料分个类:一类是能公开、量大、偶尔用,再大的也放心交给云端;一类是私密、高频、离线也要能用,尽量让它留在你自己的设备和本地工具里。
我自己的习惯是,凡是要反复翻、又不想外传的东西,先落进本地笔记,再让AI在旁边帮我读;只在真的需要更宽的台面时,才临时把一段内容递给云端。这样,隐私最要紧的那部分,始终没离开过我的手。
有个来自工程行当的说法,我特别认:再大的机器,也不是所有活都堆在中央厨房做的;能就近处理的,就别都拉回去。 记忆也一样。
回到开头那条消息。100万Token也好,端侧也罢,它们指向的都不是"更强",而是更近——AI离你的设备和你的数据,近了一步。
记忆落到哪里,你就拥有到哪里。
你有没有哪类资料,是宁可慢一点,也不愿意传上云端的?留言说说你的底线在哪。
说明:本文由AI辅助创作并经过人工审核修改,数据均标注来源。
关注「拙勤守新」· 用AI认知提升工作效率!